Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2を一行でまとめると、Fable 5.2が最も高いスコアを出し、Neonはトークンあたりのコストが最も低く、Astraは独立系ベンチマークのタスクを最も安く完了します。Neonの料金は100万トークンあたり入力$3 / 出力$15、AstraとFableはいずれも$8 / $40です。3モデルとも約100万トークンのコンテキストを備えています。
10日間で3つのフロンティアモデルが登場しました。2026年11月9日のClaude Fable 5.2、11月17日のGPT-6.2 Astra、11月18日のGemini 4 Neonです。以下では料金、スペック、独立系スコア、タスクあたりのコスト、そしてApidog CLIで3モデルすべてを試す方法を解説します。
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2:結論を先に
リーダーボードの順位ではなく、ワークロードで選びましょう。
- Gemini 4 Neon:一日中回し続ける複雑なコーディングや分析に。トークンあたりのコストは他の2モデルより62.5%安く、Vals Indexでは2位です。
- GPT-6.2 Astra:あなたのスタックがOpenAI Responses API上に構築されているなら。タスクあたりに書き出すトークンがはるかに少ないため、$8 / $40という料金にもかかわらず、Artificial Analysisのタスクあたりコストは3モデル中最安です。
- Claude Fable 5.2:失敗した実行のコストがトークン代をはるかに上回るような、最も難易度の高い長期的タスクに。両方の独立系インデックスで首位ですが、タスクあたりのコストは最も高くなります。
10月の事例から来た方は、前世代を扱ったGemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5の比較もご覧ください。
3モデルの料金とスペックはどう比較できる?
Neonは料金面で際立っています。数値はGoogleのGemini 4 Neonローンチ記事と料金ページ、GPT-6.2 Astraのモデルページ、AnthropicのClaude Fable 5.2概要から引用しています。
| スペック | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| APIモデルID | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| リリース日 | 2026年11月18日 | 2026年11月17日 | 2026年11月9日 |
| 100万トークンあたりの入力 / 出力 | $3 / $15 | $8 / $40 | $8 / $40 |
| 100万トークンあたりのキャッシュ入力 | $0.15(暗黙キャッシュのみ) | $0.40 | $0.20 |
| コンテキストウィンドウ | 1,048,576(出力と共有) | 1,050,000(最大入力922,000) | 1M |
| リクエストあたりの最大出力 | 65,536 | 128,000 | 128K |
| 長いプロンプト | 100万トークンまで定額 | 入力272K超:入力2倍、出力1.5倍 | 100万トークンまで定額 |
| バッチ割引 | 50%(BatchおよびFlex) | 50% | 50% |
| 推論制御 | thinking_level:low〜xhigh、デフォルトはhigh |
reasoning.effort、noneは拒否される |
effort、デフォルトはhigh |
| 無料API枠 | なし | なし | なし |
実際の請求額を左右するディテールが2つあります。Neonのキャッシュは暗黙型です:Googleが繰り返し現れるプロンプトのプレフィックスをマッチしたときにのみ$0.15の料金が適用されます。またNeonはリクエストあたり最大65,536トークンしか返さないため、非常に長い出力にはGoogleのlong decodeか継続ループが必要になります。
完全な料金表については、Gemini 4 Neonの料金、GPT-6.2 Astraの料金、Claude Fable 5.2の料金の解説をご覧ください。
独立系ベンチマークではどのモデルが勝つ?
ベンダーのベンチマーク表は同じテストを共有していることがほとんどありません。2つの独立系リーダーボードが3モデルすべてを同じスイートで評価しており、2位の判定で食い違っています。
| 指標 | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61(xhigh) | 62(max) | 65(max) |
| Vals Index | 70.87%、2位 | 67.66%、8位 | 71.31%、1位 |
| AAのインデックスタスクあたりコスト | $6.44 | $4.00 | $26.54 |
| AAのインデックスタスクあたり所要時間 | 21.5分 | 13.9分 | 41.8分 |
| AAの出力速度 | 110 tok/s | 49 tok/s | 109 tok/s |
| AAインデックス全体の出力トークン数 | 283M | 65.8M | 275M |
出典:各モデルのArtificial Analysisモデルページ(2026年11月19日時点)、および2026年11月18日時点のVals Index。
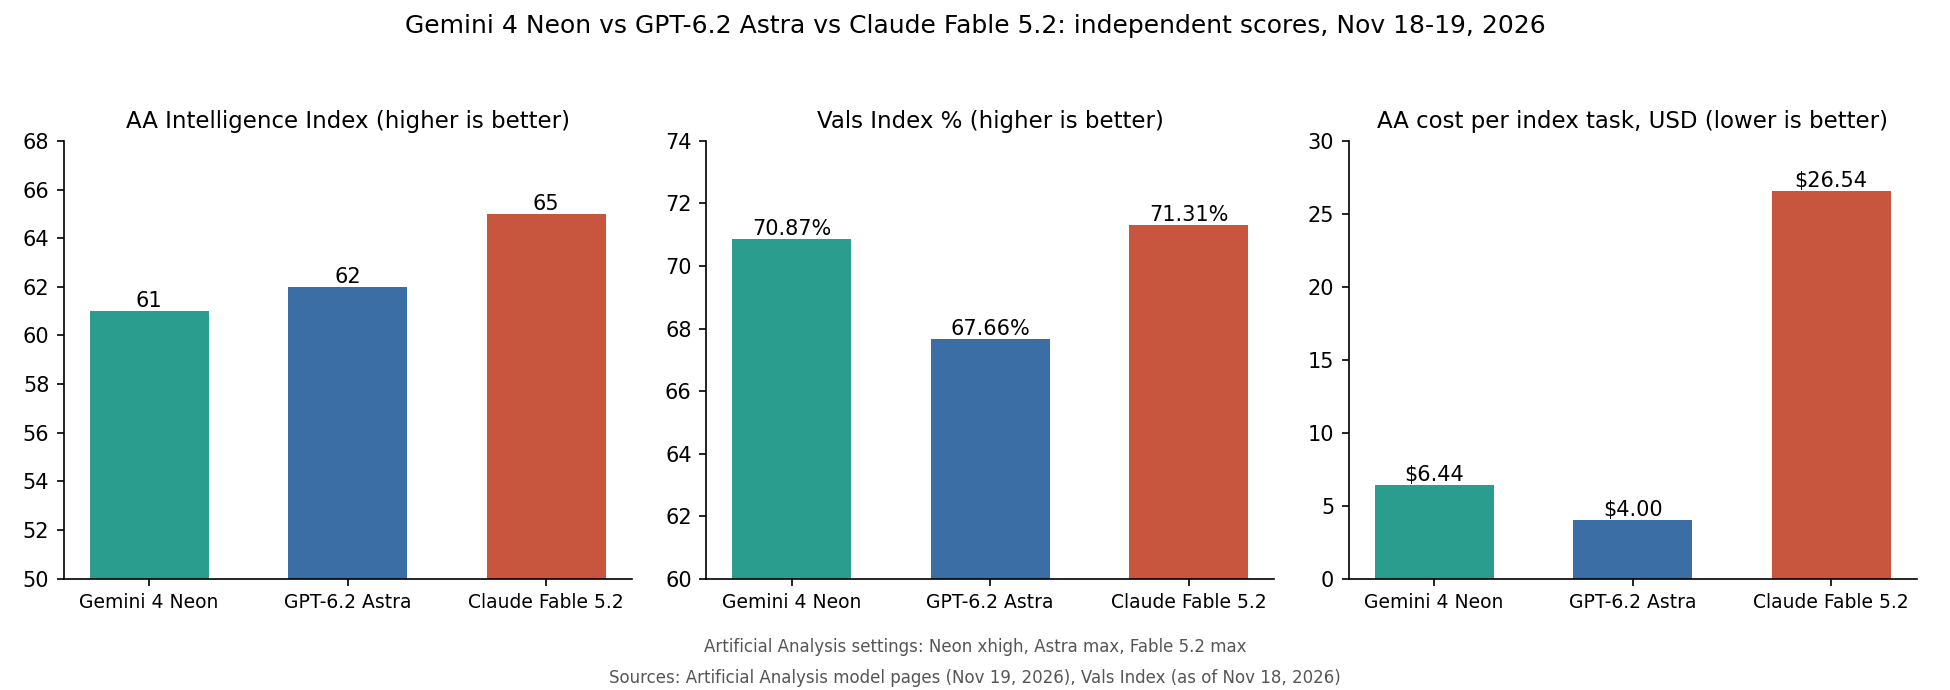
Fable 5.2は両方のボードで首位に立ち、ValsではNeonがわずか0.44ポイント差で続きます。Artificial AnalysisではAstraがNeonを1ポイント上回り、ValsではNeonがAstraを3ポイント以上上回っています。
Googleのローンチ記事ではNeonはArtificial Analysisで3位でしたが、11月19日時点で同じページでは96モデル中6位と表示されています。ローンチ日の順位は移ろいやすく、1ポイントの差はノイズにすぎません。コストと速度の行のほうが、各モデルがあなたのエージェントでどう体感されるかをよく示してくれます。
トークンあたりで最も高いモデルが、タスクあたりで最も安いのはなぜ?
請求額の半分はトークンあたりの料金で、もう半分はモデルが回答するまでに書き出すトークン数です。Artificial Analysisのスイートでは、Astraは65.8Mの出力トークンを生成しました。Neonは283M、Fableは275Mで、4倍以上です。Astraの$40という出力料金がはるかに小さなトークン量に適用された結果、タスクあたりコストは$4.00となり、Neonの$6.44を下回りました。Neonの出力料金は62.5%低いにもかかわらず、です。
設定も重要です。Artificial AnalysisはNeonをxhighで実行しましたが、highではスコア60、出力トークンは283Mではなく123Mになります。1ポイントを半分以下のトークンで得られる計算です。詳細なカーブはGemini 4 Neon thinking levelsガイドでご覧いただけます。
Fableの$26.54は、高い出力料金と高い冗長性が合わさった結果です。最高スコアの代償と言えます。
実際のエージェントワークロードは各モデルでいくらかかる?
2つのワークロードを定価で試算します。各モデルで同一のトークン数を使うと仮定しています(実際は同一にはならないため、予測ではなく料金比較として読んでください)。
| ワークロード | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| エージェントセッション:新規入力150K、キャッシュ読み取り1.35M、出力150K | $0.45 + $0.20 + $2.25 = $2.90 | $1.50 + $0.54 + $6.00 = $8.04 | $1.50 + $0.27 + $6.00 = $7.77 |
| 長いリクエスト1件:入力400K、出力8K、キャッシュなし | $1.20 + $0.12 = $1.32 | $6.40 + $0.48 = $6.88 | $3.20 + $0.32 = $3.52 |
AstraとFableは最初の150Kを100万トークンあたり$10のキャッシュ書き込みとして課金しますが、Neonには書き込み料金がありません。長いリクエストの例はAstraの272Kルールを示しています。このラインを超えると、OpenAIはリクエスト全体に対して100万トークンあたり入力$16、出力$60を課金します。
もしNeonがあなたのプロンプトでAstraの3倍のトークンを書き出すなら、その$2.90のセッションはAstraのコストを上回る可能性があります。料金で選ぶ前に、出力トークン数を計測しましょう。
どのAPIの違いがエージェントハーネスを壊す?
各APIは、他のAPIが受け付ける設定を拒否します。
- Gemini 4 Neon:旧
thinking_budgetパラメータはHTTP 400を返します。frequency_penaltyとpresence_penaltyも同様です。カスタムのtemperature、top_k、top_pの値は無視されます(GoogleのCloud開発者ガイドによる)。 - GPT-6.2 Astra:
reasoning.effortをnoneに設定すると400を返します。またモデルページには、Realtime、Assistants、ファインチューニングが非対応と記載されています。 - Claude Fable 5.2:強制ツール使用(
tool_choiceをanyまたはtoolに設定)やtemperatureなどのサンプリングパラメータは400を返し、thinkingをオフにすることはできません。
AstraとFableの癖はGPT-6.2 Astra vs Claude Fable 5.2ガイドで詳しく解説しており、Neonのリクエスト形式はGemini 4 Neon APIガイドで扱っています。
各モデルはどこで最も力を発揮する?
Gemini 4 Neonは頻繁で複雑な作業向けに作られています。Googleによれば、冗長なファイル読み取りを削減し、安価なGemini 4 Hydrogenサブエージェントが各ステップを実行する間に計画を立てられるといいます。Google Antigravityでは、/swarmでエージェントを並列実行できます。
GPT-6.2 AstraはOpenAIのツールボックスを提供します。apply_patch、ホステッドシェル、computer use、MCP、そしてResponses APIのマルチエージェントベータです。Artificial Analysisではタスクあたり13.9分と、3モデル中最速です。Simon Willison氏はローンチ当日に、複数のベンチマークでFable 5.2をわずかに下回ると指摘しました。
Claude Fable 5.2は品質がコストを上回る場面での選択肢です。長時間のエージェントセッション、難易度の高いリファクタリング、調査タスクなど。$0.20のキャッシュ読み取りと100万トークンまでの定額料金が、$40という出力料金を和らげます。
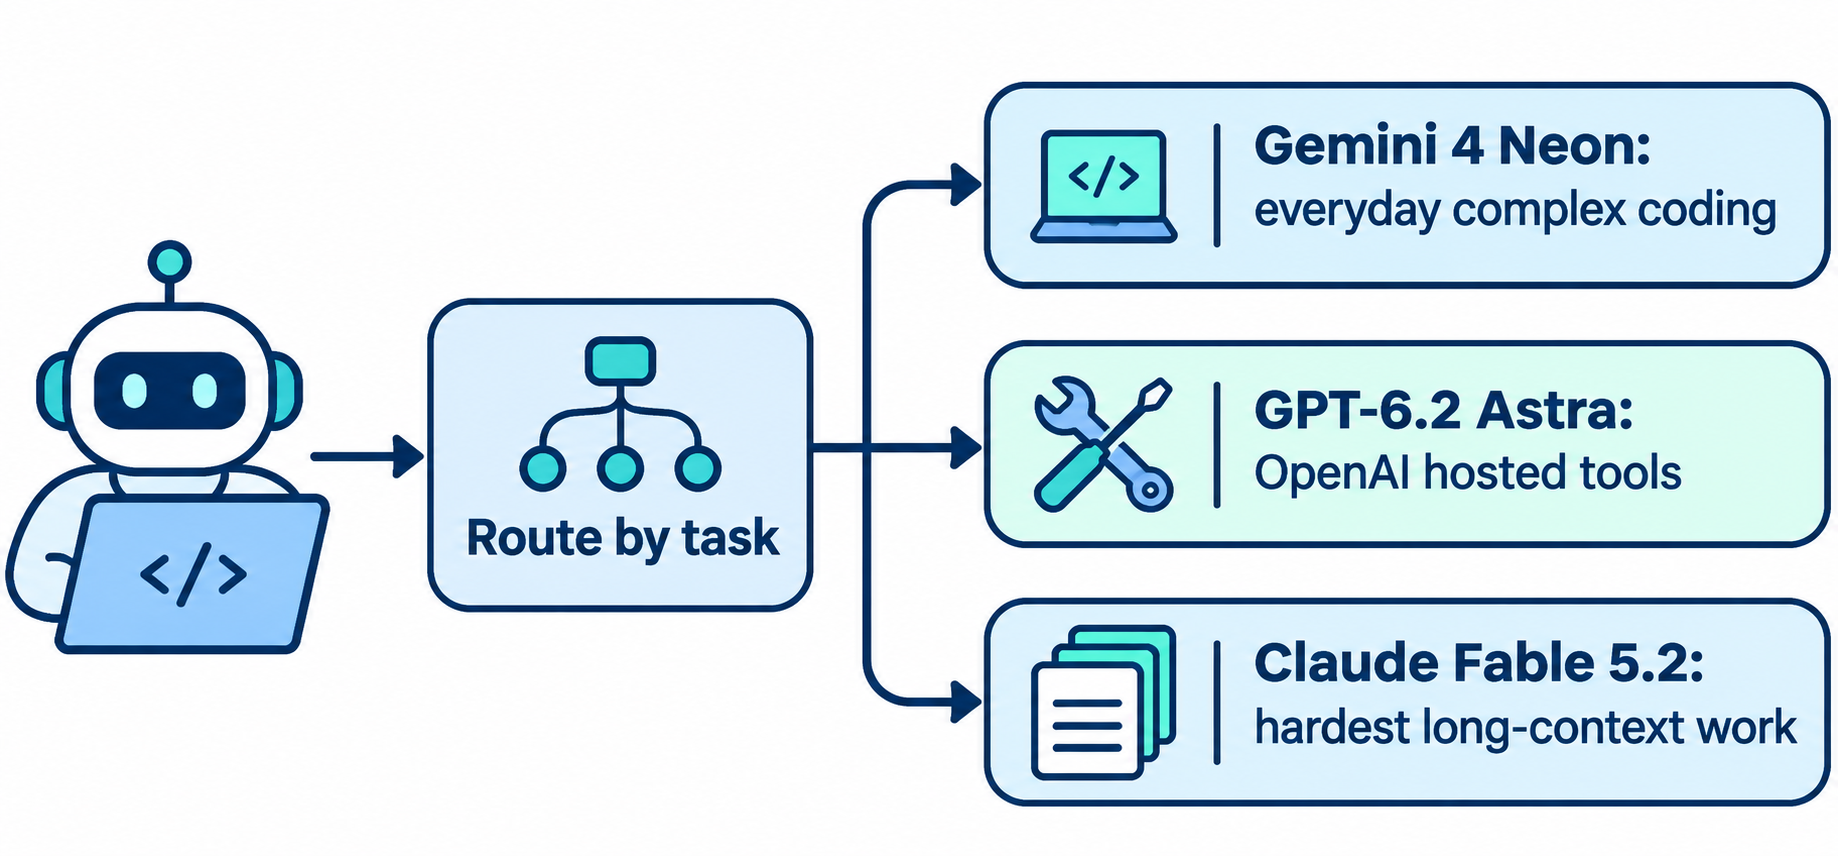
1つに絞る必要はありません。エージェントのステップの大部分をNeonに送り、Neonで失敗した少数のタスクをFableやAstraに送れば、平均コストはNeon並みに抑えられます。
自分のワークロードで3モデルすべてを試すには?
リーダーボードが測っているのは他人のタスクです。エージェントの履歴から実際のプロンプトを5〜10件選び、3つのAPIすべてに送って、合格率、トークン数、レイテンシを比較しましょう。そうしたリクエストを手作業で回すのはすぐに面倒になるので、Claude Code、Codex、CursorにApidog CLIを操作させましょう。セットアップは3つのコマンドで完了します。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、エージェントへ1つのプロンプトを渡します。
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
エージェントは各ペイロードのスキーマを検証し、テストケースを作成して実行します。以下のフラグはCLI 2.2.12のapidog run --helpに基づいています。
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
最後のコマンドをAstraとFableのケースIDで繰り返します。-n 5は各ケースを5回実行し、--upload-reportを付けるとApidogアプリで実行結果を確認できます。これはワークフローのテンプレートであり、本マシンから3つのAPIすべてに対して実行したものではありません。
前述の400エラーに対するネガティブケースを追加しておけば、プロバイダのルール変更をいち早くスイートで検知できます。エージェントのセットアップはClaude CodeでのApidog CLIガイドで解説しており、Apidogの無料プランは最大4ユーザーまで利用できます。
FAQ
Gemini 4 NeonはGPT-6.2 Astraより優れていますか? リーダーボード次第です。NeonはVals Indexでリードし(70.87%対67.66%)、AstraはArtificial Analysis Intelligence Indexで1ポイントリードしています(62対61)。Neonの料金は100万トークンあたり$3 / $15で、Astraの$8 / $40より安価です。
3つのうち最も安いのはどれ? トークンあたりではGemini 4 Neonで、100万トークンあたり入力$3、出力$15です。Artificial AnalysisのタスクあたりではGPT-6.2 Astraが$4.00で、Neon($6.44)やFable 5.2($26.54)よりはるかに少ないトークンしか書き出さないため最安です。
最も高いスコアを出すのはどのモデル? 2026年11月18〜19日時点で、Claude Fable 5.2がArtificial Analysis Intelligence Index(65)とVals Index(71.31%)の両方で首位です。
無料API枠があるモデルはありますか? ありません。GoogleはNeonに無料枠を設定しておらず、AstraとFable 5.2は有料APIモデルです。Google AI ProおよびUltraのサブスクライバーはGeminiアプリとAntigravityでNeonを利用できます。$0で使える選択肢についてはGemini 4 Neon無料ガイドをご覧ください。
同じエージェントで複数を使えますか? はい。定型ステップはNeonに、Neonで失敗するタスクはFable 5.2やAstraにルーティングしてください。まず各ルートをテストしましょう。タスクあたりのトークン数はモデル間で4倍以上異なります。