
Gemini APIを利用するすべてのチームにとって、「Gemini 4 Neon vs Carbon」は現実の選択肢となりました。Googleは2026年11月に、HydrogenとCarbonの中間に位置するモデルとしてNeonを追加しました。3つのモデルは1つのリクエストスキーマ、100万トークンのコンテキストウィンドウ、そして同じ組み込みツールを共有しています。異なるのは、どれだけ深く思考するか、どれだけ速く完了するか、そして1トークンあたりのコストです。
結論を先に: 日常的なコーディングやエージェントワーカーには、デフォルトでGemini 4 Hydrogen(100万トークンあたり入力$1.50/出力$7.50、無料枠あり)を使いましょう。マルチファイルのリファクタリングや密度の高いドキュメント分析など、複雑で頻繁に実行されるタスクはGemini 4 Neon($3/$15、有料プランのみ)に移行します。そして、最も難しいアーキテクチャ、デバッグ、セキュリティの問題にはGemini 4 Carbon(2026年11月30日まで$2/$10、以降$4/$20)を取っておきましょう。
Gemini 4 Neon vs Carbon vs Hydrogen:早見表
Gemini 4 Neonは、高頻度で実行する複雑なソフトウェアエンジニアリング、ナレッジワーク、サイエンス向けタスクのために作られた、GoogleのGemini 4中間モデルです。Hydrogenよりも深く推論し、Carbonよりも少ない出力トークンでより速く完了します。価格は有料プラン限定で、100万入力トークンあたり$3、100万出力トークンあたり$15です。
以下は、Googleのモデル選択ガイドとGemini API料金ページ(いずれも2026年11月19日時点で確認)から抜粋した比較表です:
| Gemini 4 Hydrogen | Gemini 4 Neon | Gemini 4 Carbon | |
|---|---|---|---|
| モデルID | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| 位置づけ | 高速なデフォルト | 複雑かつ高頻度のタスク | 最強の推論 |
| 速度(Googleの表記) | Fast | Moderate | Deliberate |
| 入力/出力(100万トークンあたり) | $1.50/$7.50 | $3.00/$15.00 | 11月30日まで$2.00/$10.00、以降$4.00/$20.00 |
| キャッシュ済み入力(100万トークンあたり) | $0.075 | $0.15 | $0.10、以降$0.20 |
| 思考レベル | low、medium、high(デフォルト)、xhigh | low、medium、high(デフォルト)、xhigh | low、medium(デフォルト)、high |
| 無料API枠 | あり | なし | なし |
| コンテキストウィンドウ | 1,048,576トークン、統一 | 1,048,576トークン、統一 | 1,048,576トークン、統一 |
3モデルすべてがテキスト、画像、動画、音声、PDF入力に対応し、関数呼び出し、構造化出力、コード実行、コンピュータ操作、Google検索グラウンディングをサポートしています。それぞれ同期出力の上限は65,536トークンで、long decodeを使えば100万トークンまで拡張できます。
どのGemini 4モデルを使うべきか?
Google自身のガイダンスは簡潔で、出発点として従う価値があります:
- ほとんどの新規プロジェクトはHydrogenから始める: 日常的なコーディング、インタラクティブなアプリ、ツールを使うエージェント、マルチモーダルなドキュメントパイプラインなど。Googleによると、Gemini 3.8 Flashと比較して捏造された主張を5倍以上削減できるとのことです。
- Hydrogenでは不十分で、Carbonの追加検証が不要な場合はNeonにステップアップ: リポジトリレベルのデバッグ、マルチファイルのリファクタリング、1日に何度も実行される法務・金融・科学分析など。
- システムアーキテクチャ、マルチファイルのデバッグ、形式的証明、セキュリティ監査、または高速なモデルが行き詰まるあらゆるタスクにはCarbonを取っておく。
- 翻訳、抽出、要約など大量のテキスト処理にはGemini 3.5 Flash-Lite($0.30/$2.50)へダウングレードする。
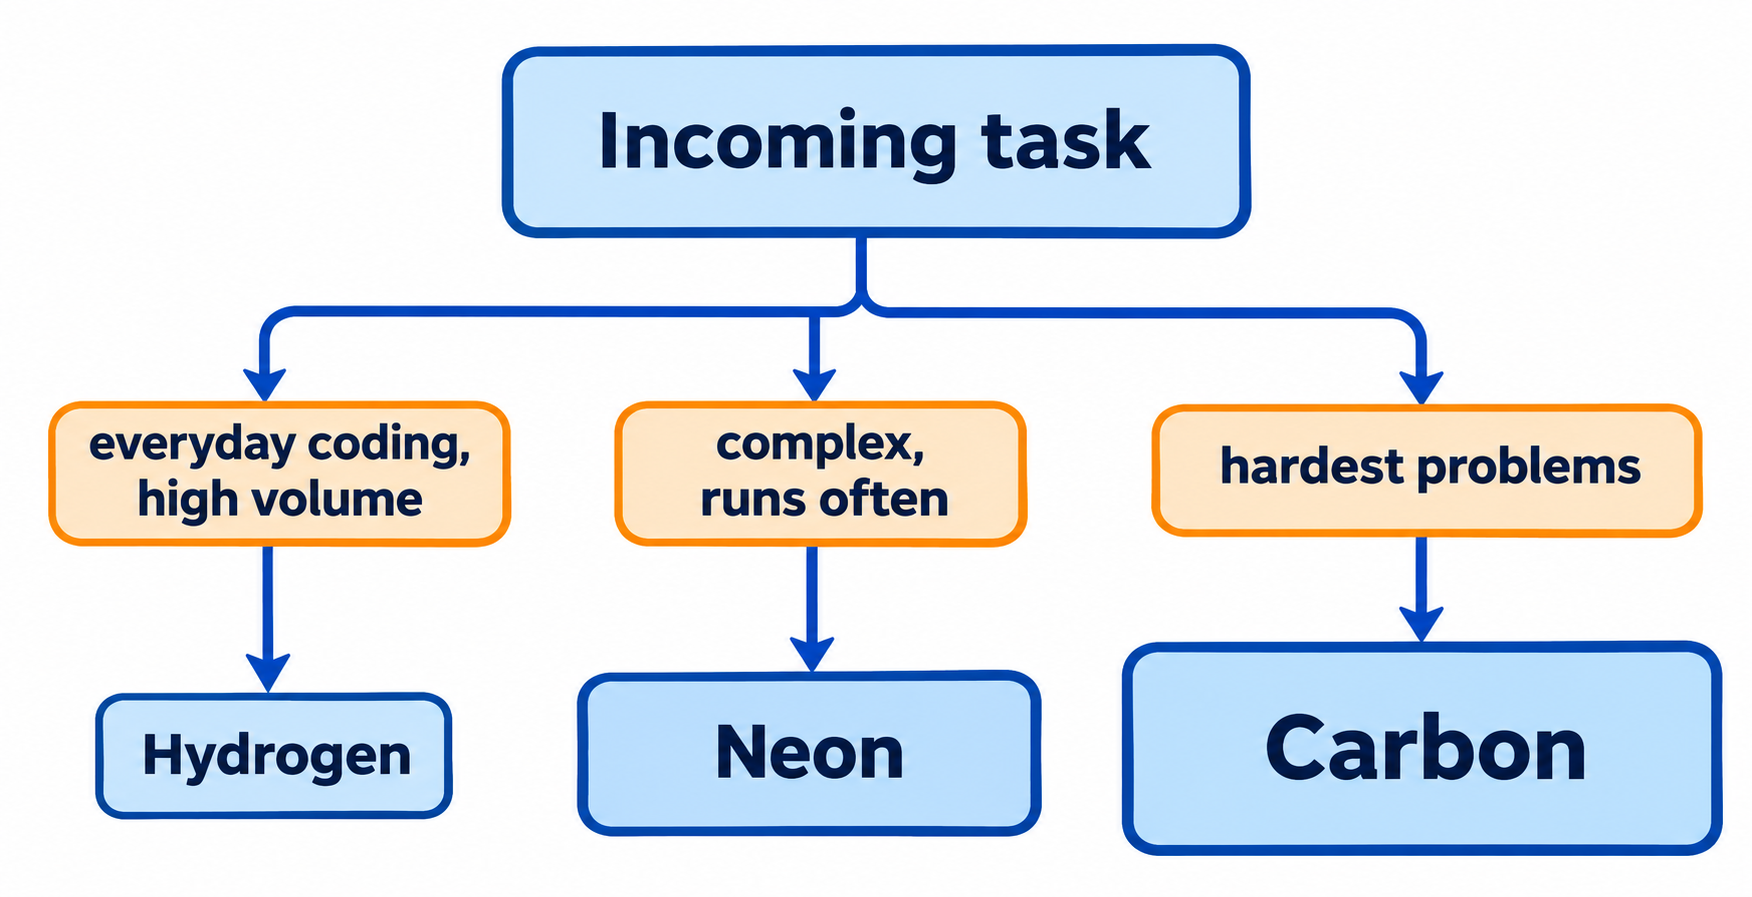
Neonにとってのキーワードは「頻繁」です。四半期に一度のセキュリティ監査なら、Carbonの遅い推論でも問題ありません。しかし週に200件のプルリクエストに触れるリファクタリングエージェントには、素早く完了しつつ難しい部分も正確にこなせるものが必要です。
Gemini 4 Neon vs Carbon:価格と推論の深さ
これはほとんどのチームが気にする比較です。NeonとCarbonはどちらも難しいタスクを対象にしているからです。
推論スタイル。 Carbonはターンごとに多くの思考トークンを使い、仮説の検証、リポジトリ全体にまたがる根本原因の特定、テストに対する修正の確認を行います。Neonはより少ないトークン使用でフロンティアレベルの品質を目指します。GoogleのWhat’s new in Gemini 4 Neonページによると、リポジトリレベルのデバッグをより少ないステップで完了させ、長いツール呼び出しセッションでの冗長なファイル読み取りを削減し、コンテキスト圧縮を確実に処理できるとのことです。
デフォルト値が異なる。 Carbonはデフォルトがmedium思考で、上限はhighです。Neonのデフォルトはhighで、最も難しいマルチステップの問題に向けてxhighを追加しています。thinking_levelを設定せずにCarbonからNeonに切り替えると、モデルの思考の深さも変わってしまいます。
12月1日に価格関係が逆転。 2026年11月30日までは、Carbonの導入価格($2/$10)はNeon($3/$15)よりもトークンあたり実際に安くなっています。12月1日からはCarbonが$4/$20に倍増し、Neonの方がトークンあたり25%安くなります。Neonには導入価格がないため、その料金は変動しません。
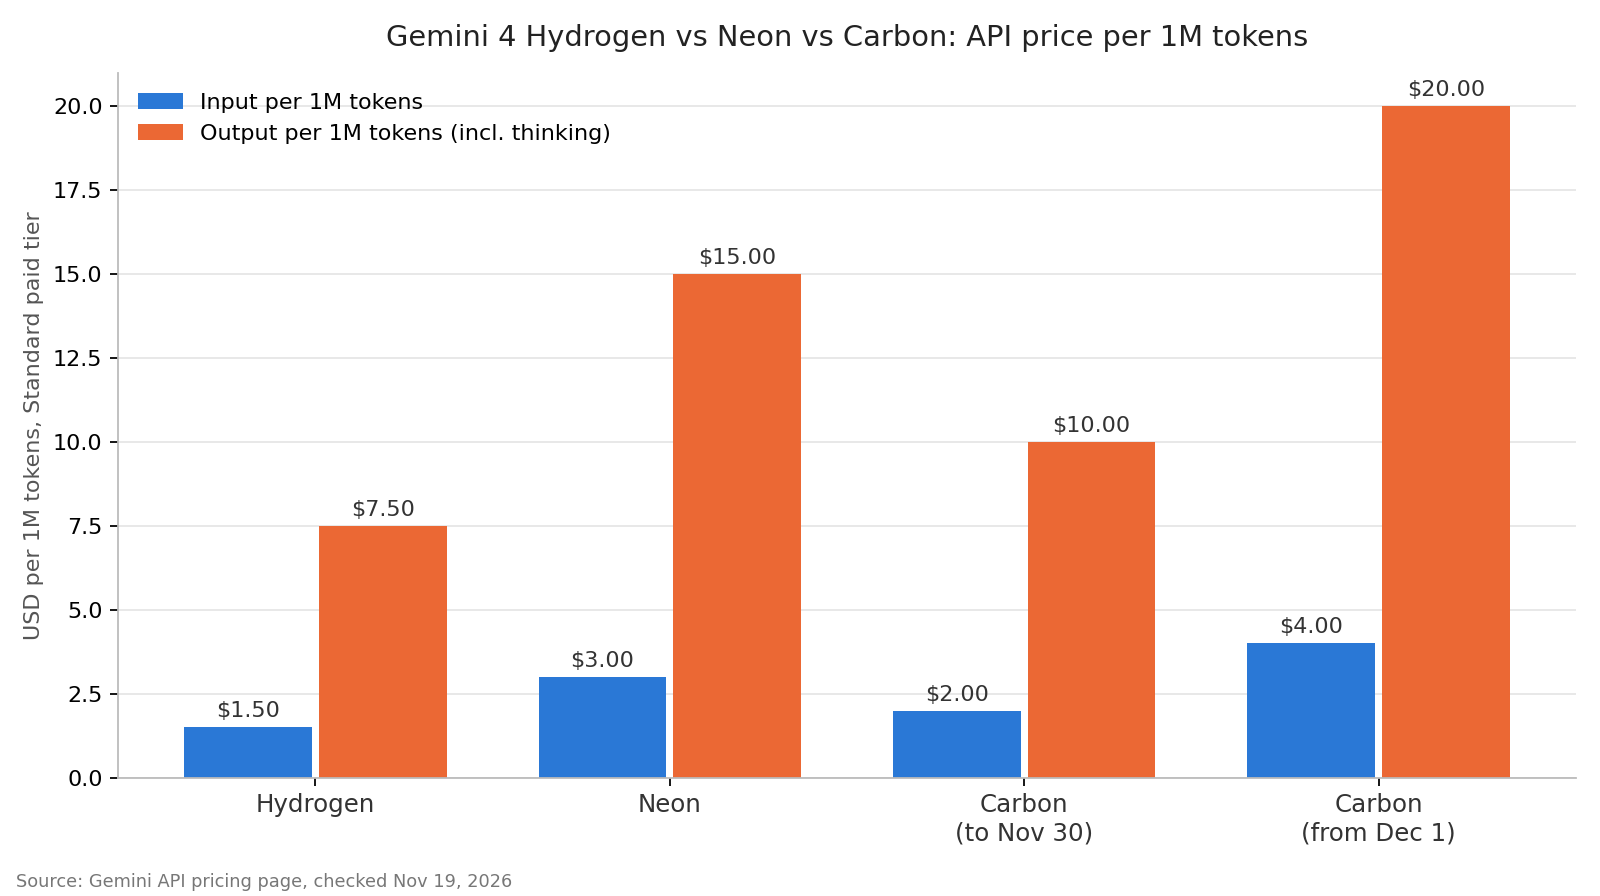
ただし、トークンあたりの価格は請求額の半分にすぎません。出力価格には思考トークンが含まれており、Carbonはより多く考えるように設計されています。
Gemini 4 Neon vs Hydrogen:アップグレードが見合うとき
HydrogenとNeonは書面上は似ています。同じ思考レベル、同じデフォルト、同じコンテキストウィンドウ、同じツール。Neonはトークンあたり正確に2倍の費用がかかります。
アップグレードが見合うのは、Hydrogenの回答がリトライを余儀なくさせるときです。Hydrogenが3回の試行を必要とするマルチファイルのリファクタリングをNeonが1回で完了できるなら、「安い」モデルの方が結果的に高くつきます。
実務上の2つの違い:
- 無料枠。 Hydrogenにはプロトタイピング用の無料API枠があります。Neonにはなく、最初の呼び出し前に有料プランのプロジェクトが必要です。無料枠では、Googleが製品改善のためにあなたのデータを使用する場合があります。
- バッチ料金。 どちらもBatchモードでは価格が半減します。Hydrogenは$0.75/$3.75に、Neonは$1.50/$7.50に下がります。夜間のNeonバッチジョブは、リアルタイムのHydrogen呼び出しとトークンあたり同額になります。
すでにCarbonをプランナーとしてHydrogenを高速ワーカーとして運用している場合は、Gemini 4 Hydrogenオーケストレーターパターンの解説をご覧ください。Neonはその構成に、中程度の難易度のステップ向けの第三のレーンを加えます。
タスクあたりのコスト:計算例
入力40,000トークン、出力8,000トークン(思考を含む)のエージェントタスクを、Standard有料プラン料金で計算してみます:
| モデル | 入力コスト | 出力コスト | タスクあたり | 1,000タスクあたり |
|---|---|---|---|---|
| Hydrogen | $0.060 | $0.060 | $0.12 | $120 |
| Neon | $0.120 | $0.120 | $0.24 | $240 |
| Carbon(11月30日まで) | $0.080 | $0.080 | $0.16 | $160 |
| Carbon(12月1日以降) | $0.160 | $0.160 | $0.32 | $320 |
この表は各モデルが同じ数のトークンを使用すると仮定していますが、実際はそうなりません。Googleによれば、Carbonはターンごとに多くの思考トークンを使い、NeonはCarbonよりも少ない出力トークンで完了します。同じタスクでCarbonが12,000出力トークンを必要とする場合、12月のコストはタスクあたり$0.40に上昇し、Neonとの差は$0.08から$0.16に広がります。これらのトークン数は例示です。予算を組む前に自身の実測値を測定してください。
請求額を削減する3つのレバー:
- 暗黙的キャッシング。 4,096トークン以上のプロンプトではデフォルトで有効になり、キャッシュされた入力を95%割り引きます。安定したシステムプロンプトとツール定義を先頭に置き、キャッシュにヒットさせましょう。
- 思考レベル。 Googleは、4つすべてのレベルで評価を実行し、品質基準を満たす最低のレベルを選ぶことを推奨しています。
xhighは最も多くのトークンとレイテンシを消費します。 - バッチモード。 急ぎでない作業は、Standard価格の半分のBatchモードに置きましょう。
Carbon価格の詳細なタイムラインについては、Gemini 4 Carbon料金ガイドをお読みください。
3モデルの切り替え:コードで何が変わるか
Gemini 4モデル間の切り替えに、リクエストスキーマの変更は不要です。変更するのはmodel文字列と、通常はthinking_levelだけです:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Find the race condition in this retry queue and propose a fix.",
    "generation_config": { "thinking_level": "high" }
  }'
ワークロードを移行するとき:
thinking_levelを明示的に指定する。 Carbonのデフォルトはmedium、NeonとHydrogenはhighです。指定しないまま切り替えると、コストとレイテンシが変わります。- NeonとCarbonには有料プランのプロジェクトを使う。 無料枠のキーがアクセスできるのはHydrogenとFlash-Liteだけです。
- サンプリングパラメータを外す。 Neonの移行ガイドによると、
temperature、top_p、top_kは範囲内では無視され、範囲外では400を返します。 previous_interaction_idでモデルを連鎖させる。 3モデルは同じスキーマを共有しているため、Carbonで計画し、Hydrogenで実装し、難しい中間ステップをNeonに1つの会話の中で任せることができます。
Apidog CLIでコーディングエージェントにモデルを比較させよう
Neon vs Carbon vs Hydrogenを決める最速の方法は、同じプロンプトを3モデルすべてに送り、ステータス、レイテンシ、トークン使用量を比較することです。Apidog CLIを使えば、あなたが作業を続けている間に、コーディングエージェントがそのテストを構築・実行してくれます。
CLIをインストールし、エージェントにApidogスキルを与えます:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、Claude Code、Codex、Cursorのいずれかに1つのプロンプトを与えます:
In Apidog project <id>, create a test scenario named "Gemini 4 model compare"
that POSTs to https://generativelanguage.googleapis.com/v1beta/interactions
with model {{model}}, thinking_level "high" and the prompt in {{prompt}}.
Assert status 200 and a non-empty output, and save the usage block to a variable.
Run it once each for gemini-4-hydrogen, gemini-4-neon and gemini-4-carbon,
then give me a table of latency and token usage per model.
エージェントはペイロードスキーマを読み、ファイルを検証し、シナリオを作成して、モデルだけを切り替えながら3回実行します:
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-hydrogen" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-neon" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-carbon" -r cli,json
GEMINI_API_KEYはApidogの環境に保存しておきましょう。--upload-reportを付けると各実行をアプリ内で確認でき、Googleがモデルを更新した際のリグレッションを検出するために、同じコマンドを-r junit付きでCIに組み込むこともできます。セットアップ全体については、Claude CodeでのApidog CLIガイドがエンドツーエンドで解説しています。ApidogのFreeプランは最大4ユーザーのチームまで対応しています。
FAQ
Gemini 4 NeonはGemini 4 Carbonより優れていますか? 一律にそうではありません。CarbonはGoogle最強の推論モデルです。Neonは、より速い完了とより少ない出力トークンと引き換えに、ある程度の深さを犠牲にしており、頻繁に実行される複雑な作業に適しています。
Gemini 4 Neonは無料ですか? いいえ。NeonはGemini APIの有料プラン限定で、Google AI StudioではGoogle AI ProおよびUltraプランで利用できます。無料API枠を持つGemini 4モデルはHydrogenです。
NeonはCarbonより安いですか? トークンあたりでは、2026年12月1日以降のみです。11月30日までは、Carbonの導入価格$2/$10がNeonの$3/$15を下回っています。それ以降はCarbonが$4/$20となり、Carbonの重い思考を考慮する前の段階で、Neonの方がトークンあたり25%安くなります。
Gemini 4 Neon、Carbon、Hydrogenは同じコンテキストウィンドウを持ちますか? はい。3モデルすべて、入力・思考・出力を合わせた1,048,576トークンの統一ウィンドウを共有し、同期出力上限は65,536トークン、long decodeで最大100万トークンまで拡張できます。
Neon、Carbon、Hydrogenを同じワークフローで使えますか? はい。リクエストスキーマを共有しているため、あるモデルのターンから別のモデルへprevious_interaction_idを渡せます。Carbonで計画し、Hydrogenで実装し、中間のステップをNeonに任せましょう。
最も速いGemini 4モデルはどれですか? Hydrogenです。Googleの表記では、HydrogenはFast、NeonはModerate、CarbonはDeliberateです。