
Gemini 4 Neonのthinking level(思考レベル)は、モデルが回答を出す前にどれだけ深く推論するかを決める4つの設定です。low、medium、high、xhighがあります。Neonのデフォルトはhighです。Googleは複雑な作業のほとんどではhighのままにしておき、難しい多段階の問題でhighが成果を出せない場合にのみxhighに切り替えることを推奨しています。というのも、xhighはより多くのトークンを消費し、時間もかかるからです。
Gemini 4 Neonのthinking levelとは?
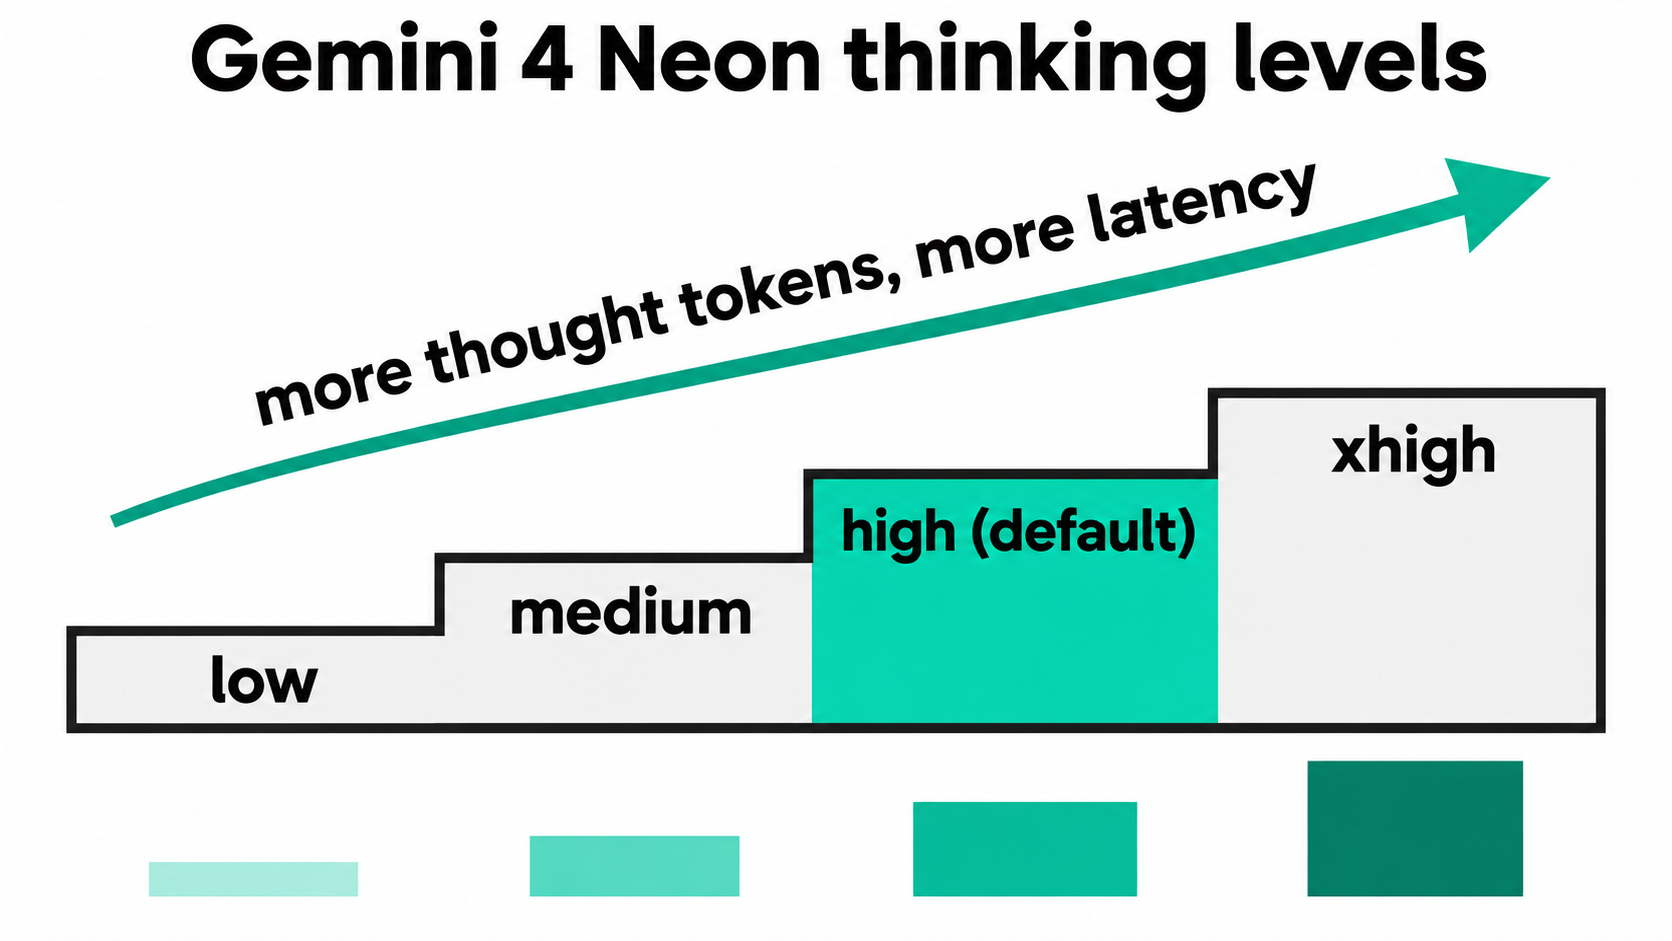
thinking levelはthinking_levelパラメータの値で、gemini-4-neonが返信を書く前にどれだけ内部推論を行うかを設定します。Neonがサポートするのはlow、medium、high(デフォルト)、xhighの4つです。レベルが高いほど思考トークンを多く使い、レイテンシーが増えます。レベルが低いほど回答が速く、コストも抑えられます。
Googleのthinkingガイドでは、Neonの各レベルを次のように説明しています。
thinking_level |
トークン使用量 | Google推奨の用途 |
|---|---|---|
low |
トークン最少、レイテンシー最小 | 高速チャット、高スループット処理。エージェントタスクでも一定の性能を発揮 |
medium |
トークン使用量が少なく、応答が速い | インタラクティブなコーディング、ライブUIプロトタイピング、レイテンシー重視のツール呼び出し |
high(デフォルト) |
知能と速度のバランス | 複雑なコーディング、エージェント実行、ツール呼び出し、マルチモーダルなナレッジワーク |
xhigh |
トークン最多、最も深い推論 | 難しい多段階のエンジニアリング、highでは不十分な分析・科学系の問題 |
予想される2つの値がありません。Neonはminimalをエラーで拒否するため、Gemini 3 Flashアプリからコピーしたコードがその値を送信すると壊れます。また、旧来のthinkingBudgetのトークン数はGemini 4では非推奨です。単独で送ると警告付きで最も近いレベルにマッピングされ、thinkingLevelと一緒に送ると400が返ります。
Neonのデフォルトは他のGemini 4モデルとどう違う?
Neonは上位モデルより1段階高い設定から始まります。Gemini 4 Neonのリリースノートによると、NeonとHydrogenはhighがデフォルトでxhighまでサポートしますが、CarbonとArgonはmediumがデフォルトでhighが上限です。
| モデル | デフォルトレベル | サポートレベル |
|---|---|---|
gemini-4-neon |
high |
low、medium、high、xhigh |
gemini-4-hydrogen |
high |
low、medium、high、xhigh |
gemini-4-carbon |
medium |
low、medium、high |
gemini-4-argon |
medium |
low、medium、high |
これはモデルを切り替える際に重要です。Carbonのワークロードをthinking_levelを設定せずにNeonへ移すと、すべてのリクエストがmediumからhighの推論に跳ね上がり、トークン数が変わってしまいます。より大型のモデルを比較検討しているなら、Gemini 4 Carbon vs Argonの比較でその違いを解説しています。
Gemini APIでthinking_levelを設定するには?
NeonはInteractions APIとgenerateContentの両方の有料枠で動作します。フィールド名は両者で異なります。
Interactions API:generation_configの中にthinking_levelを指定します。
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent:generationConfig.thinkingConfigの中にthinkingLevelを使用します。
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Python SDKでは、Interactionsの呼び出しはgeneration_config={"thinking_level": "high"}、generateContentの呼び出しはthinking_config=types.ThinkingConfig(thinking_level="low")となります。temperature、top_p、top_kは指定しないでください。Googleによると、Neonは範囲内の値を無視し、範囲外の値は400で拒否します。同じAPI設計で最初のリクエストを一通り試す方法は、Gemini 4 Hydrogen APIガイドをご覧ください。
highとxhighはいつ使い分けるべき?
デフォルトではhighを使い、そのタスクでhighが品質基準を満たせなかった場合にのみxhighへ上げてください。Googleのローンチ記事では、xhighを「最も難しいエンジニアリング、分析、科学系ワークロード向けの、より深い多段階推論」と位置づけています。
次の場合にxhighを選びます。
- タスクに依存関係の多いステップがあり、初期のミスが結果を台無しにする場合(複数ファイルのリファクタリングや並行性監査など)。
highが自信ありげな誤答を返した場合(単に遅いだけでなく)で、評価セット上で確認できたとき。- レイテンシーがほとんど問題にならない場合(バックグラウンドジョブ、夜間レビュー、バッチ分析など)。
- 誤答のコストがトークンより大きい場合(セキュリティパッチや財務計算など)。
次の場合はhighのまま(または下げる)にします。
- プロンプトが抽出やフォーマット処理の場合。Googleは、
xhighは「テキスト抽出やJSON抽出のような単純なプロンプトで考えすぎたり、max_output_tokensを使い果たしたりする可能性がある」と警告しています。 - ユーザーが待っている場合。チャット、オートコンプリート、ライブのツール呼び出しには
mediumまたはlowが適しています。 - 大量に実行する場合。追加の思考トークンはすべて課金され、その差はリクエスト数に応じて倍増します。
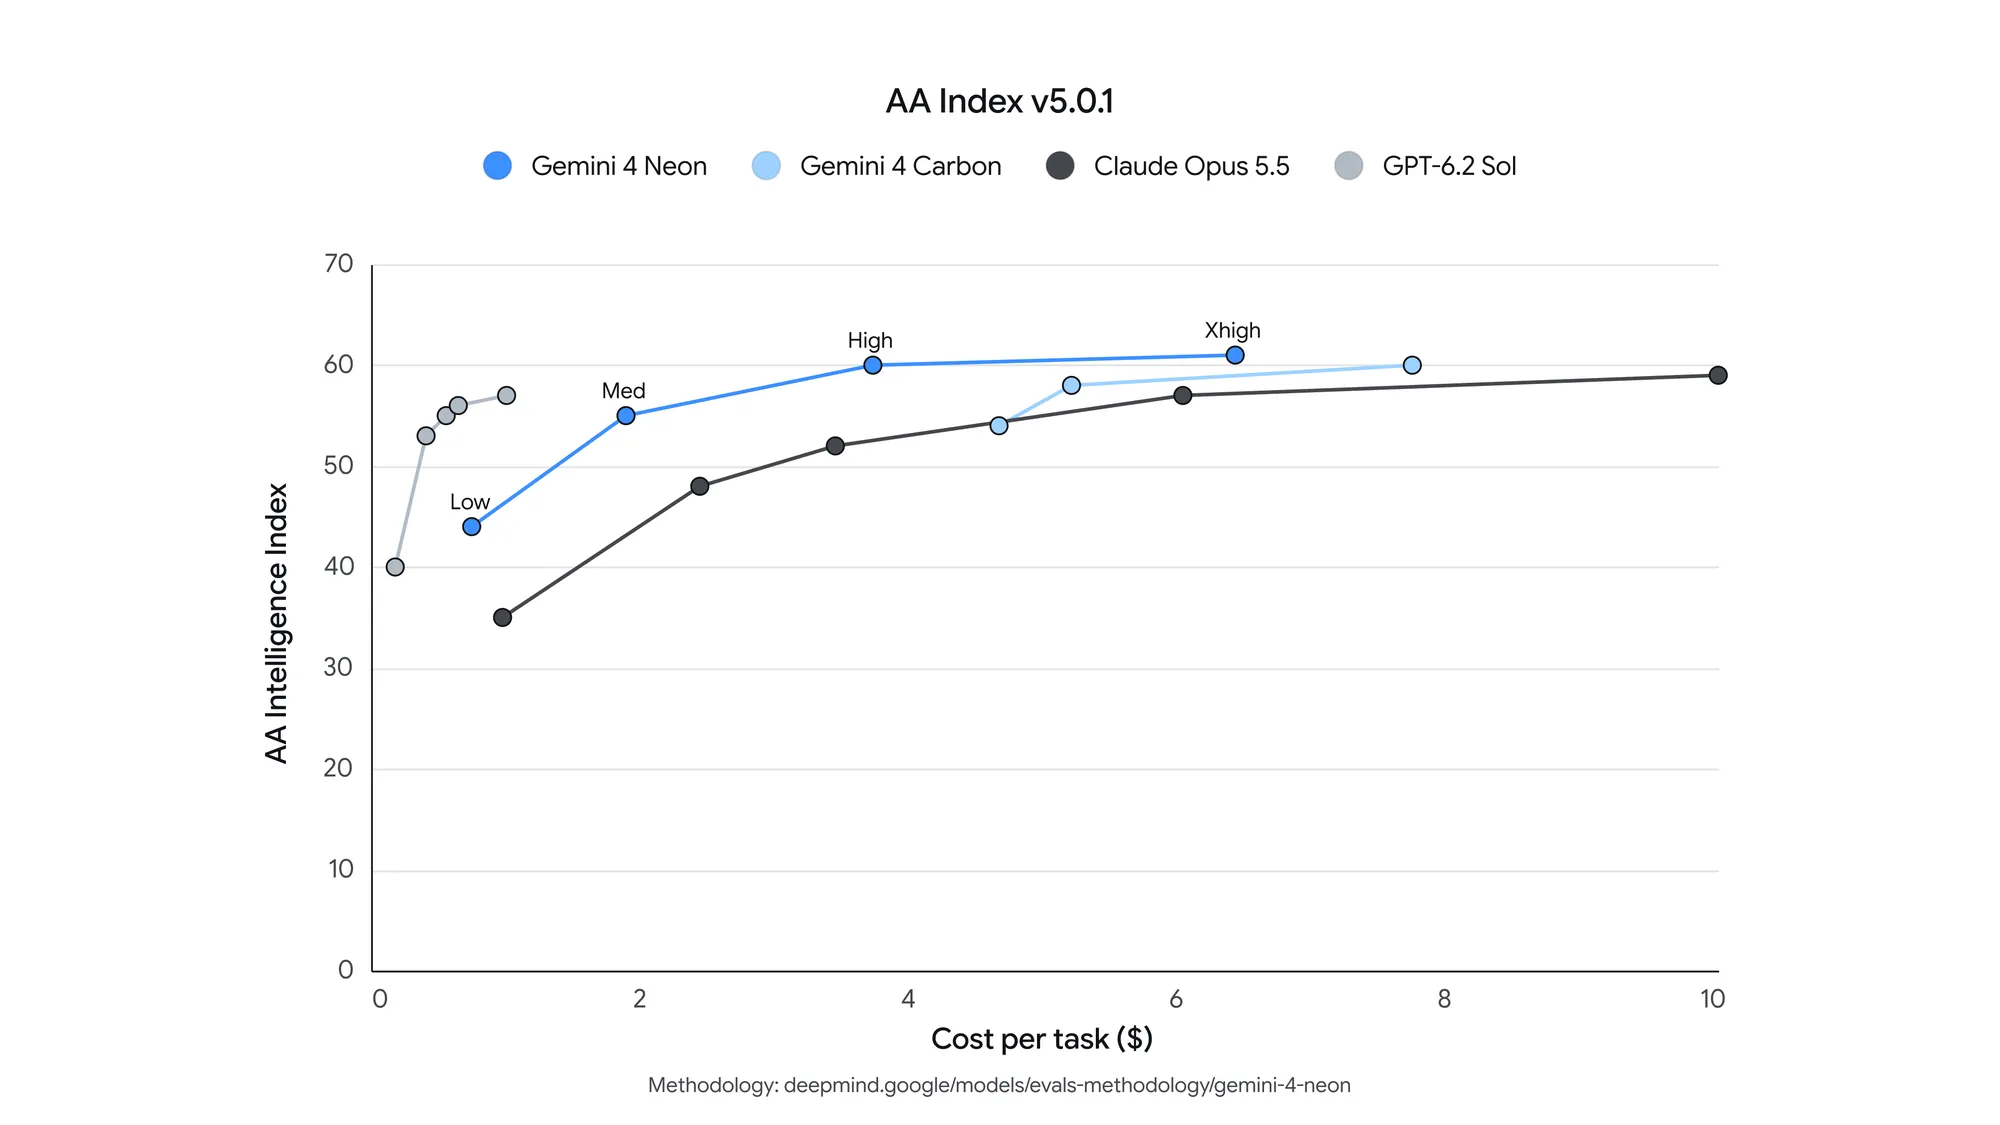
Googleのベンチマーク数値もこの使い分けを裏付けています。ローンチ発表によると、xhighのNeonはArtificial Analysis Intelligence Indexで61を記録し、3位にランクされています。デフォルトのhighでは、GoogleはCarbonよりタスクあたりのコストが32%低いと報告しています。これはGoogleの数値であり当社のテストではありませんが、トレードオフを示しています。xhighはNeonの最高スコアを買い、highは効率を買うのです。
各thinking levelのコストは?
各レベルのトークン単価は同じで、変わるのは支払うトークン数です。Neonは入力100万トークンあたり$3.00、出力100万トークンあたり$15.00で、Googleの料金ページには出力料金に思考トークンが含まれると記載されています。キャッシュされた入力は暗黙的キャッシュにより100万トークンあたり$0.15に下がります(Neonでは明示的キャッシュはサポートされていません)。このモデルに無料枠はありません。
つまり、あるレベルのコストは、そのレベルが追加する思考トークン数×100万トークンあたり$15です。以下は、入力2,000トークン、可視回答800トークンの1リクエストにおける計算です。思考トークン数は計算方法を示すための仮定値であり、実測値ではありません。
| 思考トークン(仮定) | 入力コスト | 出力+思考コスト | 1リクエストあたり合計 | 10,000リクエストあたり |
|---|---|---|---|---|
| 500 | $0.006 | $0.0195 | $0.0255 | $255 |
| 2,000 | $0.006 | $0.042 | $0.048 | $480 |
| 8,000 | $0.006 | $0.132 | $0.138 | $1,380 |
思考はすぐに請求の大部分を占めます。思考トークンが8,000の場合、推論がリクエストコストの87%を占めます。だからこそGoogle自身も、4つのレベルすべてで評価を実行し、「品質基準を満たす最も低いthinking_levelを選ぶ」よう推奨しています。より安価なモデルで同じトレードオフを比較したい場合は、Gemini 3.8 Flash thinking levelsガイドで解説しています。
レベルごとのトークンとレイテンシーを測定するには?
同じプロンプトを各レベルで実行し、usageブロックを確認します。Interactions APIでは、レスポンスのusageオブジェクトがtotal_input_tokens、total_output_tokens、total_thought_tokensを個別に報告します。generateContentでは、思考トークンはusageMetadata.thoughtsTokenCountとして現れます。
次のループは1つのプロンプトを4つのレベルすべてに送り、思考トークンと実時間を出力します。
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
実際のワークロードから10〜20個のプロンプトで実行してください。1つのプロンプトではほとんど分かりません。セットで実行すると、highとxhighが品質で食い違い始める箇所が見えてきます。
テスト中はHTTPクライアントのタイムアウトを長めに設定してください。Googleの移行ノートによると、難しいプロンプトは数分かかることがあり、少なくとも15分のタイムアウトかバックグラウンド実行を推奨しています。
xhighが空の回答を返すことがあるのはなぜ?
max_output_tokensは思考と可視出力をまとめて上限設定します。Neonが予算全体を推論に費やすと、インタラクションはステータスincompleteで停止し、切り詰められた回答または空の回答を返します。しかも生成された思考トークンには依然として課金されます。
Googleのドキュメントにある3つのルールでこれを回避できます。
- 古い低い上限を外す。アプリが8,192などをハードコードしている場合は、デフォルトの同期上限である65,536に引き上げます。
- 上限ではなくレベルを下げる。コストやレイテンシーを削減するには、
max_output_tokensを縮めるのではなくmediumまたはlowに下げます。 - 長時間の作業はバックグラウンドへ。65,536トークンを超える回答には、
backgroundをtrueに設定し、max_output_tokensを入力分を差し引いた1,048,576までにします。入力、思考、出力は1つの1Mトークンウィンドウを共有します。Gemini 4 Argon長出力ガイドでポーリングパターンを解説しています。
Apidog CLIでコーディングエージェントに4つのレベルすべてをベンチマークさせる
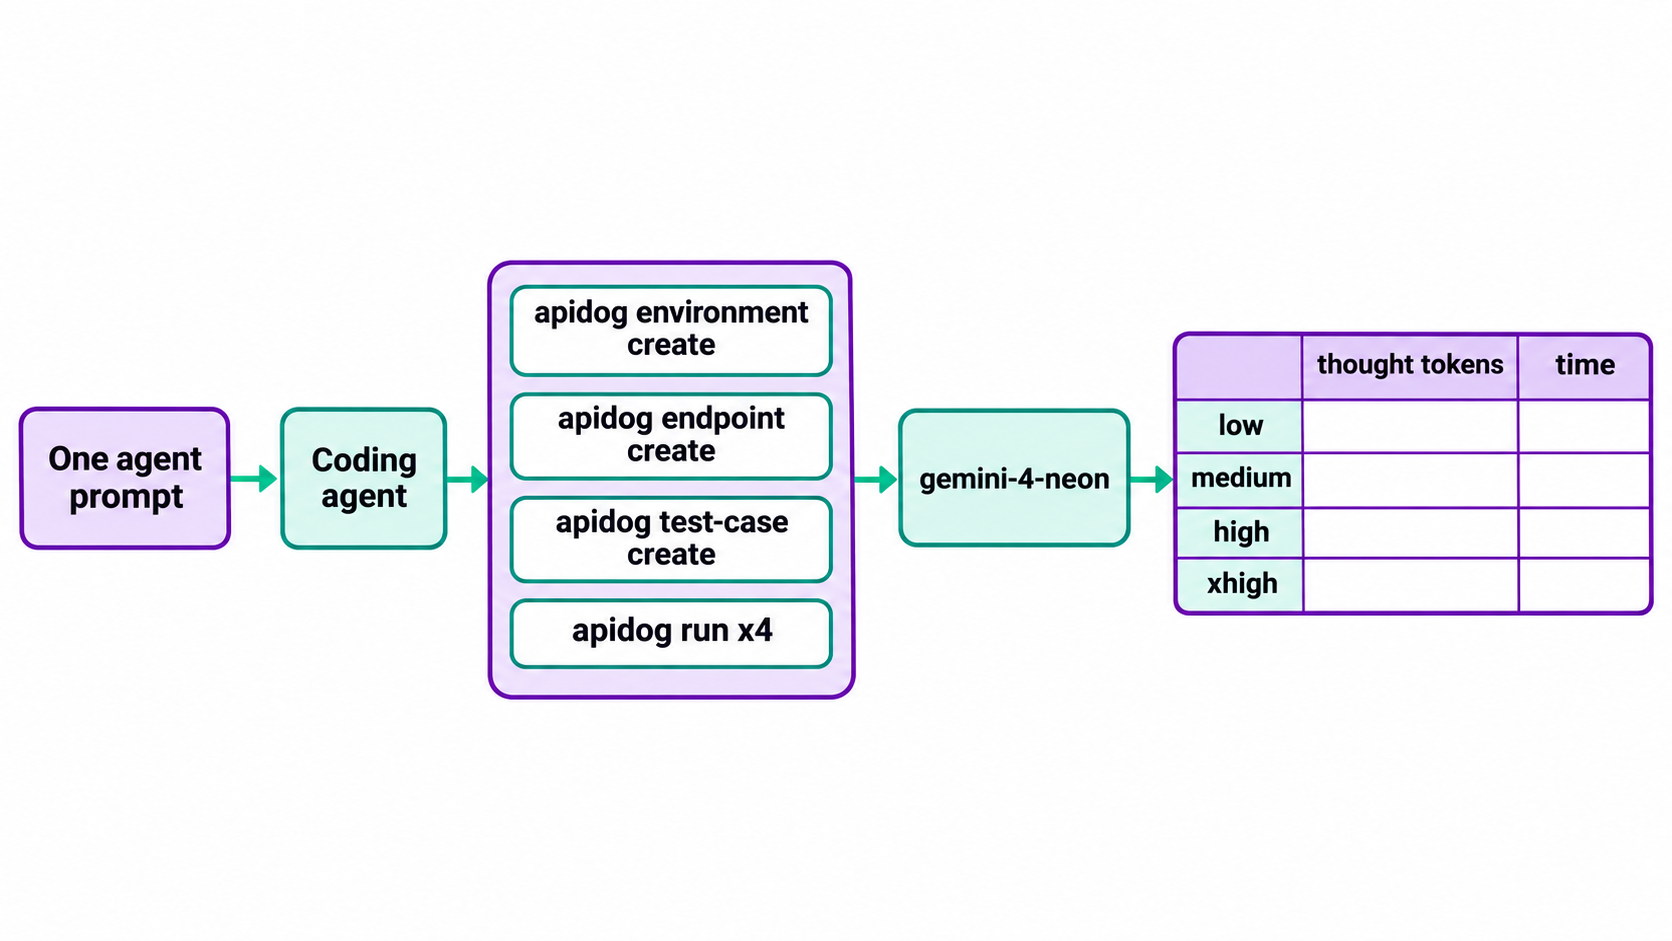
あのループを手動で再実行するのは面倒になってきます。代わりに、コーディングエージェント(Claude Code、Codex、Cursor)にApidog CLIで再利用可能なテストを1つ作らせ、新鮮な数値が欲しいときに各レベルで再実行させましょう。
一度だけセットアップします。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次にエージェントへ1つのプロンプトを渡します。
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
エージェントは各ペイロードスキーマを読み、JSONを検証し、リソースを作成して実行をループします。
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
status is "completed"のアサーションは前のセクションのincompleteの罠を捕まえるので、予算を使い果たしたレベルは空文字列を返すのではなく、はっきりと失敗します。-r cli,jsonを-r junitに替えれば同じ実行がCIに入ります。Apidog CLI CI/CDガイドでパイプラインを、Apidog CLI in Claude Codeでエージェントのセットアップを解説しています。ApidogのFreeプランは最大4ユーザーまで利用できます。
FAQ
Gemini 4 Neonのデフォルトのthinking levelは? highです。取得するのにthinking_levelを送る必要はありません。CarbonとArgonはmediumがデフォルトなので、それらから移行する際はレベルを明示的に設定してください。
Gemini 4 Neonはminimal thinkingをサポートしていますか? いいえ。Neonはlow、medium、high、xhighをサポートし、minimalはエラーで拒否します。最速で最も安価な応答にはlowを使用してください。
Gemini 4 Neonで思考トークンは課金されますか? はい。思考トークンは出力100万トークンあたり$15.00の料金で課金されます。Googleはモデルが処理するすべてのトークンを、思考トークンも含めてカウントします。
Gemini 4 NeonでthinkingBudgetをまだ使えますか? Gemini 4モデルでは非推奨です。単独で送ると最も近いthinkingLevelにマッピングされ、警告が返ります。thinkingLevelと一緒に送ると、リクエストは400で失敗します。
xhighは常にhighより正確ですか? 常にそうとは限りません。Googleによると、xhighはテキスト抽出やJSON抽出のような単純なプロンプトで考えすぎたり、max_output_tokensを使い果たしたりする可能性があります。自分のプロンプトで両方をテストし、合格する最も低いレベルを維持してください。
Gemini 4 Neonのthinking levelは無料で使えますか? いいえ。Gemini 4 NeonはGemini APIの無料枠では利用できません。Google AI StudioとGoogle Antigravityでは、有料のGoogle AI ProおよびUltraプランに紐付けられています。