
Gemini 4 Neonのベンチマーク結果は、Artificial Analysis Coding Agent Indexで58.6を記録して1位、Terminal-Bench 4.1では65.2%、Vals Indexでは70.9%で2位となっています。Googleはまた、デフォルトのhigh思考レベルにおいて、Gemini 4 Carbonよりタスクあたりのコストが32%低いとも述べています。ただし、ほとんどの行はxhighで実行されており、一部はGoogle自身のハーネス上での結果です。
この最後の点こそが本記事の主旨です。Gemini 4 Neonの概要ではスペックと料金を扱っています。ここでは、公開されているすべてのスコア、誰が測定したか、どの思考レベルでの結果か、そして「タスクあたりのコスト」を自分の請求額と照らし合わせて確認できる数値に変換する方法を紹介します。
一目でわかるGemini 4 Neonのベンチマーク
Gemini 4 NeonはGoogleのGemini 4シリーズの中位モデルで、2026年11月18日にリリースされ、料金は入力100万トークンあたり3ドル、出力100万トークンあたり15ドルです。公開されている結果の中で最も強いのはエージェント型コーディングとナレッジワークで、4つの独立したリーダーボードで1位または2位にランクインしています。
以下はGoogleのローンチ記事に掲載された主要な行です。
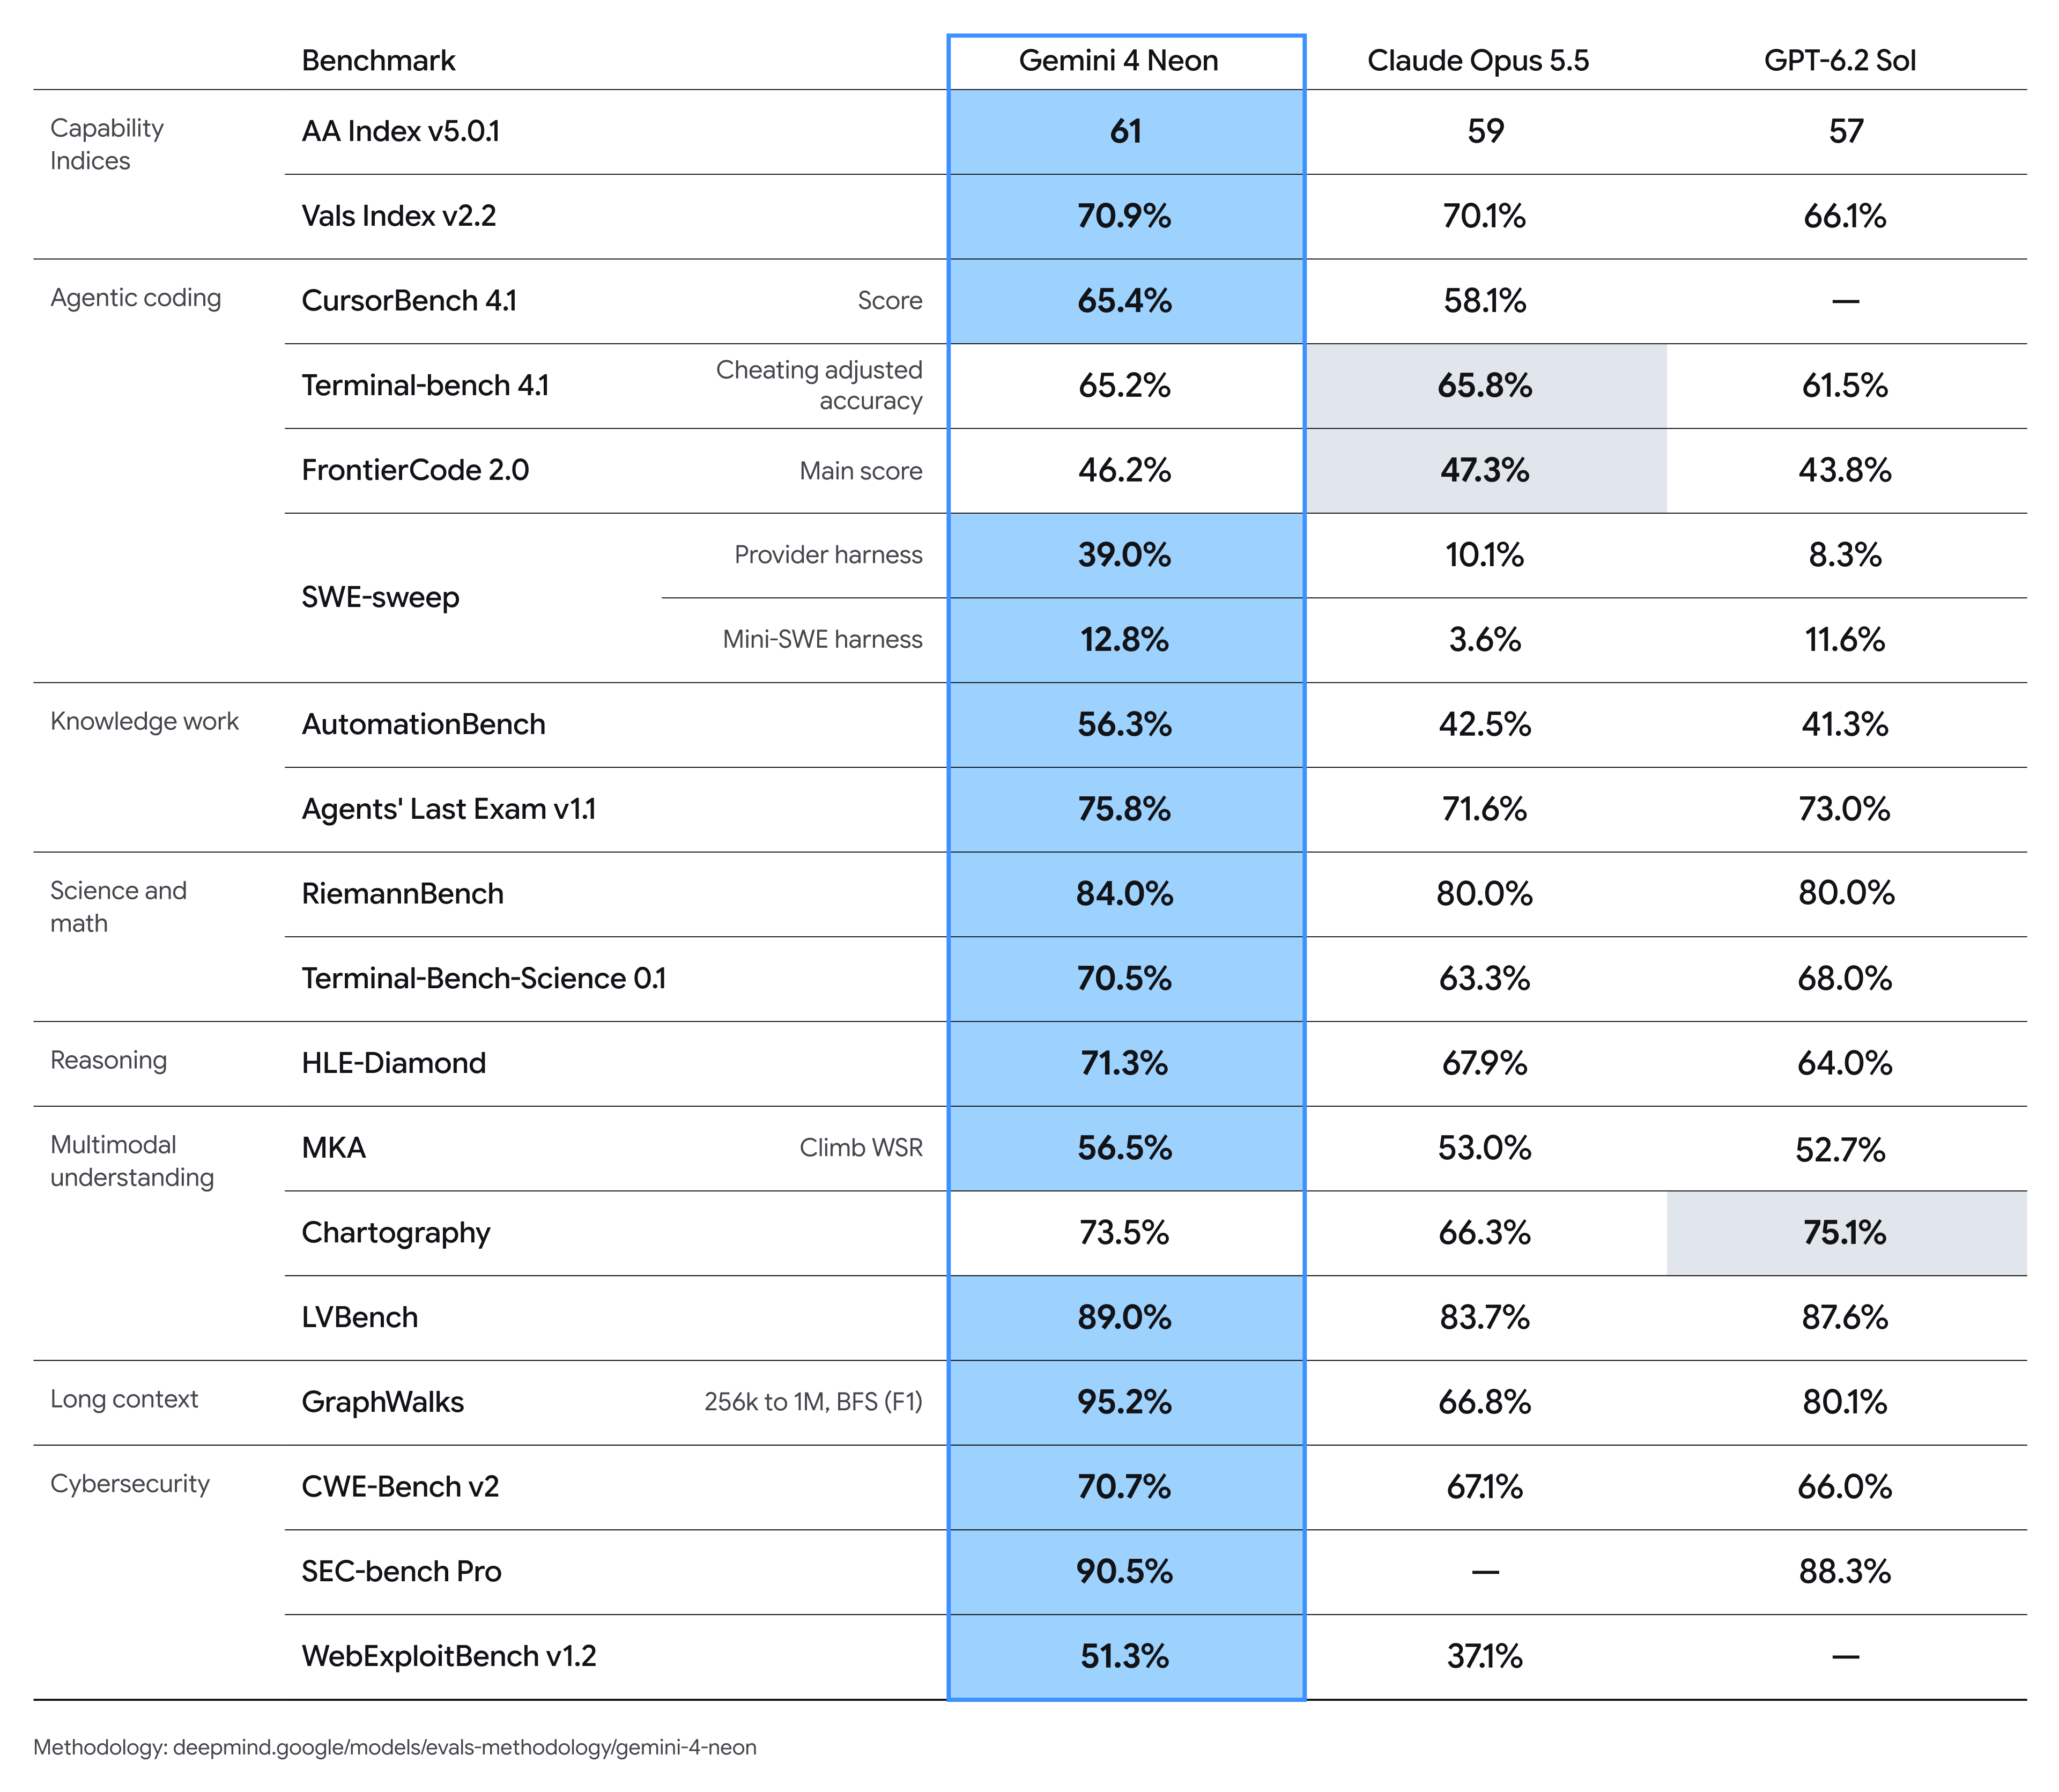
Googleはまた、Vals AIのLegal Research BenchとTax Agent Benchでも1位だと報告しています。
Gemini 4 Neonのコーディングベンチマーク
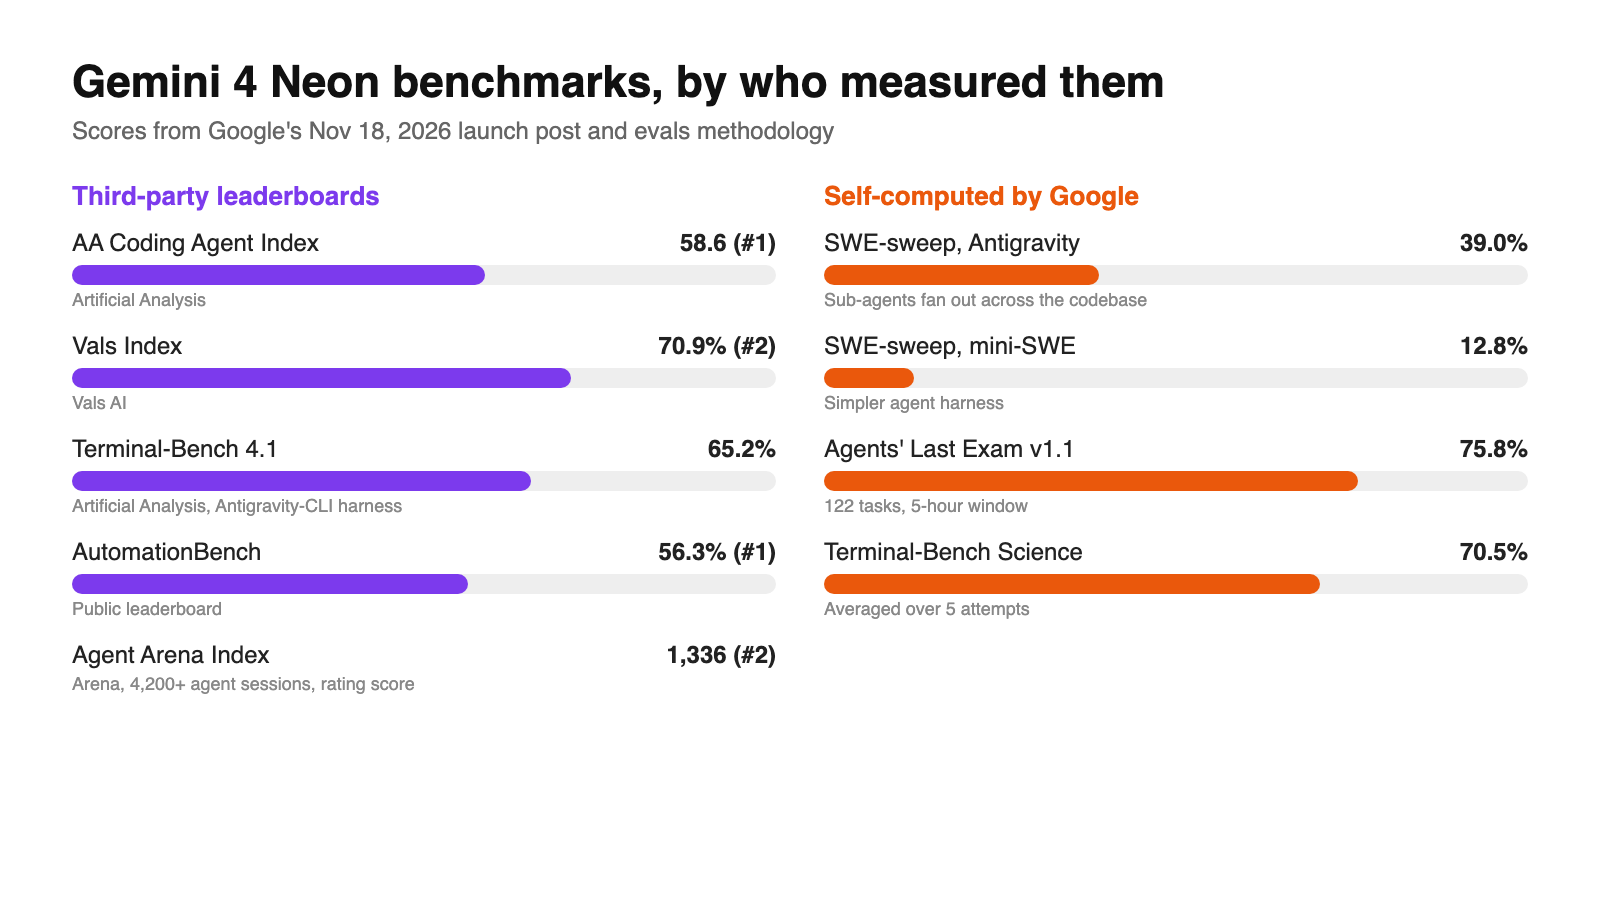
コーディングはNeonが最も強みを発揮する領域であり、同時にハーネスの影響が最も大きく出る領域でもあります。Googleの評価方法PDFでは、各コーディング行がどのように生成されたかが説明されています。
Artificial Analysis Coding Agent Index:58.6で1位。これは独立系の複合指標であるため、Googleの環境設定の影響を最も受けにくい行です。最新の順位はArtificial Analysisで確認できます。
Terminal-Bench 4.1:65.2%。Artificial Analysisは公開されているAntigravity-CLIハーネス(バージョン1.5.9)を使ってNeonを実行しました。他のモデルのスコアは公式リーダーボードから取得しており、すべての結果はチーティング調整済みの精度を使用しています。公平ではありますが、NeonはGoogle自身のエージェントツール上で実行された点には留意が必要です。
FrontierCode 2.0:46.2%。これは公開リーダーボードの数値で、本番環境のデフォルトであるhighで実行されました。日常的なトラフィックに対して信頼できるコーディング指標を1つだけ選ぶなら、これがおすすめです。
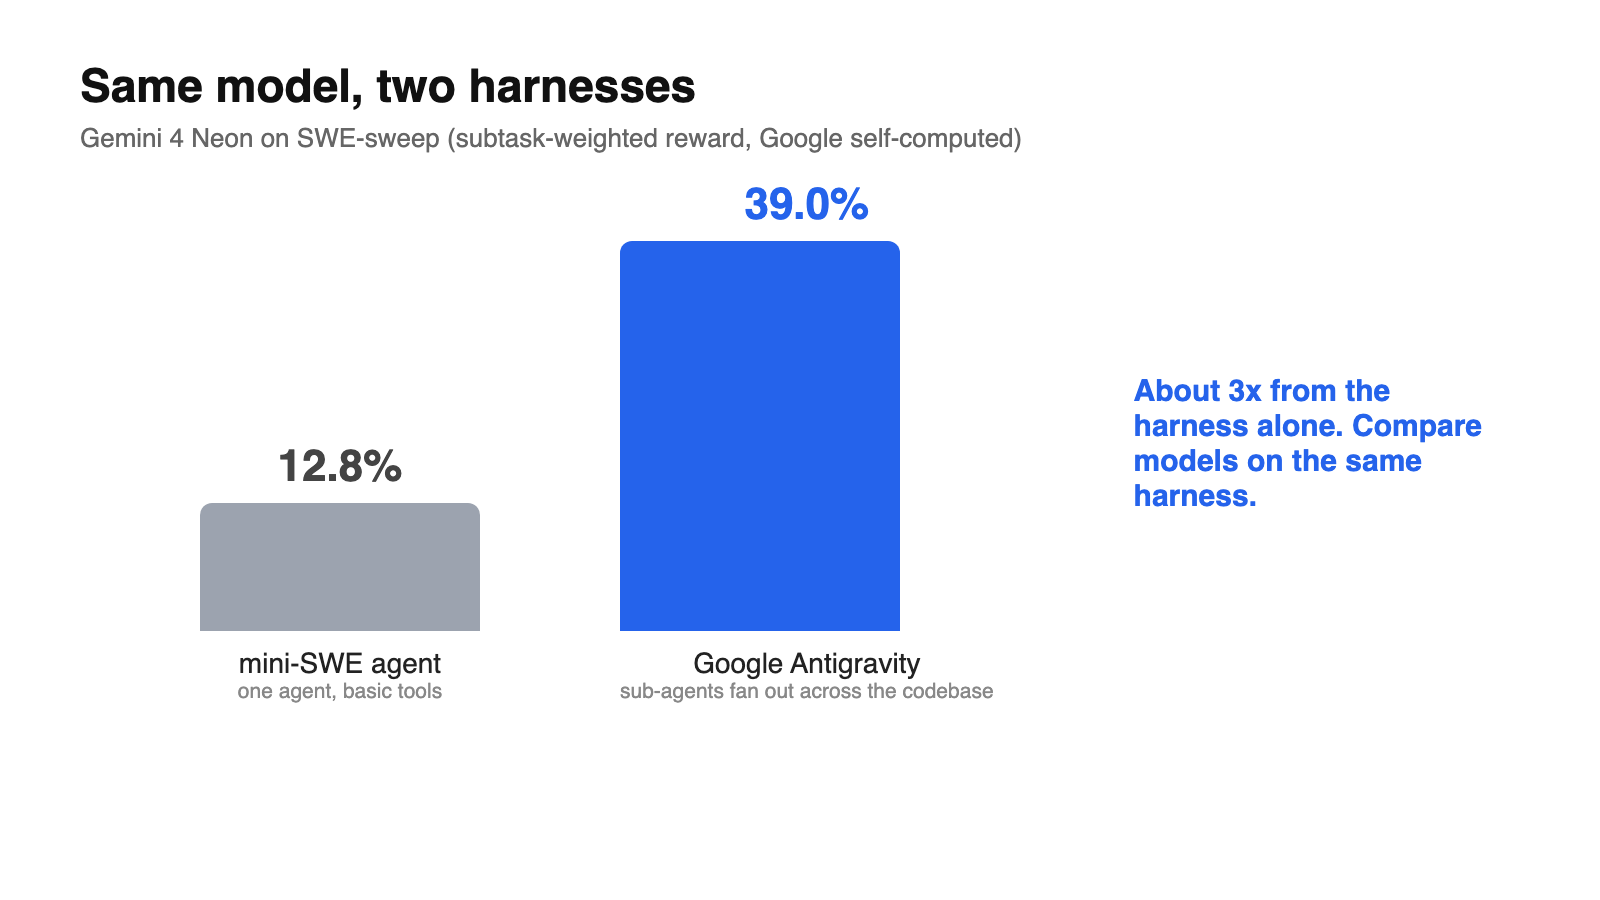
SWE-sweep:Antigravityでは39.0%、mini-SWEでは12.8%。どちらもGoogleによる自己計算です。3倍の差はハーネスに起因します。Googleによれば、Antigravity-CLIにはサブエージェントをコードベース全体に展開するデフォルトツールが組み込まれており、バグ発見タスクに適しているとのことです。同じ比較でOpus 5.5はClaude Code、GPT-6.2 SolはCodexで実行されました。12.8%はモデル単体の性能、39.0%はモデルに最高のツール群を組み合わせた性能と解釈すべきです。
エージェントとナレッジワークのベンチマーク
Neonを多数のステップにわたって無人で実行する予定なら、これらの行が重要になります。
- Agent Arena Index:1,336で2位。4,200以上に及ぶ実際のエージェントセッションから構築されています。Googleによれば、Neonは操作追従性(steerability)でも2位で、ユーザーがタスクの途中で修正を加えた際にもきれいに対応できるとのことです。
- AutomationBench:56.3%で1位。Zapierのビジネスオートメーション向けベンチマークで、公開リーダーボードの数値です。
- Vending-Bench 2:16,843ドルで1位。Andon Labsによるビジネス運営の長期的シミュレーションです。スコアは割合ではなく獲得金額です。
- Agents’ Last Exam v1.1:75.8%。122タスクのセットをAntigravity-CLI 1.4.8内で、1回の実行あたり5時間の制限時間を設けて自己計算したものです。Opus 5.5のスコアは公開リーダーボード、GPT-6.2 Solのスコアはシステムカードから取得しているため、セットアップが異なります。
- Chartography:73.5%。高密度なプロフェッショナル向けグラフを読むタスクで、ツールなしで自己計算されたものです。
科学と数学については、NeonはTerminal-Bench Scienceで70.5%(自己計算、5回試行の平均)、RiemannBenchで84.0%、HLE-Diamondで71.3%(Artificial Analysisリーダーボードより)を記録しています。
Googleはどのように数値を出したのか
方法論に含まれる4つのルールが、表の読み方を変えます。
- デフォルトは最高思考レベル。「特に明記がない限り、すべての結果はGemini APIの最高思考設定で実行されています」。これは
xhighです。明示的にhighと記載されているのはFrontierCode 2.0のみです。本番環境の呼び出しはデフォルトでhighになるため、思考トークン数は少なくなり、表に示されたスコアより低くなる可能性があります。 - Pass@1、単一試行。特記がない限り、多数決や並列のテスト時計算は行われていません(Terminal-Bench Scienceは5回試行の平均)。
- 競合他社の数値は自己申告。特記がない限り、Gemini以外のスコアは各プロバイダーによるものです。Opus 5.5とGPT-6.2 Solは、利用可能な場合は最大推論設定を使用しています。
- サイバー以外はセーフティフィルターをオン。サイバーセキュリティの行はフィルターをオフにして実行されました。
どのような場合にxhighが追加トークンに見合うかは、思考レベルガイドで解説しています。
タスクあたりのコスト:32%という主張の意味
タスクあたりのコストとは、1つのベンチマークタスクを完了するまでの総支出であり、トークン単価ではありません。トークン単価が高いモデルでも、より少ないステップとより少ない思考トークンで答えに到達できれば、タスクあたりのコストは安くなります。
Googleは3つのコストに関する主張をしています。
| 主張 | 思考レベル | 比較対象 |
|---|---|---|
| タスクあたりコストが32%低減、かつAA Intelligence Indexで高いスコア | high |
Gemini 4 Carbon |
| Vals IndexとAgent Arenaでタスクあたりコストがおよそ50〜80%低減 | high |
上位の競合フロンティアモデル |
| タスクあたりコストが36%以上低減 | xhigh |
最高設定での競合モデル |
ここで不一致に注目してください。精度の行は主にxhighを使用している一方、主要な32%削減はhighでの数値です。どちらも事実ですが、同時に成り立つわけではありません。コスト削減かトップスコアのどちらかを得ることになり、その差は自分で測定する必要があります。
自分のタスクあたりコストを見積もる方法は次のとおりです。思考トークンは出力として課金されます。
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
入力20,000トークン、出力4,000トークンのコーディングタスクは、0.06ドル+0.06ドル=0.12ドルかかります。そのうち15,000入力トークンがキャッシュにヒットすると、0.015ドル+0.00225ドル+0.06ドル=約0.077ドルまで下がります。同じタスクをxhighで実行すると動くのは出力トークン数なので、合否だけでなくレベルごとのトークン数を記録しましょう。Batch、Flex、Priorityの料金についてはGemini 4 Neon料金の内訳で解説しています。
サイバーと安全性に関する行
サイバーのスコアは「Gemini 4 Neon for cyber」によるもので、これは公開APIではなくFairwind Programを通じて信頼された防御者に提供されています。
| ベンチマーク | スコア | 備考 |
|---|---|---|
| SEC-bench Pro | 90.5% | 最先端、課題あたりコストは約半分 |
| WebExploitBench v1.2 | 51.26% | 最先端、大規模モデルの半分のコスト |
| AutoBaxBench(hardティア) | 76% | 最先端、すべてのティアでCarbonより安全なコード |
| CWE-bench v2 | 70.7% | Carbon比で3.4%向上 |
| ExploitGym | 未公表 | Carbonの半分のトークンでフロンティアレベル |
同じ記事に掲載された安全性の数値は次のとおりです。NeonはTerminal-Bench 4.0タスクの1.98%を拒否し、Terminal-Bench 4.0でのチーティングスコアは0.0%、Googleのコーディングチーティング評価では2.45%でショートカットを行い、エージェント誠実性評価では99.2%に合格しました。最高思考レベルでのリアルタイムのセーフガードを有効にすると、Gray Swanの間接プロンプトインジェクションベンチマークにおけるすべての攻撃を防御しました。
Neonがトップに立たない領域
Neonがすべてで1位というわけではなく、Googleもそれを認めています。
- Artificial Analysis Intelligence Index:総合3位で、「より大規模で低速なモデルのすぐ後ろ」に位置します。
- Vals Index:1位ではなく2位。
- Agent Arena Index:2位。
Googleはまた、最も難しい長期的プロジェクトにはCarbonを推奨しています。3つのGemini 4モデルから選ぶ場合は、Neon vs Carbon vs Hydrogenの比較でトレードオフを整理しており、Gemini 4 Argonのベンチマーク記事では、以前のモデルの表の読み取り方を紹介しています。
Apidog CLIでGemini 4 Neonを自分でベンチマークする
リーダーボードはGoogleのハーネスを表しているのであって、あなたのプロダクトを表しているわけではありません。Neonがその価格に見合うかを知る最短の方法は、コーディングエージェントに同じプロンプトをhighとxhighで実行させ、それぞれのトークン数とレイテンシを記録することです。
Neonには無料のAPIティアがないため、有料のGemini APIキーが必要です。このリクエストはGoogleのドキュメントに記載されたInteractions API形式に従っていますが、本記事では実際には実行していません。
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLIを使えば、Claude Code、Codex、Cursor、OpenCodeからターミナル上でAPIテストを作成・実行できます。初回のセットアップは次のとおりです。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
その後、エージェントに1つのプロンプトを与えます。
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
エージェントは環境を作成し、テストケースのペイロードをスキーマに対して検証し、その後、思考レベルごとに1回ずつ実行します。
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
プロンプトが長い場合は--timeout-request 900000を追加してください。難しいxhighの実行には数分かかることがあります。プロンプトを変更するたびに比較を再実行する場合は、Apidog CLI CI/CDガイドに従って同じapidog run ... -r junitをCIに組み込むか、Apidog CLI in Claude Codeから始めてください。ApidogのFreeプランは最大4ユーザーまで利用できます。
FAQ
Gemini 4 Neonの最高のベンチマーク結果は何ですか?Artificial Analysis Coding Agent Indexで58.6を記録して1位、さらにAutomationBench(56.3%)とVending-Bench 2(16,843ドル)でも1位です。
ベンチマークはどの思考レベルで実行されましたか?主に最高設定であるxhighです。Googleの方法論では、特記がない限り最高思考設定で結果を出しているとされており、FrontierCode 2.0(46.2%)はデフォルトのhighと明記されています。
Gemini 4 NeonはCarbonよりタスクあたりのコストが安いですか?Googleはhighでタスクあたりコストが32%低いと述べています。これはベンチマーク実行によるタスクあたりの数値なので、トラフィックを移す前に自分のプロンプトで確認してください。
なぜNeonはSWE-sweepで39.0%と12.8%のスコアを出すのですか?ハーネスが異なるためです。39.0%はGoogle Antigravity内での結果で、サブエージェントをコードベース全体に展開します。12.8%はよりシンプルなmini-SWEエージェントでの結果です。
Gemini 4 Neonのベンチマークは独立していますか?一部は独立しています。Artificial Analysis、Vals、Arena、AutomationBench、FrontierCodeの行は第三者によるものです。SWE-sweep、Agents’ Last Exam、Terminal-Bench ScienceはGoogleによる自己計算です。