Gemini 4 Neon APIでは、モデルIDにgemini-4-neonを使用します。https://generativelanguage.googleapis.com/v1beta/interactionsに対してPOSTリクエストを送り、キーをx-goog-api-keyヘッダーに、modelとinputをJSONボディに含めて呼び出します。有料ティアのみで利用可能で、料金は入力100万トークンあたり3ドル、出力100万トークンあたり15ドル、デフォルトのthinkingレベルはhighです。
このガイドでは、Neonの特徴である以下の点を解説します。有料ティアの設定、他のGemini 4モデルからの切り替え、64Kトークンを超える出力、NeonとHydrogenの組み合わせ、コスト管理の方法です。すべてのフィールド名はGoogleのドキュメントに基づいています。
最初のGemini 4 Neon API呼び出しの前に必要なものは?
必要なのは、課金設定済みプロジェクトのGemini APIキー、モデルIDgemini-4-neon、そしてInteractionsエンドポイントです。Googleは2026年11月18日にNeonをリリースしました。Gemini 4ファミリーの中間モデルとして、HydrogenとCarbonの間に位置します。
| 項目 | 値 |
|---|---|
| モデルID | gemini-4-neon |
| エンドポイント | generativelanguage.googleapis.com上のPOST /v1beta/interactions |
| 認証ヘッダー | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions APIとgenerateContent |
| Thinkingレベル | low、medium、high(デフォルト)、xhigh |
| コンテキストウィンドウ | 1,048,576トークン(入力・thinking・出力で共有) |
| 同期リクエスト1回あたりの出力 | 65,536トークン |
| ロングデコード | 最大1,048,576トークンから入力分を引いた値まで |
| 無料ティア | なし |
| 有料価格 | 入力$3.00/1M、出力$15.00/1M(thinkingを含む) |
| キャッシュ済み入力 | 暗黙的キャッシュにより$0.15/1M |
PDF、関数呼び出し、ストリーミングについては、リクエストの形式はGemini 4 Hydrogen APIガイドと同じです。モデルIDだけを入れ替えてください。
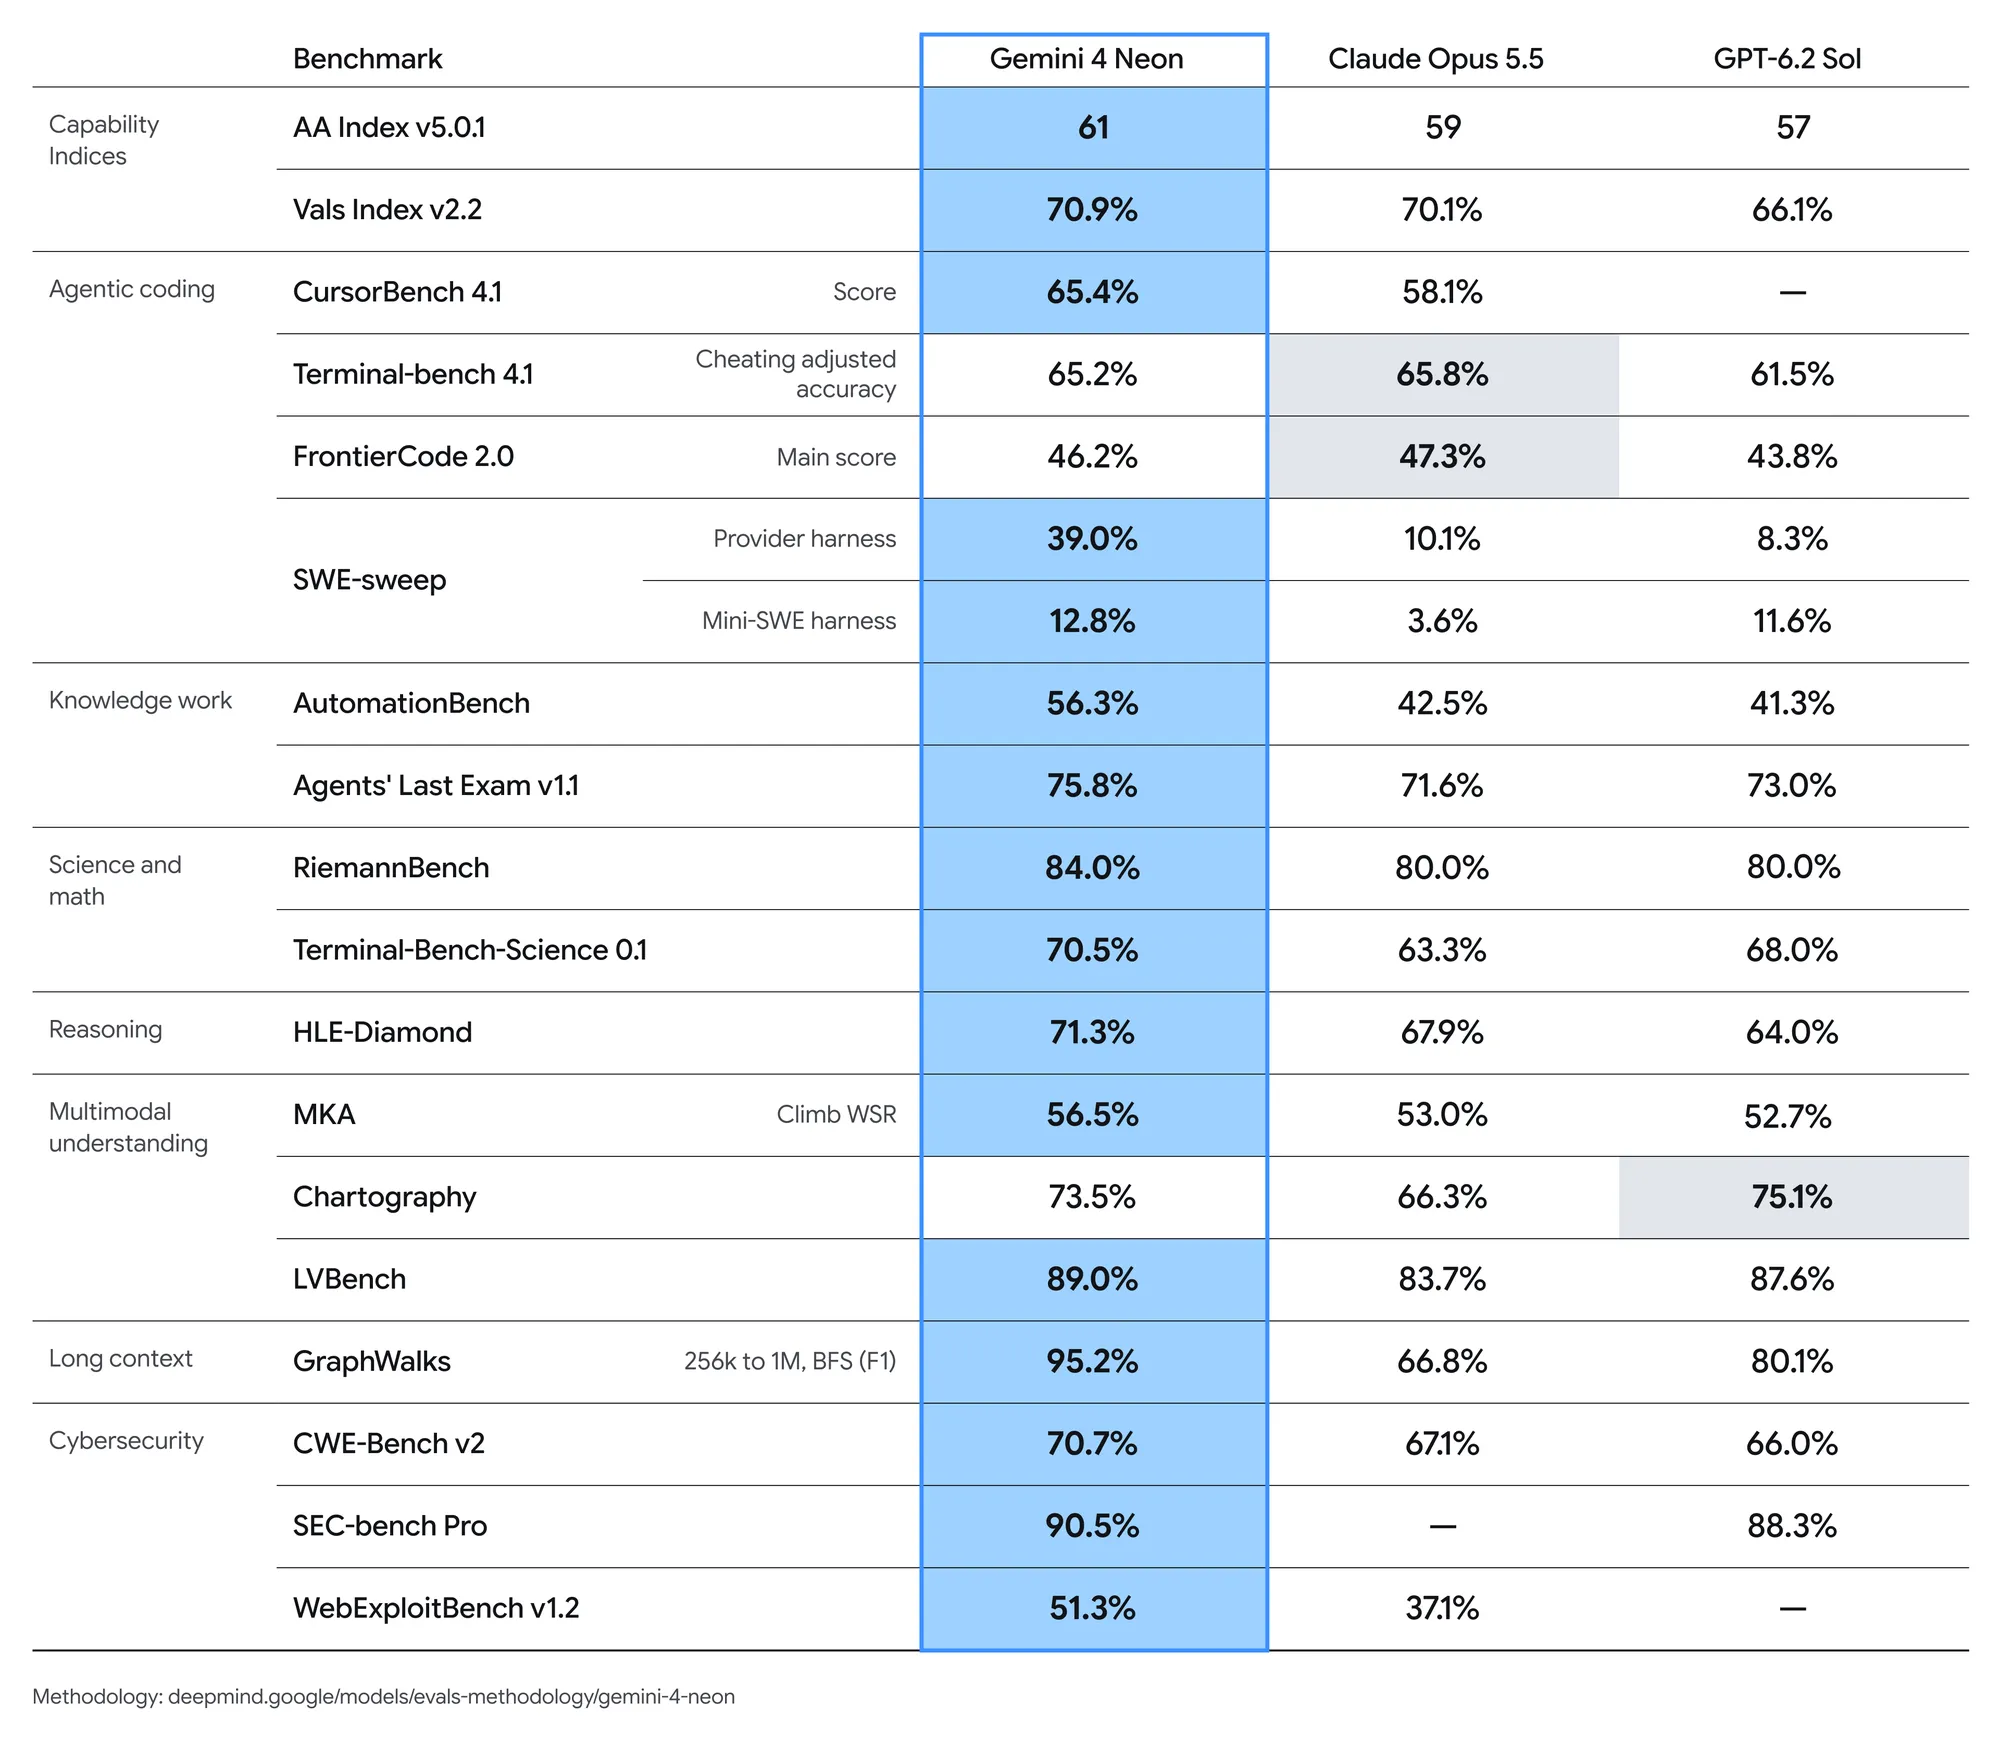
Neonで使えるGemini APIキーを取得するには?
Neonは無料ティアに含まれていないため、キーだけでは不十分です。キーの背後にあるプロジェクトで課金設定が必要です。
- Google AI StudioでAPIキーページを開き、キーを作成するか、既存のキーを再利用します。
- キーのプロジェクトが有料ティアに登録されていることを確認します。Googleのガイドには「Neonは有料ティアのみで利用可能です(無料ティアでは利用できません)」と明記されています。
- キーをエクスポートします:
export GEMINI_API_KEY="YOUR_API_KEY"。Google GenAI SDKはこれを自動的に読み込みます。 - 大量のバッチ処理を計画する前に、レート制限ページで有料ティアのレート制限を確認してください。[要確認:Neonのティア別RPM・TPM数値]
最初のGemini 4 Neon APIリクエストを送信するには?
Interactionsエンドポイントにmodelとinputを送信します。これはGoogleのクイックスタート形式です:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
Python SDKを使った同じ呼び出し(pip install -U google-genai):
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
テスト中は毎回レスポンスのusageを確認しましょう。thinkingトークンは出力と同じ$15のレートで課金されるため、コストの大半はthinkingトークンの数で決まります。
これらのスニペットはGoogleのガイドに従っています。この記事のために実際に実行していないため、初回呼び出し時にレスポンス形式を必ず確認してください。
HydrogenやCarbonから切り替えると何が変わる?
すでに他のGemini 4モデルを使用している場合、切り替えにリクエストスキーマの変更は不要です。model文字列を変更し、次の3点を確認してください:
| 確認項目 | Neon | Hydrogen | CarbonとArgon |
|---|---|---|---|
| デフォルトのthinkingレベル | high |
high |
medium |
| 最高レベル | xhigh |
xhigh |
high |
| 1Mあたりの入力/出力 | $3/$15 | $1.50/$7.50 | Carbonの料金を参照 |
CarbonやArgonから移行する場合、デフォルトがmediumからhighに変わるため、同じプロンプトでもthinkingトークンが増えます。従来の動作にしたい場合は、thinking_levelを明示的に設定してください:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
Gemini 3.8 Flash以前からの移行では、確認項目がさらに増えます。Googleの移行チェックリストに従うと:
- 低い出力上限を引き上げる。
max_output_tokensはthinkingと回答を合わせた総量です。8,192などのハードコードされた上限を削除するか、65,536に引き上げ、コストを抑えたい場合はthinkingレベルを下げましょう。 minimalを削除する。 Neonはこれを拒否してエラーを返します。- サンプリングパラメータを削除する。 サーバーは範囲内の
temperature、top_p、top_kを無視し、範囲外の値には400を返します。 - 明示的キャッシュから移行する。 Neonは
cachedContentsやcaches.createに対応していないため、cached_contentフィールドを削除してください。 - ツールをネイティブに宣言する。 ツールを宣言せずに生のJSONツール呼び出しをプロンプトで求めると、
MALFORMED_FUNCTION_CALLが返ることがあります。関数呼び出しまたは構造化出力を使用してください。
Neonから64Kトークンを超える出力を得るには?
同期リクエストはストリーミングの有無にかかわらず65,536トークンで停止します。完全な移行仕様書とテストスイートのような長い出力が必要な場合は、backgroundをtrueに設定し、max_output_tokensを65,536より大きくしてください。Googleのサーバーは上限に達するまで、64Kトークンずつ複数回に分けて生成を続けます。
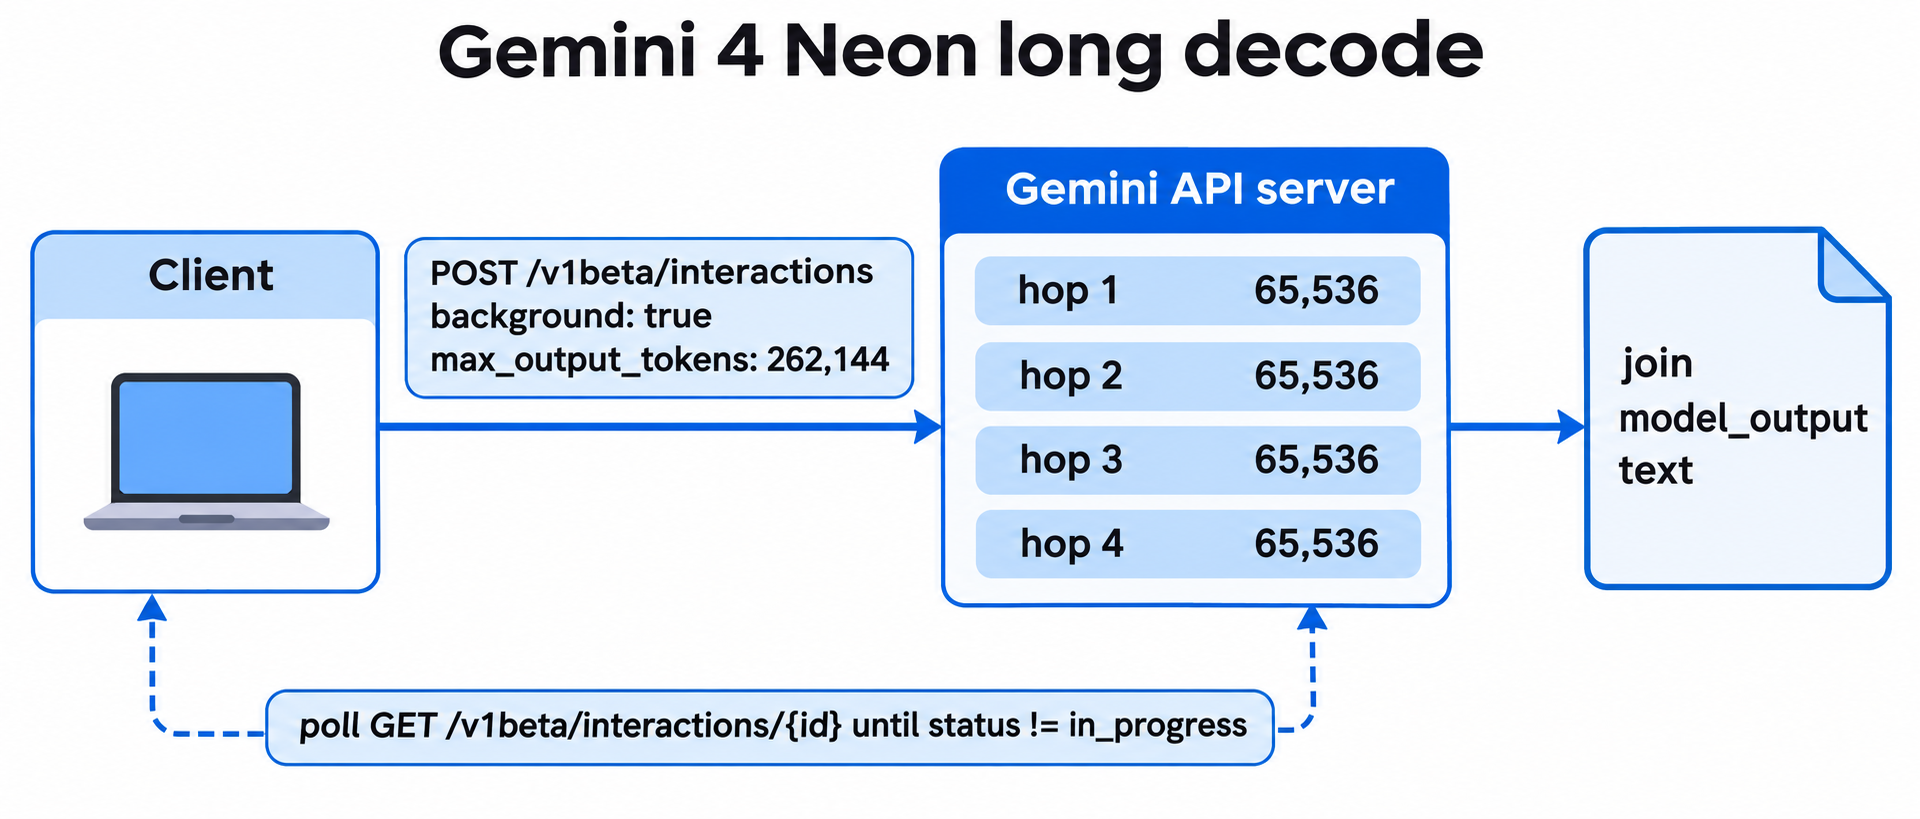
ジョブを開始し、そのidを保持します:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
その後、完了までポーリングし、各hopからのテキストを連結します(Python、エクスポートしたIDを使用):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
Googleのガイドにある次の3つのルールに従えば、問題を回避できます:
max_output_tokensを指定せずにbackgroundだけを設定すると、サーバーは65,536トークンで停止します。- 上限は1,048,576から入力トークンを引いた値まで設定できます。長い複数ステップの作業には、Googleは131,072または262,144を推奨しています。
- 難しいプロンプトは数分かかることがあります。バックグラウンドモードを使用するか、HTTPクライアントのタイムアウトを最低15分に設定してください。
Google側にインタラクションを保存したくない場合は、ロングデコードガイドに、最新SDKでのクライアント側継続方法も記載されています。
NeonとHydrogenを組み合わせるには?
判断にはNeonを、大量処理にはHydrogenを使います。Neonがワークフローを計画・レビューし、そのインタラクションのidをprevious_interaction_idとしてgemini-4-hydrogenの呼び出しに渡して、単一のステップを実行させます。GoogleのCloud開発者ガイドにこのパターンが示されています:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
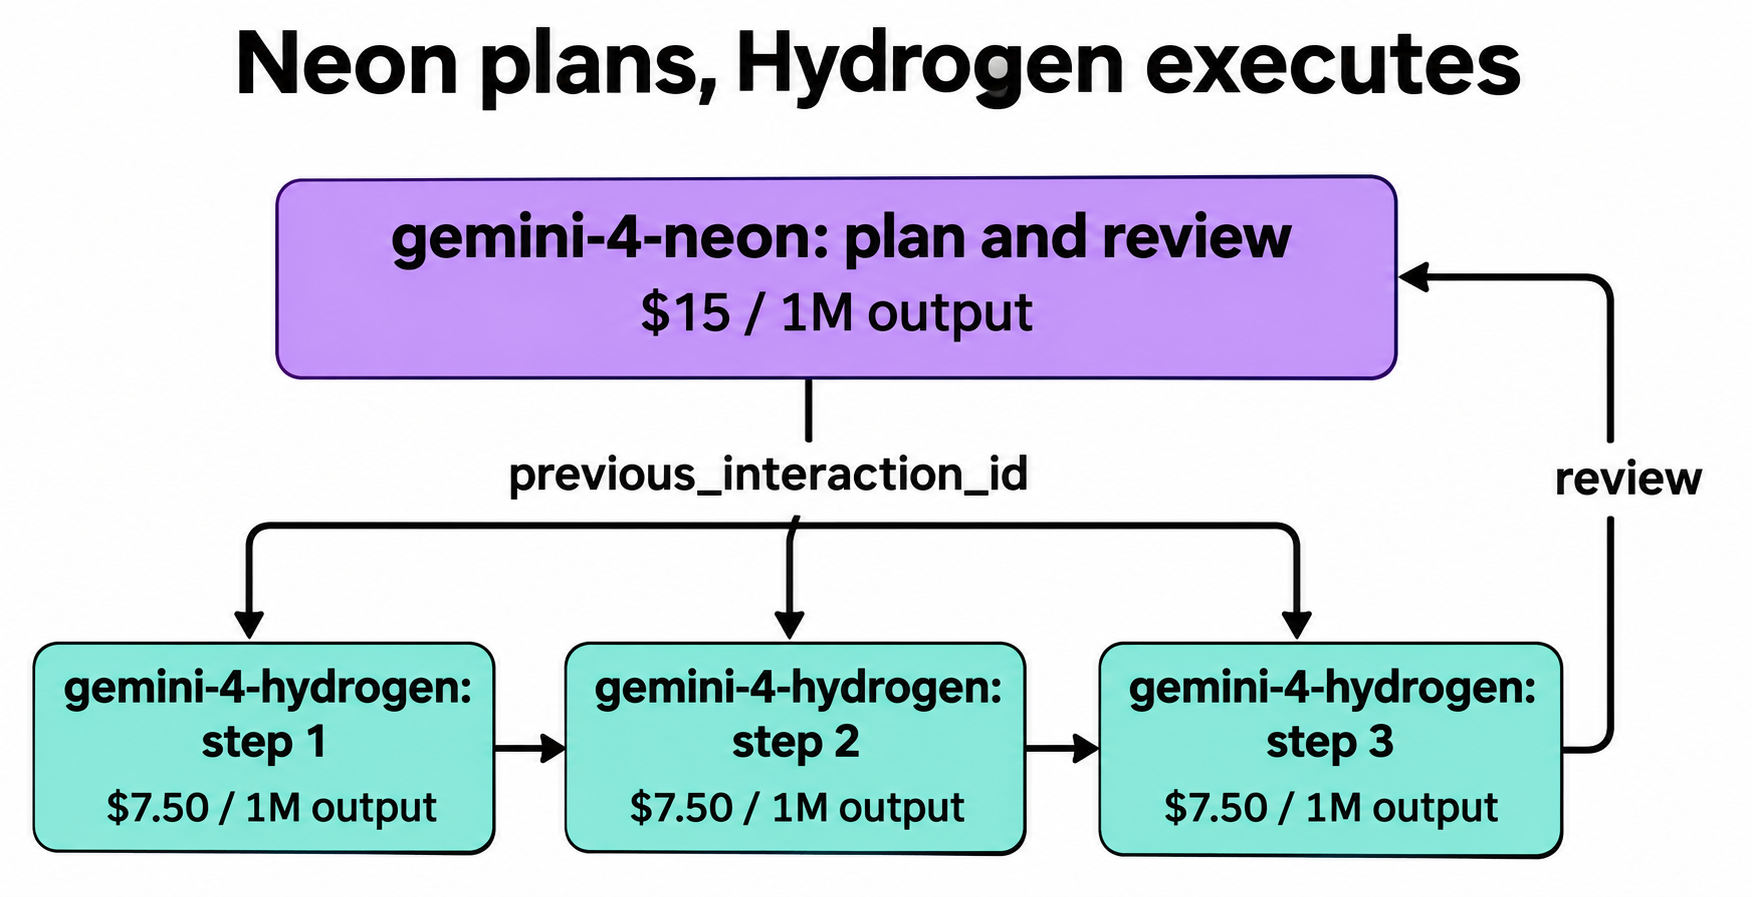
Neonの代わりにHydrogenが書き出す出力トークンは、すべて半額で済みます。Gemini 4 Hydrogenオーケストレーターガイドでは、Carbonをプランナーにした同じループを解説しています。
Gemini 4 Neon APIのコストを抑えるには?
一般的に効果が大きい順に、4つの方法があります:
- 合格基準を満たす最も低いthinkingレベルを選ぶ。 Googleのアドバイスは、4つのレベルすべてで高い
max_output_tokensを使って評価を実行し、品質基準を満たす最も低いthinking_levelを選ぶことです。 - 長いプロンプトを再利用する。 暗黙的キャッシュは4,096トークン以上のプロンプトにデフォルトで適用され、キャッシュ済み入力のコストを95%削減し、100万トークンあたり$3.00から$0.15になります。プロンプトの長く安定した部分(システムテキスト、ドキュメント、スキーマ)を先頭に置きましょう。
- 実行をHydrogenに任せる。 上記の組み合わせパターンを参照してください。
- すべてのトークンを数える。 Googleはモデルが処理したすべてのトークンに課金します。thinkingトークンや、グラウンディング使用時に追加される内部指示も含まれます。Google検索によるグラウンディングはクエリごとにも課金されます。
簡単な目安として:入力20,000トークン、出力8,000トークン(thinkingを含む)の呼び出しは、入力に$0.06、出力に$0.12がかかり、定価で合計$0.18です。
Apidog CLIでコーディングエージェントにNeonとHydrogenを比較させる
あなたのプロンプトでは、NeonはHydrogenの2倍の価格に見合う価値があるでしょうか?コーディングエージェント(Claude Code、Codex、Cursor)に1つのテストケースを作成させ、Apidog CLIで両モデルに対して実行してみましょう。
一度だけセットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
そしてエージェントに次のプロンプトを1つ渡します:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
エージェントは何かを書く前に、各ペイロードのスキーマを読み、JSONを検証します:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
各実行のトークン数にモデルの単価を掛ければ、そのプロンプトにおけるタスクあたりの実際のコストがわかります。ローンチ記事の平均値ではありません。--upload-reportを付けるとApidogアプリで実行結果を確認でき、-r cli,jsonを-r junitに変えると同じチェックをCIに組み込めます。Apidog CLI CI/CDガイドではパイプラインを、Claude CodeでのApidog CLIではエージェントのセットアップを解説しています。ApidogのFreeプランは最大4ユーザーまで利用できます。
FAQ
Gemini 4 NeonのモデルIDは? gemini-4-neonです。Interactions APIとgenerateContentの両方で動作します。
Gemini 4 Neon APIは無料ですか? いいえ。NeonはGemini APIの有料ティア専用で、入力100万トークンあたり3ドル、出力100万トークンあたり15ドルです。Google AI ProおよびUltraの加入者はAI Studioのチャットで試用できます。
Hydrogen用のコードはNeonでも動きますか? はい。Googleによると、Gemini 4モデル間の切り替えにリクエストスキーマの変更は不要です。model文字列を更新し、デフォルトのhighthinkingレベルのままで良いか判断してください。
Gemini 4 Neon APIの最大出力は? 同期リクエスト1回あたり65,536トークンです。backgroundをtrueにしてmax_output_tokensを高く設定すれば、Neonは1,048,576トークンのウィンドウから入力分を引いた上限まで生成できます。
Gemini 4 Neonはtemperatureに対応していますか? いいえ。サーバーは範囲内のtemperature、top_p、top_kを無視し、範囲外の値には400を返します。品質と速度・コストのトレードオフにはthinking_levelを使用してください。
Neonは明示的コンテキストキャッシュに対応していますか? いいえ。リクエストからcached_contentを削除してください。暗黙的キャッシュは引き続き4,096トークン以上のプロンプトに自動適用され、キャッシュ済み入力は95%の割引になります。