
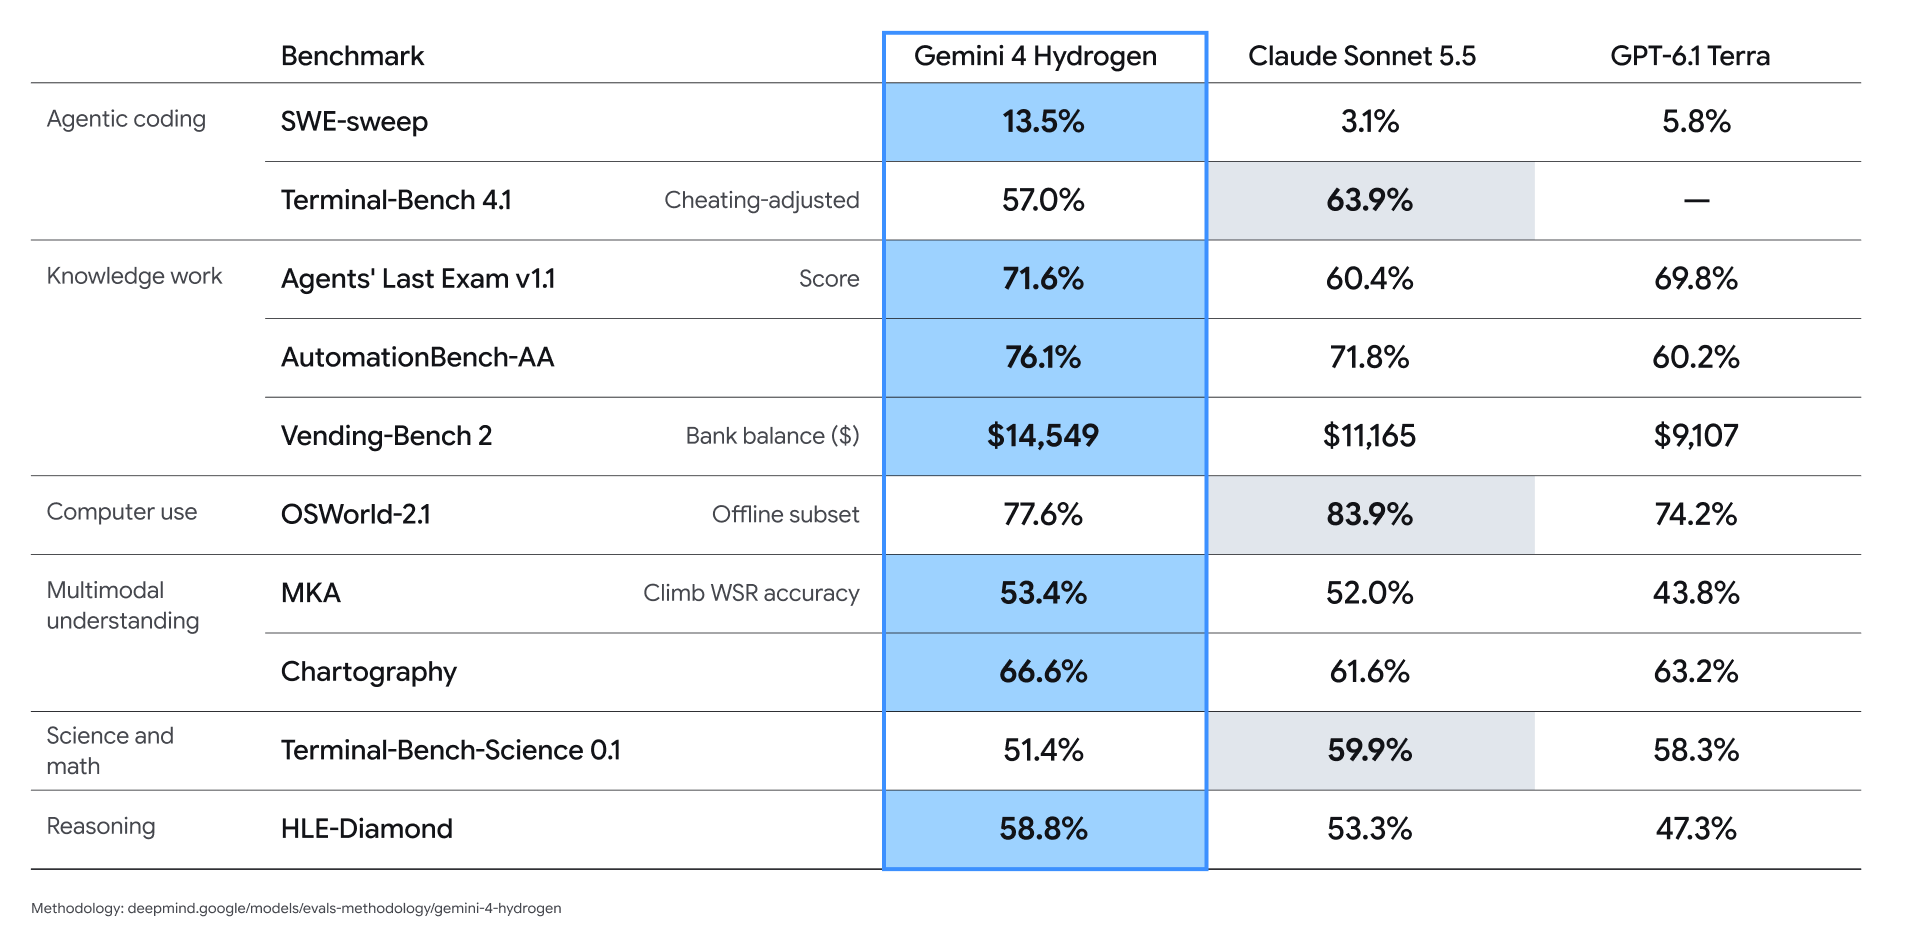
Gemini 4 Hydrogen APIは、モデルID gemini-4-hydrogen を使用します。https://generativelanguage.googleapis.com/v1beta/interactions に POST リクエストを送り、x-goog-api-key ヘッダーにAPIキーを、JSONボディに model と input を指定して呼び出します。無料ティアと有料ティア(入力1Mトークンあたり$1.50、出力$7.50)の両方で利用可能で、デフォルトのthinkingレベルは high です。
このガイドでは、APIキーの取得から最初のリクエスト、thinkingレベルの設定、PDFの送信、関数呼び出し、ストリーミング、エラーハンドリングまで、一通りの流れを解説します。すべてのフィールド名はGoogleの公式ドキュメントに基づいています。
最初のGemini 4 Hydrogen API呼び出しの前に何が必要?
Gemini APIキー、モデルID gemini-4-hydrogen、そしてInteractionsエンドポイントが必要です。Googleは2026年11月12日、CarbonやArgonと並ぶ高速なGemini 4モデルとしてHydrogenをリリースしました(Gemini 4 Hydrogenとは)。
| 項目 | 値 |
|---|---|
| モデルID | gemini-4-hydrogen |
| エンドポイント | generativelanguage.googleapis.com の POST /v1beta/interactions |
| 認証ヘッダー | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions API と generateContent |
| thinkingレベル | low、medium、high(デフォルト)、xhigh |
| コンテキストウィンドウ | 1,048,576トークン(入力・thinking・出力で共有) |
| 同期1回あたりの出力 | 65,536トークン(ストリーミングの有無に関わらず) |
| 無料ティア | あり(レート制限付き) |
| 有料価格 | 入力 $1.50 / 1M、出力 $7.50 / 1M(thinkingトークンを含む) |
| キャッシュ済み入力 | 暗黙的キャッシングにより $0.075 / 1M |
Googleのドキュメントでは generateContent はレガシーと位置づけられているため、本記事の例ではInteractions APIを使用します。
Hydrogen用のGemini APIキーを取得するには?
Hydrogenは無料ティアで利用できるため、課金設定なしで始められます:
- Google AI StudioのAPIキーページを開きます。
- [APIキーを作成] をクリックします。AI Studioで作成した新しいキーは、サービスアカウントに紐づく認可キーです。
- キーをエクスポートします:
export GEMINI_API_KEY="YOUR_API_KEY"。SDKはGEMINI_API_KEYまたはGOOGLE_API_KEYを読み込みます。両方設定されている場合はGOOGLE_API_KEYが優先されます。 - AI Studio外で作成したCloudプロジェクトでは、無料ティアを利用する前にプロジェクトの認証が必要な場合があります。
無料ティアの数値は、ローンチガイドではなくGoogleのレート制限ページに掲載されています。$0で何ができるかについては、Gemini 4 Hydrogen無料ガイドを参照してください。
最初のGemini 4 Hydrogen APIリクエストを送るには?
model と input をInteractionsエンドポイントに送信します。モデルを変数にしておけば、モデルの切り替えも1行の変更で済みます。
export GEMINI_MODEL="gemini-4-hydrogen"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Write a Python function that retries an HTTP call with exponential backoff."
  }'
Python SDKを使った同じ呼び出し(pip install -U google-genai):
import os
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model=os.environ.get("GEMINI_MODEL", "gemini-4-hydrogen"),
    input="Write a Python function that retries an HTTP call with exponential backoff.",
)

print(interaction.output_text)
print(interaction.usage)
レスポンスには id、status、steps 配列が含まれます。テキストは model_output ステップに、推論内容は thought ステップに格納され、SDKの output_text はテキストを連結して返します。usage オブジェクトには total_input_tokens、total_thought_tokens、total_output_tokens、total_tokens が含まれます。
これらのコード例はGoogleのクイックスタートに準拠しています。本記事の執筆時点では検証環境にGeminiキーがなかったため実行しておらず、実際のレスポンスの構造は最初のレスポンスでご確認ください。
Gemini 4 Hydrogenのthinkingレベルを設定するには?
generation_config の中で thinking_level を設定します。Hydrogenのデフォルトは high で、新たに xhigh レベルが追加されています。minimal を指定するとエラーになります。
thinking_level |
トークン使用量 | Googleの推奨ユースケース |
|---|---|---|
low |
トークン消費が最少、レイテンシ最短 | 高速チャット、高スループット処理 |
medium |
トークン消費を抑えつつ高速 | インタラクティブなコーディング、ライブUIプロトタイピング、素早いツール呼び出し |
high(デフォルト) |
バランス型 | 複雑なコーディング、エージェント実行、マルチモーダルなドキュメント作業 |
xhigh |
トークン消費が最多、最も深い推論 | high では足りない難しい多段階問題 |
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "medium",
      "max_output_tokens": 65536
    }
  }'
重要なルールが2つあります。まず、max_output_tokens はthinkingと出力を合わせた上限となるため、古い低い上限値(たとえば8,192)では回答が途中で切れることがあります。Googleは、上限を65,536に引き上げ、代わりにthinkingレベルを下げることを推奨しています。また、thinkingトークンは出力と同じ$7.50のレートで課金されるため、表示される回答の長さが同じでも xhigh はコストが高くなります。レベルごとの料金計算はGemini 4 Hydrogen料金解説を参照してください。
さらにGoogleによると、Hydrogenでは temperature、top_p、top_k はサーバー側で無視されるため、リクエストから削除しましょう。
Gemini 4 HydrogenにPDFを送るには?
input 配列に、指示文の text アイテムと並べて document アイテムを追加します。小さいファイルなら、PDFをbase64でインライン送信できます:
PDF_PATH="invoice.pdf"
B64=$(base64 < "$PDF_PATH" | tr -d '\n')

curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": [
      {"type": "document", "data": "'"$B64"'", "mime_type": "application/pdf"},
      {"type": "text", "text": "Extract the line items as a table."}
    ]
  }'
大きなファイルや複数ターンにわたる再利用の場合は、Files APIで一度アップロードし(無料、48時間保持)、代わりに {"type": "document", "uri": "<file uri>", "mime_type": "application/pdf"} を渡します。ドキュメント処理ガイドによると、PDFは最大50MBまたは1,000ページまで対応しており、モデルはテキストだけでなくPDF内のグラフ、表、画像も読み取ります。
Gemini 4 Hydrogenでの関数呼び出しの仕組みは?
tools で関数を宣言します。モデル自身は何も実行せず、function_call ステップを返します。あなたのコードが関数を実行し、その結果を function_result として送り返します。Googleの関数呼び出しガイドに基づく、ステップ1の例です:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "What'\''s the temperature in London?",
    "tools": [{
      "type": "function",
      "name": "get_current_temperature",
      "description": "Gets the current temperature for a given location.",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {"type": "string", "description": "The city name"}
        },
        "required": ["location"]
      }
    }]
  }'
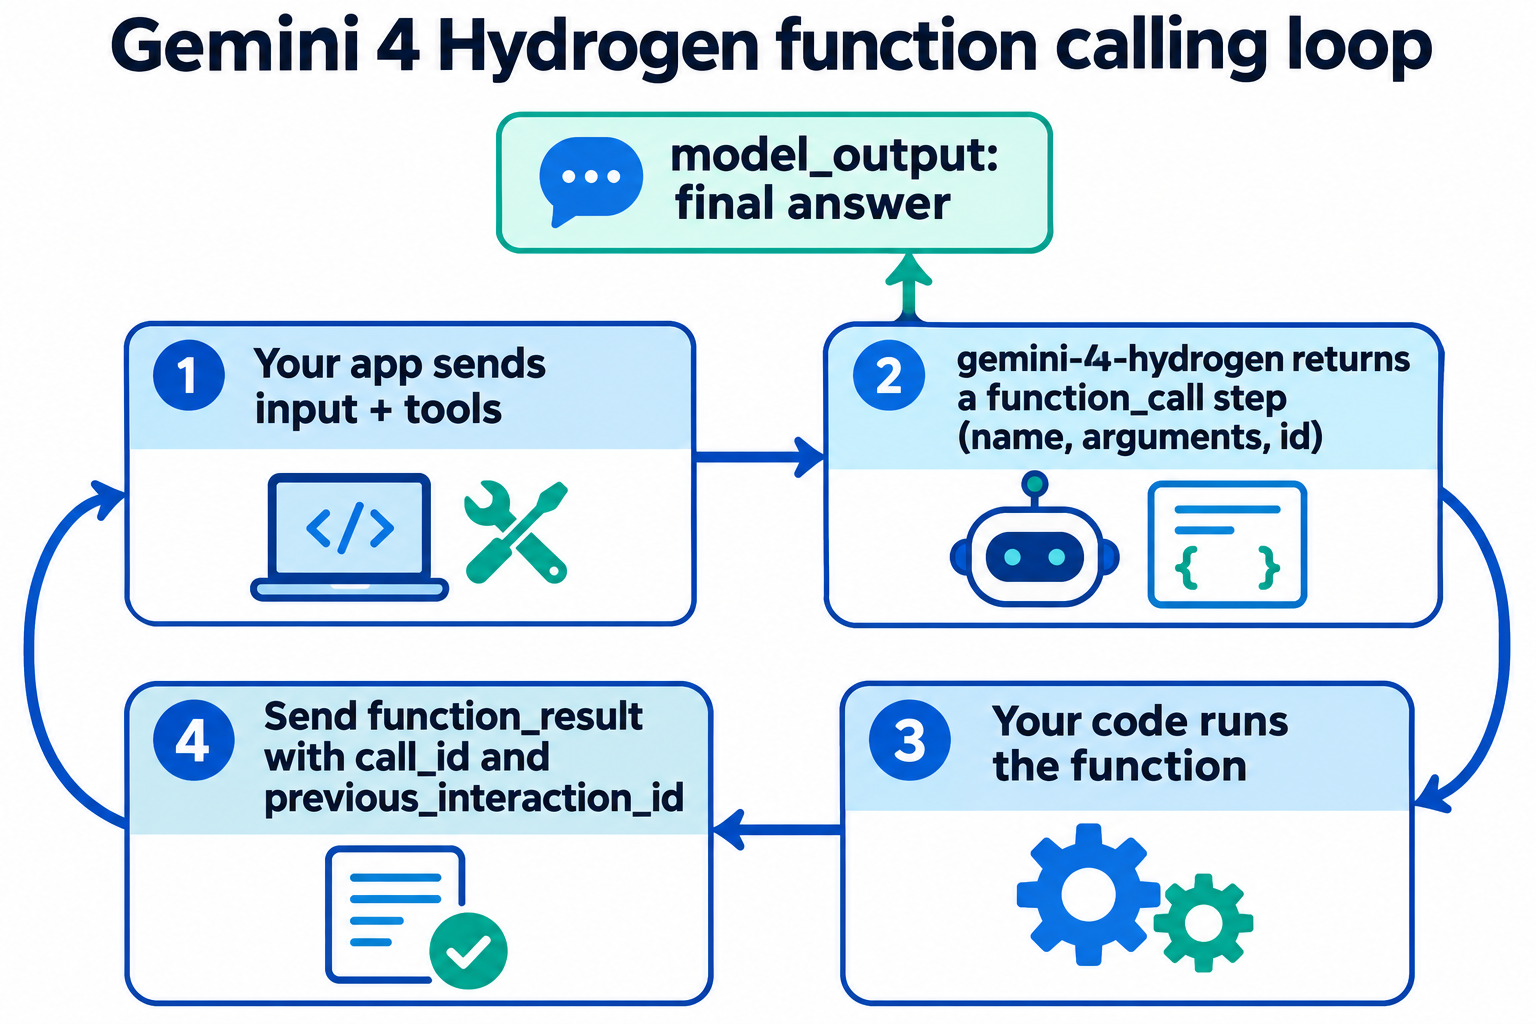
type が function_call になっているステップを探し、その name、arguments、id を読み取ります。関数を実行したら、同じセッションで結果を送り返します:
fc = next(s for s in interaction.steps if s.type == "function_call")
result = get_current_temperature(**fc.arguments)

final = client.interactions.create(
    model="gemini-4-hydrogen",
    input=[{
        "type": "function_result",
        "name": fc.name,
        "call_id": fc.id,
        "result": [{"type": "text", "text": json.dumps(result)}],
    }],
    tools=[weather_function],
    previous_interaction_id=interaction.id,
)
print(final.output_text)
previous_interaction_id により、会話と思考の状態はGoogle側で保持されるため、履歴を再送信する必要はありません。Googleの移行ノートからの注意点として、ツールを宣言していない状態でモデルに生のJSON「ツール呼び出し」を出力させようとすると、MALFORMED_FUNCTION_CALL が返ることがあります。ツールはネイティブに宣言するか、構造化出力を使用してください。
Gemini 4 Hydrogenのレスポンスをストリーミングするには?
ボディに "stream": true を追加します。APIはServer-Sent Eventsで応答します:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  --no-buffer \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Explain idempotency keys in three short paragraphs.",
    "stream": true
  }'
Googleのストリーミングガイドによると、まず interaction.created が届き、各ステップ(thought、次に model_output)ごとに step.start、step.delta、step.stop が続き、最後に最終の usage を含む interaction.completed が届きます。model_output ステップの delta.text を連結して回答を構築します。ストリーミングしても上限は上がらず、1回のホップごとに65,536トークンで停止します。より長い出力が必要な場合は、"background": true を設定して max_output_tokens を65,536超にし、status が in_progress や queued でなくなるまで GET /v1beta/interactions/{id} をポーリングしてください。
Gemini 4 Hydrogen APIのエラーを処理するには?
非ストリーミングのエラーは、HTTPステータスと code、message を含む error オブジェクトとして返されます。ストリーミングでは、同じフィールドを持つ error イベントが届きます。GoogleのAPIエラーページから、よく遭遇するコードは以下の通りです:
| HTTP | code |
対処法 |
|---|---|---|
| 400 | invalid_request |
ペイロードを修正し、フィールド名をドキュメントと照合する |
| 403 | permission_denied |
キーの権限、認証状態、課金設定を確認する |
| 404 | model_not_found |
モデル文字列が gemini-4-hydrogen であることを確認する |
| 429 | rate_limit_exceeded |
待機してリトライする |
| 429 | quota_exceeded |
1日の割り当てに到達。リセットを待つ |
| 503 | service_unavailable |
待機してリトライする |
Googleのトラブルシューティングガイドでは、指数バックオフ+ジッターとリトライ上限を設けて 429、408、5xx のみをリトライし、400、402、403 は決してリトライしないよう推奨されています。Python SDKは一時的なエラーをすでに最大4回まで自動リトライします。
Apidog CLIでコーディングエージェントにHydrogen APIをテストさせる
プロンプトやthinkingレベルを変更するたびにJSONを読む代わりに、コーディングエージェント(Claude Code、Codex、Cursor)に再現可能なテストを作らせ、Apidog CLI で実行させましょう。
一度だけセットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
そしてエージェントに次のプロンプトを1つ渡します:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING (default "low"). Add an endpoint for POST /v1beta/interactions with the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-hydrogen", a short prompt and generation_config.thinking_level
{{THINKING}}, and asserts: HTTP 200, status is "completed", steps contains a
non-empty model_output, and usage.total_tokens exists. Run it at low and at high,
then compare usage.total_thought_tokens.
エージェントは何かを書く前に、各ペイロードをCLIのスキーマに対して検証します:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=low" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=high" -r cli,json
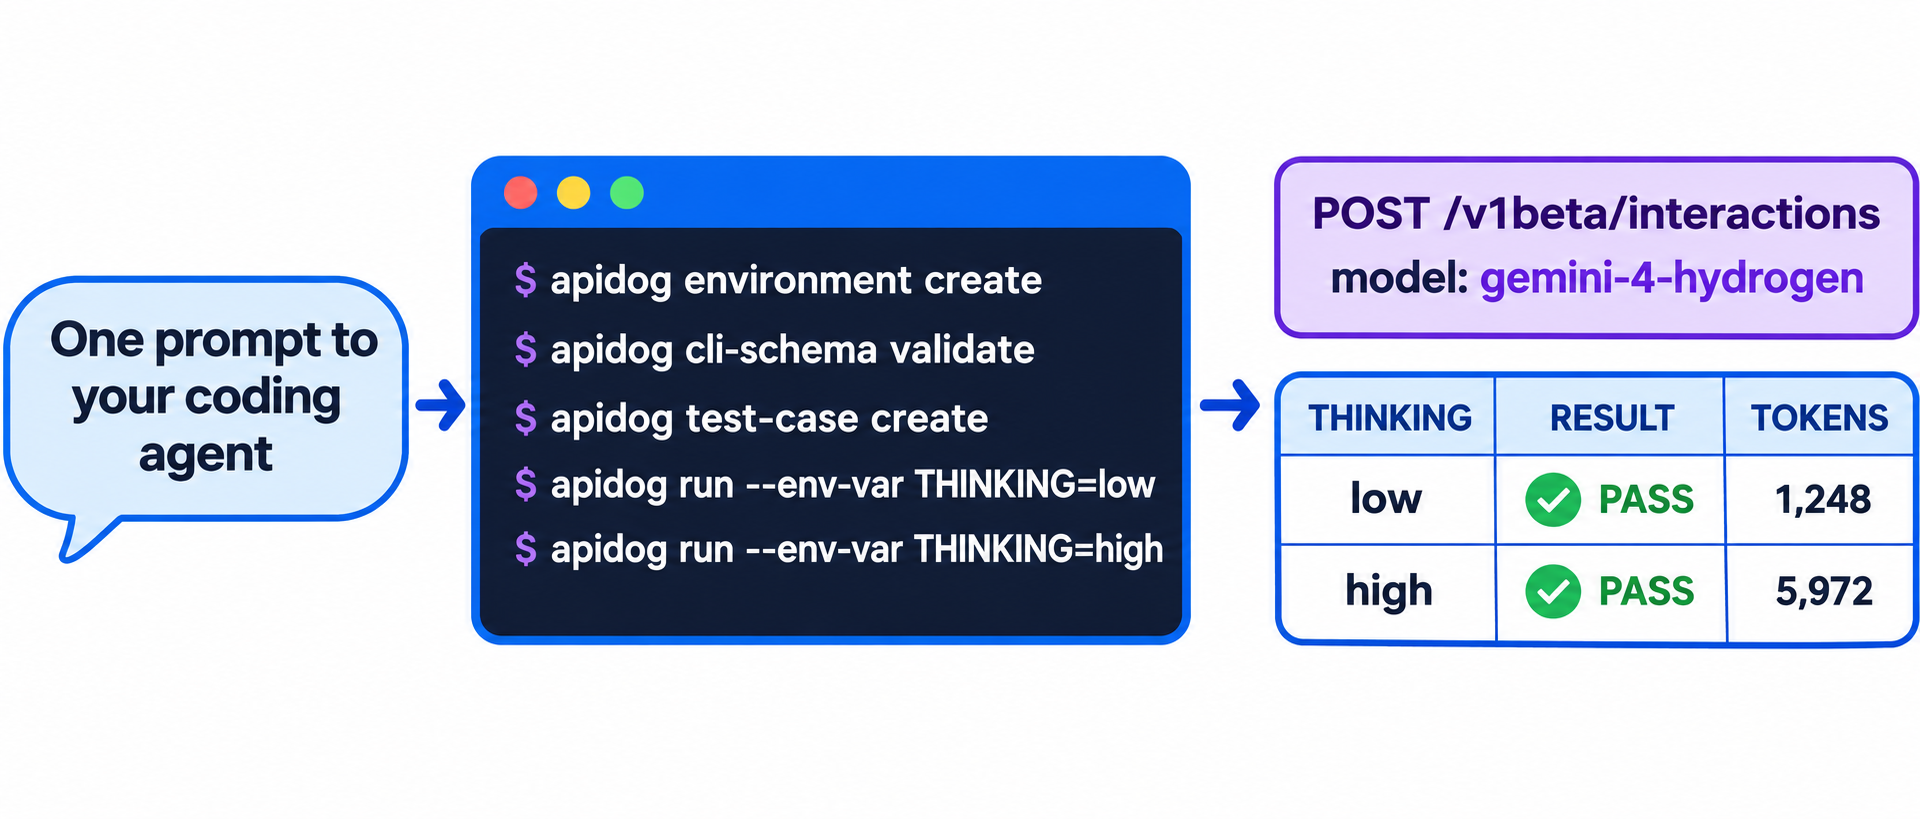
2回の実行で、同じプロンプトにおけるthoughtトークン、つまり課金に直接影響する数値を比較します。-r cli,json を -r junit に変えれば、同じ実行をCIに組み込めます。パイプラインについてはApidog CLI CI/CDガイド、エージェントのセットアップについてはClaude CodeでのApidog CLIを参照してください。ApidogのFreeプランは最大4ユーザーまで利用できます。
FAQ
Gemini 4 HydrogenのモデルIDは? gemini-4-hydrogen です。Interactions APIと generateContent の両方で動作します。
Gemini 4 Hydrogen APIは無料? はい、制限付きで無料です。GoogleはGemini APIとAI Studioの無料ティアにHydrogenを掲載しており、レート制限があります。有料利用は入力1Mトークンあたり$1.50、出力1Mトークンあたり$7.50です。
Gemini 3.8 Flashから移行するには? モデル文字列を変更し、低い max_output_tokens の上限を引き上げ、temperature、top_p、top_k および明示的キャッシング(cachedContents)を削除し、minimal thinkingを low か medium に置き換えてください。
Hydrogenはコンテキストキャッシングに対応している? 暗黙的キャッシングのみです。4,096トークン以上のプロンプトに対してデフォルトで有効になり、キャッシュヒットを95%割り引きます。明示的キャッシングはサポートされていません。
APIにおいてHydrogenはGemini 4 Argonと何が違う? リクエストスキーマは同じです。Hydrogenのデフォルトは high で xhigh が追加されている一方、Argonのデフォルトは medium です。モデルの組み合わせについては、Gemini 4 Argon APIガイド、Gemini 4 Carbon APIガイド、Gemini 4 Hydrogen Orchestrator を参照してください。