
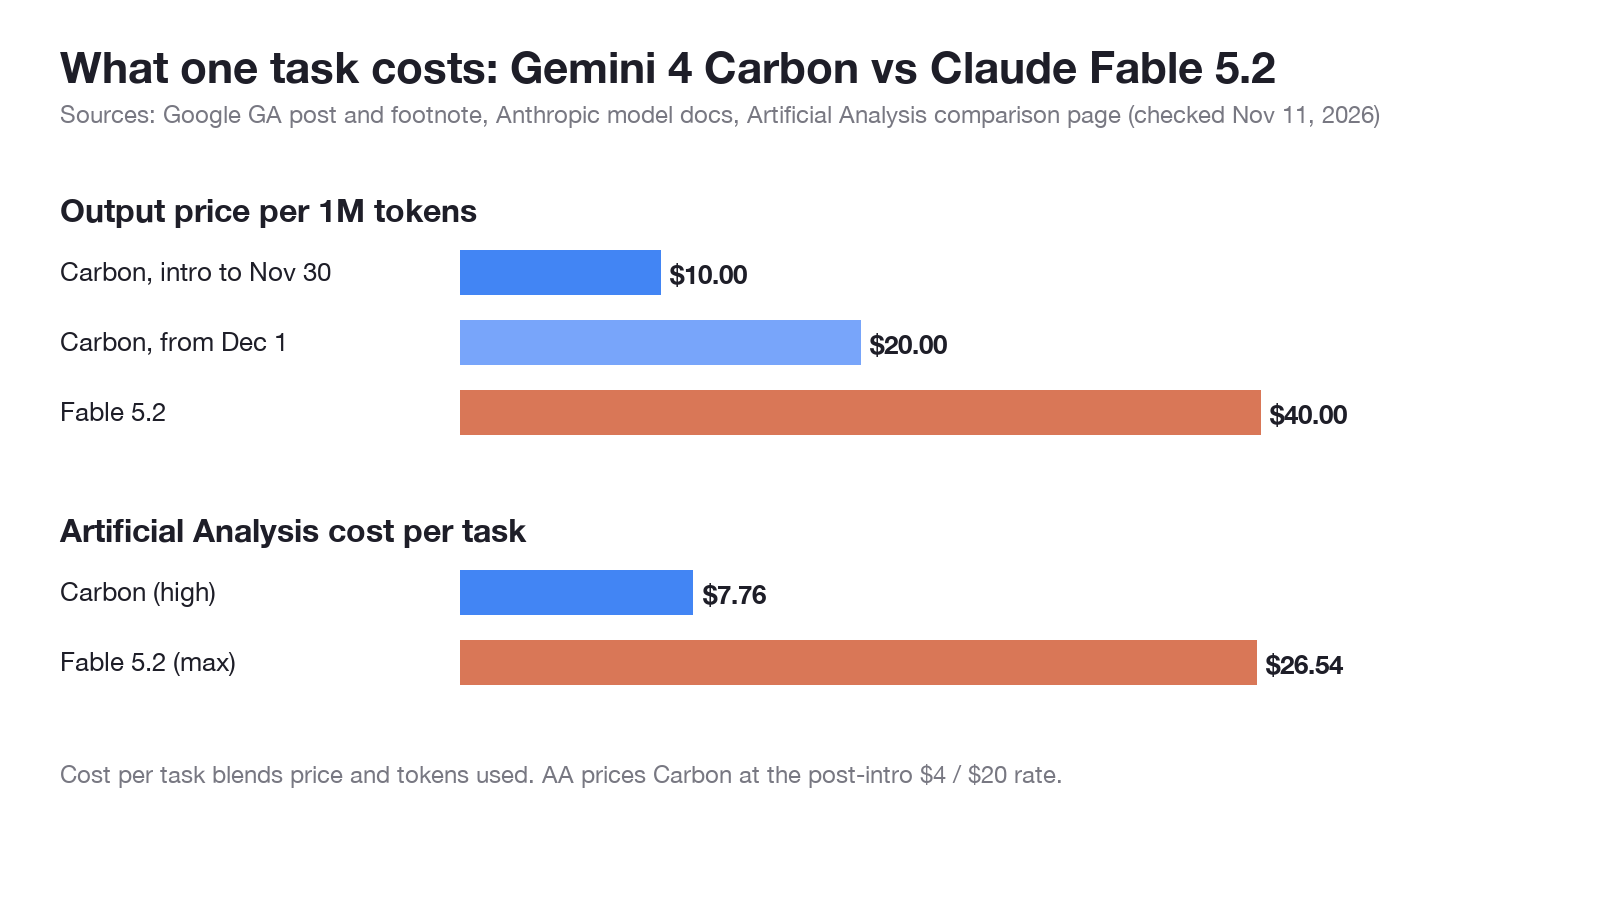
2026年11月11日時点で、GoogleのGemini 4 Carbonはより安価なモデルであり、Claude Fable 5.2は公開されているほとんどのコーディング・エージェント系ベンチマークでより高性能なモデルです。Carbonは11月30日まで100万入力/出力トークンあたり$2 / $10で提供され(以降は$4 / $20)、Fable 5.2は$8 / $40。Artificial Analysisによれば、1タスクあたりのコストは$7.76対$26.54です。
両モデルのリリースは1日違い(11月9日にFable 5.2、11月10日にCarbon GA)で、各ベンダーの表は自社モデルに有利な内容になっています。このガイドでは、すべての数値を「誰が測定したか」で分けて提示し、さらに自分のリクエストで両モデルをA/Bテストする方法を紹介します。
Gemini 4 Carbon vs Claude Fable 5.2:結論を手早く
タスクあたりのコストが最も重要な場合、業務自動化フロー、あるいはセキュリティ関連の作業にはGemini 4 Carbonを選びましょう。難易度の高いコーディング、ターミナル、コンピュータ操作タスクで最高スコアが必要で、タスクあたり約3.4倍のコストを払える場合はClaude Fable 5.2を選びましょう。日常のエンジニアリングについては、どちらのベンダーもまずより安価なデフォルトモデルを推奨しています。
GoogleのGA記事では「ほとんどのソフトウェアエンジニアリングとナレッジワークには、引き続きArgonが最適な選択肢」と述べ、Carbonは探索と検証に多くのトークンを使う、より難しいタスク向けに位置づけています。Anthropicのモデルドキュメントも同じことを別の言葉で述べています。ほとんどのワークロードにはClaude Opus 5.5から始め、要求の厳しい推論や長時間稼働のエージェント作業にはFable 5.2へ移行する、と。
つまり、デフォルトモデルが物足りないときにどちらかを使う、という使い方です。まだデフォルトを選んでいないなら、まずGemini 4 Carbon vs Argonを読んでみてください。
Gemini 4 CarbonとClaude Fable 5.2の価格・スペック比較
各ベンダーが公開している事実を、出典付きでまとめました。
| スペック | Gemini 4 Carbon | Claude Fable 5.2 | 出典 |
|---|---|---|---|
| モデルID | gemini-4-carbon |
claude-fable-5-2 |
Google、Anthropic |
| リリース | 2026年11月10日GA | 2026年11月9日 | Google、Anthropic |
| 入力価格(100万トークンあたり) | 11月30日まで$2、以降$4 | $8(高速モードでは$16) | Googleの脚注、Anthropic |
| 出力価格(100万トークンあたり) | 11月30日まで$10、以降$20 | $40(高速モードでは$80) | Googleの脚注、Anthropic |
| コンテキストウィンドウ | 100万トークン | 100万トークン | AI Studioモデルカード、Anthropicドキュメント |
| 最大出力 | 65K / 1Mと記載 [要確認] | 128Kトークン | AI Studioモデルカード、Anthropicドキュメント |
| 思考(Thinking) | 思考レベルを設定可能 | アダプティブ、常時有効、デフォルトのeffortはhigh |
Googleクイックスタート、Anthropicドキュメント |
| 入手先 | Gemini API有料ティア、AI Studio、Android Studio、Gemini for business、Antigravity、CodeMender、Google AI Ultra | Claude Platform、Amazon Web Services、Google Cloud、Microsoft Azure | Google、Anthropic |
| 無料APIティア | 記載なし | 記載なし | Google、Anthropic |
GoogleのGA記事ではVertex AI、Gemini CLI、GitHub Copilotには言及されていないため、現時点でこれらを前提に計画するのは避けましょう。Carbonの導入価格はArgonと同一のため、11月は評価を実行するのに最も安い月です。
完全な料金表については、Claude Fable 5.2の料金とGoogleのGemini 4 Carbon発表記事を参照してください。
ベンチマークで優位なのはどちら?
どの表を読むかによって答えが変わるため、3つの表を分けて示します。
Anthropicの表(Fable 5.2とともに公開)
AnthropicのFable 5.2ローンチ記事にはGemini 4 Carbonの列が含まれています。ただし、そのCarbonの数値を誰が測定したかはページ上で明記されていないため、ベンダー報告値として扱うべきです。
| ベンチマーク(Anthropicの表) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1%(xhigh effort) | 41.1%(medium effort) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1(オフラインセット、部分) | 89.3% | 81.5% |
| AA-Briefcase v1.1(ルーブリック) | 66.1% | 61.8% |
| Chartography(ツールなし) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
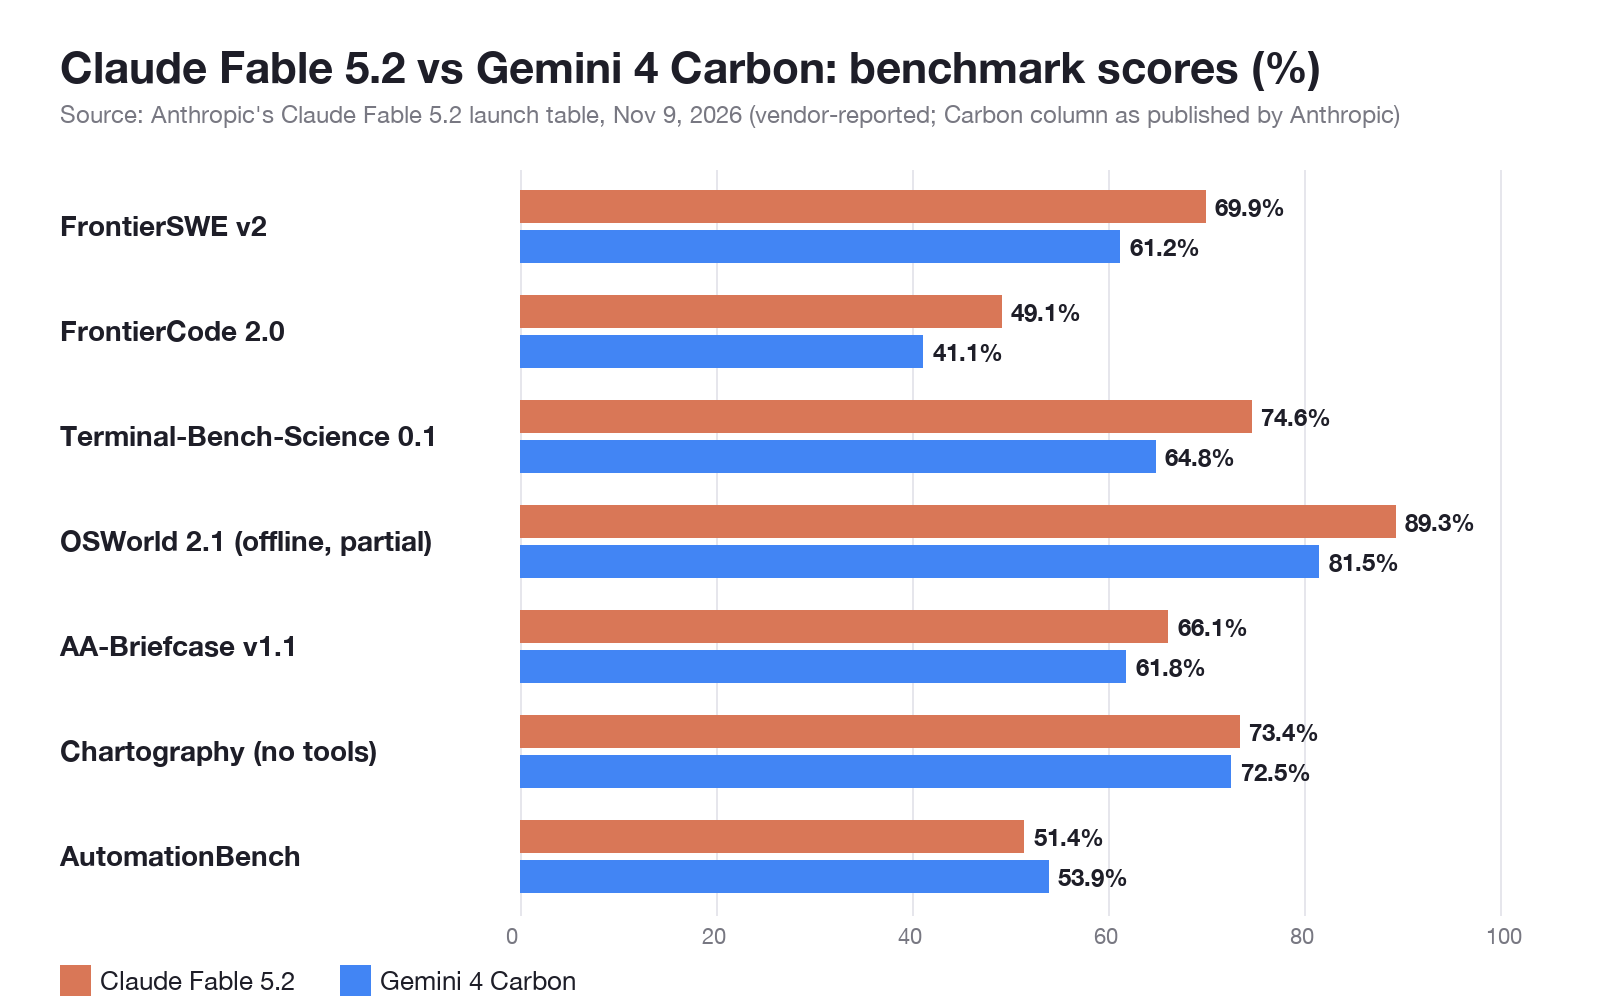
FrontierCodeの行に注目してください。Fableはxhigh effortで実行され、Carbonはmedium effortです。この設定の差は、スコアの差と同じくらい重要です。
Googleの表(Carbon GAとともに公開)
GoogleはFable 5.2との直接比較を公表していません。代わりにパートナーのリーダーボードを報告しています。CarbonはCursorBench 4.0、PerplexityのWANDR、ZapierのAutomationBenchで「次点の外部モデルと比べて2倍以上低いタスクあたりコスト」で1位、Multimodal Knowledge Agentベンチマークでは上位モデルと比べて平均タスクあたりコストが6倍以上低い状態で2位と報告されています。これらの主張でGoogleは競合モデル名を明示していません。
Artificial Analysis(独立系)
Artificial Analysisの比較ページでは、両モデルを同じIntelligence Index v5.0.1で評価しています。
| 指標(Artificial Analysis) | Fable 5.2(max) | Gemini 4 Carbon(high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| タスクあたりコスト | $26.54 | $7.76 |
| インデックス全体の実行コスト | $22,191 | $8,240 |
| 出力速度 | 103トークン/秒 | 82トークン/秒 |
現時点でFable 5.2(max)がこのインデックスの首位を保持しています。Carbonは5ポイント低いものの、タスクあたりコストは約29%です。Artificial AnalysisはCarbonを$4 / $20(11月以降のレート)で計上しているため、そのコスト数値はすでに12月の価格を反映しています。
Claude Fable 5.2が優位な場面
Anthropicの数値によれば、Fable 5.2は最も難しいコーディングおよびコンピュータ操作タスクで優位です。
- リポジトリ規模のコーディング:FrontierSWE v2で69.9%対61.2%。
- ターミナルとリサーチ作業:Terminal-Bench-Science 0.1で74.6%対64.8%。
- コンピュータ操作:OSWorld 2.1で89.3%対81.5%。
- 独立系インデックス:Artificial Analysisで65対60。どちらのベンダーも実施していない唯一のスコアです。
- 出力長:1リクエストあたりの最大出力が公式に128Kトークン。
タスクの失敗がエンジニアの午後ひとときを奪うような場合、FrontierSWEの8ポイントの差はトークン代を上回る価値があります。セットアップについてはClaude Fable 5.2 APIガイドを参照してください。
Gemini 4 Carbonが優位な場面
Carbonはタスクあたりコストと、Googleが想定して開発したワークロードで優位です。
- タスクあたりコスト:Artificial Analysisで$7.76対$26.54。約3.4倍安い。
- 業務自動化:AutomationBenchで53.9%対51.4%。しかもAnthropic自身の表での数値です。
- セキュリティ:GoogleによればSEC-bench Pro、ExploitGym、CWE-bench v1で首位。さらに防御者向けに、Fairwind Program経由でゲート制限付きのCarbon for cyberモデルを提供。
- 11月の価格:11月30日まで$2 / $10。入出力ともにFableのレートの4分の1。
- エージェントチーム:Google Antigravityの/swarmプレビューは、1つのプロンプトを連携するチームに変換し、Carbonが計画と監査を担当する間、軽量モデルが並列で作業します。
このモデルが初めての方は、Gemini 4 Carbonとは何かから始めてみてください。
1タスクの実際のコストは?
定価はレートを教えてくれるだけで、請求額そのものではありません。タスクのコストは「単価×モデルが費やすと決めたトークン数」で決まり、GoogleはCarbonが探索と検証に多くのトークンを使うと説明しています。
入力50,000トークン、出力10,000トークンの1リクエストを例にしてみます。
- Carbon、導入レート:(0.05×$2)+(0.01×$10)=$0.20
- Carbon、12月1日以降:(0.05×$4)+(0.01×$20)=$0.40
- Fable 5.2:(0.05×$8)+(0.01×$40)=$0.80
これは両モデルが10,000トークンを出力するという仮定に基づいています。実際はそうなりません。Fableが10,000トークンで済む推論をCarbonが30,000トークンで書くと、Carbonの12月のコストは$0.80に上昇し、差は縮まります。Artificial Analysisはスイート全体で実際の値を測定し、それでもCarbonが約3.4倍安いという結果を得ています。自分で測定するまでの間、これが最も信頼できるシグナルです。
自分のリクエストでGemini 4 CarbonとClaude Fable 5.2をA/Bテストするには?
ベンチマークは他人のタスクです。公平なテストは、同じプロンプトを両方のAPIに送り、トークン数とレイテンシを並べて記録することです。
どちらの呼び出しも単純なHTTPです。以下はGoogleのInteractions APIクイックスタートをもとに構築したCarbonのリクエストで、モデル名は変数にしています。
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2はAnthropicのMessages APIをclaude-fable-5-2をモデル名として使って呼び出します。
Apidog CLIでコーディングエージェントにA/Bを実行させる
リクエストペアを手動で実行するのはすぐに飽きます。代わりにClaude Code、Codex、CursorにApidog CLIを操作させましょう。セットアップは3コマンドです。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
その後、エージェントに次の1つのプロンプトを与えます。
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
エージェントがスキーマを確認し、テストケースを作成して実行します。以下のフラグはCLI 2.2.12のapidog run --helpから取得したものです。
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5は各ケースを5回繰り返すため、1回の遅いレスポンスで結果が決まることはありません。--upload-reportを追加すると、Apidogアプリで実行結果を確認できます。これはワークフローのテンプレートであり、このマシンからCarbonに対して実行したものではありません。エージェントのセットアップについてはClaude CodeでのApidog CLIガイド、Gemini側のリクエストについてはGemini 4 Argon APIガイドを参照してください。
ApidogのFreeプランは最大4ユーザーまで利用できるため、この比較を実行するには十分です。
FAQ
Gemini 4 CarbonはClaude Fable 5.2より優れていますか?
一概には言えません。Fable 5.2はAnthropicのほとんどのベンチマークとArtificial Analysisのインデックスで高いスコア(65対60)を示しています。一方Carbonはタスクあたりコスト($7.76対$26.54)とAutomationBenchで優位です。
Gemini 4 CarbonはClaude Fable 5.2よりどれほど安いですか?
定価では、2026年11月30日まで4倍安く($2 / $10対$8 / $40、100万トークンあたり)、12月1日からは2倍安い($4 / $20)です。Artificial Analysisによるタスクあたりの実測では約3.4倍安いという結果です。
両モデルとも100万トークンのコンテキストウィンドウを持っていますか?
はい。GoogleのAI StudioモデルカードはCarbonに100万トークンを、AnthropicのドキュメントはFable 5.2に100万トークンを記載しています。Fableの最大出力は128Kトークンです。Carbonの正確な出力上限はGoogleの開発者ガイドで確認してください。
Gemini 4 CarbonやClaude Fable 5.2のAPIに無料ティアはありますか?
どちらのベンダーも無料ティアの記載はありません。CarbonはGemini APIの有料ティアおよびGoogle AI Ultraアプリに含まれ、Fable 5.2はトークン単位で課金されます。
デフォルトモデルをどちらかに切り替えるべきですか?
おそらくその必要はありません。GoogleはほとんどのソフトウェアエンジニアリングとナレッジワークにはArgonが引き続き適切な選択だと述べており、AnthropicもほとんどのワークロードにはOpus 5.5を推奨しています。デフォルトが失敗するタスクだけをCarbonやFableに振り分け、自分のリクエストで結果を比較しましょう。