2026年11月11日時点で、GoogleのGemini 4 Carbon APIはモデルIDとして gemini-4-carbon を使用し、2026年11月30日までは入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドル、その後は4ドルと20ドルの料金となっています。Googleは2026年11月10日に一般提供を開始し、Gemini APIの有料ティア限定での提供です。
このガイドでは、新しいAPIキーの取得から最初のリクエストの送信までを説明し、請求額を決める使用量の数値を確認した上で、テストはコーディングエージェントに任せる方法を紹介します。
Gemini 4 CarbonのモデルIDとは?
Gemini 4 CarbonのモデルIDは gemini-4-carbon です。Gemini APIのInteractionsエンドポイントへのリクエスト、PythonまたはJavaScript SDK、Google AI Studioのプロンプトのいずれかで、model フィールドにこの値を渡します。GoogleはCarbonを最も高性能な推論モデルと位置づけ、難易度の高いタスクに推奨しています。一方、日常的な作業ではGemini 4 Argonが引き続きデフォルトとなります。
モデル自体の詳細については、まず「Gemini 4 Carbonとは」をご覧ください。
| 項目 | 値 | 出典 |
|---|---|---|
| モデルID | gemini-4-carbon |
Google AI Studioドキュメント |
| 提供開始日 | 2026年11月10日 | Googleローンチ記事 |
| 提供場所 | Gemini API有料ティア、Google AI Studio、Android Studio | Googleローンチ記事 |
| 無料ティア | 利用不可 | Google AI Studioドキュメント |
| コンテキストウィンドウ | 1,048,576トークン(入力・思考・出力で共有) | Google AI Studioドキュメント |
| 同期レスポンスの最大出力 | 65,536トークン | Google AI Studioドキュメント |
| 長時間デコード | 入力を除く最大100万トークン(background: true 使用時) |
Google AI Studioドキュメント |
| 思考レベル | low、medium(デフォルト)、high |
Google AI Studioドキュメント |
| 2026年11月30日までの価格 | 入力2ドル、出力10ドル/100万トークン | Googleローンチ記事 |
| 2026年12月1日からの価格 | 入力4ドル、出力20ドル/100万トークン | Googleローンチ記事 |
| キャッシュ済み入力(暗黙的キャッシュ) | 100万トークンあたり0.10ドル、12月1日からは0.20ドル | Google AI Studioドキュメント |
Gemini 4 Carbon用のGemini APIキーを取得するには?
Carbonは有料ティアでのみ動作するため、キーだけでは不十分です。Cloud Billingが紐付いたプロジェクト上のキーが必要です:
- Google AI StudioでAPIキーのページを開きます。新規ユーザーにはプロジェクトとキーが自動的に作成されます。既存ユーザーはCreate API keyをクリックしてください。
- APIキーまたはProjectsページでSet up billingをクリックします。
- Cloud Billingアカウントを作成またはリンクし、支払い方法を追加して、Googleのクイックスタートに従い少なくとも5ドルのクレジットを前払いします。
- シェルでキーをエクスポートします:
export GEMINI_API_KEY="YOUR_API_KEY"。
「Gemini 4 Carbonの無料オプション」の記事では、APIキーが一切不要な方法を紹介しています。
最初のGemini 4 Carbon APIリクエストを送信するには?
GoogleのCarbonクイックスタートではInteractions APIを使用します。ボディに model と input を含む POST リクエストを /v1beta/interactions に送ります。モデル名を変数にしておけば、後でCarbonとArgonを切り替える際も1行の変更で済みます。
curlの場合:
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
Python SDKの場合(pip install -U google-genai):
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
どちらのスニペットもGoogleのドキュメントの例に従っています。この記事を執筆しているマシンにはCarbonの有料キーがないため検証は行っていません。実際のレスポンスの構造はご自身の最初の呼び出しで確認してください。
Googleの移行ガイドに記載されている以下の3つのポイントを押さえておくと、デバッグに時間を取られずに済みます:
- サンプリングパラメータを削除する。
temperature、top_p、top_kはCarbonでは無視されるため、削除してください。 - タイムアウトを引き上げる。 難しいプロンプトには数分かかることがあります。Googleはバックグラウンド実行か、少なくとも15分のHTTPタイムアウトを推奨しています。
- 状態はサーバー側で保持する。 マルチターンのチャットや関数呼び出しでは、履歴を再送する代わりに
previous_interaction_idを渡してください。
すでにArgonを使用している場合も、Gemini 4 Argon APIガイドと同じリクエスト構造です。
レスポンス内の使用量と思考トークンを読み取るには?
すべてのインタラクションは usage オブジェクトを返します。コストに関わる重要なフィールドは以下の通りです:
total_input_tokens:送信したトークン数。システム指示とツール宣言を含みます。total_thought_tokens:モデルが回答前に思考に費やしたトークン数。total_output_tokens:可視の回答のトークン数。total_tokens:合計。
注目すべきは total_thought_tokens です。Googleの思考ガイドによると、レスポンスの課金は出力トークンと思考トークンの合計であり、思考は出力レートの10ドルで課金されます。Googleはまた、Carbonはターンごとに作業の探索と検証のため、Argonより多くの思考トークンを消費すると述べています。難しいプロンプトでは、思考が請求額の大部分を占めることもあります。
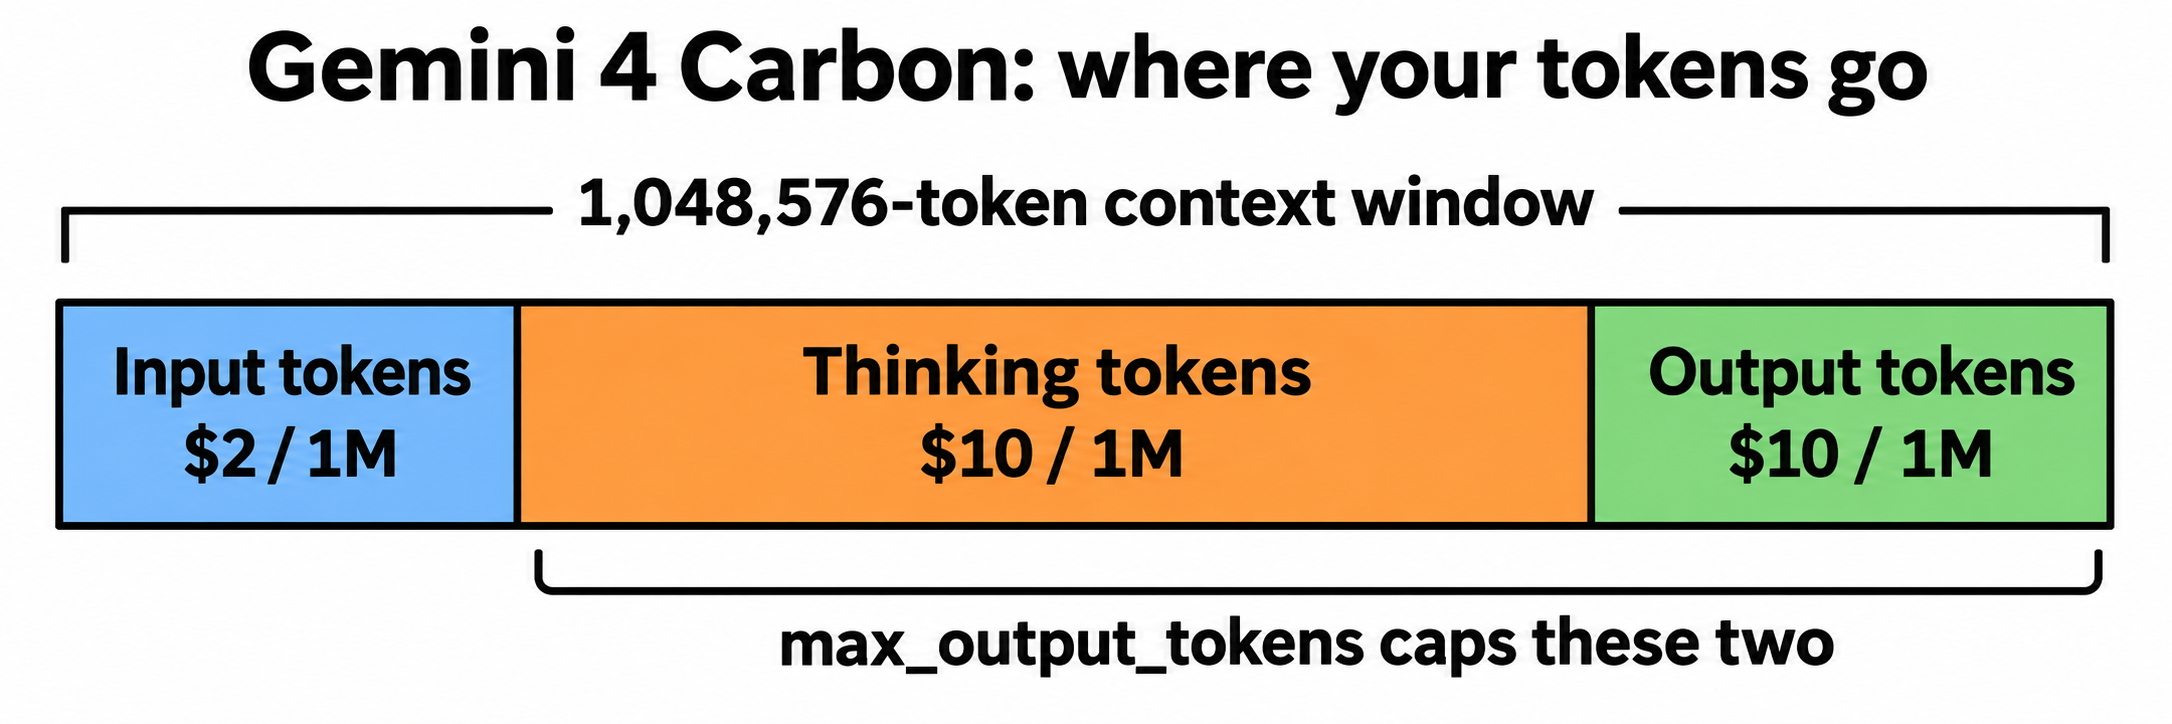
max_output_tokens は思考と出力の合計に上限を設けます。値が低すぎると、Carbonが予算を思考に使って回答を途中で打ち切る可能性があります。Googleの推奨値:
- 標準的なタスク: デフォルトの65,536のまま。
- 32K未満の制限があるアプリ: 32,768以上に引き上げる。
- 複雑な推論とコーディング:
background: trueを設定し、131,072または262,144トークンにする。
background: true を設定すると、Googleのサーバーが64Kトークン単位でレスポンスを継続します。インタラクションのステータスが in_progress や queued から変わるまでポーリングし、すべての model_output ステップのテキストを連結します。
どのGemini 4 Carbonの思考レベルを使うべきか?
思考レベルは品質、レイテンシ、コストを制御する主要な手段です。思考ガイドとCarbonドキュメントによるGoogleのガイダンスは以下の通りです:
| 思考レベル | トークン使用量 | 適した用途 |
|---|---|---|
low |
最少トークン、最低レイテンシ | シンプルでコスト重視のタスク、軽い分析や文章作成 |
medium(デフォルト) |
バランス型 | 複雑なコードやエージェント作業を含むほとんどのタスク |
high |
最多トークン、最初のトークンが最も遅い | 難しい数学、科学、最も困難なコードやエージェントのタスク |
Googleは、3つのレベルすべてで評価を実施し、品質基準を満たす最も低いレベルを採用することを推奨しています。Carbonでは、low と high の差がそのまま予算の差になります。
タスクをArgonではなくGemini 4 Carbonに送るべきときは?
Googleはこの点について明確です。「Argonは、ソフトウェアエンジニアリングとナレッジワークの大部分において依然として理想的な選択肢です」。両モデルは100万トークンのコンテキストウィンドウ、組み込みツール、同じ導入期間中のトークン単価を共有しているため、違いはターンごとに消費するトークン量にあります。複雑な根本原因のデバッグ、アーキテクチャ設計、高密度なマルチモーダル統合、証明、セキュリティ監査にはCarbonを使いましょう。インタラクティブなコーディング、日常的な機能開発、高速な本番ループにはArgonが適しています。「Gemini 4 Carbon vs Argon比較」で詳しく解説しています。また、CarbonをAnthropicの最新モデルと比較したい場合は、「Gemini 4 Carbon vs Claude Fable 5.2」と「Claude Fable 5.2 APIガイド」をご覧ください。
Gemini 4 CarbonのAPI呼び出しコストはいくらか?
Gemini 4 Carbonは、Googleによると2026年11月30日まで入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドル(思考を含む)、その後は4ドルと20ドルです。
1回の呼び出しで具体化すると、2,000入力トークン、6,000思考トークン、1,500出力トークンという例示用のリクエストを想定します。これらはあくまで例示の数値であり、実測値ではありません:
- 入力:2,000 x $2 / 100万 = $0.004
- 思考+出力:7,500 x $10 / 100万 = $0.075
- 合計:現在は約$0.079、12月1日からは約$0.158
思考トークンはプロンプトによって大きく変動するため、ご自身の usage オブジェクトを確認してください。詳細な価格計算、12月の値上げ、タスクごとのコストについては「Gemini 4 Carbonの料金」をご覧ください。
Apidog CLIでコーディングエージェントにCarbon APIをテストさせる
思考レベル、出力上限、プロンプトは何度も変更することになります。変更のたびにJSONを目視確認する代わりに、コーディングエージェント(Claude Code、Codex、Cursor)に再現可能なテストを作成させ、Apidog CLIで実行させましょう。
まず一度だけセットアップします:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
次に、エージェントに以下のプロンプトを1つ渡します:
In Apidog project <projectId>, add an endpoint for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <envId>. Create a test case that sends model "gemini-4-carbon",
a short prompt and thinking_level "low", and asserts: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Run it and summarize any failures.
テストで low を使うことで、実行ごとのコストを抑えられます。エージェントはスキーマを読み、ペイロードを検証し、テストケースを実行します:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog test-case category --project <projectId>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
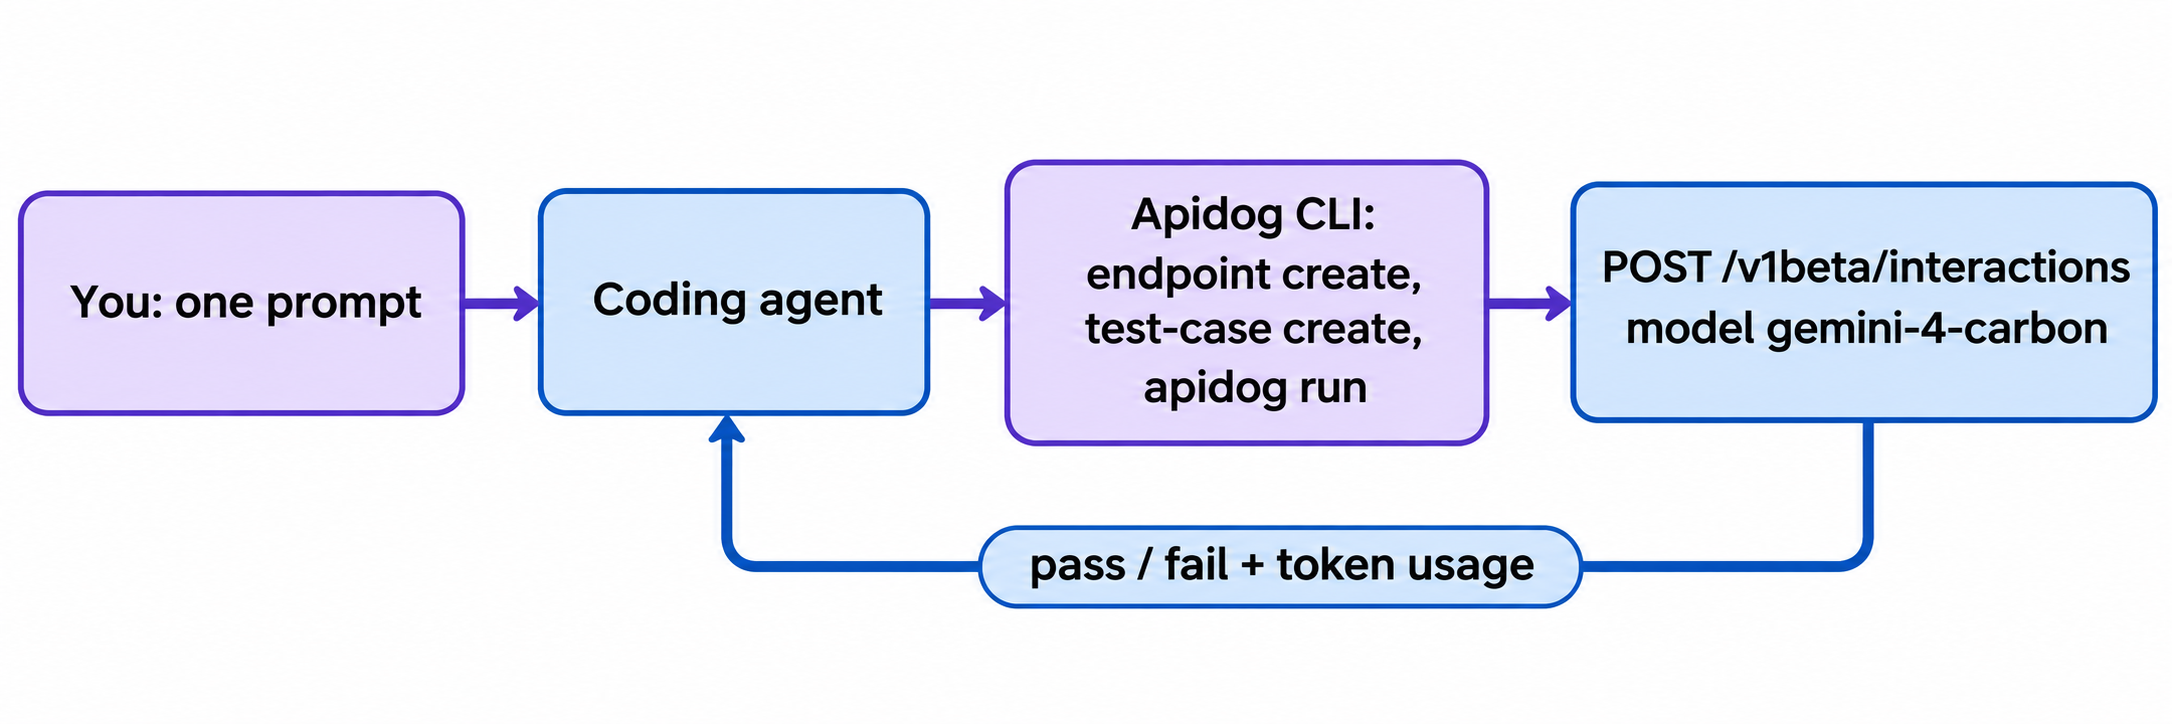
トークン予算のアサーションが特に有用です。プロンプトの変更で思考が上限を超えた場合、請求額が増える前にテストが失敗します。 -r cli,json を -r junit に変えれば、同じコマンドがCIでも実行できます。Apidog CLIのCI/CDガイドではパイプラインの構築方法を、Claude CodeでのApidog CLI活用ではエージェントのセットアップ方法を解説しています。ApidogのFreeプランは最大4ユーザーまで利用できます。
エージェントにゼロからすべてセットアップさせたい場合は、「https://apidog.com/apidog-cli-installation-guide.md を読んでApidog CLIをセットアップして」と指示しましょう。
FAQ
Gemini 4 Carbon APIは無料ですか? いいえ。Googleのドキュメントによると、Gemini 4 CarbonはGemini APIのFreeティアでは利用できません。Cloud Billingが紐付き、少なくとも5ドルの前払いクレジットがある有料ティアのプロジェクトが必要です。コンシューマー向けには、GoogleはGeminiアプリ、AI Mode、AntigravityでGoogle AI Ultraの加入者にCarbonを展開しています。
Gemini 4 CarbonはVertex AIで使えますか? Googleのローンチ記事では、Gemini API、Google AI Studio、Android Studio、Gemini for business、Antigravity、CodeMenderが挙げられています。Vertex AIは明記されていないため、計画の前にGoogle Cloudのモデル一覧を確認してください。
Gemini 4 Carbonのコンテキストウィンドウは? 1,048,576トークンで、入力・思考・出力で共有されます。同期レスポンスは65,536トークンで停止します。バックグラウンド実行では、入力を除く最大100万トークンまで実行できます。
Interactions APIの代わりにgenerateContentを使えますか? GoogleのCarbonクイックスタートではInteractions APIを使用しており、ドキュメントではクライアントサイドの長時間デコードの継続についてGenerateContent APIに言及しています。アプリがすでに generateContent を使用している場合は、移行前にモデルIDの変更をそこでテストしてください。
Gemini 4 ArgonからCarbonへ切り替えるには? モデル文字列を gemini-4-argon から gemini-4-carbon に変更します。Googleによると、リクエストスキーマの変更は不要です。Carbonはより長く思考するため、max_output_tokens とHTTPタイムアウトを引き上げ、タスクが high を必要としない限り thinking_level は medium のままにしてください。