
まだ公開されているGemini 4 Argon APIはなく、GoogleはモデルIDを公開していません。Googleは2026年9月30日にArgonを発表し、現在はFairwindプログラムの擁護者(Fairwindパートナーの一部がGemini Enterprise上のマネージドモデルとして利用)のみが利用可能です。Artificial Analysisは、Google AI StudioをArgonの唯一のAPIプロバイダーとしていますが、速度やレイテンシのデータはなく、これは登録可能なエンドポイントというよりは、許可リストによるプレリリースアクセスに該当します。より広範な展開が始まるとき、Googleは「有料API顧客とGoogle AI Ultraの購読者から」開始すると述べているため、有料のGemini APIキーがあれば優先的に利用できます。
発表からアクセスまでのこの空白期間は、あなたが活用できる時間です。このガイドでは、GoogleがArgon APIについて確認した情報とそうでない情報を区別し、Gemini 3.8 Flashで今日実行できるコードを順に説明することで、Argonへの切り替えが1つの変数を変更するだけで済むようにします。リクエストの構築、Go-Liveアラートの設定、Apidogでのレスポンスのモック、Argonの価格でのコスト上限の追加を行います。モデル自体については、Gemini 4 Argonとは何かから始め、展開段階については、Gemini 4 Argonのリリース日ガイドを参照してください。
Gemini 4 Argon APIについて確認されていることと、そうでないこと
Googleの発表投稿では、価格と出力制限が示されています。統合に必要なその他のほとんどのことはまだ公開されていません。
| 項目 | ステータス | 詳細 |
|---|---|---|
| 入力価格 | 確認済み | 100万トークンあたり2ドル(導入期間)、導入期間後は4ドル |
| 出力価格 | 確認済み | 100万トークンあたり10ドル(導入期間)、導入期間後は20ドル |
| キャッシュ済み入力 | 確認済み | 入力95%オフ:導入期間0.10ドル、標準0.20ドル |
| 出力制限 | 確認済み | 64Kから1Mトークンに増加 |
| APIサーフェス | 示唆あり | Googleのドキュメントによると、すべての新しいモデルはInteractions APIで起動される |
| モデルID | 未公開 | モデルページ、価格ページ、変更履歴に記載なし |
| 入力コンテキストウィンドウ | 未公開 | Googleの長文コンテキスト評価では最大1Mトークンのプロンプトが使用されたが、これは仕様ではない |
| 思考レベル | 未公開 | 評価は「最高の思考設定」で実行された。名前とデフォルトは不明 |
| レート制限 | 未公開 | 階層は発表されていない |
| バッチサポート | 未公開 | バッチまたはFlexの価格設定なし |
| 長文プロンプトティア | 未公開 | 3.1 Proは200Kを超えると追加料金が発生するが、Argonのルールは未発表 |
| 導入期間の長さ | 未公開 | 2ドル/10ドルの終了日は未定 |
2つの行については、より詳しく見る必要があります。「APIサーフェス」の行は、新しいモデルが「Interactions APIで起動される」と述べているInteractions APIドキュメントに由来します。Argonは新しいモデルであるため、まずそこで利用可能になると予想されます。GoogleはgenerateContentがそれをサポートするかどうかは述べていません。「出力」の行は、Googleがモデルに対して設定した制限ですが、Vals AIはテストした構成で最大262Kの出力しかリストしておらず、すべてのエンドポイントが初日から完全に100万トークンをサポートするとは限らないことに注意してください。当社の1M出力トークンガイドでは、その制限がストリーミング、タイムアウト、ストレージにどのような影響を与えるかを解説しています。
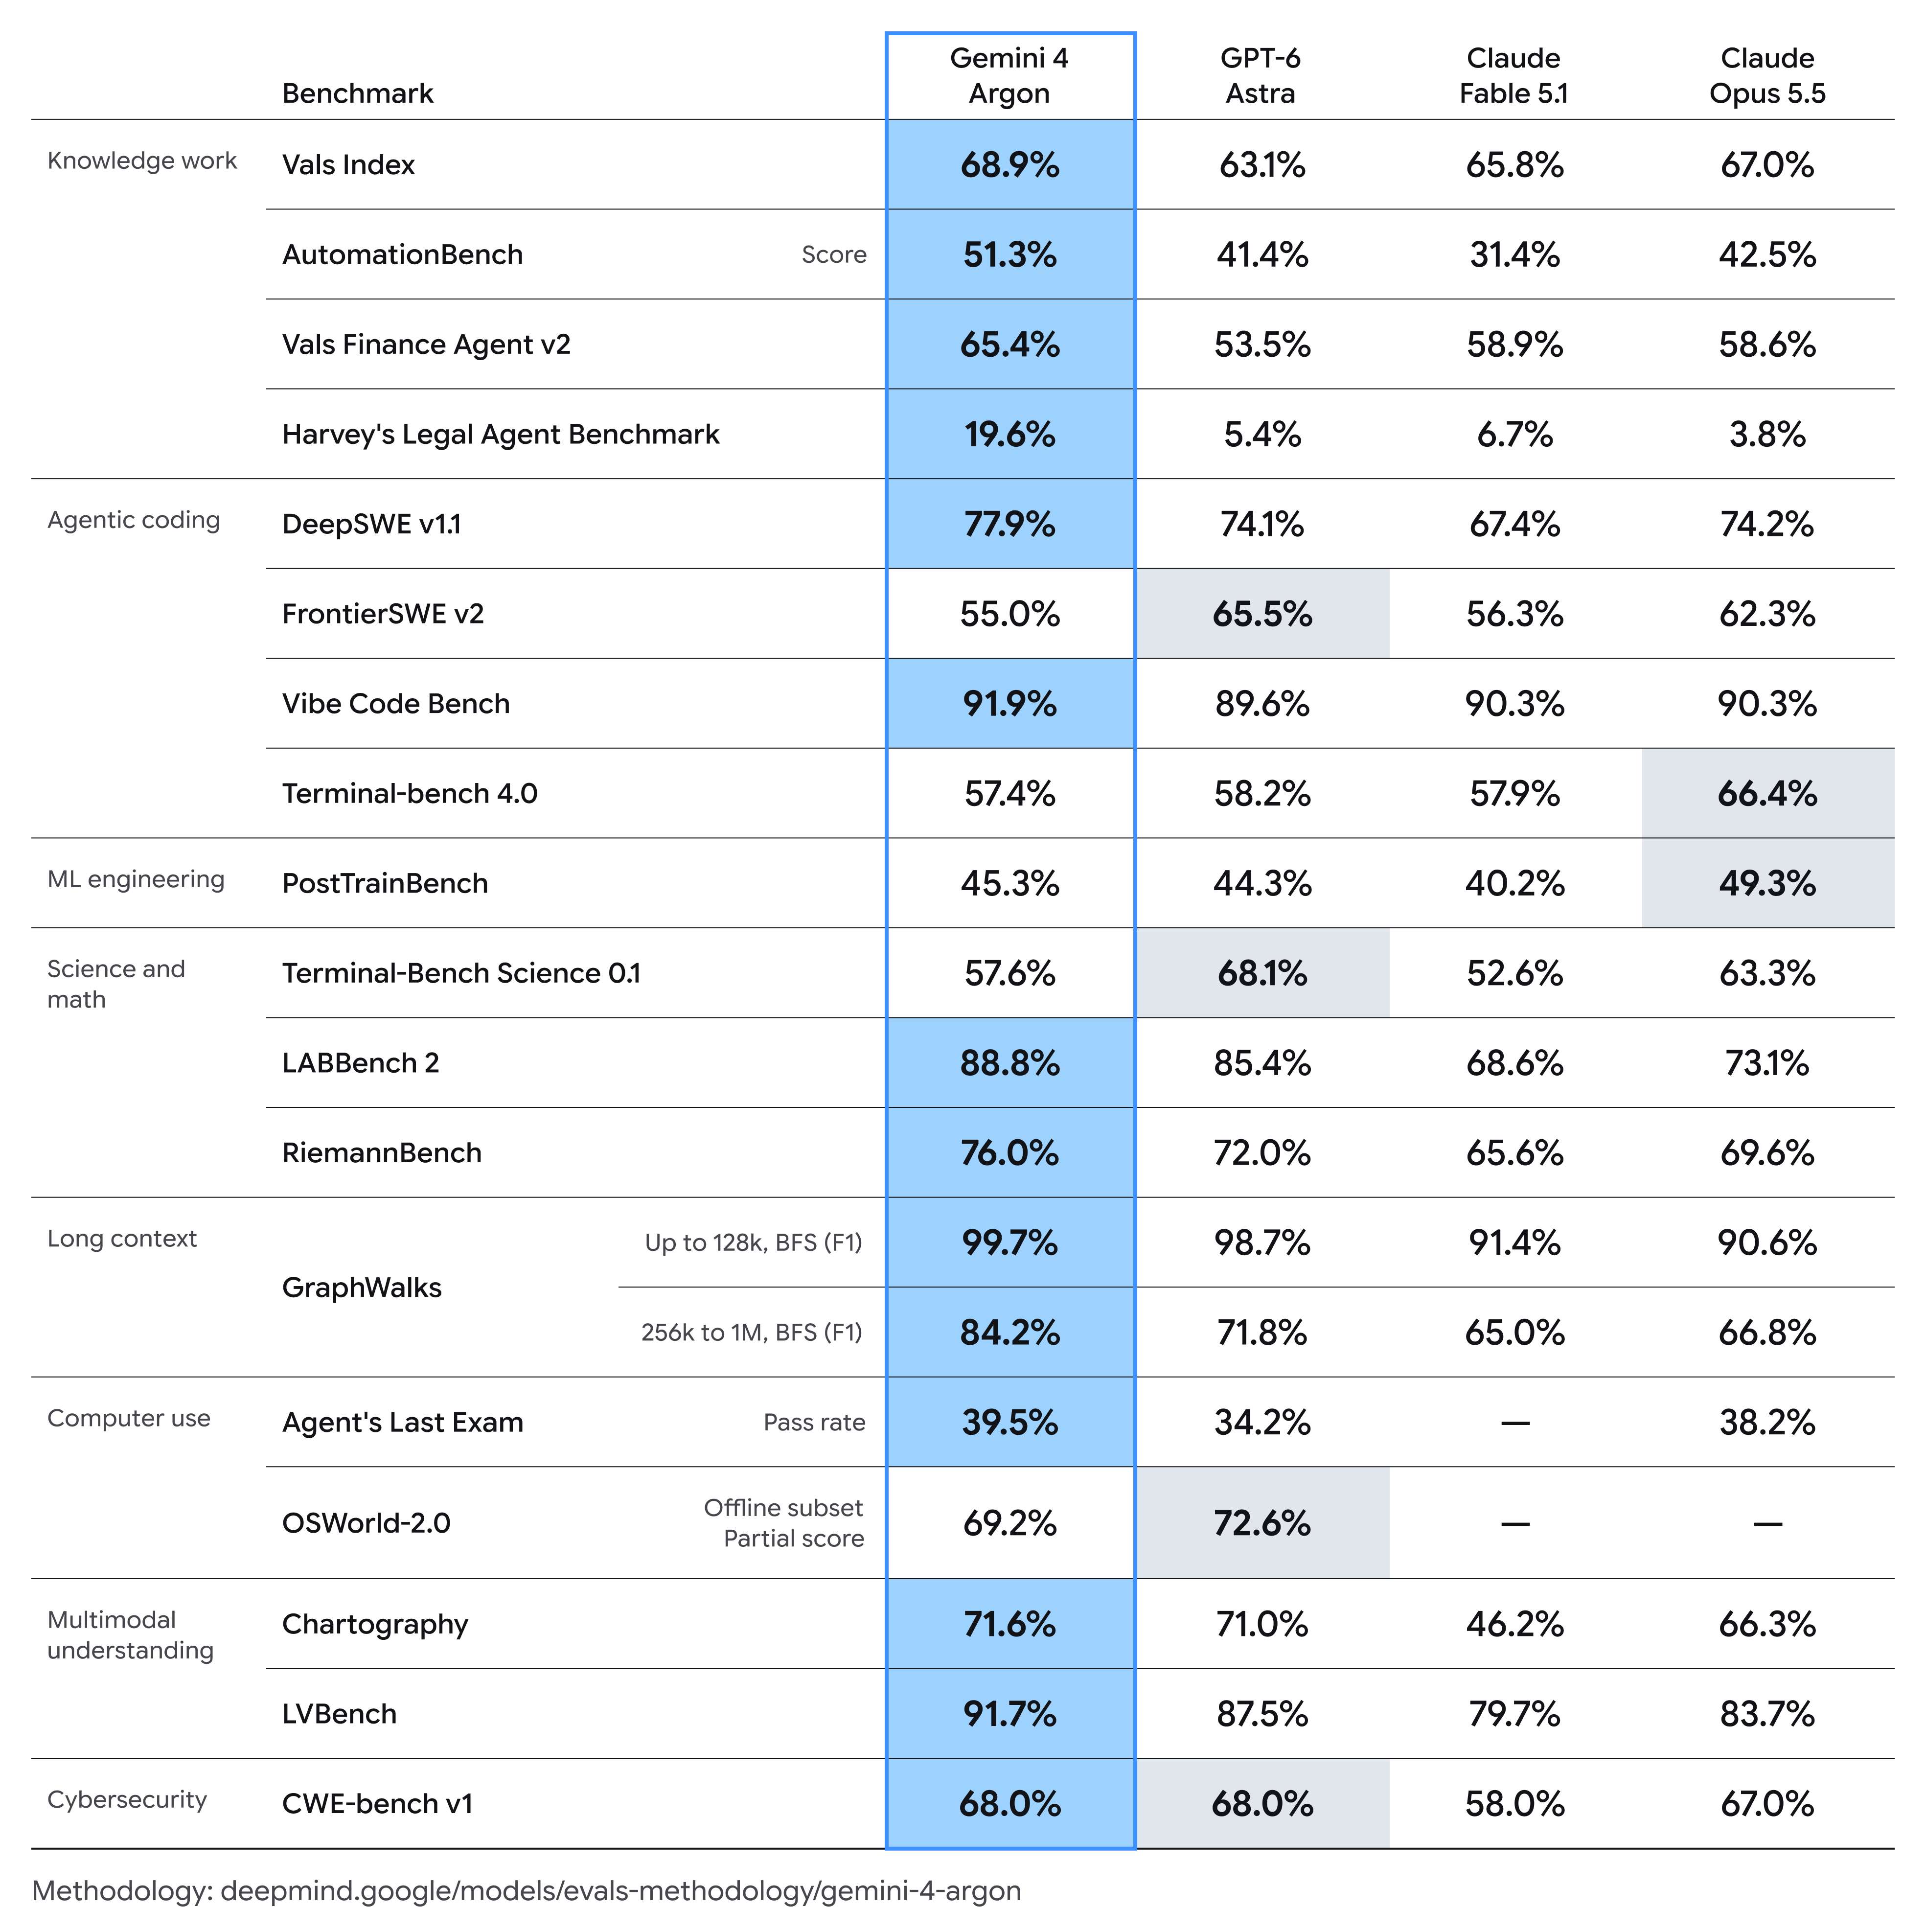
価格については、ここで1つの段落で十分です。20,000トークンのプロンプトと5,000の出力トークンを含むリクエストは、導入料金で20,000 x $2/1M + 5,000 x $10/1M = $0.04 + $0.05 = $0.09、標準料金$4/$20では$0.18かかります。Argonの導入出力価格($10)はGemini 3.1 Pro Previewの$12を下回っており、その標準価格はClaude Opus 5.5と完全に一致します。Gemini 4 Argonの価格内訳では、キャッシュされた入力と最大100万トークンのレスポンスを含む、あらゆるシナリオが網羅されています。
オンラインで見つけたモデルIDをハードコードしないでください
ArgonモデルIDを検索すると、ベンチマークサイト、アグリゲーター、オープンソースのプルリクエストに文字列が見つかるでしょう。それらはプレースホルダーです。Vals AIは自身のモデルページで独自のslugを使用しており、あるGitHubプルリクエストではIDが「暫定的に」追加され、OpenRouterスタイルのパスはnot-foundページに繋がります。Googleはそれらのいずれも確認しておらず、いくつかの媒体では推測をハードコードしないよう明示的に警告しています。
推測されたIDは、最も役に立たない形で失敗します。デプロイ日に本番環境で404エラーが発生したり、ラッパーがエラーを広範に捉えすぎるとサイレントフォールバックが発生したりします。代わりに、モデル名を構成に保持してください。以下のすべての例では、モデルはデフォルトで今日呼び出せる安定したモデルであるgemini-3.8-flashに設定されているGEMINI_MODEL環境変数から取得されます。GoogleがArgonのIDを公開したら、1つの値を変更するだけです。
Gemini 3.8 Flashでコードを準備する
Gemini 3.8 Flash(gemini-3.8-flash)は、Argonが使用すると予想されるエンドポイント、ヘッダー、レスポンス形式と同じものを利用し、2026年12月31日まで100万トークンあたり$0.75/$3.75で動作します。あなたのキーはGEMINI_API_KEYに格納されます。コードに直接貼り付けないでください。完全なセットアップは、当社のGemini 3.8 Flash APIガイドに記載されています。
ステップ1:Interactions APIリクエストを送信する
Interactions APIはGoogleの主要APIであり、2026年6月から一般提供されています。Argonのレベル名は公開されていないため、モデルと思考レベルの両方を変数に保持してください。
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Interactions APIには、Python SDKでgoogle-genai 2.3.0以降が必要です。
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
3.8 Flashでは、有効なレベルはlow、medium(デフォルト)、highです。minimalはHTTP 400を返します。当社の思考レベルガイドでは、トレードオフについて説明しています。複数ターンでの作業の場合、前のレスポンスのIDをprevious_interaction_idとして渡し、サーバーサイドストレージをオプトアウトするにはstore: falseを送信してください。
ステップ2:generateContentパスを機能させ続ける
既存のコードのほとんどはレガシーなgenerateContentエンドポイントを呼び出しますが、Googleによるとこれは完全にサポートされ続けています。同じリクエストは次のとおりです。
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
思考レベルがどこに設定されるかに注目してください。Interactionsではgeneration_config.thinking_level、ここではgenerationConfig.thinkingConfig.thinkingLevelです。クライアントが両方をラップしている場合、新しいモデルはデフォルトでInteractionsを経由するようにルーティングしてください。ツール定義も同様の注意が必要です。Gemini 3.8 Flash関数呼び出しを参照してください。
ステップ3:models.listでGo-Liveチェックをスケジュールする
変更履歴を更新しないでください。APIに問い合わせてください。modelsエンドポイントは、利用可能なモデルと、それらのトークン制限およびサポートされているメソッドを返します。
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
本番アプリで使用しているキーを使って、cronまたはCIスケジュールから1時間ごとに実行してください。2026年10月1日に有料プロジェクトキーでこの呼び出しを実行したところ、61のモデルが返され、nextPageTokenはなく、「argon」を含む名前もありませんでした。一致した日には、そのエントリが、実際のモデル名、outputTokenLimitが完全な1Mであるかどうか、およびリストされているメソッドの3つの情報を一度に教えてくれます。
ステップ4:レスポンスをモックして、アクセス前にクライアントを構築する
Argonを消費するコードを構築するためにArgonは必要ありません。ステップ2のリクエストをApidogにGEMINI_API_KEYとGEMINI_MODELを環境変数として保存し、一度3.8 Flashに対して送信して、実際のリクエストをレスポンス例としてエンドポイントに抽出します。ApidogのデフォルトのSmart Mockはスキーマからデータを生成するため、プロジェクトのデフォルトのモックメソッドを「Response example first」(プロジェクト設定、機能設定、モック設定)に設定してください。これにより、モックURLが保存されたレスポンスを返し、フロントエンド、キューワーカー、パーサーはトークンを消費することなくそれに対して実行できます。
このモックが何であるかを明確にしてください。GoogleがArgon固有のレスポンススキーマを公開していないため、これは現在のGeminiのレスポンススキーマであり、Argon固有のものではありません。Argonも同じAPIで利用可能になると予想されるため、これは依然として正しい選択です。大規模なArgonの応答をリハーサルするには、例のusageMetadataを大きなカウントに編集し、請求およびアラートコードが反応するかどうかを確認してください。
ステップ5:usageMetadataとコスト上限についてアサートする
すべてのgenerateContentレスポンスにはusageMetadataが含まれています。Apidogにポストプロセッサースクリプトを追加し、Argonの標準料金で各レスポンスを価格設定することで、請求が発生する前にテストが失敗するようにします。
// Apidogのポストプロセッサー: このレスポンスをGemini 4 Argonの標準料金で計算
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // 導入期間後の入力トークンあたりのUSD
const OUT = 20 / 1e6; // 出力トークンあたりのUSD。現在のGeminiモデルでは思考トークンも出力として請求される
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadataは存在する", () => pm.expect(u).to.be.an("object"));
pm.test("Argon料金でのコストが0.10ドル未満である", () => pm.expect(cost).to.be.below(0.10));
リクエストごとに上限を設定してください。この例のような短いプロンプトには$0.10が適しています。GoogleはArgonが思考トークンをどのように請求するかを明示していないため、スクリプトは現在のGeminiのルールを前提としています。同じ保存されたリクエストを今すぐ3.8 Flashで、後でArgonで実行してください。トークン数とコストの違いが、あなたのリグレッション比較となります。
よくある質問
Gemini 4 Argon APIは利用できますか? 公開されていません。Argonは、Fairwindプログラムのパートナーの一部のみに展開されており、彼らはGemini Enterpriseを通じて利用しています。有料API顧客とGoogle AI Ultraの購読者が次に続きますが、具体的な日程は未定です。
Gemini 4 ArgonのモデルIDは何ですか? Googleは公開していません。サードパーティサイトの文字列はプレースホルダーなので、モデルを環境変数に保持し、models.listを監視してください。
Gemini 4 Argon APIの費用はいくらですか? 期間未定の導入期間中は、100万トークンあたり入力2ドル、出力10ドルで、その後は4ドルと20ドルになります。キャッシュされた入力は95%オフです。Gemini 4 Argonの価格を参照してください。
ArgonはgenerateContentで動作しますか? Googleは明言していません。ドキュメントによると、すべての新しいモデルはInteractions APIで起動されるため、Interactionsで構築し、generateContentはフォールバックとして扱うべきです。
Google AI UltraでAPIアクセスが得られますか? いいえ。AI Ultraは消費者向けサブスクリプションであり、APIキーではありません。Googleは、APIアクセスは有料API顧客から始まると述べています。
次のステップ
すべての環境でGEMINI_MODELを設定し、models.listチェックをスケジュールし、コストアサーションを付加したInteractionsおよびgenerateContentリクエストを保存してください。Apidogをダウンロードして、これらのリクエスト、モック、テストを1つのワークスペースに保持し、GoogleがIDを公開したときに1つの変数を変更するだけです。