DeepSeekは2026年9月10日にDeepSeek-V4.1-Flashのモデルカードを公開しましたが、その数値はV4-Proの顧客にとって都合の悪いものです。より小型で安価なモデルは、DeepSeekがリストアップしているすべてのコーディングおよびエージェントベンチマークにおいてフラッグシップモデルよりも高いスコアを叩き出し、ピーク時のトークンあたりのコストは70〜77%低く、さらに9月14日にはV4-Proを完全に吸収します。つまり、deepseek-v4-proへのすべてのリクエストはV4.1-Flashにルーティングされ、Flashの料金で課金されます。
これは通常の「小さい方がいいか、大きい方がいいか」というトレードオフではありません。これは期限付きの比較です。もし本番環境でV4-Proを使用しているなら、ルーティングが切り替わる際に何が変わるのかを学ぶための時間は4日間しかありません。もしV4-Flashを使用しているなら、変更はすでに発生しています。deepseek-v4-flashという名前は今日からV4.1-Flashによって提供されています。
以下に、アーキテクチャ、DeepSeekが報告したベンチマーク、米ドル価格、スループットに関する3つのモデルすべてを比較します。その後、切り替え前にApidogでdeepseek-v4-proとdeepseek-flashの両方に1つのプロンプトセットを実行し、出力、レイテンシ、使用量カウントを比較するワークフローを示します。アーキテクチャの詳細については、まずDeepSeek-V4.1-Flashとは何かをお読みください。移行チェックリストについては、V4-Proリタイアメントガイドをご参照ください。
要約
- V4.1-FlashはDeepSeek自身のベンチマークで勝利。 DeepSWE v1.1が主要な点です。V4-Proの62.7、V4-Flashの54.4に対し、74.2を記録しました。
- 3つの中で最も安価。 ピーク時のキャッシュミス入力は、V4-Proが1Mトークンあたり1.32ドル、古いV4-Flashが0.44ドルであるのに対し、0.30ドルです。
- スループットのために構築。 プリフィルには80億のアクティブパラメータ、トークンあたり890バイトのKVキャッシュ、2,500の同時実行制限。
- 9月14日以降は選択肢は一つ。 V4-ProのトラフィックはV4.1-Flashに再ルーティングされます。どちらを選ぶかではなく、何を得て何を失うかが問題です。
スペック比較
V4.1世代は、再トレーニングされたものではなく、新しいアーキテクチャです。DeepSeekはこれを因果エンコーダー・デコーダー(CED)と呼んでいます。20層のエンコーダーと20層のデコーダーに分割された40層で構成され、各層には384のルーティングされたエキスパートと1つの共有エキスパートがあります。モデルカードによると、基盤モデルは5520億パラメータ(ビジョンエンコーダーを含めると7630億パラメータ)です。
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| アーキテクチャ世代 | V4 MoE | V4 MoE | V4.1 因果エンコーダー・デコーダー、40層 |
| 総パラメータ数 | 2840億 (OpenRouterのビジョンビルドリスト) | ここで開示なし | 5520億(基盤モデル)、7630億(ビジョンエンコーダー含む) |
| アクティブパラメータ数 | 130億 | ここで開示なし | 80億(プリフィル)、160億(デコード) |
| コンテキストウィンドウ | 100万トークン | 100万トークン | 100万トークン |
| 最大出力 | 38.4万トークン | 38.4万トークン | 38.4万トークン |
| ビジョン | 別途Vision-Expビルド | ここで開示なし | ネイティブ、DeepSeek-ViTエンコーダー |
| ライセンス | ここで説明なし | ここで説明なし | MIT、Hugging Faceで重み公開 |
| 同時実行制限 | 2,500 | 500 | 2,500 |
| APIステータス | 廃止、V4.1-Flashによってエイリアスが提供 | 9月14日にV4.1-Flashに再ルーティング | 9月10日から一般提供、モデルID deepseek-flash |
アクティブパラメータ数が分割されている点に注目してください。V4-Flashはすべてのトークンに130億を使用していたのに対し、V4.1-Flashは入力に80億、出力に160億を費やしており、品質が出力で決まることを示しています。
ベンチマーク:11.5ポイントの由来
以下に示す数値はすべて、DeepSeekがモデルカードから報告したものです。独立した実行は公開されておらず、リタイアメント通知の「複数の関係者によるテスト」という表現は、具体的な関係者名を挙げていません。これらはベンダーの主張として扱い、ご自身のプロンプトで検証してください。
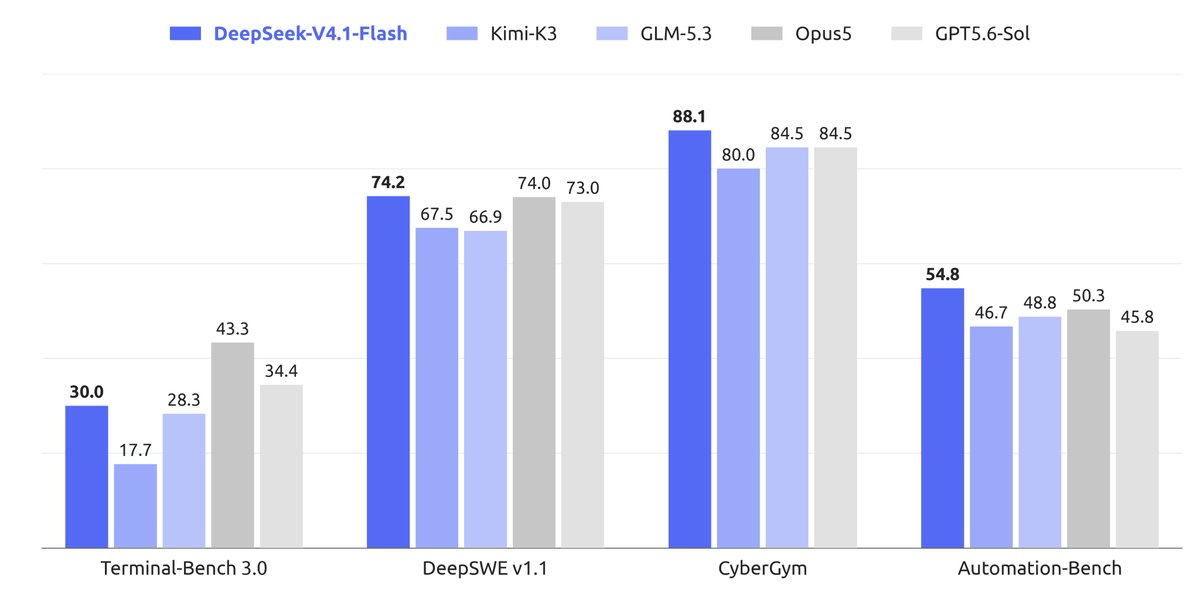
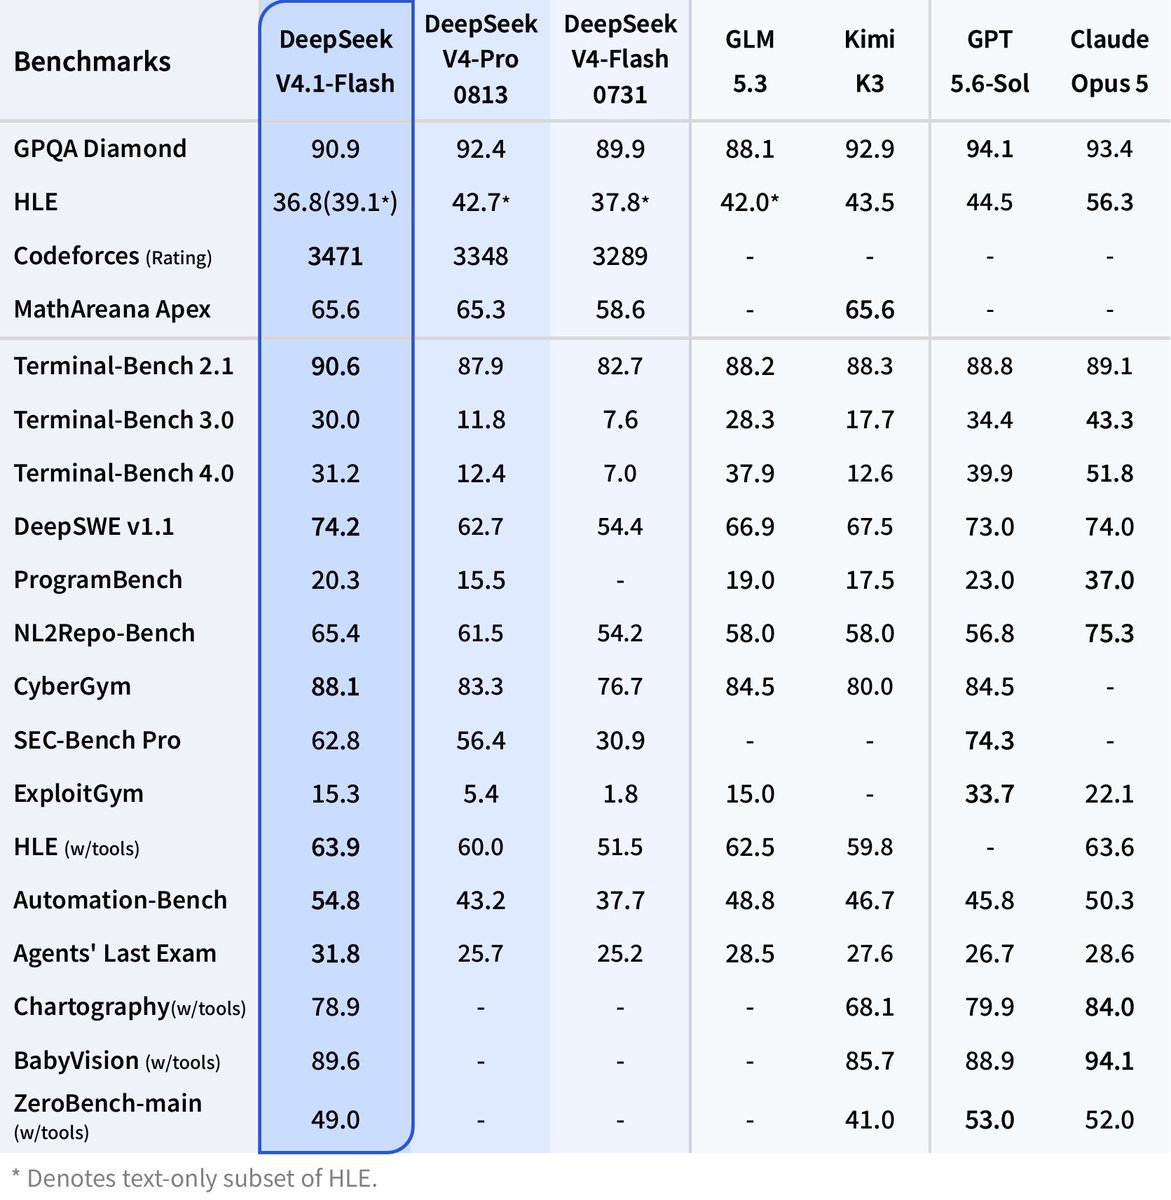
DeepSWE v1.1(Proを+11.5、V4-Flashを+19.8上回る)。 これが主要な点であり、意思決定を変えるに足る唯一の大きな差です。DeepSWEは、コーディングエージェントが一日中実行するマルチファイルソフトウェアエンジニアリングタスクを測定します。もしこれがあなたのリポジトリでも当てはまるなら、V4.1-Flashは4倍高価だったモデルを上回るコーディング性能を発揮します。
Terminal-Bench 2.1(+2.7)。 シェル駆動のエージェントタスク。V4-Flash-0731は7月にすでにV4-Pro-Previewを上回っていましたが、V4.1はそのリードを3ポイント未満で拡大しています。実際の差ですが、決定的ではありません。
HumanEval(+2.6)およびGSM8K(+0.4)。 両方ともほぼ飽和状態にあります。すべてのモデルがGSM8Kで90を上回り、HumanEvalは本番コードについてはほとんど何も示唆しません。これらの項目を重視しないでください。
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7には、V4世代の他のオープンモデルとの比較数値がありますが、V4.1はまだ含まれていません。
コスト:3つのモデル、6つの料金ティア
ピーク時間は月曜日から金曜日のUTC 01:00〜04:00と06:00〜10:00です。それ以外の時間はオフピークとなり、半額です。料金は料金ページからの100万トークンあたりの料金で、9月10日から有効です。V4-Flashの行には、2026年8月21日の米ドルレートが「変更前」の列として使用されています。
| モデルとティア | 入力(キャッシュヒット) | 入力(キャッシュミス) | 出力 |
|---|---|---|---|
| V4-Flash、オフピーク(8月21日レート) | $0.007 | $0.22 | $0.66 |
| V4-Flash、ピーク(8月21日レート) | $0.014 | $0.44 | $1.32 |
| V4-Pro、オフピーク | $0.022 | $0.66 | $1.98 |
| V4-Pro、ピーク | $0.044 | $1.32 | $3.96 |
| V4.1-Flash、オフピーク | $0.003 | $0.15 | $0.60 |
| V4.1-Flash、ピーク | $0.006 | $0.30 | $1.20 |
V4-Flashと比較して、V4.1はキャッシュヒット入力を約57%、キャッシュミス入力を約32%、出力を約9%削減します。V4-Proと比較すると、ピーク時のキャッシュミス入力で77%、出力で70%の削減となります。
1ヶ月間の試算。 コーディングエージェントが、70%のキャッシュヒット率(システムプロンプトとリポジトリコンテキストを複数ターンで再利用)で月に20億の入力トークンを処理し、3億の出力トークンを生成する場合(すべてピーク時)。
| V4-Pro、ピーク | V4-Flash、ピーク | V4.1-Flash、ピーク | V4.1-Flash、オフピーク | |
|---|---|---|---|---|
| 14億(キャッシュヒット入力) | $61.60 | $19.60 | $8.40 | $4.20 |
| 6億(キャッシュミス入力) | $792.00 | $264.00 | $180.00 | $90.00 |
| 3億(出力) | $1,188.00 | $396.00 | $360.00 | $180.00 |
| 月間合計 | $2,041.60 | $679.60 | $548.40 | $274.20 |
これはV4-Proと比較して73%の削減であり、バッチジョブをオフピークに移行するとさらに半減します。出力トークンが各列で大部分を占めるため、70%の出力削減はキャッシュヒットの削減よりも重要です。V4.1-Flashの料金内訳では、キャッシュヒットの計算について説明しています。
速度とスループット
DeepSeekは1秒あたりのトークン数を公表していません。そのため、スループットの話は3つのアーキテクチャ上の事実と1つの逸話に基づいています。
- トークンあたり890バイトのKVキャッシュ。 FP4メインKVキャッシングにより、グローバルキャッシュはV4-Flashのフットプリントの約4分の1になります。リリースノートでは、前世代のHBMの1/4、SSDストレージの1/8と記載されています。100万トークンの完全なコンテキストには約0.9GBのキャッシュが必要です。
- プリフィルには80億のアクティブパラメータ。 V4-Flashの130億よりも入力トークンあたりの計算量が少ないため、大規模なコンテキストでのファーストトークンまでの時間が短縮されるはずです。
- 同時実行数2,500 vs 500。 再ルーティングされたV4-ProのトラフィックはFlashの制限を受け継ぎ、エージェントフリートにとって5倍のメリットとなります。
- あるユーザーの報告:「ほぼ400 t/s」。 あるXユーザーがベータテスト中のビデオテストから投稿しました。これは逸話であり、ベンチマークではありません。HNベータスレッドも同様の熱意で溢れています。
これらを信頼する前に、ご自身のp50とp95を測定してください。
9月14日以降に失うもの、得るもの
切り替え後は「どのモデルを選べばいいか」という問いはありません。deepseek-v4-proはエイリアスとなるため、正直なところ損益計算書のようなものです。
得られるもの: リストされたすべてのベンチマークで高いスコア、ピーク時で70〜77%低い価格、5倍の同時実行性、別のビジョンモデルIDなしでのネイティブ画像入力、そしてDeepSeekが1から100のスケールで連続的に制御可能と説明する推論努力ダイヤル。
失うもの: V4世代のチェックポイントを固定する機能。V4-Proのスタイル、冗長性、ツール呼び出しフォーマットに合わせて調整されたプロンプトがずれる可能性があります。出力長と推論トークン数が変更される可能性があり、料金表には示されていない方法で請求額が変わります。また、再ルーティングはあなたのスケジュールではなく、DeepSeekのスケジュールで発生します。
この2番目のリストこそが、14日以降ではなく、14日より前に差分比較を行うべき理由です。
切り替え前にApidogでV4-ProとV4.1-Flashを比較する
ApidogはAPIレイヤーをテストするため、両方のモデルIDに1つのプロンプトセットを実行し、返ってくるものを比較するのに適した場所です。
- エンドポイントを追加する。 プロジェクトを作成し、
POST https://api.deepseek.com/chat/completionsを追加するか、OpenAPIスペックをインポートします。 - キーとモデルIDを環境変数に設定する。
DEEPSEEK_API_KEYとMODEL変数を保存します。MODEL=deepseek-v4-proを持つv4-pro環境と、MODEL=deepseek-flashを持つv41-flash環境の2つを作成し、ヘッダーでBearer {{DEEPSEEK_API_KEY}}として、ボディで"model": "{{MODEL}}"としてそれらを参照します。 - 実際のプロンプトをリクエストとして保存する。 本番環境を代表する20〜30個のプロンプト(システムプロンプト、ツール呼び出しターン、長文コンテキストの要約、複数ファイルのコード編集など)を選びます。それぞれを
stream: falseで保存し、usageオブジェクトがレスポンスボディに含まれるようにします。 - 請求額に影響するフィールドをアサートする。 保存されたリクエストからテストシナリオを構築し、
usage.prompt_tokens、usage.completion_tokens、usage.prompt_cache_hit_tokensに対してアサーションを追加します。ステップごとの応答時間を記録し、実行が識別できるように環境名をヘッダーに付与するプリリクエストスクリプトを追加します。 - 環境ごとに一度実行し、その後差分を比較する。
v4-pro環境でシナリオを実行し、次にv41-flash環境で実行します。完了トークン数(再ルーティングによって出力の請求額が変わります)、ステップごとのレイテンシ、そしてフォーマットのずれがないかコンテンツ自体を比較します。 - 14日にCIで再実行する。 切り替え時にパイプラインで
apidog-cliを使用して同じシナリオを実行します。再ルーティングによって何か問題が発生した場合、サポートチケットではなく失敗したアサーションとして表示されます。
スクリプトでの同じ比較は以下の通りです。
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
ピーク時とオフピーク時に実行し、出力を保存してください。Apidogをダウンロードして、差分、アサーション、実行履歴を1か所にまとめてください。
FAQ
V4.1-FlashはコーディングにおいてV4-Proよりも優れていますか? DeepSeekが報告した数値によると、はい。DeepSWE v1.1で74.2 vs 62.7、Terminal-Bench 2.1で90.6 vs 87.9です。V4世代がコーディングでClaudeとどのように比較されたかについては、DeepSeek V4 vs Claude Opus for codingをご覧ください。
9月14日にV4-Proとの統合はどうなりますか? UTC 04:00から、すべてのdeepseek-v4-proリクエストはV4.1-Flashによって提供され、Flashの料金で課金されます。あなたのコードは引き続き動作しますが、その背後のモデルが変更されます。移行ガイドに完全なチェックリストがあります。
deepseek-v4-flashをdeepseek-flashにリネームする必要がありますか? 今日のところは必要ありません。deepseek-v4-flashとdeepseek-v4-flash-vision-expは引き続きV4.1-Flashによって受け入れられ、提供されます。DeepSeekは削除日を公表していないため、次回設定を変更する際にdeepseek-flashに切り替えてください。
V4.1-FlashはV4-Proよりも高速ですか? DeepSeekはそう述べていますが、具体的な数値は公表していません。アーキテクチャはその主張を裏付けています。プリフィルに80億のアクティブパラメータを使用し、KVキャッシュはV4-Flashの4分の1のサイズです。ご自身で測定してください。
V4-Proをどこかでまだ実行できますか? 14日以降はDeepSeekのAPIでは実行できません。V4世代の背景については、DeepSeek V4とは何かをご覧ください。V4.1-Flashの重みはMITライセンスでHugging Faceにあります。
まとめ
V4.1-Flashは、ベンダーの表によれば、より小型で、より安価で、同時に高スコアです。しかし、その表だけではあなたのプロンプトにとってそれが優れているかどうかはわかりません。今週中にApidogで同じプロンプトセットを両方のモデルIDで実行し、差分を保存しておけば、9月14日に何が変わるかをユーザーが知る前に知ることができます。