
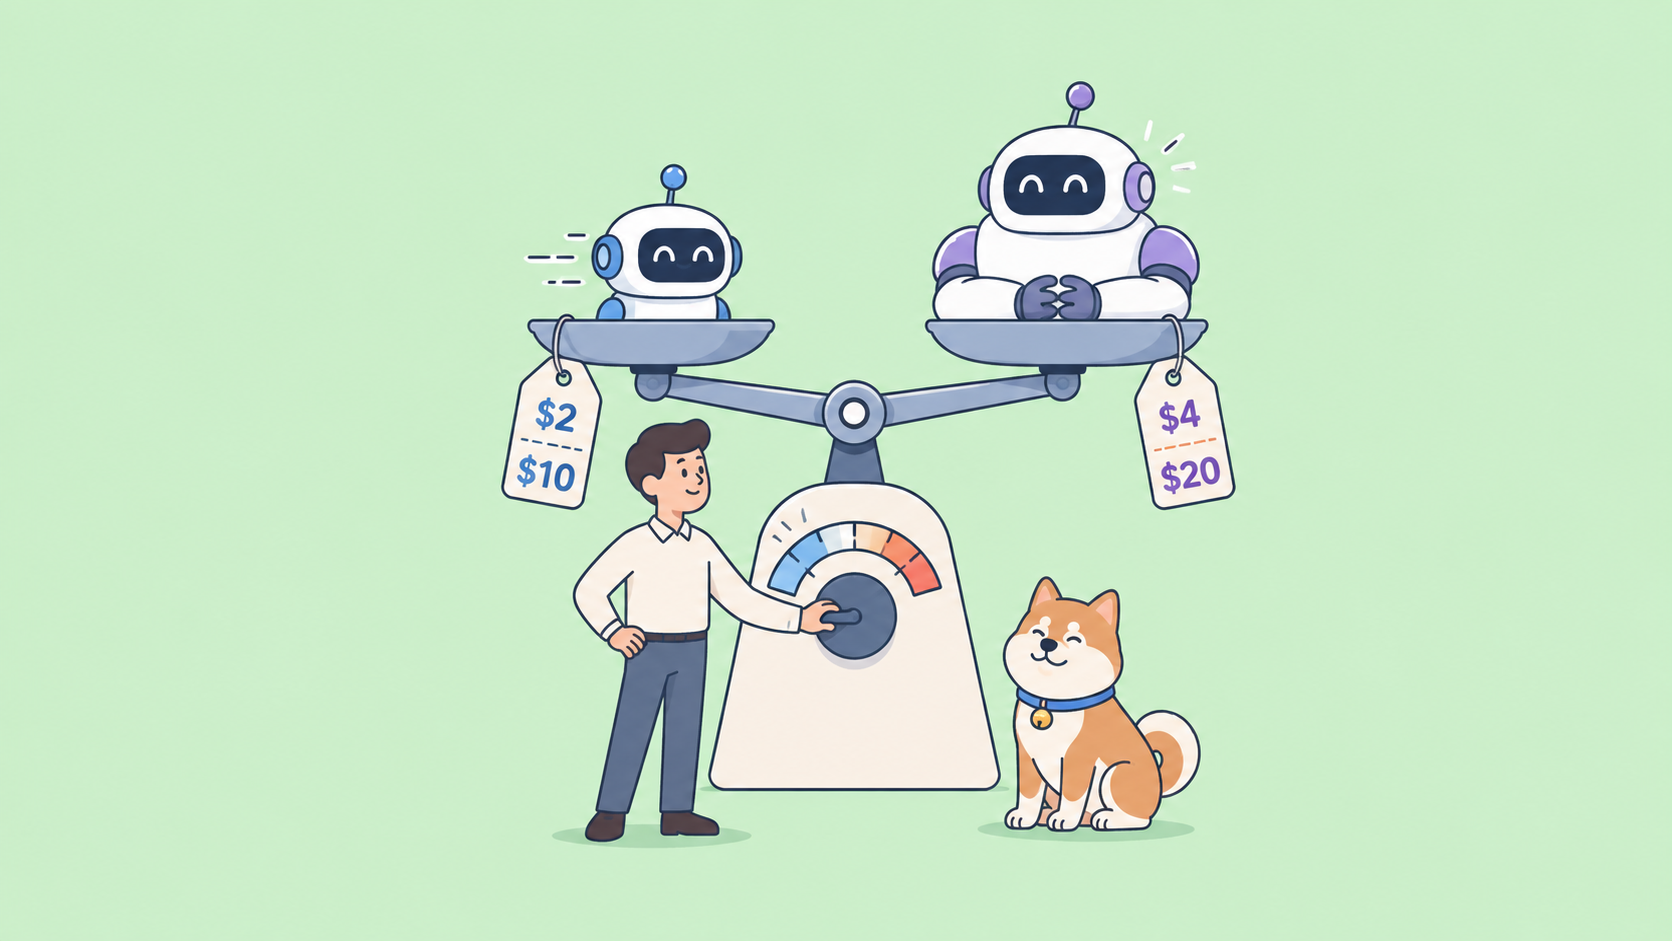
Claude Sonnet 5.5の料金は、入力トークン100万個あたり2ドル、出力トークン100万個あたり10ドルで、Claude Opus 5.5の4ドル/20ドルの半額です。Anthropicの発表表では、ほとんどの項目でOpus 5.5と数ポイント差で並び、Terminal-Bench 4.0では(70.6%対66.4%で)Opus 5.5を上回っていますが、AnthropicはOpus 5.5が「複雑でオープンエンドな作業において明確に優れている」と述べています。結論として、明確なスコープの大量の作業やサブエージェントには、低から高エフォートでSonnet 5.5を使用すべきです。長期的でオープンエンドなタスク、またはSonnetをxhighやmaxまでプッシュするような場面ではOpus 5.5の料金を支払いましょう。なぜなら、Opusのmediumまたはhighエフォートは、同等またはそれ以下の費用でより高いスコアを出すことが多いからです。
ボタン
各モデルの詳細については、Claude Sonnet 5.5とはとClaude Opus 5.5とはをご覧ください。最後のセクションでは、Apidogで独自のプロンプトを使って両方をテストする方法を紹介しています。
仕様と価格の比較
| Sonnet 5.5 | Opus 5.5 | |
|---|---|---|
| APIモデルID | claude-sonnet-5-5 |
claude-opus-5-5 |
| 入力 / 出力、100万トークンあたり | $2 / $10 | $4 / $20 |
| キャッシュ書き込み (5分) | $2.50 | $5 |
| キャッシュ読み取り | $0.20 | $0.20 |
| 高速モード | 利用不可 | $8 / $40 |
| APIのデフォルトエフォート | high |
medium |
| 思考 | デフォルトで適応型、またはbetween_tools |
適応型、常時オン |
| コンテキスト / 最大出力 | 1M / 128K | 1M / 128K |
| レイテンシクラス | 高速 | 中程度 |
特に重要な3つの項目:
- キャッシュ読み取りの費用は同じなので、キャッシュを多用するエージェントループでは、ギャップは主にアウトプットとキャッシュ書き込みにあります。Claude Sonnet 5.5の価格設定で計算されています。どちらのモデルもロングコンテキストのプレミアム料金はかかりません。
- デフォルトのエフォートが異なります。デフォルト設定でのテストでは、Sonnetが
high、Opusがmediumで競合し、この組み合わせではOpusが勝つ傾向にあります。 - 高速モードはOpusのみで利用可能です(ドキュメント)。Anthropicは、Sonnet 5.5がSonnet 5よりも30%以上速く出力を生成すると述べています。
ベンチマーク:発表表では僅差、システムカードでは差が拡大
1から8行目はAnthropicの発表表からのもので、残りはシステムカードからのものです。CognitionはFrontierCodeを、CursorはCursorBenchを、ZapierはAutomationBenchを、Artificial Analysis (AA)はGDPval-AAとAA-Briefcaseを実行し、Anthropicがその他を実行しました。Sonnetは特記がない限り最大エフォートです。
| ベンチマーク | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% (xhigh) |
| FrontierCode 1.1 Main | 46.2% max, 52.1% xhigh | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 (Elo) | 1844 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1822 |
| HLE、ツールあり | 64.5% | 67.7% |
| OSWorld 2.1、部分的に | 80.1% | 81.8% |
| Chartography、ツールなし | 61.6% | 64.4% |
| SWE-Bench Pro | 81.3 | 89.9 |
| SWE-Bench Multimodal | 54.3 | 61.4 |
| HLE、ツールなし | 56.9 | 64.4 |
| OSWorld 2.1、厳密合格 | 43.5% | 48.7% |
| ProgramBench、ロングコンテキスト | 79.7% | 91.2% |
| Terminal-Bench-Science 0.1 | 59.9% | 58.7% |
| AutomationBench | 44.7 | 42.5 |
| HealthBench Professional | 69.2 | 65.6 |
発表表は良い面だけを示しており、Terminal-Benchを除けば、Sonnetのxhigh FrontierCodeスコアを含めて、Opusが1.7〜3.2ポイントリードしています。システムカードの5つの項目では、その差が5.2〜11.5ポイントに拡大しています:SWE-Bench Pro、SWE-Bench Multimodal、ツールなしのHLE、厳密なOSWorld、ロングコンテキストのProgramBench。長期的で補助なしのタスク全体では、Opusが優位を保っています。
Terminal-Bench 4.0の勝利は注意深く解釈する必要があります。システムカードのセクション8.5によると、Opusの試行の10%が安全対策のフォールバックに触れたのに対し、Sonnetでは1.5%でした。また、AA自身の実行ではSonnet 5.5が63.6%を記録しています。詳細はClaude Sonnet 5.5のベンチマークをご覧ください。
エフォートが対決を左右する
発表表は各モデルが最高のセッティングで比較されています。しかし、あなたの請求書はそうではありません。Anthropicの発表ページは、各エフォートレベルと試行またはタスクあたりのコストをグラフで示しています。
| ベンチマーク、モデル | 低 | 中 | 高 | X高 | 最大 |
|---|---|---|---|---|---|
| Terminal-Bench、Sonnet | 20.0% ($0.76) | 28.8% ($0.83) | 43.0% ($1.94) | 61.5% ($5.30) | 70.6% ($12.54) |
| Terminal-Bench、Opus | 38.5% ($1.29) | 57.6% ($2.94) | 64.2% ($3.88) | 66.4% ($7.35) | 64.8% ($11.24) |
| CursorBench、Sonnet | 35.8% ($0.50) | 39.2% ($0.70) | 47.8% ($1.67) | 53.1% ($3.88) | 55.5% ($9.67) |
| CursorBench、Opus | 43.7% ($1.17) | 52.5% ($2.91) | 56.0% ($3.97) | 56.0% ($6.98) | 57.8% ($13.43) |
| FrontierCode、Sonnet | 29.3% ($0.19) | 36.5% ($0.24) | 49.4% ($0.42) | 52.1% ($1.59) | 46.2% ($20.78) |
| FrontierCode、Opus | 47.3% ($0.40) | 54.6% ($0.80) | 54.0% ($1.09) | 51.4% ($2.25) | 54.4% ($6.19) |
| AA-Briefcase、Sonnet | 1264 ($0.87) | 1461 ($1.64) | 1634 ($3.95) | 1746 ($9.63) | 1811 ($29.19) |
| AA-Briefcase、Opus | 1285 ($1.15) | 1642 ($4.40) | 1705 ($6.27) | 1780 ($12.27) | 1822 ($21.05) |
示されていること:
- Opusのmediumは、Sonnetのhighをしばしば上回ります。 Terminal-Bench 4.0: Opusは試行あたり2.94ドルで57.6%、Sonnetは1.94ドルで43.0%です。
- Opusの最大以下は、Sonnetの最高スコアをより安価に上回ることができます。 CursorBench: Opusのhigh(56.0%、3.97ドル)対Sonnetのmax(55.5%、9.67ドル)。FrontierCode: Opusのmedium(54.6%、0.80ドル)対Sonnetの最高(52.1%、1.59ドル)。
- Sonnetのmaxは、Opusのmaxよりも高価になることがあります。 AA-Briefcaseでは、低いスコアで29.19ドル対21.05ドルです。FrontierCodeでは、Anthropicの脚注によると、レビューサブエージェントを分散させたため、Sonnetのmaxスコアはxhighスコアを下回りました。
- Sonnetはカーブの底部を支配します。 そのlow設定は、すべてのチャートでOpusの最も安い点を下回っています。
トークンあたりの価格が半分だからといって、タスクあたりのコストが半分になるわけではありません。Sonnetはエフォートが上がるにつれてより多くのトークンを消費します。OfficeChaiが報じたAAデータによると、Sonnet 5.5は最大エフォートでインデックス作成タスクあたり約193,000の出力トークンを消費し、Opus 5.5よりも約60%多いとされています。
これがHacker Newsのスレッドでの主な議論です。多くのコメント投稿者は、チャートを読んで、Opusの低いエフォートがSonnetのhighまたはxhighに匹敵するか、それを下回ると解釈しており、Sonnetのニッチはlowまたはmediumエフォート、そしてOpusのオーケストレーターの下のサブエージェントであると結論付けています。
Anthropicのプロンプトガイドによると、Sonnet 5.5のエフォートは再調整されています。high(明確に指定されたエージェントコードの場合はmedium)から開始し、xhighとmaxは測定可能な改善があった場合にのみ使用することを推奨しています。リクエスト間で最上位のエフォートを変更するとプロンプトキャッシュが無効になるため、ワークロードごとに設定してください(APIガイド)。
安全性と動作の違い
プロンプトインジェクションの結果は分かれています。Gray Swanの間接プロンプトインジェクションベンチマークでは、Sonnet 5.5の攻撃成功率は15回の試行で3.4%(Sonnet 5は6.7%)でした。Opus 5.5よりも耐性は低いですが、テストされた他のすべての非Claudeモデルよりも優れており、GUIコンピューター使用では最も弱い(12.5%)です。Shadeの適応型攻撃者に対しては、コード生成(安全対策なしで3.01%対54.61%、プローブありで2.63%対11.13%)でSonnetがOpusを上回り、コンピューター使用(0.07%)では同等でした。ブラウザ使用では、Anthropicが評価した中で最初の攻撃成功なしのモデルでした。Opus 5.5とプロンプトインジェクションを参照してください。
どちらのモデルもサイバー安全対策を備えており、Sonnet 5.5はSonnetシリーズで初めてこれらを搭載しました。危険度の高いサイバータスクとしてフラグが立てられた場合、Anthropicのアプリでは自動的に、APIではオプトインした場合にのみ(fallbacks: "default"、ベータ版)Sonnet 5にフォールバックします。システムカードは、無害なセキュリティ作業であっても拒否が増える可能性があると警告しています。
システムカードによると、Sonnet 5.5はOpus 5.5よりもプレッシャー下でより正直ですが、幻覚を起こしやすい傾向があることも示されています。
1つのシステムでのSonnet 5.5とOpus 5.5の組み合わせ
両方を利用する一つの方法は、Opusが計画を立て、Sonnetが実行するというものです。重要なメカニズムは3つあります。
思考ブロックは交差しない。Sonnet 5.5はOpus 5とOpus 5.5の思考ブロックをドロップします(課金されません。リクエストは200を返します)。ブロックはモデル、会話、アカウントに紐付けられています。会話の途中でモデルを切り替えると、推論は失われるため、テキストを介して状態を受け渡す必要があります。Opusが計画をメッセージとして書き込み、Sonnetがそれから開始します(移行ガイド)。
アドバイザーツールはOpus 5.5を受け入れます。Sonnet 5.5実行者のアドバイザーとして機能し、アドバイスはadvisor_redacted_resultとして暗号化されて返されます。
Claude Codeにはopusplanがあります。Opusが計画モードで、Sonnetが実行を担当します。sonnetエイリアスはAnthropic API(v2.1.284以降)でのみSonnet 5.5を意味するため、Bedrock、Google Cloud、Foundryではopusplanは古いSonnetで実行されます。Claude CodeにおけるClaude Sonnet 5.5を参照してください。
GPT-6 Solの立ち位置
GPT-6 Solは、Sonnet 5.5と同じ2ドル/10ドルの定価で、キャッシュからの読み取りは0.20ドル(90%オフ)、コンテキストウィンドウは872kです。Anthropicの表ではSolに4つのセルが与えられています:FrontierCode 49.3%、GDPval-AA 1487、AA-Briefcase 1483、そしてツールなしのChartography 53.6%。脚注には、OpenAIが最近、AAとSurge AIのスコアにまだ反映されていない可能性があるSolの画像理解バグを修正したとあります。
ベンチマークによってタスクあたりのコストは逆転します。AA-Briefcaseの最大エフォートでは、Solはタスクあたり2.67ドルでSonnetの29.19ドルに対して1483対1811のスコアです。FrontierCodeでは、SonnetのhighはSolの最高スコア(49.4%対49.3%)に匹敵し、コストは0.42ドル対2.07ドルです。GPT-6 Sol vs Claude Opus 5.5およびGPT-6 Solとはを参照してください。
どのワークロードにどのモデルを
| ワークロード | モデルとエフォート |
|---|---|
| 大量チャット、分類、抽出 | Sonnet 5.5、lowまたはmedium |
| スコープが明確なバグ修正、PRサイズの変更 | Sonnet 5.5、mediumまたはhigh |
| Opusプランを実行するサブエージェント | Sonnet 5.5、mediumまたはhigh |
| 長期的でオープンエンドなエージェント作業 | Opus 5.5、medium、次にhigh |
Sonnetのxhighまたはmaxが必要な場合 |
Opus 5.5、mediumまたはhigh |
| ロングコンテキストのコードベース推論 | Opus 5.5、medium以上 |
| 信頼できないコンテンツを読むエージェント | どちらでも可;独自のインジェクションケースをテスト |
自分のトラフィックで両方をテストする
上記のすべてのチャートは、あなた自身のプロンプト、ツール、トークンミックスではなく、他社のハーネスから得られたものです。データが示唆する組み合わせから始めましょう:
ask() {
  curl -s https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{"model":"'"$1"'","max_tokens":16000,
         "output_config":{"effort":"'"$2"'"},
         "messages":[{"role":"user","content":"Review this diff and list each bug as JSON: ..."}]}' \
  | jq '{model, stop_reason, usage}'
}
ask claude-sonnet-5-5 high
ask claude-opus-5-5 medium
Apidogでは、繰り返し可能に設定できます: https://api.anthropic.com/v1/messagesへの1つのリクエスト、環境変数としてのANTHROPIC_API_KEY、そしてボディ内の{{model}}と{{effort}}。ペアリングごとに複製し、各実行が同じことをチェックするようにポストプロセッサを追加します:
const body = pm.response.json();
pm.test("finished cleanly", () => {
  pm.expect(body.stop_reason).to.not.be.oneOf(["max_tokens", "refusal"]);
});
pm.test("stays inside the token budget", () => {
  pm.expect(body.usage.output_tokens).to.be.below(8000);
});
各ペアを10回から20回実行し、usage、応答時間、合格率を比較してください。トークン数に定価をかけたものが、タスクあたりの実際のコストです。詳細はLLMアプリケーションのテスト方法をご覧ください。
よくある質問
Claude Sonnet 5.5はOpus 5.5より優れていますか? ほとんどの項目ではそうではありません。Opus 5.5はTerminal-Bench 4.0とGDPval-AAでのほぼ同点を除き、発表表でリードしています。前世代の対決: Claude Opus 5 vs Sonnet 5。
Sonnet 5.5はOpus 5.5の半額ですか? トークンあたりでははい。タスクあたりではエフォートによります。maxエフォートでは、SonnetはAA-Briefcaseでより高価でした(29.19ドル対21.05ドル)。
会話の途中でモデルを切り替えられますか? はい、ただしSonnet 5.5はOpus 5.5の思考ブロックをドロップするため、状態はテキストとして渡す必要があります。
Sonnet 5.5かGPT-6 Sol、どちらが2ドル/10ドルですか? Sonnetは、共有されている4つの項目すべてで最高のセッティングでリードしていますが、Solはタスクあたりのはるかに安価になる可能性があります。両方をテストしてください。
次のステップ
ルーティングルールを変更する前に、最も高価なプロンプトの2つをSonnet 5.5のhighとOpus 5.5のmediumで実行し、合格率とタスクあたりのコストを比較してください。リクエスト、アサーション、結果を1つのプロジェクトにまとめるには、Apidogをダウンロードしてください。
ボタン