
Claude Fable 5.2 vs Opus 5.5については、日常のコーディングやナレッジワークにはまずOpus 5.5を使いましょう。難しい推論、曖昧なマイグレーション、長期のエージェントプロジェクトなど、Opusの実力を超える場面でFable 5.2を試してください。ワークロード全体を切り替える前に、effort設定と採用された成果あたりのコストを比較しましょう。
この推奨は、2026年11月10日時点で確認したAnthropicのFable 5.2発表に基づいています。本記事は情報源に基づく比較であり、独立した対面ベンチマークを実施したものではありません。旧世代については、以前のOpus 5 vs Fable 5比較記事を参照してください。以下の料金、デフォルト設定、根拠はこれらの新しいバージョンに適用されるものです。
Claude Fable 5.2 vs Opus 5.5 の概要
| 判断ポイント | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| 基本的な役割 | 高難度の推論と長時間のエージェント作業 | ほとんどのワークロードのデフォルト |
| Claude APIのモデルID | claude-fable-5-2 |
claude-opus-5-5 |
| 標準入力、100万トークンあたり | $8 | $4 |
| 標準出力、100万トークンあたり | $40 | $20 |
| APIのデフォルトeffort | High | Medium |
| コンテキストウィンドウ | 100万トークン | 100万トークン |
| 最大出力 | 128Kトークン | 128Kトークン |
| 比較レイテンシのラベル | 中程度(Moderate) | 中程度(Moderate) |
出典:最新のClaudeモデル概要。両モデルともテキストと画像を入力として受け付け、テキストを出力し、ツールをサポートし、常時有効なアダプティブ思考を採用しています。したがって、コンテキストウィンドウの大きさは差別化ポイントにはなりません。区別になるのは、あなたの特定のタスクを完遂できるかどうかです。
Fableの標準トークン料金はOpusの2倍です。そのため、両モデルが同程度のトークン量であなたの合格基準を満たすのであれば、Opusを出発点にするのが合理的です。ただし、推論の深さ、再試行、ツール呼び出しが異なる場合にどちらの請求額が低くなるかは、これでは判断できません。
どのようなコーディングタスクならFable 5.2への切り替えが正当化されるか?
明確な検証がある範囲の限られた変更にはOpusを使いましょう。エージェントが問題そのものを発見する必要がある場合、複数の依存する変更を調整する必要がある場合、失敗したアプローチから回復する必要がある場合にFableを試してください。これらはAnthropicのポジショニングと結果から推測したワークロードに関する推奨であり、あなたのリポジトリでの実測に基づく保証ではありません。
| タスク | 最初の選択 | 切り替えを正当化する根拠 |
|---|---|---|
| ドキュメントに沿ったエンドポイントの追加 | Opus 5.5 | コントラクトや統合のエラーが繰り返し発生する |
| 小規模なリファクタリング後のテスト更新 | Opus 5.5 | エージェントが変更された不変条件を特定できない |
| 断続的に発生するサービス間障害のデバッグ | Opus、その後Fable | Opusが競合する原因を検証せずに修正を繰り返す |
| 依存関係が不明確なサービスのマイグレーション | 両方を比較 | Fableが予算内でより多くの変更を完了させられる |
| 長期の技術プロジェクトの調整 | Fableをトライアル | より優れた計画が実行とレビューを通して維持される |
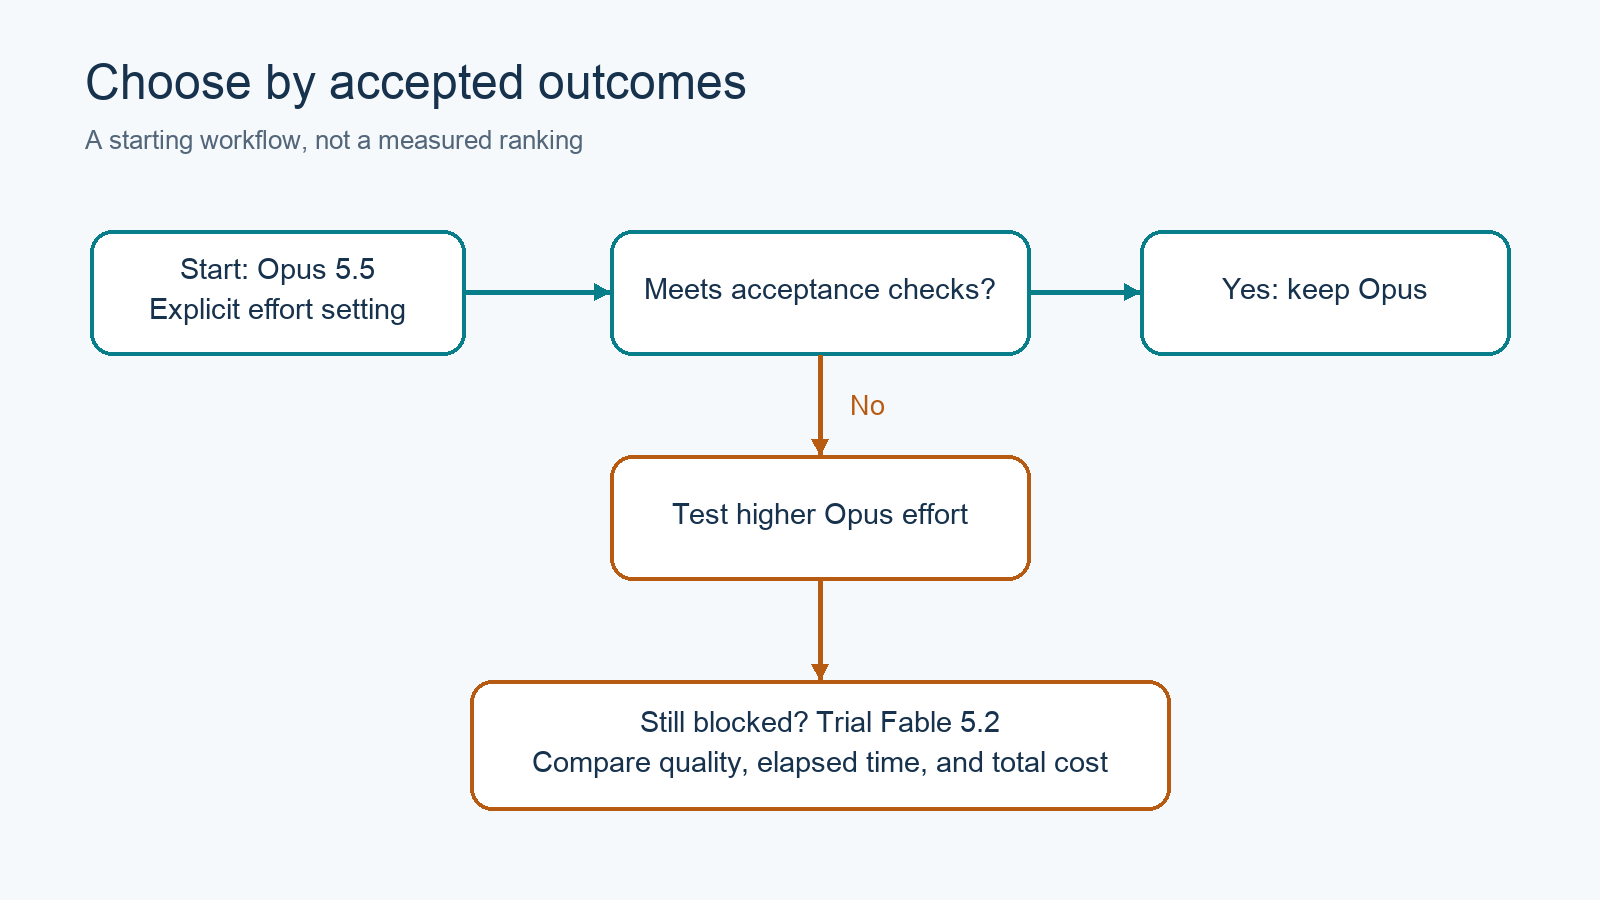
選択的なエスカレーション:ルーティンなタスクはベースラインのままにし、難しい作業はあなたの検証に合格したモデルに送りましょう。
決済用のWebhookが断続的にイベントを2回処理してしまうケースを考えてみましょう。必要な修正がすでに特定されているなら、Opusにとって範囲の限られたコーディングタスクです。一方、エージェントがリトライ、ストレージ、下流サービスにまたがる並行処理を再構築する必要があるなら、その調査はFableのトライアルにふさわしい候補です。
どちらのモデルにも、同じインシデントの証拠と制約を与えましょう。高額なモデルでも、欠けているログやアクセスできない依存関係、誤った動作を合格とみなす受け入れテストを補うことはできません。
Anthropicのベンチマークが示すもの
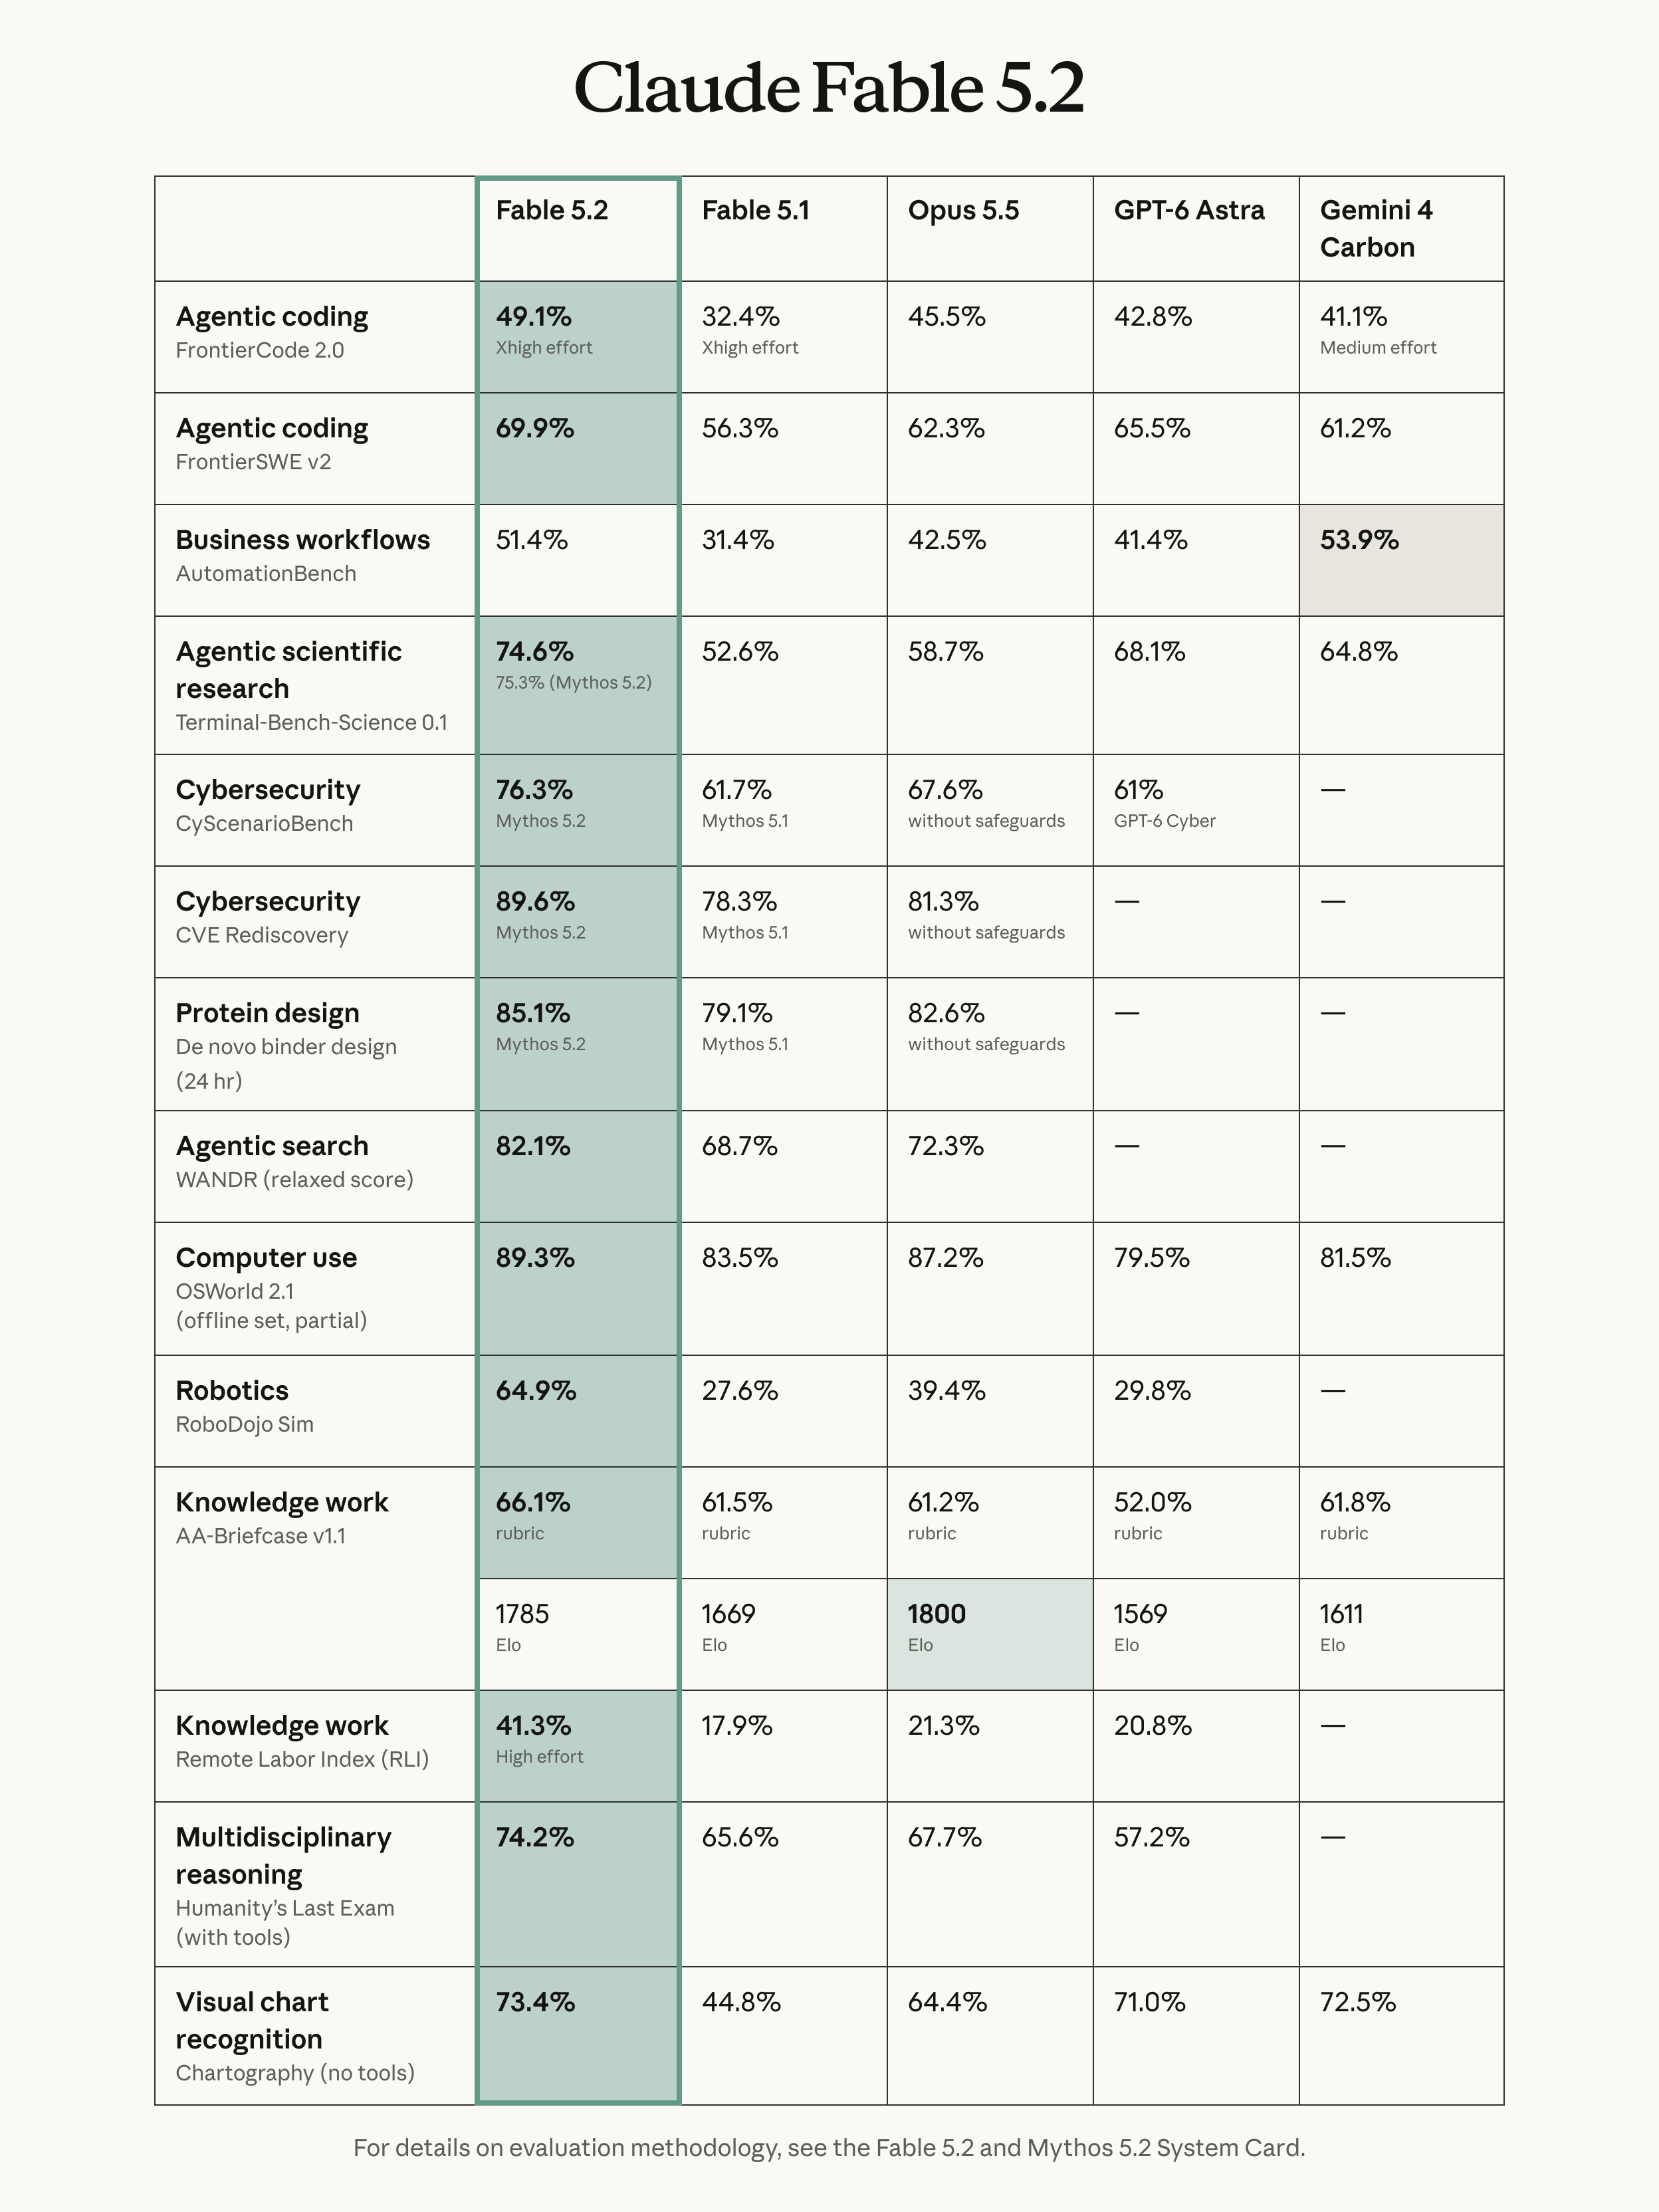
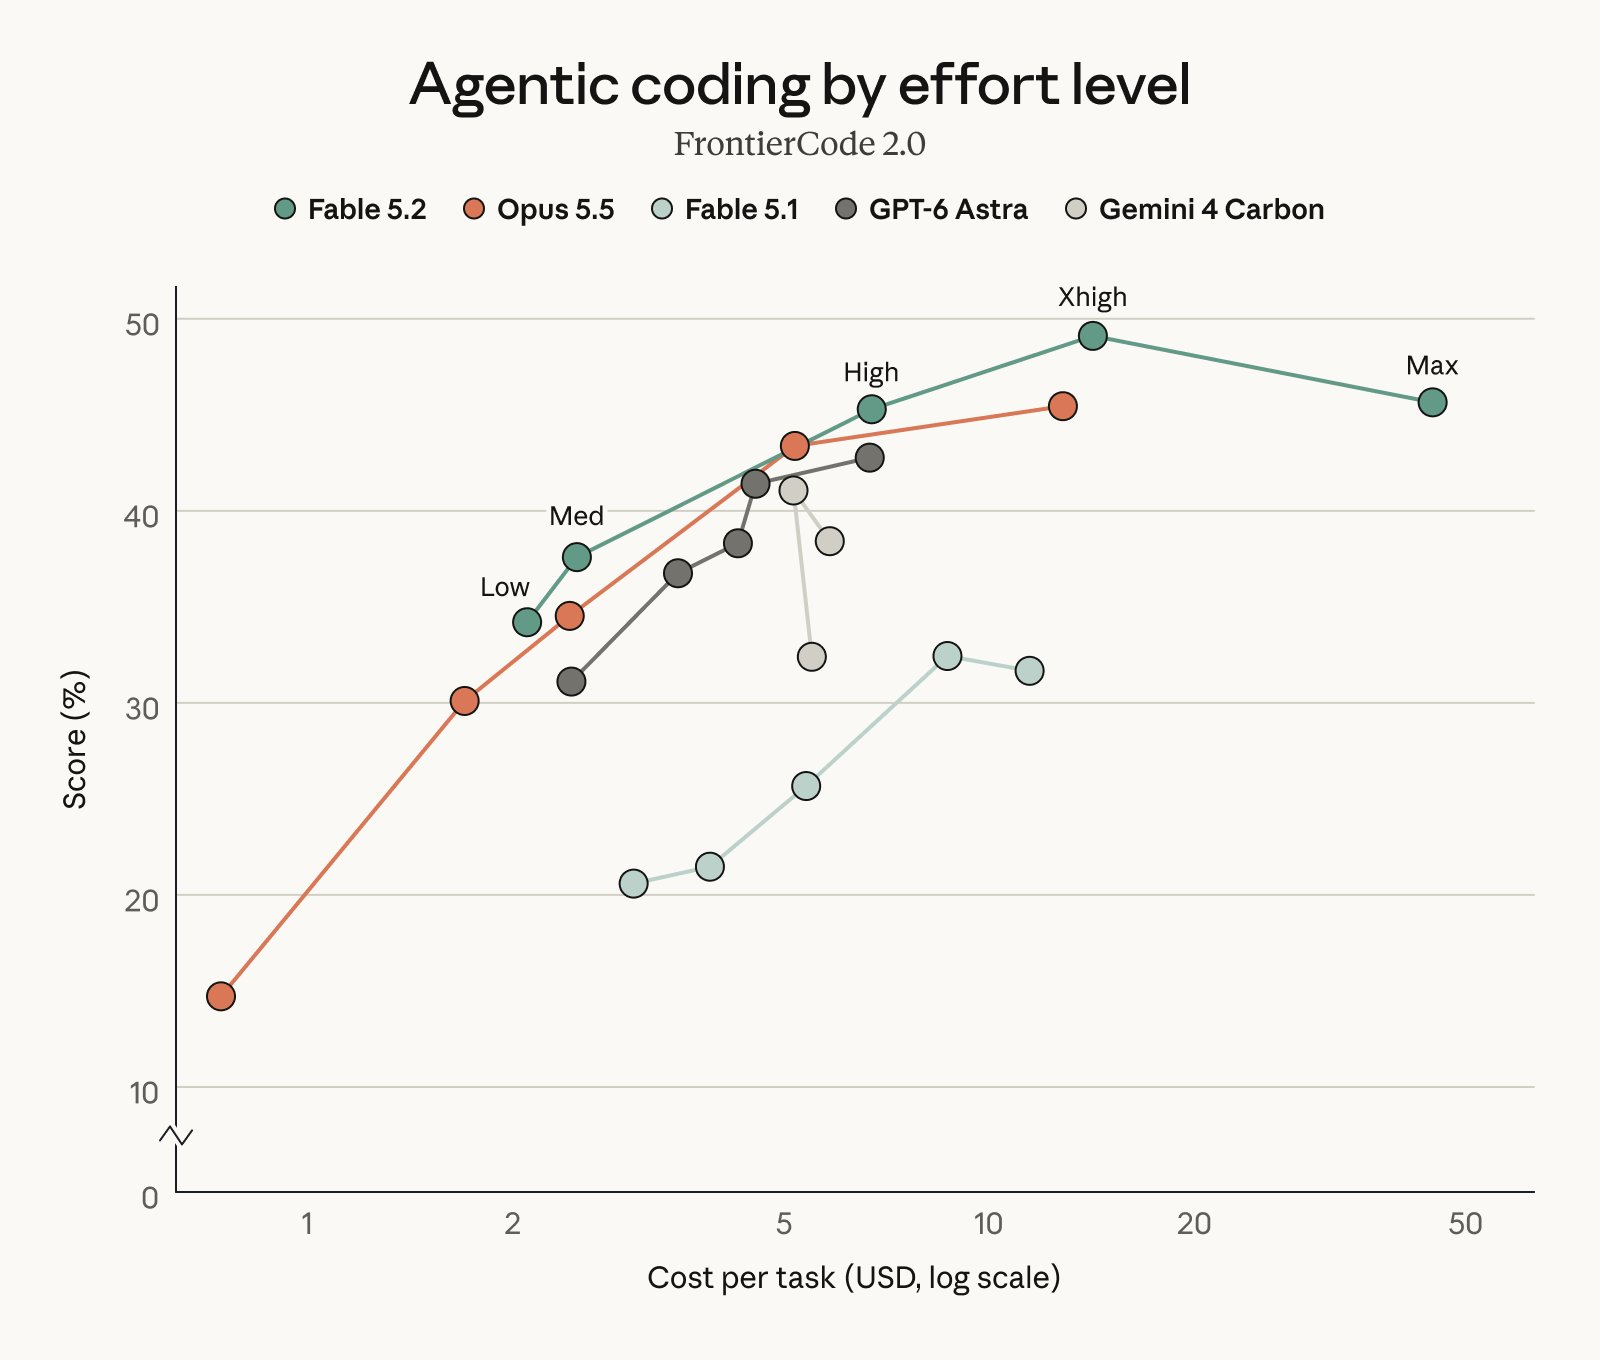
Anthropicは、複数のコーディングおよび推論評価においてFable 5.2がより高いスコアを記録したと報告しています。実用上最も重要なシグナルはeffortとコストの結果です。Anthropicの初期テストでは、High設定のFableがFrontierCode 2.0においてMax設定のOpusにほぼ匹敵し、タスクあたりのコストは約半分でした。
| ベンダー報告の評価 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0、エージェント型コーディング | Xhighで49.1% | 45.5% |
| FrontierSWE v2、エージェント型コーディング | 69.9% | 62.3% |
| WANDR、エージェント型検索、緩和スコア | 82.1% | 72.3% |
| OSWorld 2.1、オフライン部分セット | 89.3% | 87.2% |
これらの数値は発表資料によるもので、特に明記されていない限りスコアは利用可能な最高のeffort設定で取得されたと記載されています。これらはAnthropicの評価条件を示すものであり、デフォルト設定やあなたのチケットにおける予想合格率ではありません。
コスト比較はさらに狭い範囲のものです。High設定のFableのスコアは45.3%で、Opusの最高スコアは45.5%です。この評価においては、より安価な構成を試す根拠にはなりますが、すべてのFableワークフローがOpusの半分のコストになるという意味ではありません。
ベンチマークのパーセンテージを生産性の予測に変換することは避けましょう。コーディングスコアは、レビュー待ちの量、デプロイのリスク、誤ったマイグレーションの修復に費やす時間を測るものではありません。また、Mythos限定のサイバーセキュリティおよび生物学の結果は、Fableのスコアカードから除外すべきです。発表によれば、基盤モデルは共通ですが、セーフガードとアクセスは異なります。
effort設定が比較を変える
モデルを比較する際は、effortを明示的に設定しましょう。APIのデフォルトは、Fable 5.2がHigh、Opus 5.5がMediumです。Anthropicの発表では、ClaudeアプリとClaude CodeにおけるデフォルトがMediumであることも別途説明されています。どの製品のどの設定かを記録し、一つのデフォルトがどこでも適用されると想定しないようにしましょう。
effortのドキュメントでは、両モデルに対してlow、medium、high、xhigh、maxが定義されています。effortは応答テキスト、ツールの引数、思考に影響を与えます。これは動作のシグナルであり、支出の上限ではありません。
まず現時点で機能しているOpusの構成から始めましょう。それで不十分な場合は、より高いOpusのeffortと、MediumまたはHigh設定のFableを比較してください。XhighとMaxのトライアルは、追加の推論に現実的な利益が見込め、その支出に耐えられるタスクに留保しましょう。
同一effortの比較が答えるのは一つの問いです。同じ名前の設定下でこれらのモデルがどう振る舞うか。コストを一致させた比較が答えるのは別の問いです。あなたの予算で最も強い許容可能な結果を出すのはどの構成か。どちらももう一方の代わりにはなりません。
レイテンシ:タスク全体を測る
両モデルともAnthropicの概要では比較レイテンシが「中程度(Moderate)」のラベルです。このラベルから普遍的な勝者は分かりません。出力速度を開発ワークフロー全体の速度と見なすのではなく、ツールや再試行を含め、レビュー済みの結果に至るまでの時間を測りましょう。
Anthropicによれば、Fable 5.2はFable 5.1より最大30%速く出力を生成します。この比較は前世代とのものであり、Opus 5.5との比較ではありません。オプションの高速モードは最大2.5倍のトークン生成速度を提供しますが、これもベンダーの主張であり、あなたのタスク時間の実測による短縮ではありません。
コンパイルや遅いデータベースが支配的なタスクは、トークン生成が速くなってもそれに比例して速くなりません。逆に、失敗するアプローチを2つ回避できるエージェントは、トークン生成が遅くても早く完了できます。速度のプレミアムを支払う前に、これらを別々に追跡しましょう。
採用された成果あたりのコストを比較する
意思決定の指標としては、ワークフロー全体の支出を採用された成果で割った値を使いましょう。トークン価格は単価を決めますが、何を買っているかはトークン量、キャッシュ、失敗した試行、ツール、レビューで決まります。以下の計算は例示であり、どちらのモデルの動作の実測でもありません。
1回のリクエストがキャッシュされていない入力トークン10万個と出力トークン1万個を消費し、標準のグローバルルーティングで追加のツール課金がないと仮定します:
| 構成 | 入力コスト | 出力コスト | 合計 |
|---|---|---|---|
| Opus 5.5 標準 | $0.40 | $0.20 | $0.60 |
| Fable 5.2 標準 | $0.80 | $0.40 | $1.20 |
| Opus 5.5 高速 | $0.80 | $0.40 | $1.20 |
| Fable 5.2 高速 | $1.60 | $0.80 | $2.40 |
料金は2026年11月10日時点でAnthropicの価格ドキュメントと突き合わせて確認しました。サブスクリプションの利用枠はこれらのAPI料金とは別物です。クラウドプロバイダー、キャッシュ、データレジデンシーのオプション、その他の機能により請求額は変わります。
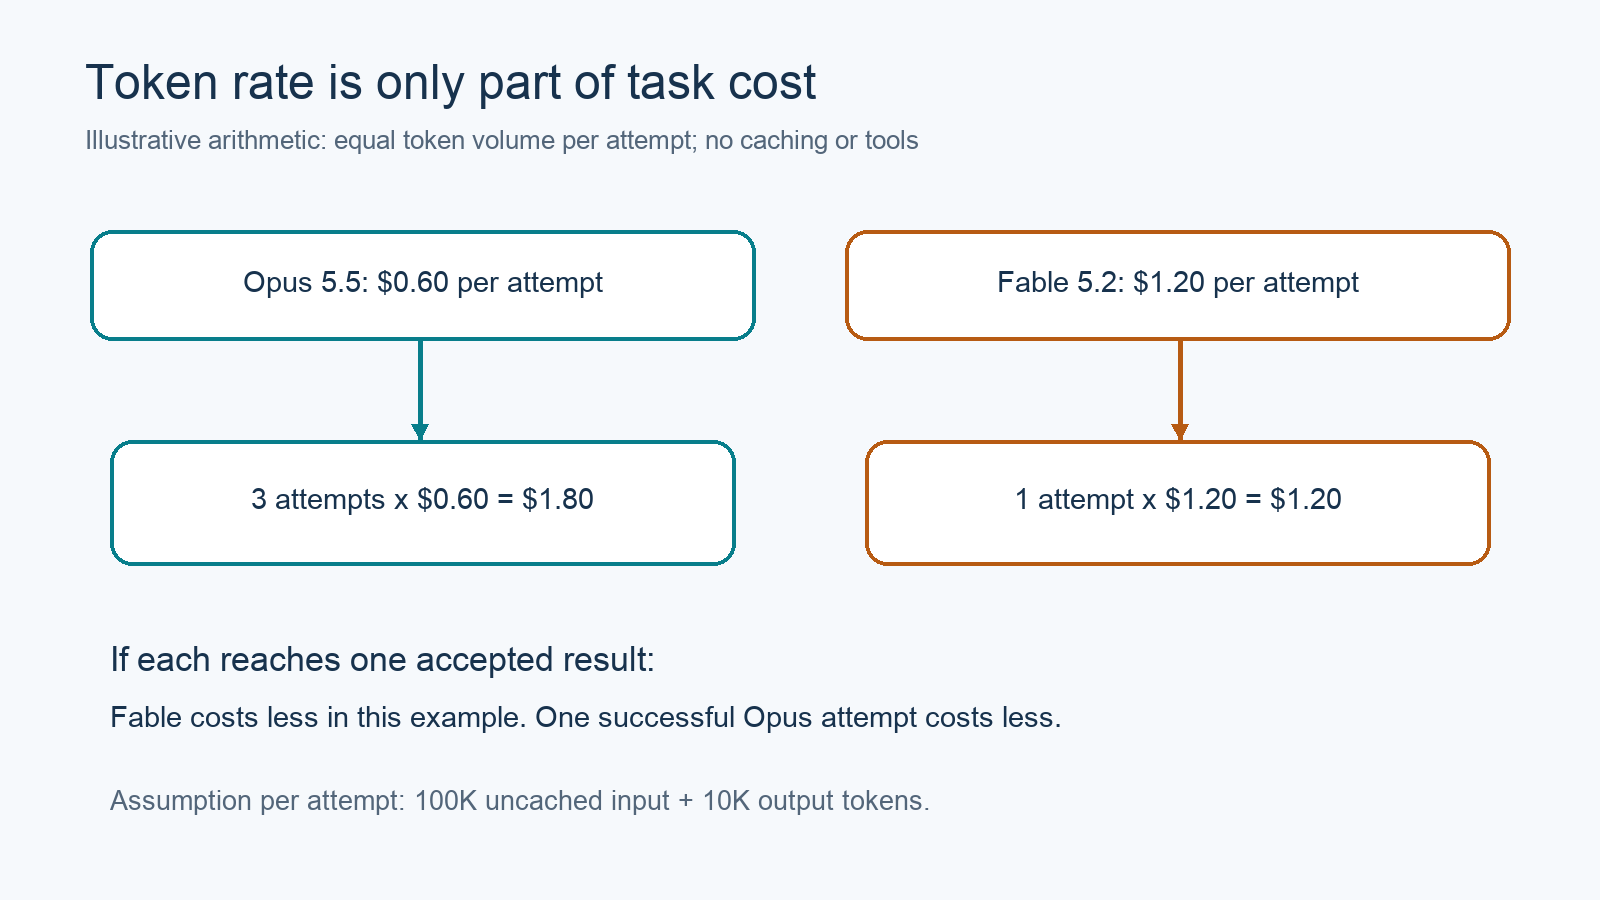
成功した結果に必要なすべての試行を、再試行とレビューを含めて比較しましょう。
この単純化した例では、同一トークン量のOpusの試行3回で$1.80、Fableの試行1回で$1.20です。Fableがその1回で合格結果に到達できる場合にのみ、Fableの方が安くなります。成功したOpusの試行1回の方が安いままです。実際の再試行では消費トークン量が異なることが多いため、推測した平均を掛けるのではなく、記録された使用量を使いましょう。
API支出の横にエンジニアリングレビューの時間も置きましょう。テストには合格しても大幅な修正を要するパッチは、レビュー準備完了のパッチと同じ合格ラインを通過していません。
Apidog CLIでコーディングエージェントにAPIを検証させる
Apidog CLIを使えば、コーディングエージェントに再現可能なAPIチェックを作成・実行させられます。これらのチェックは、モデルを切り替えた際のリクエストやレスポンスのリグレッションを明らかにできます。ただし、エージェントによるリポジトリ変更が正しいかどうかは判定できないため、リポジトリのテストと人間によるレビューも併用してください。
CLIをセットアップし、エージェントに公式のインストールガイドを読ませましょう:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Claude Codeやお好みのエージェントに、次のプロンプトを与えます:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
エージェントはスキーマを確認し、有効なテストケースカテゴリを選び、case.jsonを作成してから、次のようなコマンドを実行します。フラグはインストール済みのCLI 2.2.12のヘルプと突き合わせて確認しました:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
プレースホルダーは自分のプロジェクトのリソースに置き換えてください。これは実行済みのモデル比較ではなく、ワークフローのテンプレートです。エージェントのセットアップについては、Claude CodeでのApidog CLIガイドまたはCodex統合ガイドを参照してください。
FAQ
すべてのコーディングにおいてFable 5.2はOpus 5.5より優れていますか?
いいえ。AnthropicはほとんどのコーディングおよびナレッジタスクにOpus 5.5を推奨しています。Fableを試す価値があるのは、難しい作業がそのベースラインを超える場合です。高いベンダーベンチマークスコアは、すべてのタスクでより良い結果を保証するものではありません。
Fable 5.2は2倍のコストがかかりますか?
標準の入力・出力トークン料金はOpus 5.5の2倍です。ただし、構成によってトークン消費量と必要な試行回数が異なるため、タスク全体のコストは変わります。
常に最大のeffortを使うべきですか?
いいえ。設定はあなたの合格基準と予算と比較して判断しましょう。高いeffortはトークン支出の増加を許容しますが、範囲の限られたタスクで有益な改善を保証するものではありません。
Fable 5.2はOpus 5.5より高速ですか?
本記事で確認した情報源からは、普遍的な対面レイテンシの勝者は確定できません。両モデルともレイテンシは「中程度(Moderate)」のラベルです。実際のワークフローを測定し、高速モードは別の構成として扱いましょう。
Apidogはどちらのモデルがより良いコードを書くかを判定できますか?
Apidog CLIは、エージェントがAPIチェックを実行しレスポンスの証拠を収集する助けになります。コード品質の判定には依然としてリポジトリのテストとレビューが必要です。それらの採用された成果をもとに、どのモデルとeffort設定がコストに見合うかを判断しましょう。