Claude Fable 5.1は、100万トークンあたり入力10ドル、出力50ドルです。Claude Opus 5は、入力5ドル、出力25ドルです。Anthropicの公式ドキュメントによると、「Claude Opus 5でより高いエフォート設定での評価でもまだ不十分な場合」にのみ、Opus 5からFable 5.1に移行するよう指示されています。これは検証可能なルールであり、この比較はそのルールに基づいて構築されています。Anthropicの数値がFable 5.1がOpus 5を明確に上回っている点、プロンプトの調整で差を縮められる可能性のある数ポイントの差、そしてFable 5.1のキャッシュ読み取りがOpus 5の半分であるため料金計算が興味深くなる点について説明します。
情報源はAnthropicのリリース投稿、Fable 5.1モデルページ、および料金ページです。各モデルの概要については、Claude Fable 5.1とはとClaude Opus 5とはをご覧ください。
比較表
| 項目 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| モデルID | claude-fable-5-1 |
claude-opus-5 |
| リリース日 | 2026年9月1日 | 2026年7月24日 |
| 位置づけ | 高度な推論と長期的なエージェント作業 | 複雑なエージェントコーディングおよびエンタープライズ向け作業。推奨されるデフォルト |
| 入力 / 出力 | 10ドル / 50ドル | 5ドル / 25ドル |
| キャッシュ読み取り | 0.25ドル | 0.50ドル |
| キャッシュ書き込み (5分 / 1時間) | 12.50ドル / 20ドル | 6.25ドル / 10ドル |
| バッチ | 5ドル / 25ドル | 2.50ドル / 12.50ドル |
| 高速モード | なし | あり (10ドル / 50ドル) |
| 優先ティア | なし | なし |
| コンテキスト / 最大出力 | 1M / 128K | 1M / 128K (ベータ版のバッチ処理で300K) |
| 知識のカットオフ | 2026年6月 | 2026年5月 |
| 比較レイテンシー | 遅い | 中程度 |
| 思考 | 常にオン; disabledは400を返す |
デフォルトでオン; disabledはhigh以下のエフォートで許可される |
強制tool_choice |
400 | 受け入れ |
| 安全性分類器 | サイバー、バイオ、フロンティアLLM、推論抽出、一般的な危害 | サイバーのみ |
| ゼロデータ保持 | 承認されない限り利用不可 | 利用可能 |
| メッセージごとのエフォート (ベータ版) | はい | はい |
| 履歴編集チェック | はい | いいえ |
ベンチマークが示すもの
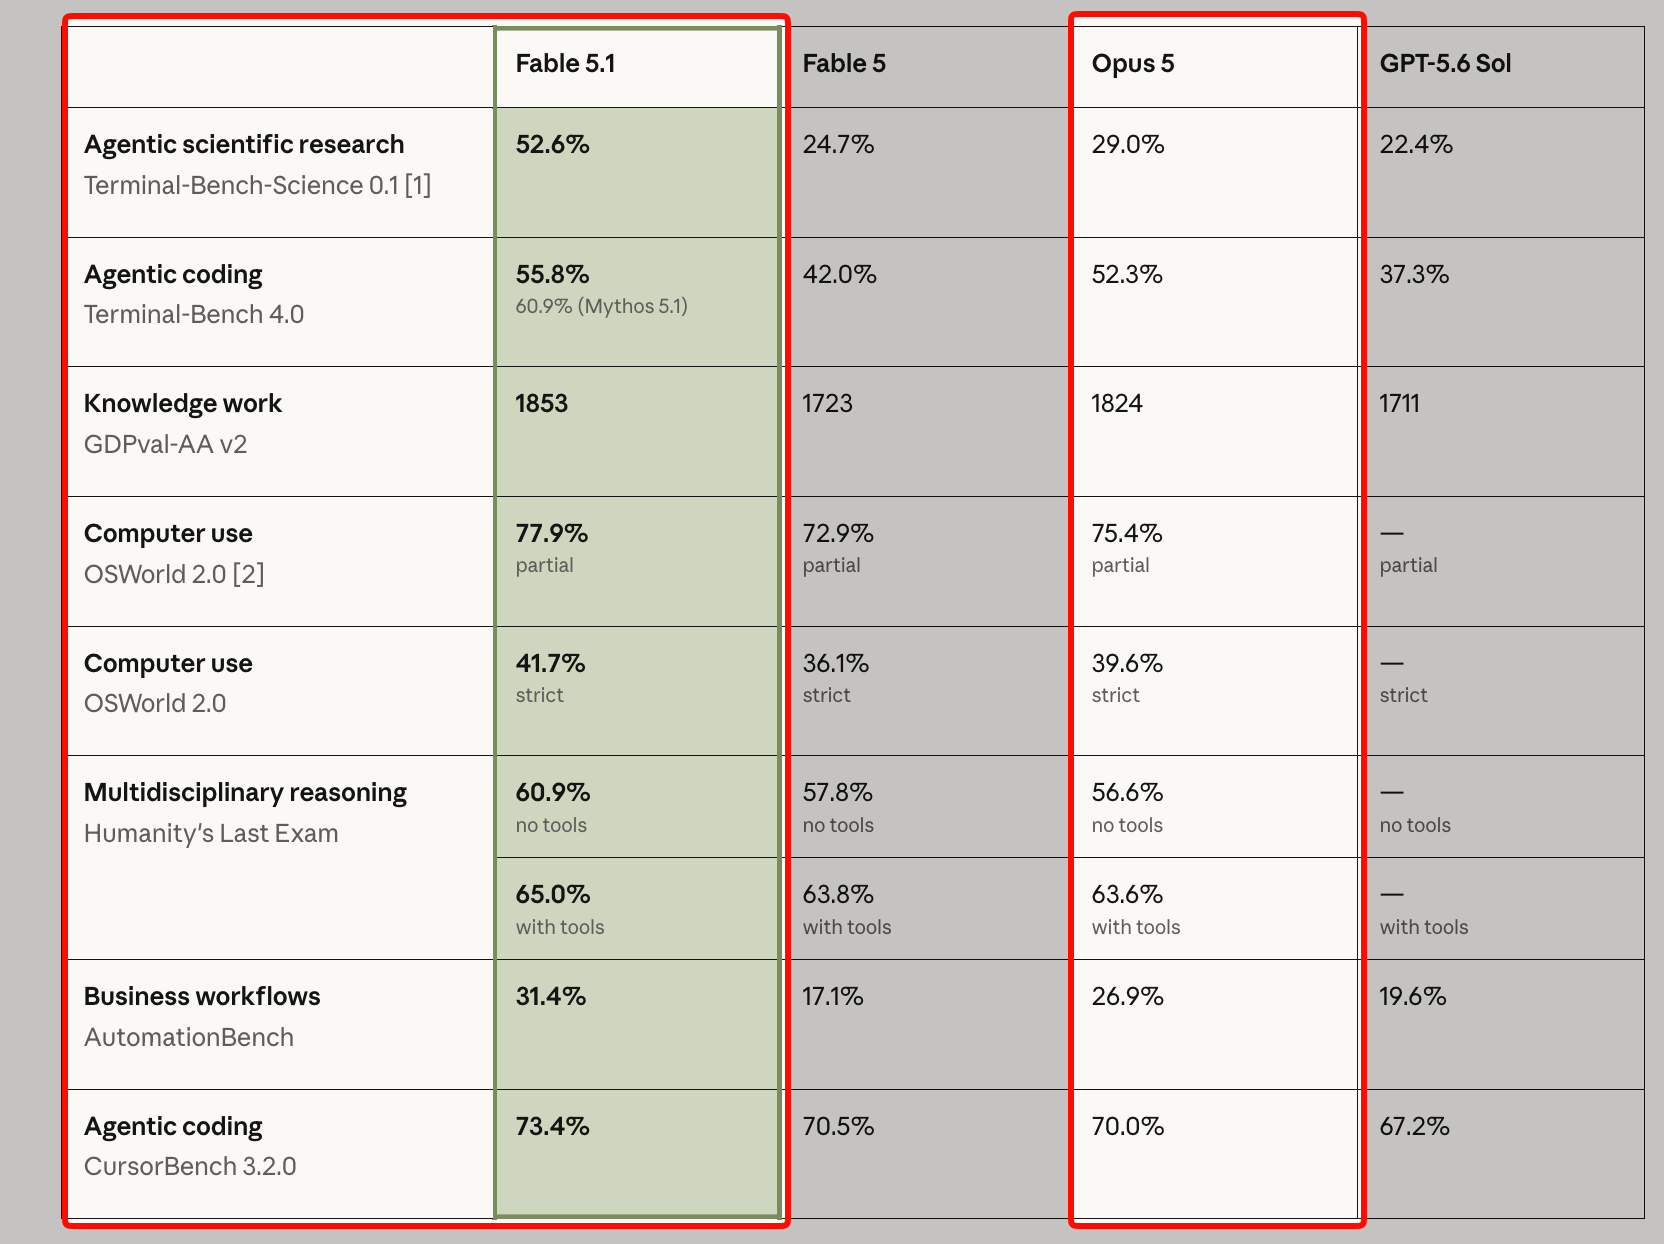
すべての数値はAnthropicによるものであり、まだ独立した再現は行われていません。
| ベンチマーク | Fable 5.1 | Opus 5 | 差 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | +23.6 |
| AutomationBench | 31.4% | 26.9% | +4.5 |
| Humanity’s Last Exam (ツールなし) | 60.9% | 56.6% | +4.3 |
| Terminal-Bench 4.0 | 55.8% | 52.3% | +3.5 |
| CursorBench 3.2.0 | 73.4% | 70.0% | +3.4 |
| OSWorld 2.0 (部分) | 77.9% | 75.4% | +2.5 |
| OSWorld 2.0 (厳密) | 41.7% | 39.6% | +2.1 |
| Humanity’s Last Exam (ツールあり) | 65.0% | 63.6% | +1.4 |
| GDPval-AA v2 | 1853 | 1824 | +29 Elo |
この表は2つの物語として読み取れます。Terminal-Bench-Scienceでは、Fable 5.1はOpus 5のほぼ2倍の性能を示しています。これは、モデルが長時間ターミナルで実験を実行する、長期的なツールを多用する研究ベンチマークです。その他のすべてにおいて、差は1〜5ポイントです。AutomationBenchでの5ポイントの差は重要です。ツールを使用したHumanity’s Last Examでの1.4ポイントの差や、GDPvalでの29 Eloの差は、モデル選択よりもプロンプトやエフォート設定が結果に大きく影響する範囲内です。
もう1つ注目すべきデータポイントは、Opus 5が7月にTerminal-Bench 4.0で52.3%を記録し、Fable 5の42.0%を上回ってリリースされたことです。Fable 5.1は55.8%でリードを奪還しましたが、その差は13.8ポイントではなく3.5ポイントでした。エージェントコーディングにおけるFableティアのOpusティアに対する優位性は本物ですが、6月時点よりも狭まっています。Opus 5とFable 5の比較は、その競争の以前の状態を捉えています。
料金計算は単純な2倍ではない
キャッシュされていない場合、Fable 5.1はあらゆる点でOpus 5のちょうど2倍です。しかし、キャッシュ読み取りは逆転します。Fable 5.1では0.25ドルに対し、Opus 5では0.50ドルです。したがって、実質的な乗数は、入力のどのくらいがキャッシュされたプレフィックスであるかによって異なります。
キャッシュされた150,000トークン、キャッシュされていない入力1,000トークン、出力800トークンを含むエージェントのターンを考えてみましょう。Opus 5の場合: 5(0.001) + 0.5(0.15) + 25(0.0008) = 0.005ドル + 0.075ドル + 0.02ドル = 0.10ドルです。Fable 5.1の場合: 10(0.001) + 0.25(0.15) + 50(0.0008) = 0.01ドル + 0.0375ドル + 0.04ドル = 0.0875ドルです。このターンでは、Fable 5.1の方が安くなります。
次に、キャッシュされていない入力30,000トークンと出力4,000トークンでのコードレビューを考えてみましょう。Opus 5の場合: 0.15ドル + 0.10ドル = 0.25ドルです。Fable 5.1の場合: 0.30ドル + 0.20ドル = 0.50ドルです。ちょうど2倍になります。
クロスオーバーポイント:キャッシュされた入力トークンが、キャッシュされていない入力トークンと出力トークンの5倍の合計の約20倍を超えると、Fable 5.1の1ターンあたりのコストはOpus 5を下回ります。プレフィックスを多用するエージェントループでは、この条件が一般的です。出力を多用するものでは、決してそうはなりません。キャッシュ書き込みもFable 5.1では2倍になるため、頻繁にキャッシュをリセットするセッションではその利点が失われます。Fable 5.1の料金内訳とOpus 5の料金内訳に全表が記載されています。
Opus 5が明確に優位な点
思考をオフにして実行できるものすべて。 Opus 5はthinking: {"type": "disabled"}をhigh以下のエフォートで受け入れます。Fable 5.1は決して受け入れません。分類、抽出、短文回答のルートでは、思考をオフにした(またはlowエフォートの)Opus 5は、より安価で高速です。
高速モード。 Opus 5には、出力速度を最大2.5倍にし、10ドルと50ドルで利用できる研究プレビューの高速モードがあります。Fable 5.1には同等のものはありません。応答時間がベンチマークのわずかな差よりも重要である場合、これは決定的な要素となります。
一般的なレイテンシー。 AnthropicはFable 5.1を「遅い」、Opus 5を「中程度」とリストしています。Fable 5.1の高いエフォートでの困難なタスクの1回のターンは、数分かかることがあります。
ゼロデータ保持。 Opus 5はZDR(ゼロデータ保持)で利用可能です。Fable 5.1はカバードモデルであり、AnthropicがZDRアクセスを明示的に承認しない限り400を返します。
拒否の少なさ。 Opus 5はサイバーセキュリティに特化した分類器のみを実行します。Fable 5.1は、サイバー、バイオ、フロンティアLLM開発、推論抽出、一般的な危害を含む完全なFableセットを実行します。Opus 5では問題なく動作する良性のライフサイエンスやMLワークロードでもFable 5.1では問題が発生する可能性があり、その場合でもフォールバックターゲットはOpus 5になります。
ツールの強制使用。 Opus 5はtool_choiceのanyとtoolを依然として受け入れます。Fable 5.1は400を返します。強制的な呼び出しに依存する統合を行っている場合、Opus 5は書き換えの手間を省きます。
履歴編集チェックなし。 Opus 5は以前のターンを編集しても気にしません。Fable 5.1は、その操作を行うと後続の思考ブロックを無効にします。クライアント側で圧縮したり、ターンごとのリマインダーを挿入したりするハーネスは、現在Opus 5で動作しますが、Fable 5.1を導入する前に監査が必要です。
Fable 5.1が明確に優位な点
長期的な研究とターミナルエージェント。 Terminal-Bench-Scienceでの52.6%対29.0%という結果は、Anthropicの表で最大の差です。エージェントが実験を実行したり、複数ステップのウェブ調査を追求したり、何時間も動作したりする場合、これはこのモデルが構築されたワークロードです。
ビジネスワークフローの自動化。 AutomationBenchでの31.4%対26.9%という差は、アプリケーションを横断するエンドツーエンドのタスクをモデル化したベンチマークにおいて、実際のギャップを示しています。
キャッシュプレフィックスを多用するエージェント。 上記で説明したように、0.25ドルのキャッシュ読み取りにより、Fable 5.1はプレフィックスが支配的なループで1ターンあたり安価になります。
知識のカットオフ。 2026年6月対2026年5月。1か月の差ですが、これはClaudeモデルの中で最も新しいものです。
密集したドキュメントのビジョン。 Anthropicは、PDFに埋め込まれたグラフ、提出書類、表の読み取りの改善、特にクロップ&ズームツールとの組み合わせを、Fable 5.1の利点として挙げています。Opus 5は公開されたビジョンベンチマークで比較されていないため、これはテストすべき主張として扱ってください。
xhighのエフォートでOpus 5が失敗する場合。 これがAnthropicのルールであり、正しいものです。タスクがxhighのエフォートでOpus 5での評価に失敗した場合、他に何かを試す前にhighのエフォートでFable 5.1を試してみてください。
エフォートが比較を変える
両方のモデルは5つのエフォートレベルを提供しており、AnthropicはFable 5.1の低エフォートについて具体的な主張をしています。「lowエフォートでは、Claude OpusおよびClaude Sonnetモデルとタスクあたりのコストで競合することが多く、より高いスコアを達成する」と述べています。これは選択肢を再構築します。highエフォートのOpus 5とhighエフォートのFable 5.1の比較ではなく、ルーティン作業の公正な比較は、highエフォートのOpus 5とlowまたはmediumエフォートのFable 5.1かもしれません。低エフォートでの出力トークン数は少ないため、2倍のトークンあたりの価格を相殺します。
逆もまた真です。Fable 5に対するFable 5.1の利点は、xhighとmaxで最大になります。これは、Opus 5を超える機能の天井が、最も時間がかかるエフォートレベルで最も高いことを意味します。リリース表から何かを結論付ける前に、独自の評価で両モデルのエフォート全体を調べてください。Opus 5のエフォートガイドでは5つのレベルについて説明されており、Fable 5.1でも意味は同じです。
意思決定フレームワーク
highのエフォートでOpus 5から開始する。 Anthropicのデフォルト推奨であり、半分の価格、少ない分類器、ZDRが利用可能です。- 失敗するタスクではOpus 5を
xhighに上げる。 モデルを切り替えるよりも安価です。 - それでも失敗するタスクは
highのエフォートでFable 5.1に移行する。 グローバルではなくルートごとに行います。成功するものはすべてOpus 5で続行します。 - 移行したもののキャッシュプロファイルを確認する。 プレフィックスを多用するループであれば、Fable 5.1の方がOpus 5よりも1ターンあたりのコストが安くなる可能性があります。
- ステップ3の前にハーネスを監査する。 強制
tool_choiceと履歴編集はFable 5.1では両方とも動作しません。移行ガイドにチェックリストがあります。
Apidogでの比較実行
本番プロンプトとmodelを環境変数として使用して、1つのコレクションを作成します。それをhighエフォートのclaude-opus-5で実行し、次にxhighで実行し、その後highとlowエフォートのclaude-fable-5-1で実行します。各実行について、回答、usage.output_tokens、およびusage.cache_read_input_tokensを繰り返し送信して記録します。各モデルのレートを応答後スクリプトで乗算すると、モデルごと、エフォートごとのタスクあたりのコストが1つの表にまとまります。Apidogはすべての実行を履歴として保持するため、次のモデルリリース後も比較が可能です。設定するにはApidogをダウンロードしてください。
よくある質問
Claude Fable 5.1はOpus 5よりも優れていますか? Anthropicが公開したすべてのベンチマークにおいて、1.4ポイントから23.6ポイントの差で優れています。大きな差はTerminal-Bench-Scienceで見られ、その他ほとんどは5ポイント未満です。これらはベンダーが実行した結果です。
Fable 5.1はOpus 5の2倍の価格に見合いますか? 長期的な研究やターミナルエージェント、ビジネス自動化、そしてプレフィックスを多用するエージェントループ(キャッシュ読み取りが安価であるため、1ターンあたりのコストが低くなる場合がある)では、多くの場合そうです。出力が多い、レイテンシーに敏感な、または分類作業ではそうではありません。Anthropic自身のルール:より高いエフォートのOpus 5が評価に失敗した場合にのみ、上位モデルに移行してください。
Fable 5.1とOpus 5ではどちらが高速ですか? Opus 5です。AnthropicはFable 5.1を「遅い」、Opus 5を「中程度の」レイテンシーとしており、Opus 5には最大2.5倍の出力速度を持つ高速モードがあります。Fable 5.1にはありません。
Opus 5はFable 5.1と同じ安全性分類器を持っていますか? いいえ。Opus 5はサイバーのみの分類器を実行します。Fable 5.1は、バイオ、フロンティアLLM、推論抽出、一般的な危害を追加します。Fable 5.1が拒否した場合、Opus 5は許可された2つのフォールバックターゲットの1つです。
Opus 5のようにゼロデータ保持でFable 5.1を使用できますか? いいえ。Fable 5.1は30日間の保持が必要なカバードモデルです。Opus 5はZDRで利用可能です。
Opus 5とFable 5.1の間で会話を移行できますか? 上方向(Opus 5からFable 5.1へ)は可能です。Fable 5.1はOpus 5の思考ブロックを読み取ります。下方向(Fable 5.1からOpus 5へ)の場合、APIはFable 5.1の思考ブロックがOpus 5に表示される前にそれらを削除し(課金なし)、Opus 5はそのターンを再計画します。