
Chain of Recallは、コンテキストウィンドウにあらゆる情報を詰め込むことなく、長時間稼働するAIエージェントに記憶を持たせるための手法です。すべてのTrigger、Thread、Workerには不変のIDが割り当てられます。コンテキストにはID、短い要約、近傍のメッセージのみを保持し、エージェントはID間のリンクを辿ることで、数ホップで過去の事実を取得します。
この言葉は、2026年11月1日に公開されたDeepSeek Harnessの設計論考「Exploring Super-agent Design(スーパーエージェント設計の探求)」に由来します。読み進める前に1点注意すべき点があります。この論考で解説されているのはアーキテクチャであり、正式に提供されている機能ではありません。その一部はプロトタイププラグインであるdsh-superagent-prototypeに実装されていますが、著者らはこれを「DeepSeekの公式製品ではない」としています。オンにすればすぐ使える「Chain of Recall」の機能スイッチがあるわけではなく、自ら構築する設計パターンなのです。
長時間稼働するエージェントにおけるコンテキストウィンドウの課題
長時間稼働するエージェントは、絶え間なくタスクが届くため、いずれコンテキストの上限に達します。チャット、GitHub、CIを常時監視するスーパーエージェントは1日に数百件ものイベントを処理するため、昨日の作業内容を保持したウィンドウに今日の作業まで収めることはできません。
一般的な対策には、それぞれ代償が伴います。
- すべて保持する:ウィンドウがすぐに埋まり、ターンごとにコストが跳ね上がります。
- 過去のターンを要約する:要約によって、後で必要になる正確なエラーメッセージやPR番号が抜け落ちてしまいます。
- 類似度で検索する:必要としている事実がクエリの表現と似ていない場合、うまく機能しません。
AnthropicによるAIエージェントのコンテキストエンジニアリングガイドでは、コンテキストを「キュレーションすべき有限のリソース」と位置づけています。Chain of Recallはそのキュレーションを実践する具体的な手法の1つです。より幅広い選択肢については、AIエージェントのメモリの仕組みの解説記事をご覧ください。
インライン化とスピル:キャッシュとしてのコンテキスト
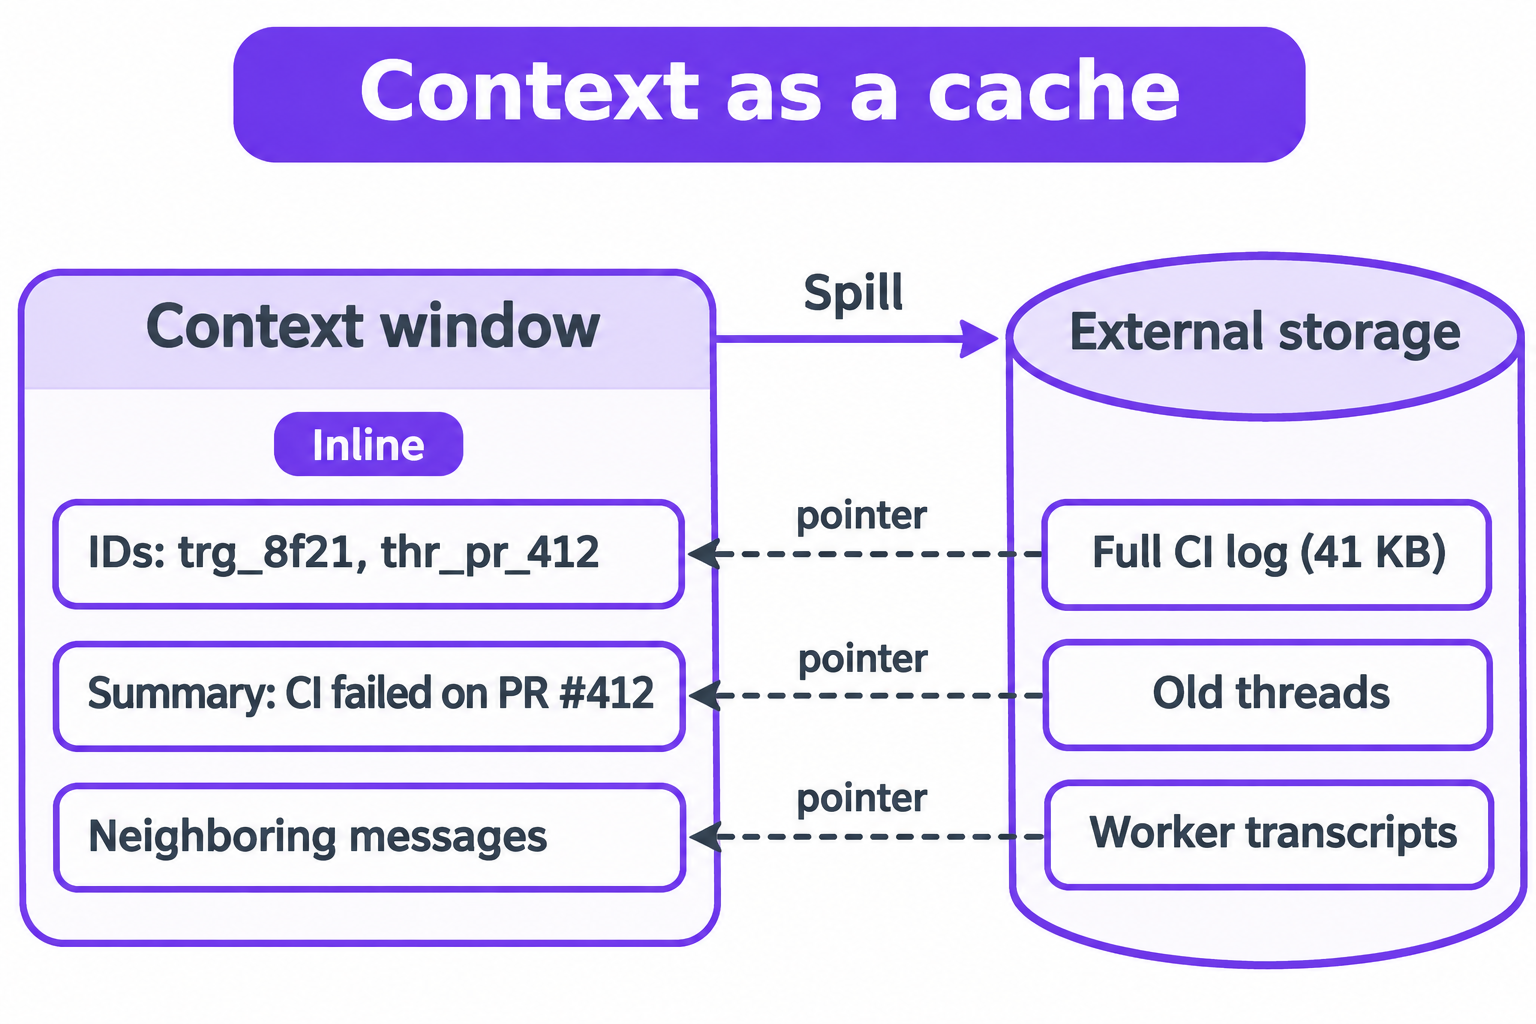
論考では、コンテキストウィンドウをキャッシュのように扱い、2つの操作を行います。
- インライン化(Inline):ID、短い要約、前後のメッセージなど、エージェントが今すぐ必要としそうな情報をコンテキスト内に残します。
- スピル(Spill):それ以外のすべての情報を切り捨て、エージェントが後から辿れるポインタ(参照先)だけを残します。
スピルされた項目は削除されるわけではなく、プロンプト内にはそのポインタのみが保持されます。
Routerに届いた1件のCI障害イベントを例にとると、以下のようになります(この構造は概念を示すための例であり、DeepSeekのコードそのものではありません)。
{
  "trigger_id": "trg_8f21",
  "source": "github.check_run",
  "thread_id": "thr_pr_412",
  "summary": "CI failed on PR #412: 3 of 118 tests red in payments/",
  "neighbours": ["trg_8f1c: review comment asking for retry logic"],
  "spilled": {
    "full_log": "GET /triggers/trg_8f21/payload (41 KB, truncated)"
  }
}
1行の要約だけで十分であれば、エージェントは41KBのログを読み込むコスト(トークン)を支払わずに済みます。詳細が必要になった場合のみ、IDを指定してログを取得します。
不変のIDと参照グラフ
Chain of Recallが機能するのは、IDが決して変化しないからです。論考の設計では、主に3種類のオブジェクトにIDが付与されます。
| オブジェクト | 概要 | IDの例 |
|---|---|---|
| Trigger | 受信した1件のイベント(チャットメッセージ、Webhook、CIコールバックなど) | trg_8f21 |
| Thread | 1つのPR、チャットトピック、メールスレッドに関する一連の関連イベント | thr_pr_412 |
| Worker | 1つのタスクを処理する隔離されたエージェントセッション | wkr_77a0 |
TriggerはThreadに属し、Threadは1つ以上のWorkerによって管理され、Workerのレポートには対処したTriggerが引用されます。これらのリンクが参照グラフを形成し、そのグラフこそがエージェントのメモリとなります。
想起(リコール)は、履歴全体を読み込んだり類似テキストを検索したりするのではなく、リンクを1ホップずつ辿ることによって行われます。RouterとWorkerの全体設計におけるTrigger、Thread、Workerの位置づけについては、関連ガイドのスーパーエージェントの構築方法で解説しています。
マルチホップ想起の具体例
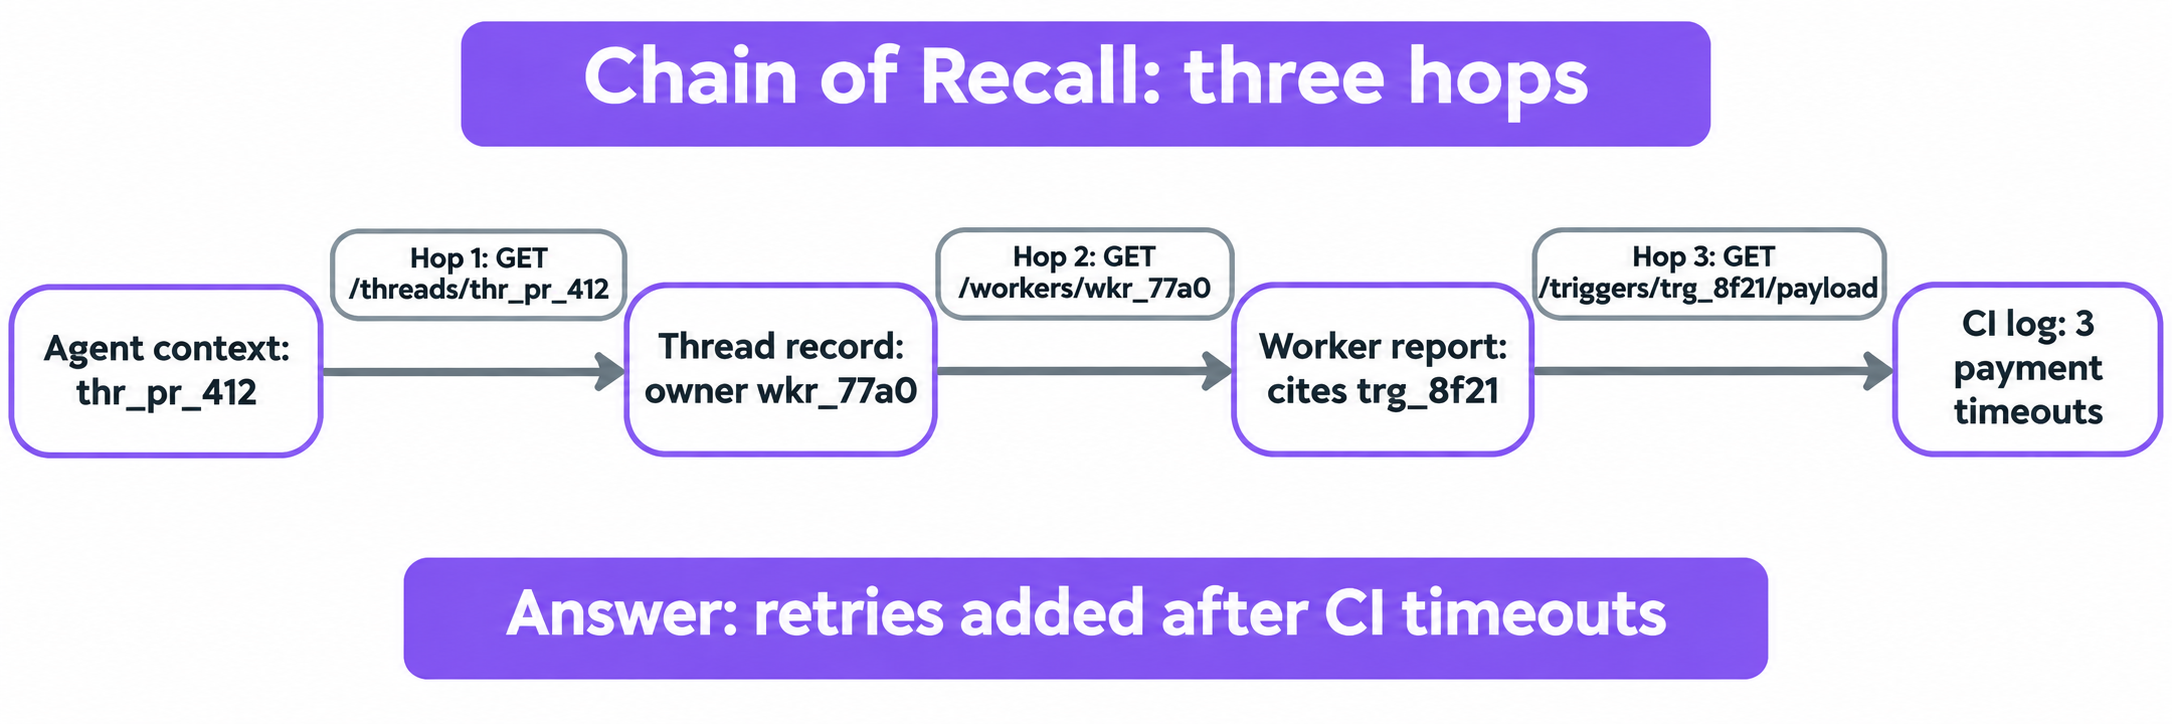
例えば金曜日に、チームメンバーがRouterに「paymentsクライアントにリトライ処理を追加したのはなぜ?」と尋ねたとします。元の議論が行われたのは火曜日であり、すでにスピルされています。このときのリコール手順は次のようになります。
- ホップ1:Threadを見つける。 Routerのコンテキストには、まだ1行のインデックスエントリ(
thr_pr_412: payments retry PR, merged Wed)が残っています。これをもとにGET /threads/thr_pr_412を実行して取得します。 - ホップ2:Workerを見つける。 Threadのレコードには
owner_workers: ["wkr_77a0"]が記載されています。RouterはGET /workers/wkr_77a0を実行し、その最終レポートを読み取ります。 - ホップ3:原因を特定する。 レポートにはCI障害である
trg_8f21が引用されています。RouterはそのTriggerのペイロードを取得し、ログ内のタイムアウトエラーを確認します。 - 回答の生成。 「火曜日にPR #412のCIで決済タイムアウトが3件発生しました。Worker wkr_77a0がバックオフ付きリトライ処理を追加し、水曜日にPRがマージされました。」
行われたのは、小さく正確な3回の取得のみです。推測に頼ることは一切なく、3日間にわたってプロンプトに情報が残り続けることもありませんでした。
Chain of Recallとベクトルメモリ・要約の比較
Chain of Recallは、他のメモリ技術を置き換えるものではありません。対象とする問いが異なるのです。検索拡張生成(RAG)の論文で広く知られるようになったベクトル検索が「これに似ているものは何か?」を問うのに対し、Chain of Recallは「これにリンクしているものは何か?」を問いかけます。
| Chain of Recall | ベクトルメモリ(RAG) | ローリング要約 | メモリMCPサーバー | |
|---|---|---|---|---|
| 想起の仕組み | 不変のIDリンクを辿る | 埋め込みベクトルの類似度検索 | 圧縮された履歴を読み込む | サーバーが提供するメモリツールを呼び出す |
| 精度 | IDによる完全一致のレコード | スコア順にランク付けされた近似値 | 設計上情報落ちが発生する | サーバーのストレージに依存する |
| 最適な用途 | イベント履歴(PR、チケット、CI実行など) | 大規模なドキュメント群、曖昧な質問 | 短時間のセッション、チャットの継続性 | ツールやセッション間で共有される事実 |
| 必要なもの | 不変のID、ID指定取得API | 埋め込みモデルとインデックス | 要約処理 | 稼働中のMCPサーバー |
| 弱点 | リンクされていないものは見つけられない | 異なる表現で書かれた事実を見逃す | 詳細が欠落する | 別のサービスの運用とセキュリティ管理が必要 |
実際にはこれらを組み合わせて運用することになります。まずベクトルインデックスを使って起点となるThread IDを見つけ、そこからChain of Recallで正確な事実を辿っていくという形です。MemGPT論文のOSスタイルのメモリ階層もこれに近いアプローチです。既存のストレージをそのまま使いたい場合は、MCPを使ってAIエージェントに永続メモリを追加する方法をご覧ください。
留意すべき制限事項が2点あります。まず、論考では長期記憶が未解決の課題として挙げられており、Chain of Recallがそれを完全に解決するとは主張していません。また実験では、Threadのパススルー(素通し)を取り除くと、実行あたりのキャッシュ読み取りトークン数が23.2Mから31.8Mへと約37%増加しました。これは機能が不足していたことによるコスト増であり、Chain of Recallによる削減効果ではありません。
基盤となるAPIが保証すべきこと
先ほどのウォークスルーにおける各ホップは、いずれもAPI呼び出しです。仮に1つの呼び出しで別のレコードが返されたり、何も返されなかったりすると連鎖が途切れ、エージェントは停止するか推測で回答してしまいます。そのため、Chain of Recallを支えるAPIには以下の4つの契約(保証)が求められます。
- IDが決して変化しないこと:今日返されたIDは、翌月でも同じオブジェクトに解決されなければなりません。削除後のID再利用や、データ移行に伴う再付番は不可です。
- IDによる取得が軽量かつ厳密であること:
GET /threads/{id}は該当する1件のレコードのみを返します。検索処理を行ったり、「最も近い一致」を返したりしてはいけません。 - 未定義のIDは明確にエラーを返すこと:存在しないIDに対しては、RFC 9110の定義通り、明確なエラーボディとともに
404 Not Foundを返します。空のオブジェクトで200を返すと、実際には存在しない記憶が存在するかのようにエージェントに誤認させてしまいます。 - カーソルによるページネーションに欠落がないこと:
GET /threads/{id}/events?cursor=によって、長いThreadを順序通りに走査できます。すべてのイベントが1度だけ出現し、スキップされることがなく、新しいイベントが届いてもカーソルの有効性が維持される必要があります。
これらの契約はリファクタリング時に密かに破られがちであるため、自動テストに組み込む必要があります。また、ツールのレスポンス自体も小さく保つ必要があります。これについては、エージェントのツールレスポンスとコンテキストウィンドウに関するガイドで詳しく解説しています。
Apidog CLIを使ってコーディングエージェントにリコールAPIをテストさせる
Chain of Recallの信頼性はID指定取得エンドポイントの信頼性に直結しますが、そうした検証コードの記述や再実行はコーディングエージェントに任せることができます。Apidog CLIを使用すれば、エージェントはエンドポイントの定義、テストケースの作成、ターミナルからの実行をコマンド経由で行えます。
初回セットアップ手順:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
あとは、Claude CodeやCodexなど、お使いのエージェントに以下のようなプロンプトを1つ与えるだけです。
In Apidog project <projectId>, define three endpoints for our agent memory
service: GET /threads/{id}, GET /threads/{id}/events?cursor=, and
GET /workers/{id}. Then create test cases that check:
1. A thread_id returned by GET /threads/{id} resolves to the same record
   on a second call, and each owner worker ID resolves via GET /workers/{id}.
2. An unknown thread ID and an unknown worker ID both return 404.
3. Paging GET /threads/{id}/events with the cursor returns every event
   once, in order, with no gaps.
Run them against the staging environment and summarize any failures.
エージェントは各ペイロードスキーマを読み込み、書き込みを行う前にJSONを検証した上で、テストケースの作成と実行を行います。
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file thread-get.json
apidog endpoint create --project <projectId> --file thread-get.json

apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file id-resolves.json
apidog test-case create --project <projectId> --file id-resolves.json

apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
cliレポーターはターミナル上にアサーションごとの成否を出力し、jsonレポートはどのホップで障害が発生したかをエージェントが読み取って説明できるファイルを生成します。移行作業後にIDが解決できなくなった場合でも、エージェントが壊れたチェーンに基づいて回答を始める前にレポートで検知できます。マージごとに同じチェックを実行したい場合は、レポーターを-r junitに切り替えます。Claude CodeでのApidog CLI活用のウォークスルーで、エージェントの完全なループ処理を紹介しています。
Chain of Recallの適した活用場面
Chain of Recallが適しているのは、エージェントのメモリがPR、チケット、CI実行、サポートスレッド、デプロイといった、個別のリンク可能なイベントの履歴である場合です。これらにはすでに自然なIDが存在しており、それらについて人が尋ねる質問(「なぜこれを行ったのか?」「その後に何が起きたのか?」)は、本質的にリンク(つながり)に関する問いだからです。
非構造化ドキュメントや曖昧な質問にはベクトル検索を使い、細部が欠落しても問題ない短時間のセッションには要約を活用するのが賢明です。
Chain of Recallは1つの論考と1つのプロトタイプから生まれたものであり、製品ではなく明確で検証可能なアイデアです。論考の背景にあるツールについては、まずDeepSeek Harnessとは何かをご覧ください。
FAQ
Chain of Recallは有効化できるDeepSeekの機能ですか? いいえ。これはDeepSeek Harnessのスーパーエージェント論考に登場する用語であり、その一部がプロトタイププラグインに実装されているものの、著者らはDeepSeekの公式製品ではないとしています。このパターンは利用者自身で実装する必要があります。
インライン化(Inline)とスピル(Spill)の違いは何ですか? インライン化は、ID、短い要約、前後のメッセージをプロンプト内に保持します。スピルはそれ以外の情報を切り捨て、必要に応じてエージェントがIDで取得できるポインタを残します。
Chain of RecallはRAGを置き換えるものですか? いいえ。RAGが類似したコンテンツを検索するのに対し、Chain of Recallは厳密なIDリンクを辿ります。多くのエージェントでは両方を組み合わせて使用します。
Chain of Recallによってトークン数が37%削減されたのですか? いいえ。37%という数値はThreadのパススルーに関するものです。論考の実験では、パススルーを取り除いたことで実行あたりのキャッシュ読み取りトークン数が23.2Mから31.8Mに増加しました。論考自体では、Chain of Recallそのものによるトークン削減効果については報告されていません。
ID指定取得APIは、不明なIDに対して何を返すべきですか? 明確なエラーボディを持つ404 Not Foundを返すべきです。空のオブジェクトとともに200を返すと、エージェントはレコードが存在すると誤認し、想起チェーンが気づかないうちに破綻してしまいます。
エージェントのメモリAPIの安定性をテストするにはどうすればよいですか? ある呼び出しで得られたIDが次の呼び出しでも正しく解決されること、不明なIDには404が返されること、カーソルによるページネーションに欠落がないことを検証するテストケースを作成します。コーディングエージェントを使えば、マージごとにApidog CLIを通じてこれらを自動作成・実行できます。