
Cerebrasは一つの数字を売りにしている:スピードだ。その宣伝文句は、ウェハースケールのチップがGPUクラスタよりもはるかに高速にトークンを出力するというもので、無料枠は同社があなたに気づいてもらうための方法だ。しかし「高速」はベンダーの言葉を鵜呑みにすべきものではない。それは自分の接続で、自分のプロンプトを使って測定し、Cerebrasが新しいモデルを投入したり制限を変更するたびに再実行できる記録として保持すべきものだ。
このガイドでは、その測定を一緒に行う。CerebrasのAPIキーを取得し、OpenAI互換エンドポイントに対して実際のチャット補完呼び出しを行い、最初のトークンと応答全体の時間を計測し、コーディングエージェントにリクエスト全体をApidog CLIテストに変換させて、次のモデル交換に耐えられるようにする。
TL;DR
Cerebrasは新規アカウントに無料トライアル枠を提供する:付与後30日で失効する$5分のクレジットで、2つのモデル(gpt-oss-120bとqwen-3.8-27b)に限定され、それぞれ毎分5リクエスト、毎分30Kの非キャッシュトークンがCerebrasの公開レート制限に従って適用される。APIはhttps://api.cerebras.ai/v1でOpenAI互換なので、既存のOpenAIクライアントをそれに向けて3行変更するだけでよい。以下では、マーケティングページを信じるのではなく、自分でtime-to-first-tokenと毎秒トークンを測定するリクエストを構築する。
無料枠が文書化していること、していないこと
Cerebrasの料金ページは数値をクライアントサイドでレンダリングするため、有料利用の正確な100万トークンあたりのドルレートは、ページの静的フェッチから取得できるものではない。その数字を推測してはいけない。必要なときは、自分でCerebras Cloudコンソールの請求タブを開くこと。そこだけが現在のレートが正確であることが保証されている場所だ。
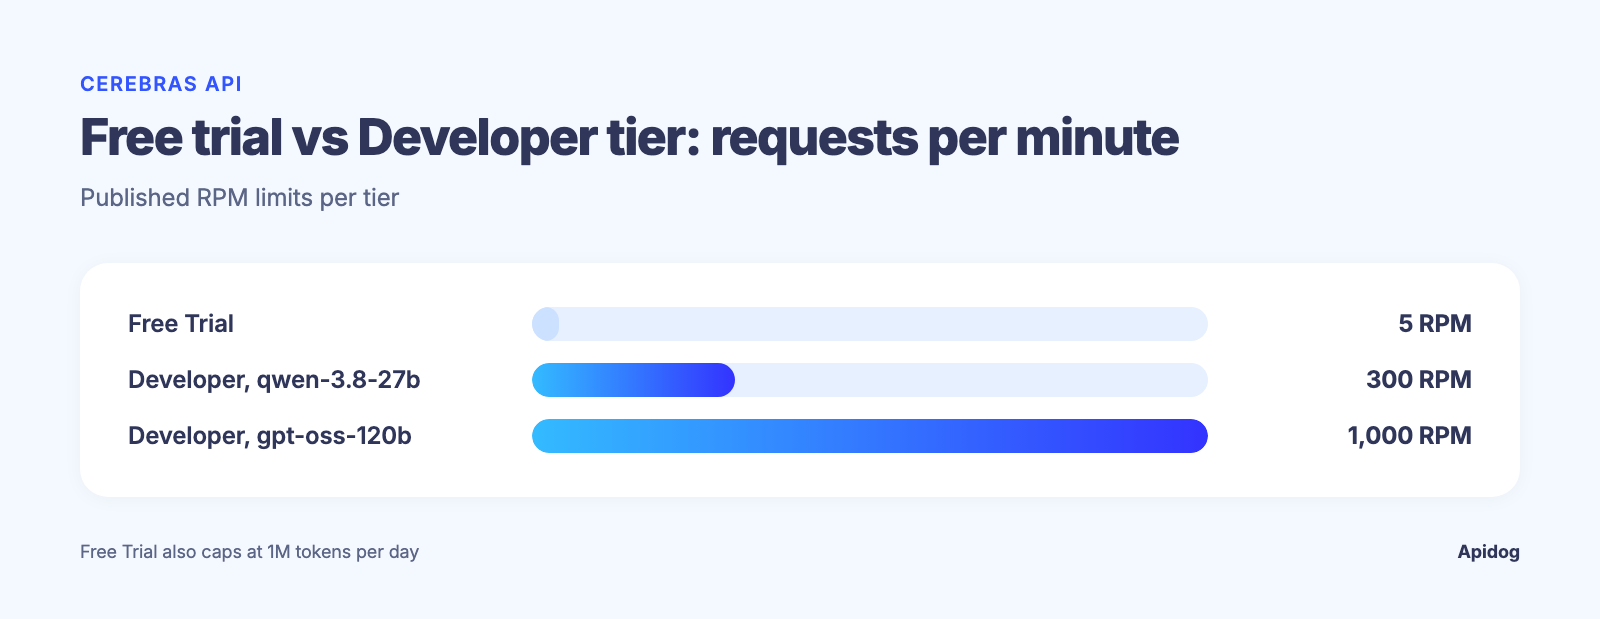
ドキュメントが明確に述べているのは、サポートレート制限ページにおいて、無料トライアル枠の形である:
| ティア | モデル | RPM | 非キャッシュTPM | 合計TPM | TPH | TPD |
|---|---|---|---|---|---|---|
| 無料トライアル | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
デベロッパー (gpt-oss-120b) |
従量課金制 | 1,000 | 1M | 3M | なし | なし |
デベロッパー (qwen-3.8-27b) |
従量課金制 | 300 | 150K | 450K | なし | なし |
ここで重要な点が2つある。第一に、「非キャッシュTPM」が実際の上限である:完全なコンピュートを必要とするトークンであり、キャッシュヒットがカウントされると、合計TPM許容量はその約3倍になる。第二に、無料トライアルアカウントはクレジットと時間に制限され、永久にリクエストが制限されるわけではない:$5がなくなったか30日が経過すると、支払い方法を追加するまで、アカウントティアが許す範囲に落ちる。この表以降のすべて(トークンごとの価格設定、シート価格設定、エンタープライズ条件)は、JavaScriptでレンダリングされる料金ページとコンソールの背後にあり、静的ドキュメントにはない。したがって、予算を立てる前にそこで確認すること。
他のプロバイダーでこのような壁にぶつかったことがあるなら、パターンは429レート制限超過応答を受け取ったときの対処法のガイドで扱っているものと同じだ:エラーボディを読み、バックオフし、APIが壊れていると決めつける前にダッシュボードを確認する。
キーを取得して実際の呼び出しを1回行う
cloud.cerebras.aiでサインアップし、API Keysを開いて生成する。Cerebras自身のクイックスタートでは、環境変数として設定するように指示されているので、手動でリクエストボディに入れることはない:
export CEREBRAS_API_KEY="your-key-here"
ベースURLはhttps://api.cerebras.ai/v1で、チャット補完エンドポイントはOpenAIの形式と直接一致する:modelとmessages配列を持つPOST /v1/chat/completionsである。この互換性はAPIリファレンスに記載されており、ベースURLとキーを変更するだけで、OpenAIのクライアントライブラリ用に書かれたコードにCerebrasを組み込める理由である。生のcurl呼び出しは次のようになる:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
実行すると、応答には補完テキスト以上のものが含まれる。usageブロック(prompt_tokens、completion_tokens、total_tokens)と、Cerebrasがすべての呼び出しで返すtime_infoブロック(queue_time、total_time)が含まれる。
チームが複数のモデルやプロバイダーをテストしているなら、一回限りのcurlコマンドに頼るのをやめる良い機会だ。以下のApidog CLIセクションでは、コーディングエージェントにこの呼び出しをテストに変換させ、Cerebrasがモデルを追加したり制限を変更するたびに再実行させる。
スピードの主張を測定する:time-to-first-tokenと毎秒トークン
「高速」があなたのワークロードにとって現実的かどうかを示す2つの数字:time-to-first-token(TTFT)と毎秒生成されるトークン数だ。どちらもAPI応答のヘッドラインメトリクスとしては表示されないので、呼び出しが提供するものから計算する。
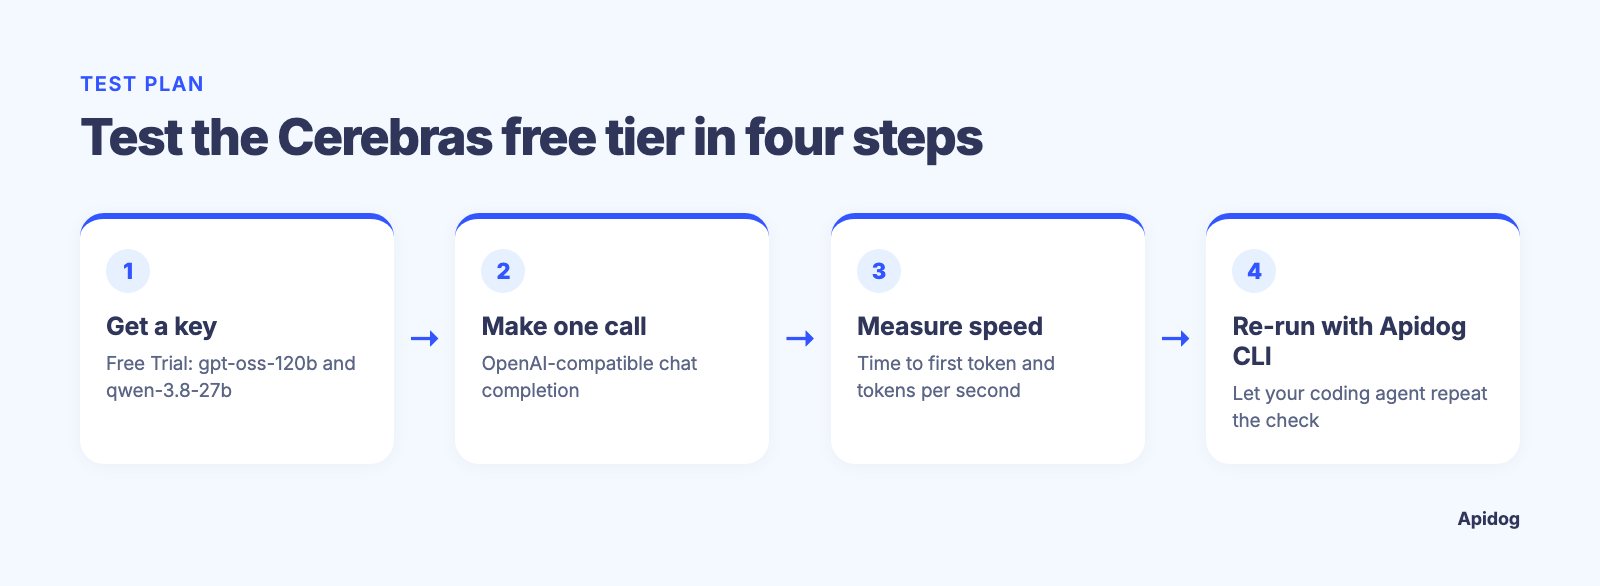
TTFTについては、応答をストリームし、リクエストの送信から最初のチャンクを受信するまでの実時間のギャップを記録する:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
毎秒トークンについては、非ストリーミング呼び出しを使用し、補完トークンをtime_infoでCerebrasが報告するtotal_timeで割る:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
これを数回、異なる時間帯に、製品が送信するものに近いプロンプトで実行する。両方のスクリプトを保持し、Cerebrasが無料枠にモデルを追加するたびに再実行すること。なぜなら、毎秒トークンの数値はプロバイダーごとだけでなくモデルごとに変わるからだ。
制限に読まれる前に制限を読む
Cerebrasのレート制限設計には、スクリプトを書く前に知っておく価値のある微妙な点が1つある:組織ごとに2つの別々のトークンバケット(非キャッシュTPMと合計TPM)を追跡し、両方を同時に適用する。短く反復的なプロンプトのバーストは、トークン上限に近づく前に毎分リクエスト上限に達する可能性がある。これは、APIレート制限の仕組みに関するより広範な記事で説明されている罠とまったく同じだ。
ドキュメントの正直なギャップが1つある:Cerebrasは一部のプロバイダーのようにx-ratelimit-*応答ヘッダーを公開していない。APIリファレンスには記載がなく、レート制限ページにもない。これは、すべての呼び出しで残りクォータヘッダーを返すOpenAI自身のチャット補完APIとは異なる。このパターンはOpenAIレート制限ガイドでより詳しく扱っている。Cerebrasでは、実際の状況を確認する場所はCloudコンソールのLimitsセクションと、429応答のボディの2つであり、非キャッシュか合計トークン上限のどちらを超えたかが示される。ヘッダーが最初に教えてくれると想定するのではなく、そのエラーボディを中心にリトライロジックを構築すること。
コーディングエージェントにApidog CLIで再実行させる
スクラッチファイルでの測定は、来月には何も証明しない。コーディングエージェントに、Apidog CLIを通じて再実行できるテストに呼び出しを変換させる。一度セットアップする:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
トークンはApidogのアカウント設定、APIアクセストークンから取得する。次にエージェントに1つのプロンプトを与える:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
実行するコマンドは、Apidog CLI 2.2.7で確認済み:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csvはMODEL列を1つ持ち、1回の実行で両方のモデルをカバーし、Cerebrasが次に投入するものはさらに1行追加するだけだ。--delay-request 12000は呼び出しを12秒間隔にし、無料トライアルの毎分5リクエスト以下に抑える。429パスについては、意図的にその制限を超えてバーストし、エラーボディをアサートする2番目のケースを依頼する。そうすれば、本番で再発見するのではなく、キャプチャしてバージョン管理できる。これはワークフローであり、一度きりのベンチマークではない。オプションを比較しているなら、エージェントとLLMワークロード向けに構築されたAPIテストツールのまとめを参照し、エージェント側についてはClaude CodeでのApidog CLIを参照のこと。
無料枠かデベロッパー枠か:いつ移行するか
無料トライアル枠は、このガイドが辿る内容、つまりカードを切る前にスピードの主張とリクエストの形を確認するために作られている。本格的にCerebrasで構築するようになると、デベロッパー枠のジャンプ、gpt-oss-120bで5 RPMから1,000 RPMへの増加が、通常、決定を迫る数字であり、トークンあたりの価格ではない。プロンプト量が安定ではなくバースト的な場合、コミットする前にCerebrasの数字を代替と比較すること。OpenRouterの代替のリストと、Groqの無料API枠のウォークスルーは、上記の表と並べて読む価値がある。推論速度と無料枠の上限は、ほとんどの比較記事が認める以上にプロバイダー間で異なるからだ。選ぶ前に知っておく価値のある違いが1つある:Groqはモデルごとの無料プラン制限を直接文書化しており、例えばopenai/gpt-oss-120bは30 RPM、1,000 RPD、8K TPM、200K TPDで、すべての呼び出しでx-ratelimit-*応答ヘッダーを返すので、応答自体から残りの予算を常に知ることができる。Cerebrasはどちらも提供しない。上記で説明したように、Cloudコンソールから状況を読むか、429ボディから推測する。
FAQ
Cerebrasの無料枠にはクレジットカードが必要ですか? 無料トライアル枠は、定期的な無料プランではなく、クレジットベース($5、30日後に失効)であり、Cerebras自身のドキュメントでは、現在のサインアップ要件についてCloudコンソールを参照するように指示されている。この詳細は静的ドキュメントとは独立して変更される可能性があるためだ。
無料枠で利用できるモデルはどれですか? 現在のレート制限ドキュメントによると、2つ:gpt-oss-120bとqwen-3.8-27b。どちらも同じ無料トライアル制限(5 RPM、30K非キャッシュTPM)を共有する。
既存のOpenAI SDKコードをCerebrasで使用できますか? はい。クライアントのベースURLをhttps://api.cerebras.ai/v1に向け、Cerebrasキーに交換する。/v1/chat/completionsの形は一致する。APIリファレンスによる。
トークン予算内なのに429が返ってきたのはなぜですか? Cerebrasは非キャッシュTPM、合計TPM、RPMを別々の上限として適用する。小さいリクエストの連続は、どのトークンバケットもいっぱいになる前にRPM制限に引っかかることがある。これは、レート制限超過のトラブルシューティングガイドで扱っているのと同じ障害モードだ。
最初に壁にぶつからずに現在の使用量を確認するにはどうすればよいですか? Cerebrasは残りクォータの応答ヘッダーを返さないので、API応答から推測するのではなく、CloudコンソールのLimitsセクションを直接確認する。Groqの無料プランは逆のアプローチを取り、すべての呼び出しでx-ratelimit-*ヘッダーを返すので、ヘッダーベースのモニタリングがセットアップにとって重要なら、その違いを比較検討すること。
Cerebrasの真の利点は、マーケティングの見出しではなく、自分の呼び出しのtime_infoブロックに現れる。