
REAの提案は一文でまとめられます。気になる機能を見つけ、その動作をバイナリレベルまで理解し、自分のプロジェクト用にバージョンを作る。この約束のもと、morluto/reaリポジトリは2026年10月にGitHubスター115,000を超えました。デモでは、エージェントがデスクトップアプリ全体を再構築する様子が示されます。しかし実用的なワークフローはもっと小さく、再現しやすいものです。あるアプリから1つの機能を取り上げ、その振る舞いをエビデンスとして抽出し、そのエビデンスから自分の仕様を書き、自分のスタックで構築し、自分のバージョンが同じように動くことを証明します。
このチュートリアルでは、このループをClaude Code、Codex、またはMCPを扱える任意のエージェントで6つのステップに分けて進めます。調査にはREA自身のNotes例を使用し、欲しい機能がAPIによって支えられている場合に何が変わるかも示します。そこで活躍するのがApidogです。REAが何であり、どのようにここまで来たのかという背景を知りたい場合は、まずREAの解説記事をご覧ください。
始める前に:3つのルール
再構築するのはコードではなく振る舞いです。REAは疑似コード、モジュールグラフ、トレースを返します。それらは機能が何をするかの説明として扱い、その説明から自分の実装を書いてください。復元されたコード、文字列、アセット、UIを製品に貼り付けないでください。REAのREADMEは、このツールを合法的な調査と再構築に限定し、許可の問題を利用者に委ねています。始める前に対象のライセンスと利用規約を確認し、何を見たかを記録しておいてください。
スコープは1つの機能に絞ります。REAのFAQでは、エージェントに1つのローカルターゲットと1つの調査対象の振る舞いを渡すように推奨されています。うまくいくショーケース(サウンドのパン計算、クリップボードブリッジ、書き出しボタン)は、検証可能な答えを持つ単一のデータ経路です。「アプリ全体を再構築」は計画ではなくデモです。
最初はJavaScriptまたはElectronのターゲットを選びます。静的JavaScript解析にはネイティブエンジンが不要です。ネイティブバイナリにはHopper、Ghidra、IDAが必要で、時間もかかります。最初の実行では扱いやすい種類を選んでください。
ステップ1:REAをインストールして確認する
Node.js 22.19以降とnpmが必要です。エージェントにMCPサーバーを登録します。
npx rea-agents@latest setup
セットアップは、適用したい設定変更を表示し、元のファイルをバックアップし、承認後にのみ書き込みます。エージェントを再起動してから、登録と認識できるツールを確認します。
npm install --global rea-agents
rea doctor --json
rea doctor --client claude_code --json
インストールガイドには、Codex、Cursor、Gemini CLI、Windsurfなど残りのクライアントIDが載っています。セットアップ後にエージェントがREAのツールを認識しない場合は、FAQの回答どおり、再起動または再接続をしてから、そのクライアント向けにセットアップを再実行してください。
ステップ2:1つの正確な質問をする
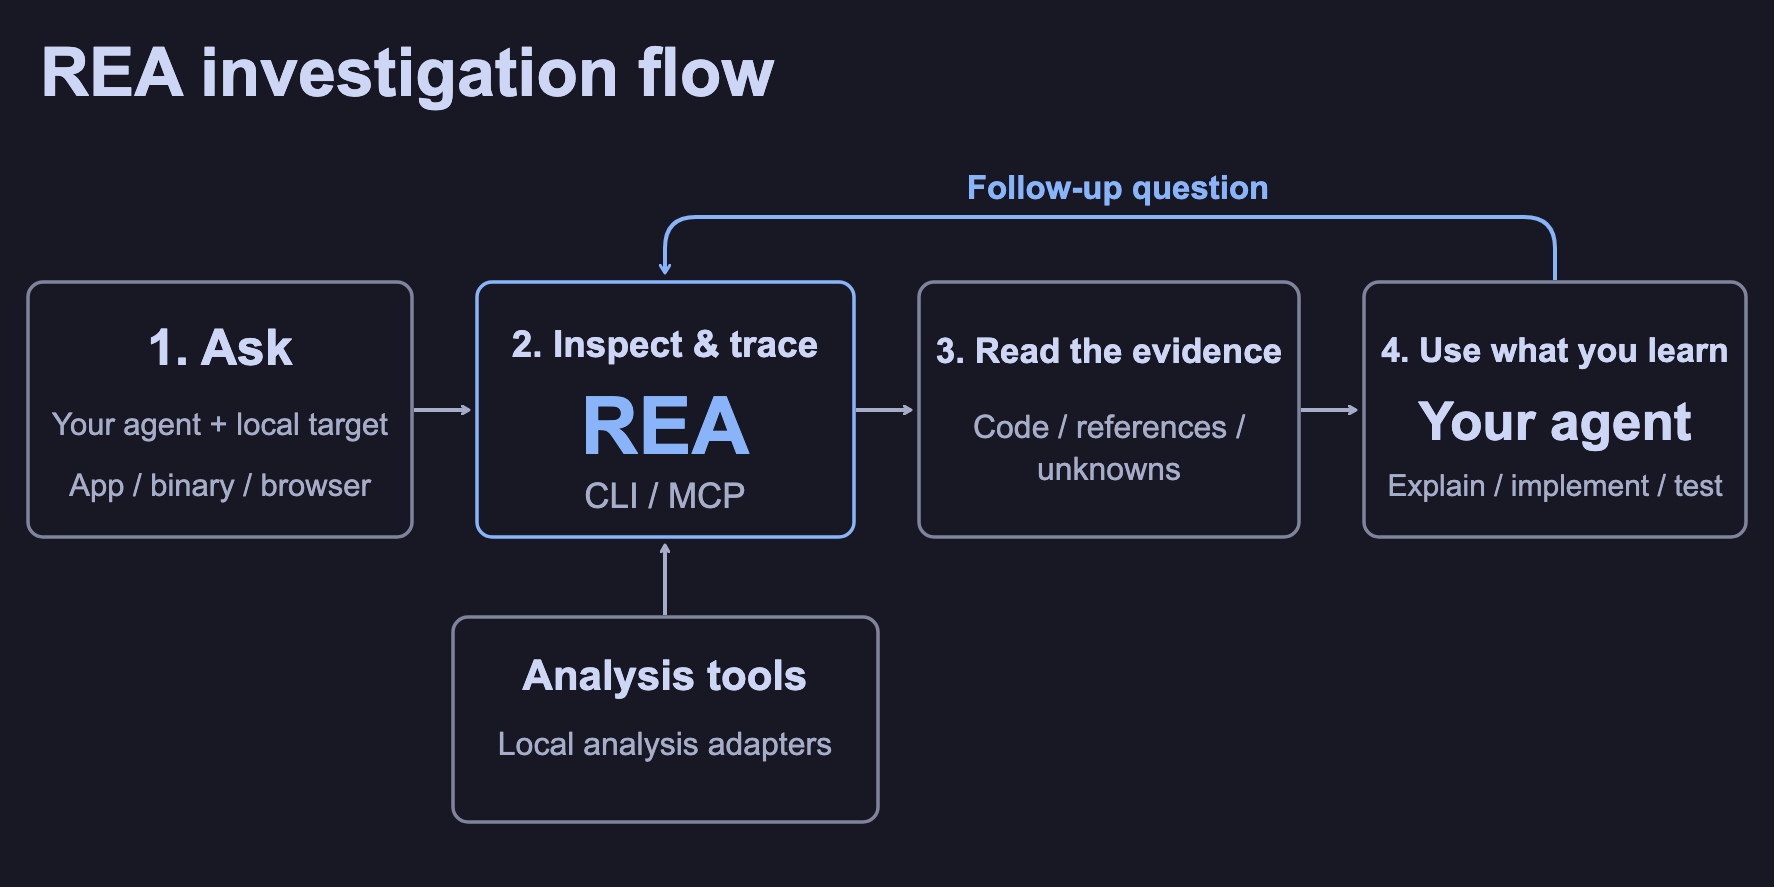
REAには6つのガイド付きMCPプロンプトが付属しています。この作業で使うのはinvestigate_featureです。機能とターゲットを受け取り、エージェントを適切な解析ツールへ誘導します。JavaScriptまたはElectronのディレクトリではanalyze_javascript_application、バイナリではopen_binaryとその背後にあるプロバイダツールです。プロンプトを名前で呼ぶ必要はありません。1つのターゲットと1つの振る舞いを明示した通常の依頼でも機能します。
Use REA on /absolute/path/to/notes-app. Find what happens when the user clicks
"Export notes": which message is sent, which process handles it, where the file
is written, and what fields it contains. Cite the files and lines.
REAの初回調査ガイドは、このまさに同じ質問をNotes例に対して実行しています。期待される答えは次のとおりです。レンダラーはnotes.exportCsv()を呼び出し、プリロードスクリプトがnotes:exportメッセージを送り、メインプロセスがそれを処理してノートをCSVとして整形し、idとtitle列を持つnotes.csvをDownloadsに書き込みます。すべてのステップにファイルと行が付きます。
自分の質問も同じように書いてください。トリガーを明示し、トリガーから結果までの経路を求め、出典を求めます。曖昧なプロンプトからは曖昧な要約しか得られません。
ステップ3:要約ではなくエビデンスを読む
REAの結果は観察、推論、不明点を分けて示し、ガイド付きプロンプトはエージェントにそれらを混ぜないように指示します。その基準を守らせてください。コードを1行書く前に、見えたもの、推論したもの、判断できなかったものを列挙させます。
DX-Ballのショーケースがその理由を示しています。デコンパイラが最初に出したサウンドパン関数の疑似コードは、入力がないと宣言していました。整数パラメータは命令ビューでのみ判明し、そのパラメータの意味は呼び出し元の関数でののみ判明しました。エージェントが正しい答えに到達したのは、1つではなく3つのエビデンスを読んだからです。不明点を省いた要約なら、誤ったシグネチャを持つ関数が生まれていたでしょう。
エビデンスにまだ穴があるときは、audit_residual_unknownsプロンプトを求めてください。セッションでREAが追跡している未解決の質問と、それぞれを解決するために必要なものが一覧されます。再構築に影響するものもあります。多くは影響しないので、それを明示的に伝えて構いません。
ステップ4:コードの前に仕様を書く
次に、その振る舞いを自分が所有する仕様へ変換します。Notesの書き出しでは、これは短いものです。
- トリガー:UIの書き出しアクション。
- 結果:ユーザーのダウンロードフォルダーにあるCSVファイル。
- 列:
id、title。 - 引用規則:カンマまたは引用符を含むタイトルは引用符で囲み、内部の引用符はそれぞれ二重にします。
最後の行は、再構築の成否を分ける細部です。REAのガイドでは、予測チェックでこの点を確認します。カンマと引用符を含むタイトルの出力を予測し、元のフォーマッタを実行して比較します。このような規則はすべて仕様に入れてください。
欲しい機能がAPIによって支えられている場合、仕様はAPI設計になり、ワークフローもここで変わります。トラフィックを1回だけキャプチャし(DevToolsからテストアカウントで記録したHAR)、REAにinspect_web_network_captureで調査させ、api-surfaceビューを求めます。すべてのリクエストがメソッド、オリジン、推論されたパステンプレートごとにグループ化され、IDが変わる部分には{numeric}や{uuid}のプレースホルダーが入ります。これは、元アプリのクライアントがサーバーに必要とするもののインベントリです。
その後、Apidogで設計するのは彼らのAPIではなく自分のAPIです。design-firstモードでプロジェクトを開き、自分のリソース名とレスポンス形状でこの機能に必要なエンドポイントを定義し、キャプチャしたトラフィックはフィールドやエラーケースの見落とし確認にだけ使います。HARインポートガイドでは、このキャプチャを参照として取り込む方法を説明しています。ここでのスペックファースト開発の要点は、どのコードよりも先に契約が存在することです。そのため、エージェントもテストもその契約に向けて構築できます。
ステップ5:自分のスタックで構築する
エージェントに渡すのはREAの出力ではなく自分の仕様です。そして、プロジェクトの言語と構造での実装を求めます。
Build the export feature described in SPEC.md in our Electron app. Use our
existing IPC naming, put the CSV formatter in src/export/csv.ts, and write unit
tests for the quoting rules in the spec. Do not reuse names or code from the
investigation.
可能であれば、このプロンプトのコンテキストから調査エビデンスを除外してください。エージェントは自分の仕様を解決すべきです。元のコードが見えているモデルは、それを再現する方向に drift します。API支給の機能の場合、エージェントはApidogの契約に対して構築します。エンドポイント定義からリクエストコードを生成し、バックエンドが完成する前にUIが動くように、クライアントをApidogのモックサーバーに向けてください。
ステップ6:自分のバージョンが同じ振る舞いをすることを証明する
再構築が完了するのは、元のアプリが通る同じテストを通るときです。REAはこれを形式的に定義します。verify_reconstructionプロンプトは、有限の再構築仕様を保持された比較エビデンスに対して評価し、build_reconstruction_obligation_ledgerツールはエビデンスの束を、所有者、フィクスチャ、合格する検証器がそれぞれ必要な主張のリストへ変換します。ledgerがreadyになるまでです。ledgerのドキュメントは、推論だけでは何もクローズできないと明示しています。
実務では、3種類のチェックを意味します。
- 仕様に基づく振る舞いテスト。DX-Ballの再構築では、元のx86関数と新しいC関数に3,205個の入力を実行して結果を比較しました。規模は小さくなりますが、形は同じです。仕様が重要とする入力を列挙し、両方を実行し、差分を見ます。
- エッジケースの予測チェック。カンマと引用符を含むタイトル。空のリスト。Notesガイドが後続の質問として使う、書き込めないファイル。
- APIの契約テスト。Apidogで、実装の各エンドポイントを呼び出し、ステータス、スキーマ、UIが依存するフィールドを検証するテストシナリオを書きます。毎回のコミットでApidog CLIから実行します。
apidog run --access-token "$APIDOG_TOKEN" -t <scenario-id> -e <dev-env-id> -r cli,junit
これにより再構築は回帰スイートになります。これがデモと出荷できる機能の違いです。ループでエージェントを運用するチームはすでにこうしています。CIの形については、CodexとApidogテストでソフトウェアファクトリーを構築するガイドを参照してください。
この方法が破綻する場合
ランタイムでのみ現れる振る舞い。静的解析が見るのはコード経路であり、実際のデータで何が起きるかではありません。REAにはそのためのブラウザおよびプロセスキャプチャツールがありますが、それらはユーザー権限でターゲットを実行します。隔離された環境で行ってください。REA自身のセキュリティポリシーは、プロバイダブリッジがサンドボックスではないと明記しています。
ネイティブターゲット。GhidraとHopperが生成する疑似コードは、DX-Ballの入力バグが示すように細部で間違っていることが少なくありません。エビデンスを読む複数ラウンドを前提に予算を組み、アセンブリビューが必要になると考えてください。
UIとアセット。機能がどう動くかは学べます。しかし画面、アイコン、テキスト、データファイルをコピーすることはできません。競合のインターフェースをピクセル単位で再現することが法的に問題ないかは、REAによって変わらない法的判断です。
速いリリースサイクル。REAは10月の急増期に9日間で7つのマイナーバージョンをリリースし、マイナーでも出力契約が壊れる可能性があります。プロジェクトの期間中はバージョンを固定してください。
よくある質問
REAは元のソースコードを渡してくれますか?いいえ。ネイティブバイナリでは疑似コードとアセンブリ、JavaScriptではモジュール、関係、ソース位置が得られます。実装を書くのはあなたの仕事であり、それが再構築をあなたのものにし続けます。
機能が純粋にローカルならAPIツールは必要ですか?いいえ。Notesの書き出しはネットワークに一切触れません。Apidogが登場するのは、機能がサーバーに依存するときです。ほとんどのWebおよびモバイル機能はそうなっています。
再構築が終わったかどうかはどうわかりますか?仕様内のすべての主張が合格するテストを持ち、無視すると決めた不明点が文書化されているときです。Apidogをダウンロードして、そのAPI側をCIで実行してください。
このループを一行で言うと
REAをインストールし、1つの正確な質問を投げ、エビデンスとその不明点を読み、自分が所有する仕様を書き、自分のスタックでその仕様に従って構築し、振る舞いを比較するテストで証明します。API支給の機能では、仕様はApidogに置かれ、証明はCIのテストシナリオになります。このループは拡散動画より遅いですが、擁護できる機能を手に残す可能性ははるかに高いです。