
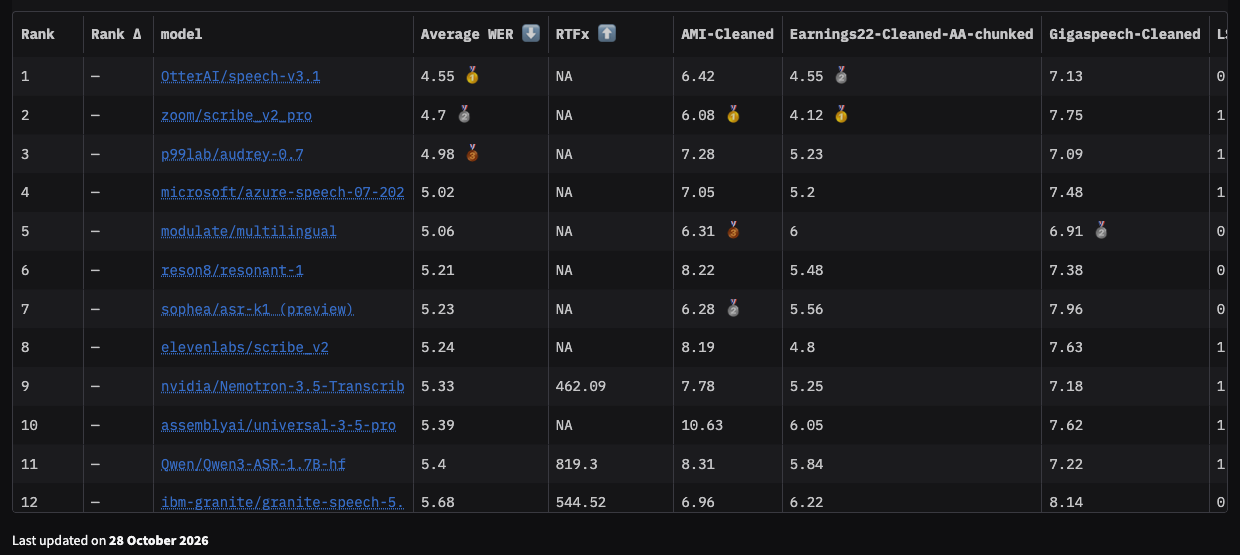
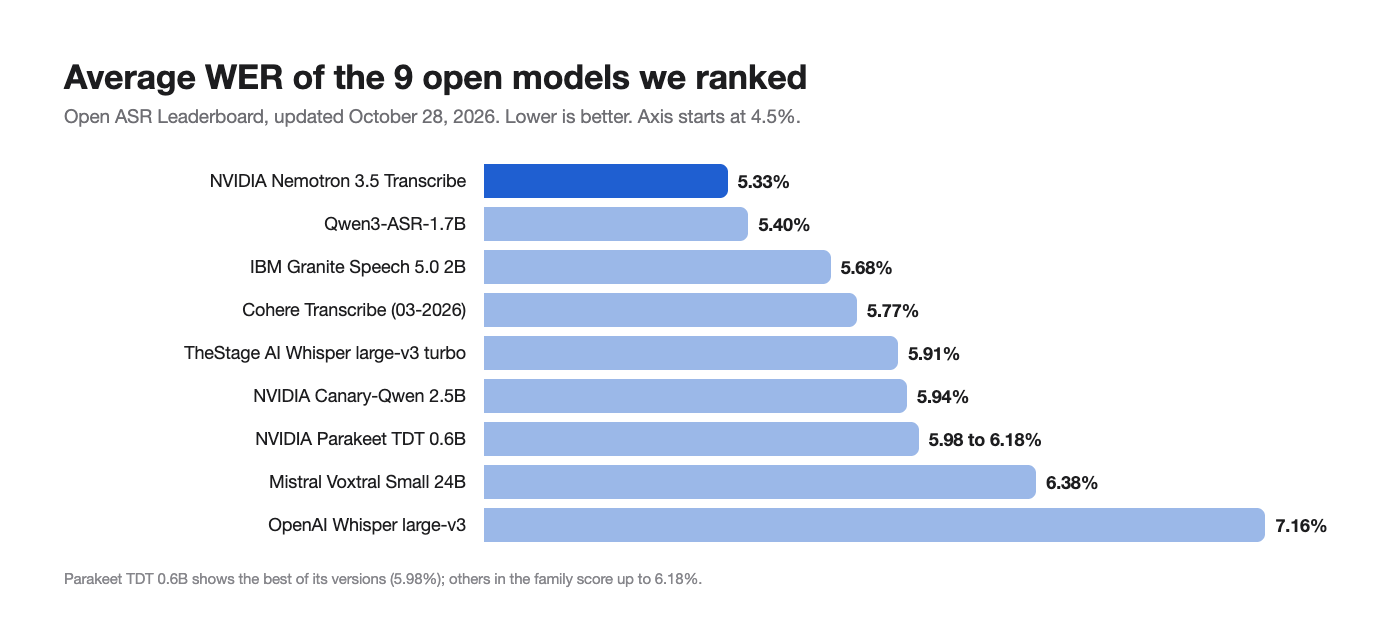
2026年10月時点で最高のオープンソース音声認識モデルは、10月28日にリリースされたNVIDIAのNemotron 3.5 Transcribeです。Hugging Face Open ASR Leaderboardが同日更新され、平均ワードエラー率5.33%で61モデル中9位にランクインしています。上位8モデルはすべてクローズドな商用APIです。多くのチュートリアルでいまだにデフォルトとして使われているOpenAIのwhisper-large-v3は、7.16%で41位です。
以下では、今検討する価値のあるオープンウェイト音声認識モデル9つを、同リーダーボードの順位に従って、速度・強み・適した用途とともに紹介します。WERと速度の数値はすべて、2026年10月29日時点で確認したリーダーボードのものです。
代わりにホスト型APIを比較検討している場合は、Nemotron 3.5 Transcribe APIガイドとWhisper APIガイドをお読みください。
ランキングの方法
Open ASR Leaderboardは、すべてのモデルを同一の英語テストセットで実行します。会議(AMI)、決算説明会(Earnings22)、ポッドキャストとYouTube(GigaSpeech)、オーディオブック(LibriSpeech)、金融通話(SPGISpeech)、雑音下の音声(URGENT24)、会話音声(Voice Arena Monsoon)、議会演説(VoxPopuli)、そして2つの非公開セットです。ランキング指標は平均WERで、低いほど優れています。
また、リーダーボードの速度指標であるRTFxも掲載しています。これは計算1秒あたりに文字起こしできる音声の秒数です。高いほど高速です。クローズドAPIは同じハードウェアで計測できないため「NA」と表示されます。
チェックポイントがダウンロード可能で、リーダーボードがそのRTFxを報告している場合に、オープンウェイトモデルとして数えました。商用利用の前には必ず各ライセンスを確認してください。
ランキング早見表
| 順位(オープン) | モデル | 平均WER | RTFx | 総合順位 |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5.33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5.40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5.68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5.77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5.91% | 1,177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5.94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B(各バージョン) | 5.98%~6.18% | 比較なし | 24~31 |
| 8 | Mistral Voxtral Small 24B | 6.38% | 比較なし | 35 |
| 9 | OpenAI Whisper large-v3 | 7.16% | 比較なし | 41 |
参考までに、同じボード上の最高のクローズドAPIは、Otter speech-v3.1が4.55%、Zoom Scribe v2 Proが4.70%、ElevenLabs Scribe v2が5.24%、AssemblyAI Universal-3.5 Proが5.39%、OpenAI gpt-transcribeが5.96%です。Nemotron 3.5 Transcribeは、AssemblyAIとOpenAIのホスト型モデルを上回りつつ、無料でダウンロードできます。
1. NVIDIA Nemotron 3.5 Transcribe:総合最優秀
WER 5.33%、RTFx 462、OpenMDW-1.1ライセンス
NVIDIAの新モデルは、従来型のASRネットワークではありません。音声拡張言語モデルです。6億パラメータのASRエンコーダーと話者エンコーダーが、Mamba-2とTransformerのハイブリッドなMixture-of-Experts LLM(総パラメータ34B、アクティブ約4.3B)に供給されます。この設計により、単に文字起こしする以上のことができるのです。
1位にランクされる理由:
- 40言語に対応し、うち13言語が「最先端」評価
- 1時間のファイルを1回のパスで処理、コンテキスト長は65,536トークン
- 単一モデルから話者識別(最大8話者)と単語タイムスタンプを出力
- プロンプト:逐語的または整形された文言、専門用語のコンテキスト指定、翻訳
- 長尺音声の精度:リーダーボードの長尺セットで平均WER 10.98%(Parakeet-TDT-0.6B-v3は13.37%)、モデルカードより
- 会議:複数話者セットで平均cpWER 15.80%、DiCoW+DiariZenパイプラインの16.83%を上回る
トレードオフ:大型GPUが必要(BF16でH100 80GB 1基、またはNVFP4ウェイトでRTX 5090)、ストリーミング非対応、音声への質問応答は英語のみです。
こんな用途に:会議、ポッドキャスト、決算説明会、多言語アーカイブ、話者ラベルや1時間ファイルが重要なあらゆる用途。無料で使う方法から始めるか、ローカルで実行してください。
2. Qwen3-ASR-1.7B:GPUコストあたりの精度が最高
WER 5.40%、RTFx 819
AlibabaのQwen3-ASR-1.7Bは、英語平均でNemotronにわずか0.07ポイント差まで迫りながら、リーダーボードのハードウェア上では約1.8倍高速に動作し、総サイズは20分の1です。NVIDIA自身の7言語多言語比較では、Nemotronがより明確にリードします(平均WER 4.62%対6.49%)。
こんな用途に:話者識別が不要で、より小さなGPUで英語中心のバッチ文字起こしを行う場合。すでにQwenのマルチモーダルモデルを使っているなら、Qwen3.5-Omniのガイドをご覧ください。
3. IBM Granite Speech 5.0 2B:同サイズで会議音声に最適
WER 5.68%、RTFx 545
IBMのGranite Speech 5.0は、AMI会議録音でWER 6.96%を記録し、ここに挙げたオープンモデル上位6つの中では最高のAMIスコアで、そこでのNemotronの7.78%も上回ります。弱点はSPGISpeechの金融通話で3.36%です。
こんな用途に:IBMのGraniteスタックに標準化しているエンタープライズチーム、およびミッドレンジGPUでの会議文字起こし。
4. Cohere Transcribe:高速かつ高精度
WER 5.77%、RTFx 902
Cohere Labsの2026年3月の文字起こしモデルは、オープン上位5位の精度スコアと、ここでも屈指の高速性を両立しています。LibriSpeechで最も強く(clean 0.97%、other 2.05%)、VoxPopuliでは5.38%とやや弱くなります。
こんな用途に:スループットが精度と同じくらい重要な大量の英語パイプライン。
5. TheStage AI Whisper large-v3 turbo:上位層で最速
WER 5.91%、RTFx 1,177
これはTheStage AIによる最適化されたWhisper large-v3 turboビルドで、本リスト中最速のモデルです。SPGISpeechで1.62%を記録し、これは全61モデル中そのセットで3番目に良いスコアです。誰かがチューニングすれば、Whisperファミリーにまだどれほどの伸びしろがあるかを示しています。
こんな用途に:既存のWhisperコードがあり、そのまま差し替えるだけで速度と精度を向上させたいチーム。
6. NVIDIA Canary-Qwen 2.5B:前世代のNVIDIAフラッグシップ
WER 5.94%、RTFx 862
Canary-QwenはNVIDIAの初期の音声+LLMモデルで、Nemotron 3.5 Transcribeがトップの座を引き継ぎました。依然として高速で、SPGISpeechの1.70%というスコアは excellent(優れています)。NVIDIAのpreference-ASRテストでは、Nemotronが7.56%、Canary-Qwenが8.16%です。
こんな用途に:まだ80GB GPUに移行できない既存のNeMoデプロイメント。
7. NVIDIA Parakeet TDT 0.6B:最小の本格選択肢
バージョン間でWER 5.98%~6.18%
Parakeet TDTにはボード上に0.6Bパラメータの複数バージョンがあり、いずれも互いに約0.2ポイント以内に収まっています。6億パラメータで、約6%のWER付近を維持するここで最小のモデルであり、控えめなGPUでも動作します。弱点は長尺音声で、そこではNemotronが2ポイント以上上回ります。
こんな用途に:エッジデバイス、低コストGPU、音声コマンドや通話の断片のような短いクリップ。
8. Mistral Voxtral Small 24B:音声+強力なLLM
WER 6.38%
Voxtral Smallは音声入力と24BのMistral言語モデルを組み合わせているため、Nemotronと同様に単に文字起こしするだけでなく、音声について質問に答えることもできます。純粋なWERでは上位5つに後れを取ります。Voxtral vs. Whisperの比較解説で、以前のリリースについて詳しく扱っています。
こんな用途に:WERの最後の1ポイントよりも言語モデルが重要な音声アシスタントや音声Q&A。
9. OpenAI Whisper large-v3:ベースライン
WER 7.16%、総合41位
Whisper large-v3は依然として最も広くデプロイされているオープンモデルで、ラッパー、ファインチューン、チュートリアルのエコシステムも最大です。精度では、現在このリストの他のすべてのモデルに後れを取っています。本番環境で使っているなら、上位6つのいずれかに乗り換えるのが、利用可能な中で最も安価な品質向上策です。
こんな用途に:Whisper固有のツールに依存するプロトタイプ、または打ち破るべきベースラインとして。
どれを選ぶべきか?
| あなたの用途 | 選ぶべきもの |
|---|---|
| 複数話者の会議 | Nemotron 3.5 Transcribe |
| 1回のパスで1時間のポッドキャストや通話 | Nemotron 3.5 Transcribe |
| 多言語アーカイブ | Nemotron 3.5 Transcribe |
| 小さめのGPUでの英語バッチ処理 | Qwen3-ASR-1.7B |
| 最大スループット | TheStage Whisper large-v3 turbo または Cohere Transcribe |
| エッジまたは低コストハードウェア | Parakeet TDT 0.6B |
| 音声Q&A+文字起こし | Nemotron 3.5 Transcribe または Voxtral Small |
| 既存のWhisperコードを最小限の変更で | TheStage Whisper large-v3 turbo |
ひとつ注意点:リーダーボードの平均値はドメインごとの差を隠してしまいます。Nemotronは総合で最良ですが、AMIではGraniteが上回り、LibriSpeechではいくつかのモデルが上回ります。実際に採用する前に、自分の録音50~100件で上位2~3モデルをテストしてください。
コーディングエージェントとApidog CLIで候補をベンチマークする
この比較対決を最も手早く行う方法は、コーディングエージェントに任せることです。2~3のモデルをOpenAI形式の/v1/audio/transcriptionsエンドポイントの背後で提供し(SGLang-Omniはこの方式でNemotronを提供します)、Apidog CLIを使って各モデルに対して同じチェックをエージェントに構築・実行させます。
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
そしてエージェントに1つのプロンプトを与えます:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
エージェントはスキーマを読み、ペイロードを検証し、ケースを作成して環境ごとに実行します:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
保存された文字起こしを任意のWERスクリプトで参照テキストと採点し、勝った環境の実行を-r junitでCIに組み込みます。Claude CodeでのApidog CLIとCI/CDパイプラインでのApidog CLIをご覧ください。
FAQ
最も高精度なオープンソース音声認識モデルは? NVIDIA Nemotron 3.5 Transcribeで、2026年10月28日のOpen ASR Leaderboardで平均WER 5.33%です。
Whisperはまだ使えますか? 動作はしますが、whisper-large-v3は7.16%で41位です。TheStageのlarge-v3 turboのようなチューニング済みWhisperビルドは5.91%を記録します。
どのオープンモデルが最速ですか? ここにあるモデルの中では、TheStage AIのWhisper large-v3 turboで、RTFxは1,177です。
オープンモデルは今や有料APIを上回りますか? 一部は上回ります。Nemotron 3.5 TranscribeはAssemblyAI Universal-3.5 Pro(5.39%)とOpenAI gpt-transcribe(5.96%)を上回ります。Otter、Zoom、ElevenLabsは依然として総合でリードしています。ホスト型の選択肢については、音声認識APIまとめをご覧ください。
話者ダイアリゼーションに対応しているのは? Nemotron 3.5 Transcribeは同一モデル内で最大8話者まで対応します。他のほとんどは別途ダイアリゼーションのステップが必要です。
結論
2026年後半のほとんどのチームにとって、80GB GPUを持っているか、ホスト型APIで1時間0.12ドルを支払えるなら、まずNemotron 3.5 Transcribeから始めるのが良いでしょう。GPU予算が厳しければQwen3-ASR-1.7B、ハードウェアがさらに厳しければParakeetを選んでください。どれを選ぶにせよ、自分の音声でテストし、エージェントにApidogのチェックを走らせ続けてもらい、選んだモデルがアップグレードのたびに性能を維持するようにしましょう。