要点:AIエージェントの非同期ツール呼び出し(Async Tool Calls)は、ブロッキングな1回のrun()をシンプルに分割した仕組みです。start()ですぐにジョブハンドルを返し、status()で進捗を報告し、stop()でキャンセルを実行。処理結果は後からイベントとして返され、エージェントは次のターンでそれを読み取ります。これにより、時間のかかるタスクを実行している最中でも、エージェントは対話を続け、新たな指示を受け付けられます。
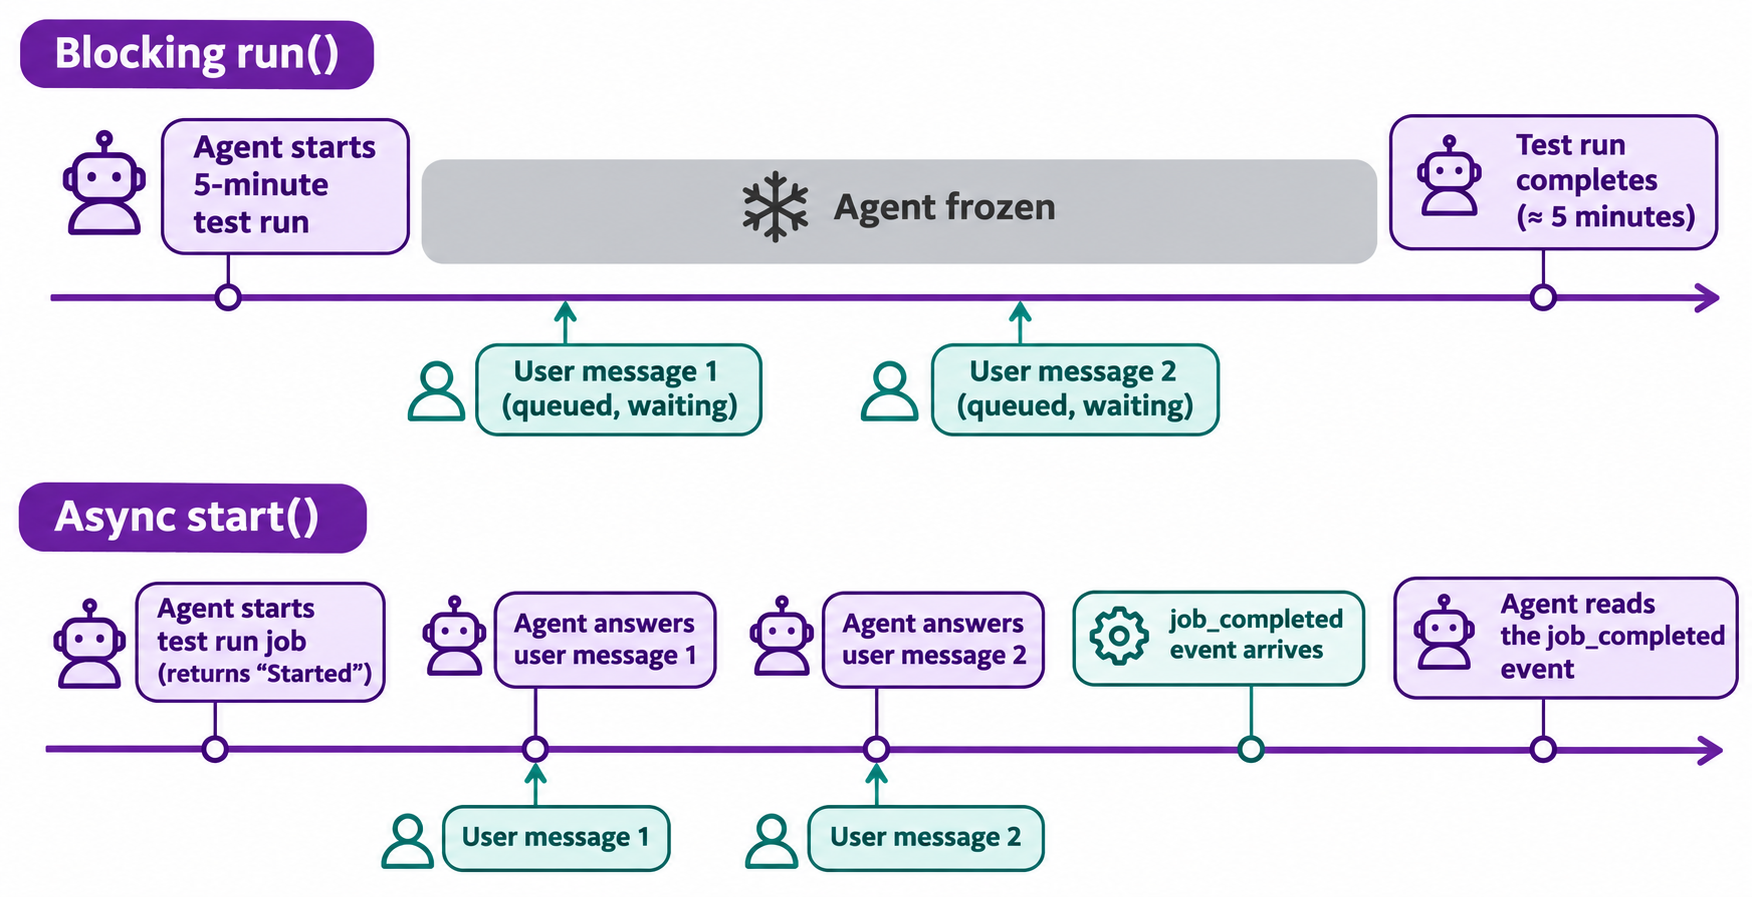
現在の多くのエージェントは、ツールを呼び出すと完了するまで待機します。6分かかるテストの実行中に別の質問を投げても、キューで待たされることになります。200ミリ秒で終わる検索なら問題ありませんが、デプロイやWebクローリングのような重いタスクでは大きなストレスになります。
DeepSeek Harnessチームが公開した最新のエッセイ「Exploring Super-agent Design(スーパーエージェント設計の探求)」では、この解決策を「全二重(full-duplex)」と呼んでいます。ブロッキングなrun()をやめ、start()とstop()に置き換えるアプローチです。本ガイドでは、ツール仕様、結果のフィードバック、キャンセル処理、各ツールに必要なAPI設計など、エージェントループ側の実装について解説します。時間のかかる単一呼び出しにおけるHTTP側の実装については、「AIエージェントと長時間実行API:ポーリング vs Webhook」をご覧ください。
エージェントループにおける非同期ツール呼び出しとは?
非同期ツール呼び出しとは、結果の代わりにハンドルを即座に返すツール実行方式です。エージェントループはハンドルを記録してターンを終了し、ユーザーからの入力待ち状態を解放します。処理が完了すると、ランタイムが完了イベントを会話履歴に注入し、モデルは次のターンで通常のメッセージと同様にそれを読み取ります。
最大の違いは「誰が待つか」です。run()ではモデルが待機しますが、start()ではランタイム側が待機します。
ブロッキング run() |
非同期 start() |
|
|---|---|---|
| 返り値 | 最終結果 | ジョブID、「Started」 |
| 処理中のエージェント | フリーズ(応答不可) | 対話、計画、追加ジョブの開始が可能 |
| 新規ユーザーメッセージ | ツールの処理完了までキューで待機 | 即座に処理 |
| キャンセル | ターン全体を強制終了 | stop(job_id) |
DeepSeekのエッセイでは、これを完成した製品機能ではなくアーキテクチャの青写真として説明しています。全二重機能はDeepSeek Harness内に実装されているもののデフォルトでは有効になっておらず、一部はdsh-superagent-prototypeというプロトタイププラグイン(著者曰くDeepSeekの公式製品ではないとのこと)に含まれています。これは参考とすべき設計パターンとして捉えるのがよいでしょう。背景については、DeepSeek Harnessの解説記事や、関連記事のスーパーエージェントの構築方法をご覧ください。
ブロッキングの課題:1つの重いツールがエージェント全体を停止させる
テストスイートの実行(5分)と、インポートエラーに関する質問への回答をコーディングエージェントに依頼した場面を想像してみてください。ブロッキングな呼び出しの場合、質問の回答にテスト結果が不要であっても、質問はテストが完了するまで待たされます。その結果、次の3つの問題が生じます。
- レイテンシの累積:実行に時間のかかるツールがあるたびに、その所要時間すべてが後続の処理の待ち時間に上乗せされます。
- 指示の陳腐化:開始2分後に「やっぱりe2eテストはスキップして」と伝えても、エージェントはテストが終わるまでその指示を認識できません。
- タイムアウトの発生:数分間にわたって接続を開いたままにするとゲートウェイによって切断されるため、バックグラウンドの処理自体は成功していても、長時間の
run()がエラーになることがあります。
エージェントに求められるこの特性を、エッセイでは「プロダクティブ(高生産的)」と呼んでいます。前の処理が終わるのを待たずに次の指示を受け付けられる状態のことです。非同期ツールを使えば、これを実現できます。
start、status、stop:非同期ツールのインターフェース仕様
時間のかかる機能ごとに、1つの巨大なツールではなく、返り値のデータ構造がコンパクトな3つのツールをモデルに提供します。
{
  "name": "start_test_run",
  "description": "Start the test suite. Returns immediately with a job_id. The result arrives later as a job_completed event; do not wait for it.",
  "input_schema": {
    "type": "object",
    "properties": {
      "suite": { "type": "string", "enum": ["unit", "e2e", "all"] },
      "idempotency_key": { "type": "string" }
    },
    "required": ["suite", "idempotency_key"]
  }
}
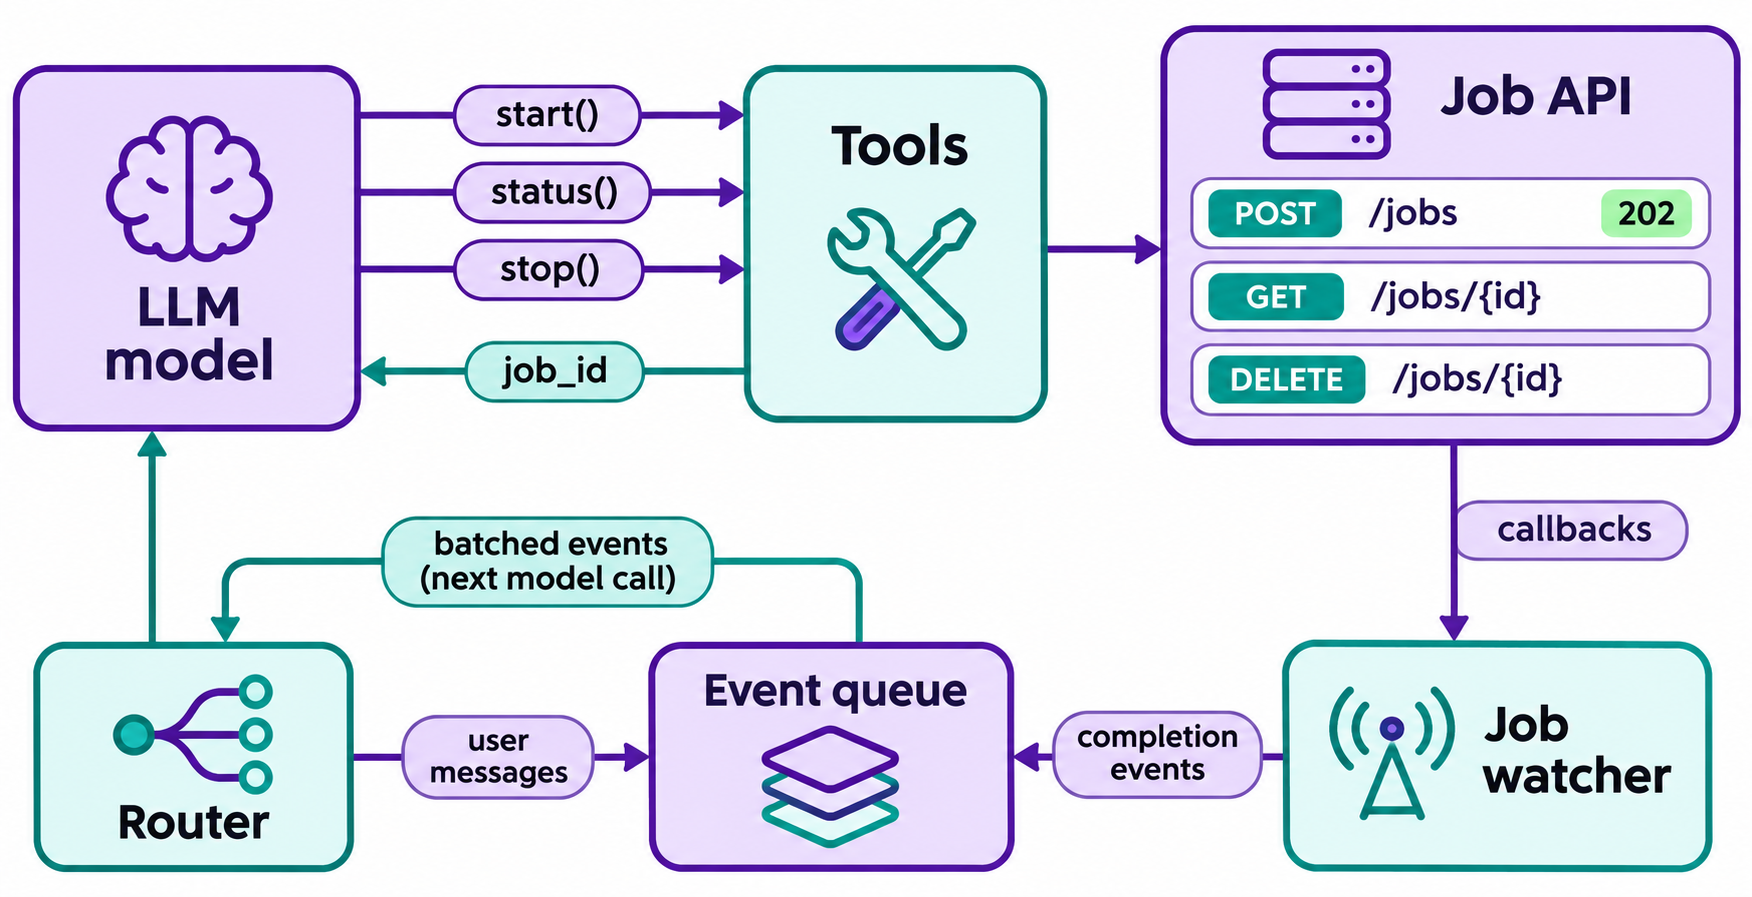
start_test_runは{"job_id": "job_8f2", "status": "queued"}のみを返します。get_job_status(job_id)は、簡単な進捗メッセージに加えてqueued、running、done、またはfailedを返します。stop_job(job_id)はキャンセルを要求し、到達したステータスを返します。
モデルを正しく動作させるための2つの鉄則があります。1つは、ツールの説明文に「待機しないこと(do not wait)」と明記することです。そうしないと、モデルはget_job_statusを小刻みにポーリングし続けてしまいます。もう1つは、startから処理結果のデータを返さないことです。返してしまうと、モデルがどの形式のレスポンスを受け取ったのか推測しなければならなくなります。
処理結果をエージェントループにフィードバックする仕組み
モデル自身によるポーリングは最終手段であり、推奨される設計ではありません。より優れたアプローチは、ランタイムがジョブを監視し、新しいメッセージとして完了イベントを会話にプッシュすることです。
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
イベントの内容は簡潔に保ち、詳細なペイロードは取得ツール経由で取得できるようにしておきます。こうすることで、4万行にも及ぶログがコンテキストを圧迫するのを防げます。
次に重要なのがバッチ処理です。DeepSeekのエッセイでは、1回のターン中に発生したトリガーを集約し、次のモデル呼び出しにまとめて組み込むルーターについて説明されています。長い入力と短い出力をプリフィル(prefill)に折り込むアプローチです。同チームの実験では、1分あたりのトリガー数が1件から40件に増加し、平均バッチサイズは1.0から2.8に拡大、1回の判断にかかる時間は6.4秒から1.6秒へと短縮されました。これらは一般的なベンチマークではなく論文内の実験値ですが、3つのイベントを個別に3回呼び出して処理するより、1回の呼び出しでまとめて処理するほうが効率的であることは明らかです。基本ルールはシンプルです。モデルの生成中はイベントとユーザーメッセージをキューに溜めておき、ターンが終了した段階で到着順にまとめて送信します。
実行順序の制御、キャンセル処理、冪等性キー
実行順序:ジョブはどのような順序で完了するかわかりません。ジョブBがジョブAに依存している場合は、ジョブAの完了イベントを受け取ってからジョブBを開始するか、API側でdepends_onを受け付けるようにして、依存関係を明示的に管理します。
キャンセル処理:stopはあくまで停止要求であり、確約ではありません。実際の最終ステータス(cancelled、あるいは先に完了していた場合はdone)を返し、モデルがそれを正確に報告できるようにします。MCPのTasks拡張機能も同様のスタンスをとっており、ドキュメントではキャンセルを協調的(cooperative)なものと位置づけているため、タスクがcancelled以外の完了ステータスに達する可能性があります。
冪等性キー:モデルは再試行を行うことがあるため、レスポンスが途切れた場合に2回目のstartが実行される恐れがあります。すべてのstartでidempotency_keyを必須とし、同じキーを受け取った場合は既存のジョブを返すようにAPIを設計します。これがないと、「マイグレーションの実行」などが誤って2度実行されるリスクがあります。
中間結果の取得:全体の完了を待つのではなく、get_job_result(job_id, cursor)などを通じて初期の出力(クロールした最初の50ページなど)を取得できるようにします。
コンテキスト肥大化の防止:完了したジョブは、モデルが処理した段階で1行のサマリーに圧縮します。
タイムアウト:各ジョブに期限を設定し、超過した場合はjob_timed_outを発行します。
バックエンドAPIに必要な要件
非同期ツールの品質は、背後にあるジョブAPIの出来栄えに左右されます。処理を受け付け、IDを返し、呼び出し元が進捗を確認できるようにする設計が必要です。RFC 9110では202 Acceptedを「リクエストは処理のために受理されたが、処理は完了していない」と定義しており、MDNの202解説ページではその実践的な使用法が説明されています。
start()ツール向け最小限のジョブAPI仕様:
| 呼び出し | レスポンス | 使用箇所 |
|---|---|---|
POST /jobs(Idempotency-Key ヘッダー付き) |
202 + {"job_id", "status":"queued"} + Location: /jobs/{id} |
start |
GET /jobs/{id} |
200 + queued, running, done または failed |
status、ジョブ監視機能 |
GET /jobs/{id}/result |
出力付き200、未完了の場合は409 |
取得ツール |
DELETE /jobs/{id} |
キャンセル要求を受け付ける202(以降の呼び出しでは404または409) |
stop |
| 任意のコールバックURL | 完了時に呼び出し元へPOST |
ジョブ監視機能 |
このコールバックにより、ランタイムはポーリングを行わずにイベントをプッシュできるようになります。どちらを採用すべきか迷った場合は、Webhook vs ポーリングでトレードオフを解説しています。また、イベント駆動型APIについてはAsyncAPIとは何かで詳しく取り上げています。
ツールがMCP(Model Context Protocol)に対応しているなら、すでに標準仕様が存在します。MCP仕様(バージョン 2026-07-28)では、オプションの拡張機能としてTasksが定義されています。サーバーはtools/callに対してtaskIdを含むCreateTaskResultで応答でき、クライアントはtasks/getをポーリング(またはnotifications/tasksを受信)し、tasks/cancelで停止を要求します。ステータスにはworking、input_required、completed、failed、cancelledがあります。クライアントとサーバーの双方が対応している必要があり、ホスト側のサポート状況も異なるため、依存する前にクライアントの対応状況を確認してください。
Apidog CLIを使ってコーディングエージェントにジョブAPIを構築・テストさせる
ジョブAPIは、エージェントを実際に動かす前に検証可能な部分です。設計とテストをコーディングエージェントに任せ、Apidog CLIを操作させましょう。プロンプトを1つ作成するだけで、エージェントが仕様の策定からテストケースの作成、実行まで行います。
セットアップはわずか3つのコマンドで完了します:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
続いて、エージェントに次のようなプロンプトを与えます:
In Apidog project <projectId>, design the job API a start() tool needs:
POST /jobs returns 202 with job_id, GET /jobs/{id} returns queued|running|done|failed,
DELETE /jobs/{id} cancels. Create the endpoints, then create test cases that assert:
202 and a job_id on create, a status that reaches done within 60 seconds,
the same job_id when the Idempotency-Key repeats, and 409 or 404 on GET result after cancel.
Run them against the staging environment <envId> and summarize failures.
エージェントはCLIから各ペイロードの構造を読み取って検証し、次のように作成とテストを実行します:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file post-jobs.json
apidog endpoint create --project <projectId> --file post-jobs.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-create-202.json
apidog test-case create --project <projectId> --file case-create-202.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
cliレポーターは各アサーションの合否をターミナルに出力し、jsonレポートはエージェントが結果を読み込んで説明するための構造化データを提供します。テストに合格したら、CI環境で-r junitを指定して同じコマンドを実行できます。Apidog CLIエージェントワークフローガイドではこの一連の流れを詳しく解説しており、Claude CodeでのApidog CLI活用法ではエージェントの設定方法を取り上げています。なお、ApidogのFreeプランは最大4ユーザーまで利用可能です。
非同期ツールを採用すべきケースと不要なケース
非同期ツールを使うべきケース:
- ツールの実行に通常数秒以上かかる場合(ビルド、テストスイート、クローリング、レンダリング、デプロイなど)。
- 処理の実行中にもユーザーがエージェントと対話する場合。
ブロッキングのままでよいケース:
- 呼び出しが1〜2秒未満で返ってくる場合。
- どのみち結果が得られなければ次のステップを開始できない場合。
- 本物のジョブAPIを用意できない場合(内部で同期的にブロックする疑似非同期ツールは、無駄に複雑さを増すだけです)。
実践的な使い分けとしては、読み取り処理はブロッキングのままにし、長時間の書き込みや重い計算処理を非同期にするのが適切です。
よくある質問(FAQ)
非同期ツール呼び出しと並列ツール呼び出しの違いは何ですか? 並列ツール呼び出し(Parallel Tool Calls)は、1回のターン内で複数のツールを同時に実行しますが、モデルはすべての処理が完了するまで待機します。一方、非同期ツール呼び出しは即座に応答を返し、後続のターンにまたがって完了するため、処理の実行中もモデルは対話を継続できます。
非同期ツールを構築するにはMCPが必須ですか? いいえ、必須ではありません。ジョブIDを返すツールと、完了イベントを注入できるランタイムがあれば機能します。MCPのTasks拡張機能(オプション)は、クライアントとサーバーの双方がサポートしている場合に、ハンドル管理、ポーリング、キャンセル処理などの標準化を提供してくれるものです。
エージェントはジョブの完了をどのように検知しますか? ランタイムがエージェントに通知します。ジョブ監視機能がジョブAPIをポーリングするかコールバックを受信し、簡潔な完了イベントを会話履歴に追加します。モデルは次のターンでそれを読み取ります。
ジョブの途中でユーザーがキャンセルした場合はどうなりますか? エージェントがstop(job_id)を呼び出し、APIがリクエストを記録して、ジョブが実際の最終ステータスを報告します。キャンセルの要求が届く前に処理が完了していた場合は、中断されたと偽るのではなく、完了したことをエージェントが正確に伝える必要があります。
DeepSeekの全二重(full-duplex)モードは設定でオンにできますか? 製品の正式機能としては提供されていません。エッセイによるとDeepSeek Harnessに実装されているもののデフォルトでは無効になっており、関連するプラグインも公式製品ではないプロトタイプとされています。参考となるリファレンス設計として活用してください。