
結論: 厳密な意味で「制限なし」のAI動画生成ツールが存在するのは、自分のハードウェア上だけです。Wan2.2、HunyuanVideo-1.5、LTX-2などのオープンウェイトモデルは、サーバー側のフィルターなしで動作します。ホスト型のサービスはすべてコンテンツポリシーを適用しています。GPUなしで誤検知による拒否を減らしたい場合は、A2Eのようなマルチモデルプラットフォームを使えば、あるモデルが無害なプロンプトを拒否したときに別のモデルに切り替えられます。
このガイドでの「制限なし」とは、クリエイティブな自由を意味します。ホラー短編、戦争シーン、スタント、医療解説動画といった正当なプロンプトが拒否される回数が少ない、ということです。露骨なコンテンツを意味するものではなく、本人の同意なく実在の人物の顔や声を使うことを許すものでもありません。これは、制限なしのAI画像生成ツールガイドの動画版です。
AI動画生成ツールにおける「制限なし」の意味
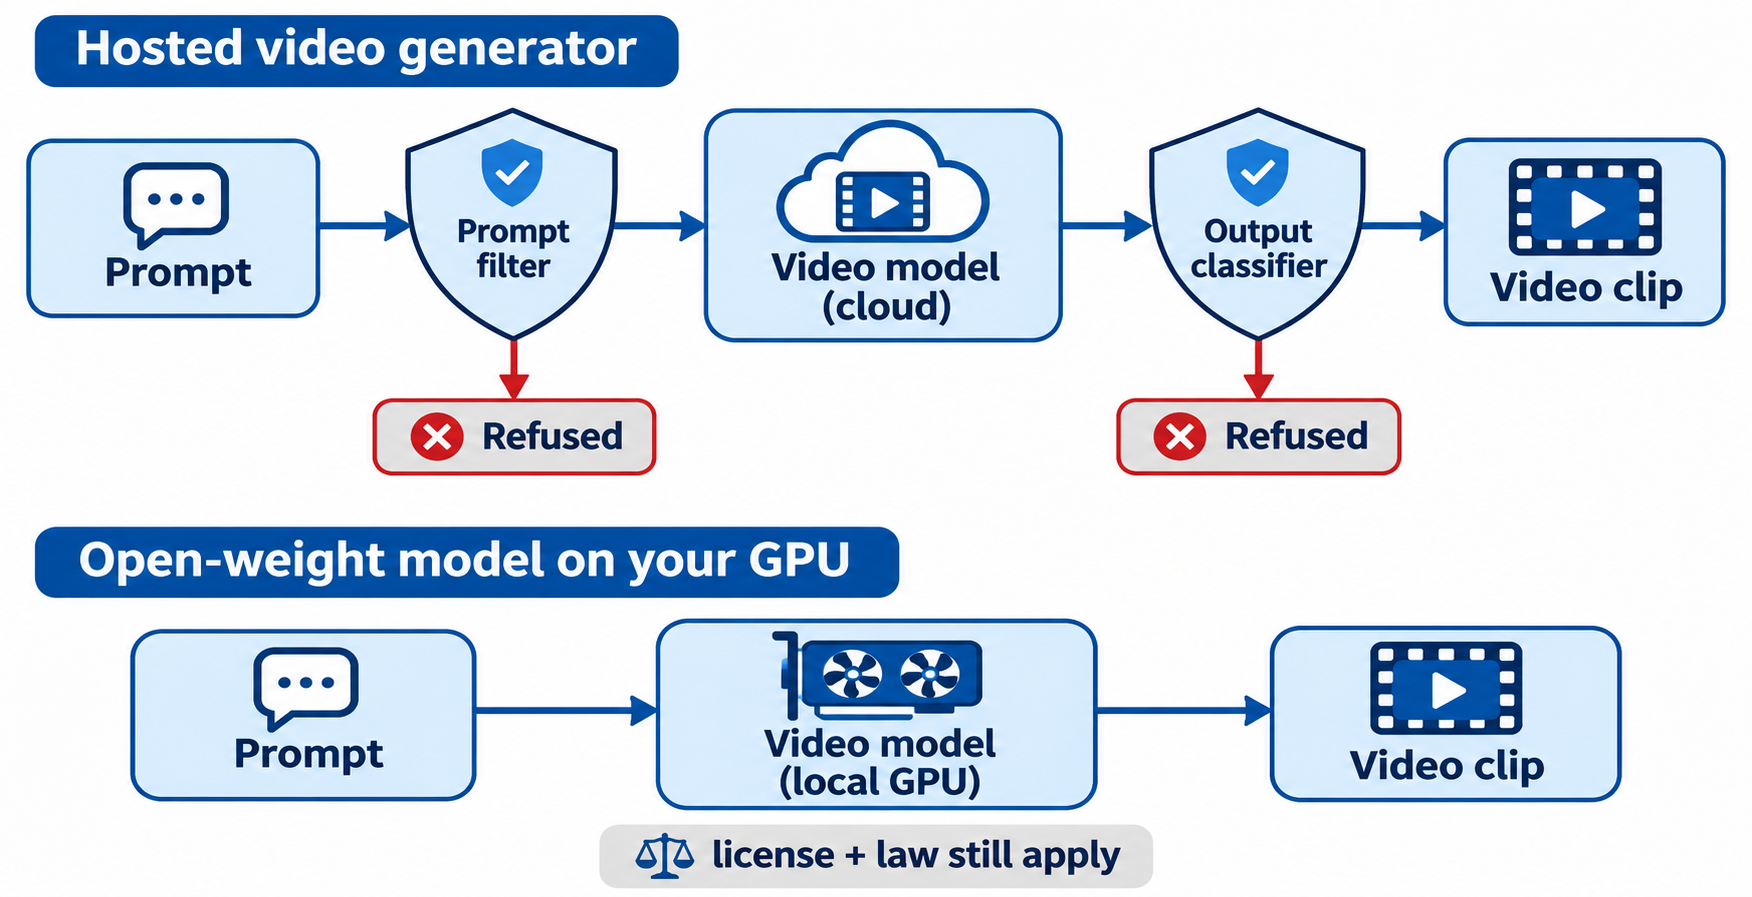
制限なしのAI動画生成ツールとは、プロバイダー側のコンテンツフィルターなしでプロンプトを実行できるものを指します。実際には、それは自分で実行するオープンウェイトモデルだけに当てはまります。ホスト型ツールはすべてフィルターをかけますが、無害なプロンプトを拒否する頻度や、ひとつのアカウントで試せるモデルの数には差があります。
ホスト型の動画生成ツールは通常、2段階でチェックします。まずプロンプトフィルターがテキストを読み取り、その後、出力分類器がクリップが返却される前にフレームを検査します。どちらも拒否の原因になり得ます。ローカルでモデルを実行すれば、この2つの層は存在しません。
制限なしのAI動画生成ツールのおすすめ: ショートリスト
主な選択肢の比較はこちらです。価格とクレジットは各公式ページから取得したもので、2026年11月13日時点で確認済みです。
| ツール | 種類 | フィルター | 無料ルート | 最適な用途 |
|---|---|---|---|---|
| A2E | ホスト型、マルチモデル | プロバイダーポリシー | 1日30クレジット、透かしあり、720p | ひとつのアカウントで多数のモデル+API |
| Kling 4.0 | ホスト型 | プロバイダーポリシー | 公式ページで確認 | 音声付きの大型モーションシーン |
| Gemini Omni Flash | ホスト型(Google) | Googleポリシー | 公式ページで確認 | ネイティブ音声付きの3〜15秒クリップ |
| Grok Imagine | ホスト型(xAI) | xAIポリシー | 有料API、秒単位の課金 | 最長15秒の短編クリップ、1.5では1080p |
| Seedance 2.5 | ホスト型(ByteDance) | ByteDanceポリシー | 公式ページで確認 | 最長30秒のシングルショット |
| Wan2.2 | オープンウェイト | 自分のマシン上ではなし | ウェイト無料 | ハイエンドGPU 1枚でローカル720p・24fps |
| HunyuanVideo-1.5 | オープンウェイト | 自分のマシン上ではなし | ウェイト無料 | 軽量なローカル実行(オフロードで14 GB) |
| LTX-2 | オープンウェイト | 自分のマシン上ではなし | ウェイト無料 | 同期音声付き動画をローカルで生成 |
1. A2E: ひとつのアカウントで多数の動画モデル
A2EはオールインワンのAI画像・動画プラットフォームです。ポリシーを無視しているからではなく、モデルの幅広さでこのリストに入っています。あるモデルが無害なプロンプトを拒否した場合、同じアカウントとクレジットで別のモデルに再実行できます。動画モデルにはSeedance 2.5、Kling 4.0、Wan 3.0、Veo 3.1、Sora 2、Grok Imagineがあり、フェイススワップ、トーキングフォト、リップシンク、ボイスクローンも利用できます。
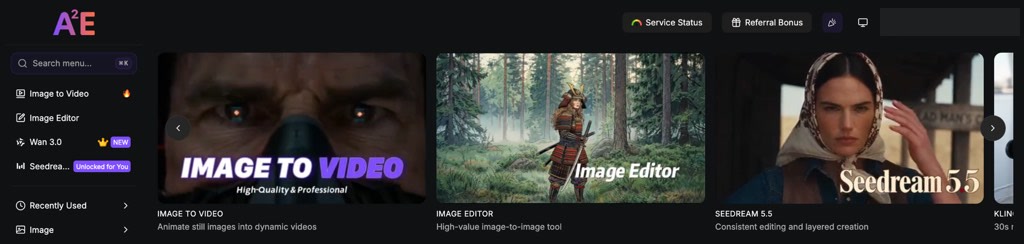
新規アカウントには無料クレジット100に加え、チェックインで毎日30クレジットが付与され、720p出力には透かしが入ります。Proプランは1か月14.9ドルで、クレジット1,500、透かしなし、APIアクセスが使えます。2026年11月13日のテストでは、A2EのV2モデルで5秒の画像から動画への変換に40クレジットを消費し、レンダリングには約2分かかりました。同じクリップへのフェイススワップはクォータ内で無料で実行でき、新しい顔が全フレームを通して維持されました。
開発者向けには、OpenAPI仕様とコーディングエージェント用のSKILL.mdが付属したREST APIがhttps://api.a2e.aiで提供されています。ジョブは非同期で、タスクを開始したら完了まで_idをポーリングします。
評価: 拒否を減らすための最も手軽なホスト型ルートです。モデルの切り替えに必要なのはドロップダウン操作であって、新しいサブスクリプションではありません。ただしA2Eの利用規約は引き続き適用され、サイトにはCSAM報告フォームへのリンクがあります。
2. Kling 4.0
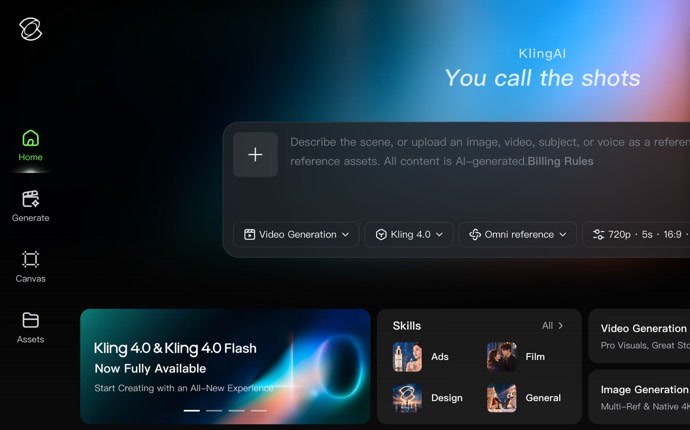
ホスト型。 Klingの公式サイトでは、Kling 4.0を映像・音声のリアリズムと安定した大型モーションシーンを売りにしています。プロンプトボックスはテキストに加えて、画像、動画、被写体、音声を参照として受け付け、720p・5秒・16:9から開始できます。周辺にはモーションコントロール、リップシンク、トーキングアバター、動画から音声の変換があり、さらにノードベースのCanvasと、バッチ処理向けのMCP・APIルートも用意されています。有料プランは6.99ドルからで、KlingはA2Eのメニューにもあります。
評価: アクション中心のクリップに最適な選択肢です。無料枠はまずkling.aiで確認しましょう。
3. Google Gemini Omni Flash(旧Veo)
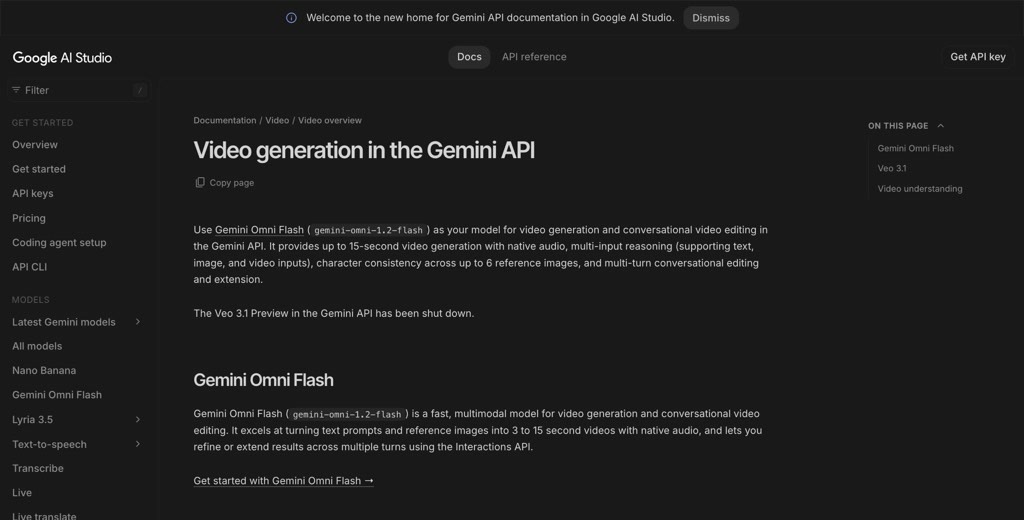
ホスト型。 Googleは2026年10月22日にGemini APIのVeo 3.1プレビューモデルを廃止し、動画ドキュメントでは開発者をGemini Omni Flash(gemini-omni-1.2-flash)に案内しています。テキスト・画像・動画の入力からネイティブ音声付きの最長15秒クリップを生成でき、最大6枚の参照画像でキャラクターの一貫性を保ち、複数ターンにわたってクリップの改善や延長が可能です。何を生成できるかはGoogleの生成AI禁止使用ポリシーが規定します。
評価: Googleのエコシステム内で高品質ですが、誤検知による拒否が最大の悩みなら最適な選択ではありません。
4. Grok Imagine
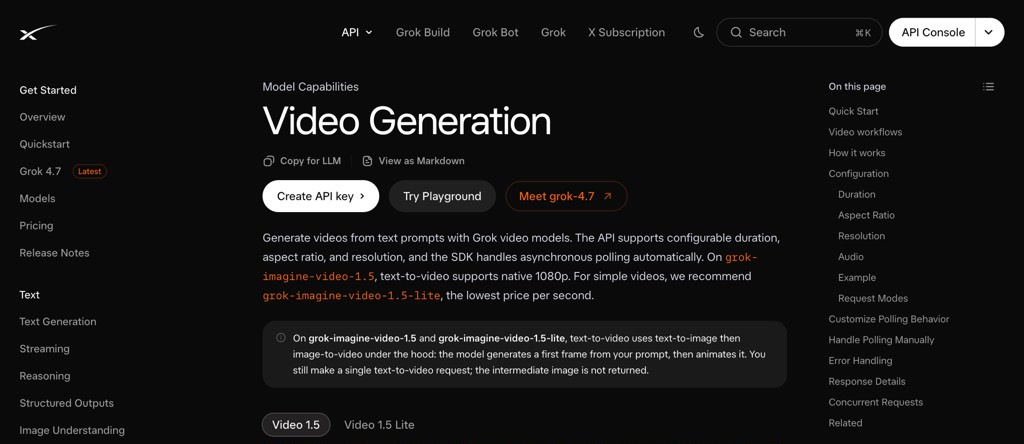
ホスト型。 xAIの動画モデルはGrokアプリとxAI APIで利用できます。grok-imagine-video-1.5ではテキストから動画への生成がネイティブ1080pで行われ、1.5-liteモデルが秒あたり最安です。クリップは1〜15秒でデフォルトで音声付き、xAIのSDKが非同期ポーリングを処理してくれます。モデレーションはアプリとAPIで同じなので、APIを使っても拒否が減ることはありませんが、各ジョブのステータスは個別に報告されます。A2Eのメニューにもあります。変更点と現状をまとめたGrok Imagine 制限なしの解説も参照してください。
評価: 高速で安価な短編クリップ向け。ただしフィルターは無害なプロンプトでも誤作動することがあります。
5. Seedance 2.5
ホスト型。 ByteDanceのSeedance 2.5は音声と動画を一緒に生成し、最大1080pでワンショット30秒のストーリーテリング向けに設計されています。参照画像30枚、動画10本、音声クリップ10個まで受け付けます。ByteDanceのアプリ、BytePlus ModelArk API、サードパーティのホスト(A2Eを含む)から利用可能です。どのルートでも、参照画像内の実在の人間の顔はブロックされます。フィルターに誤って引っかかりやすい言葉遣いについては、コンテンツフラグを避けるSeedance 2プロンプトのガイドを参照してください。
評価: 実在の顔を使わない限り、長いシングルショットに最適な選択肢です。
6. Wan2.2
オープンウェイト、ローカル実行。 Wan2.2はApache 2.0ライセンスで、テキストから動画、画像から動画、音声から動画のモデルを提供しています。Mixture-of-Experts設計を採用し、Wan2.1より65.6%多くの画像、83.2%多くの動画で学習されています。TI2V-5Bモデルは720p・24fpsでテキストと画像の両方から動画を生成でき、READMEではRTX 4090などのコンシューマーカードで動作するとされています。別のAnimate-14Bモデルがキャラクターアニメーションと置換を担当します。
評価: ハイエンドGPUが1枚あるなら、ローカル実行の最有力の出発点です。
7. HunyuanVideo-1.5
オープンウェイト、ローカル実行。 HunyuanVideo-1.5は、コンシューマーGPUで動作するよう設計された83億パラメータのテキストから動画・画像から動画のモデルです。READMEでは、モデルオフロードを有効にした場合の最小GPUメモリが14 GBとされ、ステップ蒸留された480pの画像から動画へのモデルはRTX 4090 1枚で約75秒にクリップをレンダリングできます。学習コードとLoRAチューニングスクリプトも公開されています。Tencent独自のコミュニティライセンスで提供されているため、商用利用の前にライセンスを確認してください。
評価: ライセンスが用途に合えば、最も軽量なローカルオプションです。
8. LTX-2
オープンウェイト、ローカル実行。 LightricksのLTX-2は、同期音声付き動画をひとつのモデルで生成し、複数のパフォーマンスモードを備えています。コードはApache 2.0ですが、ウェイトにはREADMEに記載された独自のモデルライセンスが適用され、Hugging Faceではダウンロード前に規約への同意が求められます。現在のクイックスタートでは約66 GiBのLTX-2.5ウェイトを取得するため、ディスク容量に注意してください。GPUメモリが不足している場合のfp8量子化とオフロードに対応し、リポジトリにはLoRAトレーナーも含まれています。
評価: 同じパスで音声も必要な場合のローカル向け選択肢です。
これら3つのオープンウェイトモデルすべてに共通するフロントエンドはComfyUIです。ウェイトを読み込み、ワークフローを組み立て、オフラインで生成します。プロバイダーのフィルターがない代わりに、ハードウェアとセットアップの手間がかかります。
ホスト型ツールでの誤検知による拒否を減らす方法
正当なプロンプトに対する拒否のほとんどは、意図ではなく言葉遣いが原因です:
- ショットを文字どおりに描写する。 「A chef slices onions with a large knife(シェフが大きな包丁で玉ねぎを切る)」は、暴力的な動詞を使ったプロンプトより効果的です。
- 実名を使わない。 ほとんどのプロバイダーは公人の名前を含むプロンプトをブロックします。それは正当な理由によるものです。
- 自分の画像から始める。 モデルに明確で、同意を得た被写体を与えられます。
- ネガティブプロンプトを使うことで、グロテスクな描写、ぼやけ、歪みを排除します。
- モデルを切り替える。 あるモデルが拒否したプロンプトは、別のモデルでは通ることがよくあります。
Apidog CLIでコーディングエージェントにA2E APIをテストさせる
動画APIで厄介なのは、failedで返ってくる非同期ジョブや、UIが対応していない拒否レスポンスです。こうしたチェックの作成と実行は、Apidog CLIでコーディングエージェントに任せましょう。
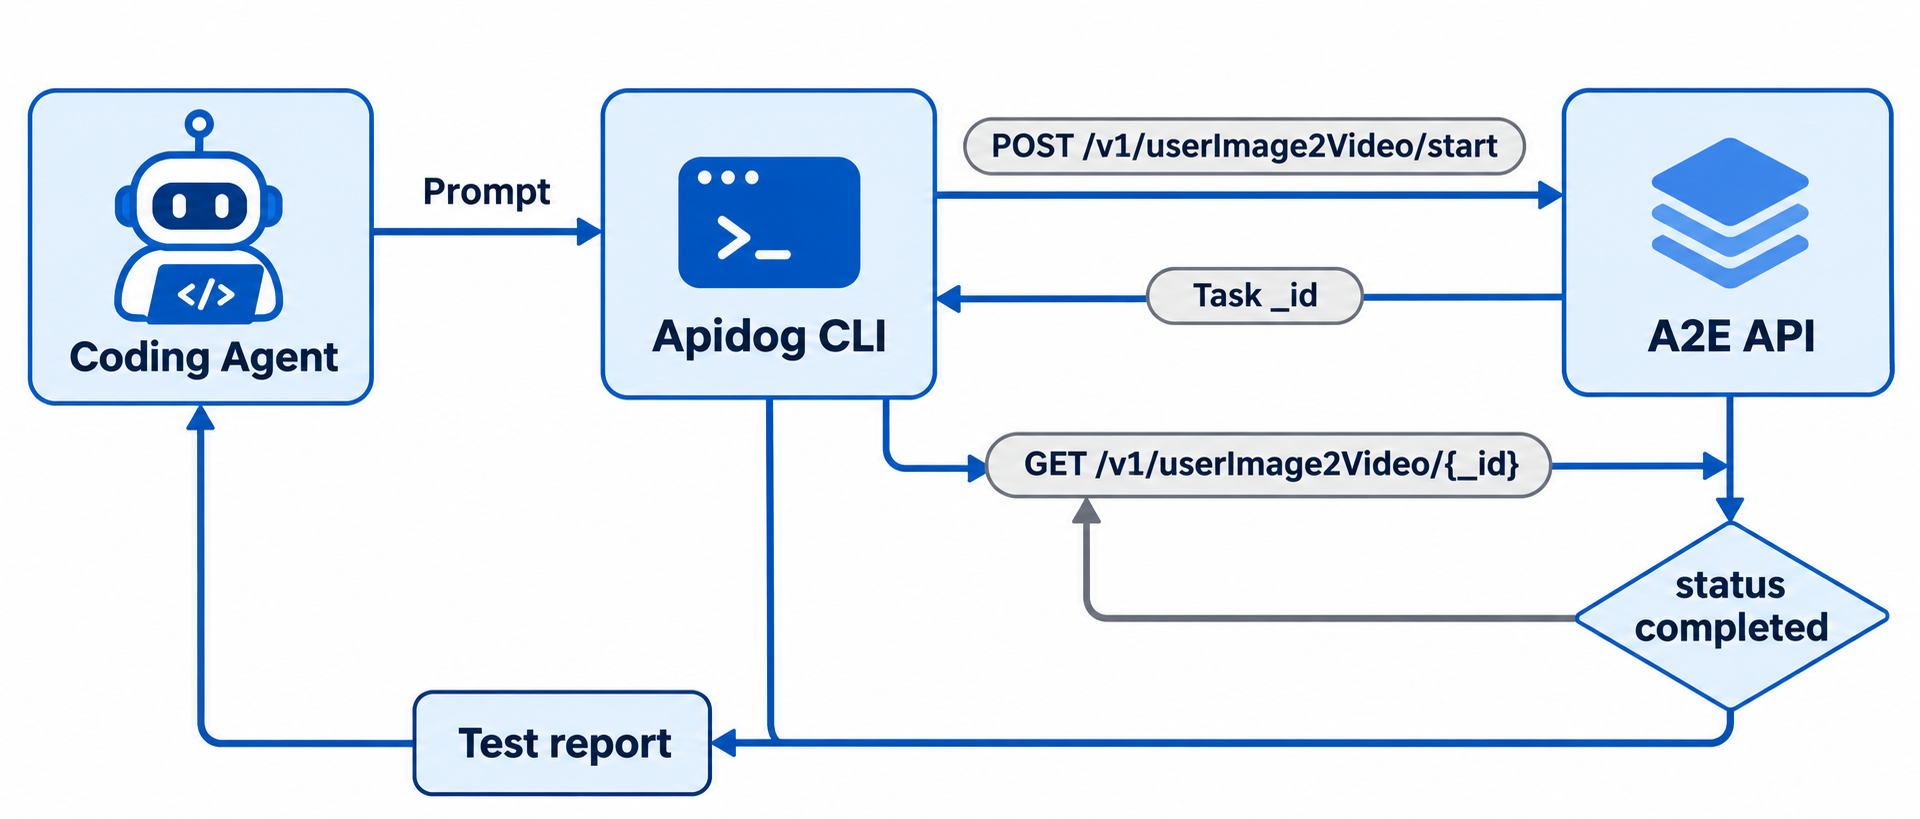
まず一度だけセットアップします:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
次に、エージェント(Claude Code、Codex、Cursor、OpenCode)にこのプロンプトを1つ渡します:
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
実際の実行ではA2Eクレジットを消費するため、failed状態に対するモック期待値をエージェントに追加させ(apidog cli-schema get mock-create、その後apidog mock create)、それに対してエラーハンドリングをテストしましょう。CIでは、apidog run --test-case <caseId> -r junitでJUnitレポートが得られます。詳細はCI/CDパイプラインでのApidog CLIを参照してください。
どのAI動画生成ツールを選ぶべきか
- プロバイダーのフィルターなし、14 GB以上のGPU: ComfyUIでHunyuanVideo-1.5かWan2.2 TI2V-5B。
- ひとつのローカルモデルで音声と動画: LTX-2。
- ひとつのアカウントで多数のホスト型モデル: A2E。
- アクション中心のクリップ: Kling 4.0。
- 長いシングルショット: Seedance 2.5。
- 製品開発: A2EのAPI+非同期ジョブのライフサイクルに対するApidog CLIテスト。
FAQ
本当に制限なしのAI動画生成ツールは存在する?
自分で実行するオープンウェイトモデル、たとえばWan2.2、HunyuanVideo-1.5、LTX-2だけです。プロバイダー側のフィルターはありません。ただし各ライセンスと現地の法律は引き続き適用され、ホスト型サービスはすべて何らかのコンテンツポリシーを適用しています。
A2Eは無料で使える?
A2Eには0ドルのFreeプランがあり、チェックインで毎日30ボーナスクレジット、透かしあり、720p出力が利用できます。APIアクセスは1か月14.9ドルのProプランからです。
AI動画生成ツールが無害なプロンプトを拒否するのはなぜ?
プロンプトフィルターと出力分類器は、無害なシーンでも、暴力や実在の人物に関連する単語に反応します。ショットを文字どおりに描写し、別のモデルも試してみてください。
画像から動画はテキストから動画より拒否されにくい?
多くの場合はそうです。自分の画像がモデルに明確な被写体を与えるからです。ただし出力分類器はフレームをチェックするため、保証はありません。