
Gemini 3.7 Flash es el modelo de IA "caballo de batalla" más reciente de Google, lanzado el 13 de agosto de 2026, tres semanas después de Gemini 3.6 Flash. Mantiene la ventana de contexto de 1M de tokens y la entrada multimodal de su predecesor, al mismo tiempo que presenta grandes avances en los puntos de referencia de codificación y agentes, y se lanza con un precio de API introductorio de $0.75 por cada 1M de tokens de entrada. Google lo llama "nuestro modelo de IA de uso general más inteligente".
Esa brecha de tres semanas entre lanzamientos es la clave. Google está lanzando actualizaciones de Flash con una cadencia rápida mientras que Gemini 3.5 Pro sigue retrasado, lo que significa que el modelo de nivel medio es ahora donde la ingeniería interesante aterriza primero. Las diferencias en los puntos de referencia lo respaldan: DeepSWE salta 16 puntos, AutomationBench casi se duplica y el precio de lanzamiento introductorio reduce a la mitad la tarifa de lanzamiento de 3.6 Flash.
Esta publicación cubre todo lo que cambió: la tabla completa de puntos de referencia que Google dispersó en su anuncio, las ventanas de precios que debes tener en cuenta, todos los lugares donde puedes acceder al modelo hoy y una solicitud cURL funcional que puedes ejecutar en cinco minutos. Si deseas una descripción más detallada del endpoint, el inicio rápido de la API de Gemini 3.7 Flash se combina con esta explicación, y Apidog te ofrece un espacio de trabajo para probar el nuevo modelo con tus prompts existentes antes de comprometerte con un cambio.
En resumen
- Gemini 3.7 Flash se lanzó el 13 de agosto de 2026, tres semanas después de 3.6 Flash. ID del modelo:
gemini-3.7-flash. - Los puntos de referencia de codificación y agentes mejoraron significativamente: DeepSWE v1.1 del 49.0% al 65.3%, AutomationBench del 17.0% al 30.4%, WebDev Arena Elo de 1538 a 1588.
- El precio introductorio de la API es de $0.75 por 1M de tokens de entrada y $3.75 por 1M de salida, la mitad del precio de lanzamiento de 3.6 Flash. Las tarifas estándar ($1.50 / $7.50) comienzan el 1 de enero de 2027.
- Las especificaciones se mantienen estables: contexto de entrada de 1M de tokens, límite de salida de 64k, entrada multimodal (texto, imagen, video, audio, PDF), llamada a funciones, búsqueda como herramienta y uso de computadora.
- Disponible ahora en la API de Gemini, AI Studio, la aplicación Gemini, Gemini Spark, Google Antigravity, Android Studio y Gemini Enterprise, en más de 160 países.
- Gemini 3.5 Pro sigue retrasado; Google está lanzando mejoras de Flash antes de su próximo modelo insignia.
Qué es Gemini 3.7 Flash
Flash es el nivel medio de la línea Gemini: más barato y rápido que Pro, más inteligente que Flash-Lite, y optimizado para las cargas de trabajo de alto volumen que constituyen la mayor parte del tráfico de IA en producción. Gemini 3.7 Flash es el tercer lanzamiento de Flash en la línea 3.x, y el enfoque de Google ha cambiado con él. El anuncio oficial lo posiciona como un modelo de codificación y agente primero, y un modelo de chat en segundo lugar.
La hoja de especificaciones se mantiene desde 3.6 Flash:
- Contexto: ventana de entrada de 1M de tokens, límite de salida de 64k tokens.
- Modalidades de entrada: texto, imagen, video, audio y PDF. La salida es texto.
- Herramientas: llamada a funciones, búsqueda como herramienta y uso de computadora.
- Seguridad: se incluyen salvaguardas CBRN y cibernéticas actualizadas con el lanzamiento.
Lo que cambió es el comportamiento, no la arquitectura. Google afirma que 3.7 Flash depura mejor, genera código listo para producción que se puede implementar al primer intento con mayor frecuencia, se adapta cuando encuentra obstáculos, hace preguntas aclaratorias cuando la intención es ambigua y sigue las instrucciones con mayor fidelidad. Esas son las afirmaciones. Los puntos de referencia a continuación son la evidencia.
Mejoras en los puntos de referencia: 3.6 vs 3.7
Google distribuyó estos números en una publicación de blog y una tarjeta de modelo. Aquí están en una sola tabla, con las diferencias importantes:
| Punto de referencia | Gemini 3.6 Flash | Gemini 3.7 Flash | Cambio |
|---|---|---|---|
| DeepSWE v1.1 (codificación agéntica) | 49.0% | 65.3% | +16.3 pts |
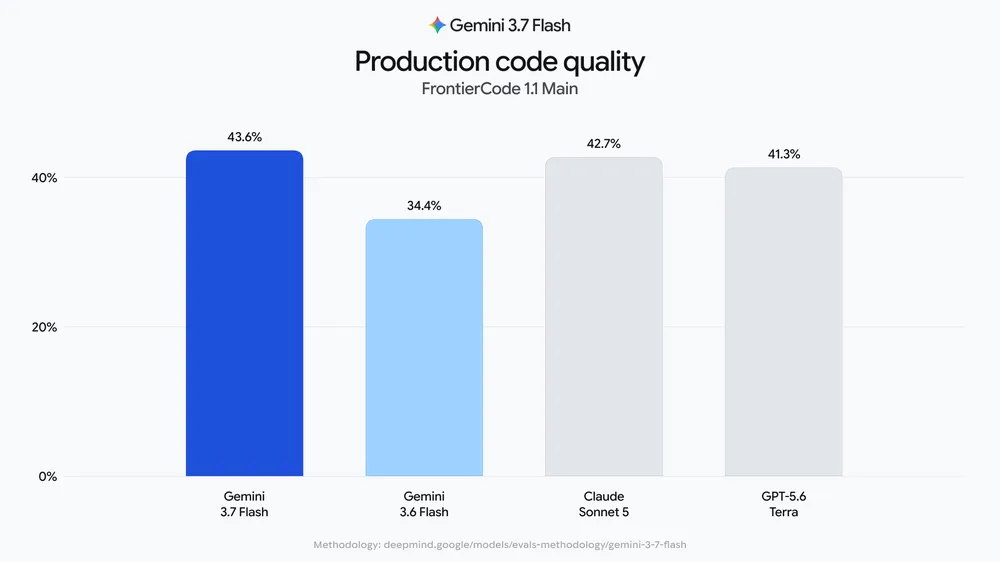
| FrontierCode 1.1 Main | 34.4% | 43.6% | +9.2 pts |
| WebDev Arena (Elo) | 1538 | 1588 | +50 Elo |
| GDP.pdf (razonamiento documental) | 22.0% | 34.0% | +12.0 pts |
| AutomationBench (tareas de agente) | 17.0% | 30.4% | +13.4 pts |
Dos puntuaciones independientes completan el panorama: 90.7% en Harvey LAB-AA, un punto de referencia de razonamiento legal, y 97.0% en la recuperación de contexto largo de 128k-needle. Ese segundo número es importante si alimentas al modelo con documentos largos; la calidad de recuperación en profundidad es donde muchos modelos fallan silenciosamente.
El patrón en la tabla es consistente. Los mayores saltos se producen en los puntos de referencia agénticos, los que miden el trabajo de varios pasos en lugar de respuestas únicas. Que AutomationBench pase del 17.0% al 30.4% es el tipo de delta que cambia las tareas que puedes delegar a un modelo de nivel medio. La cobertura del lanzamiento destacó la mejora de DeepSWE como el resultado principal, y con buena razón: un salto de 16 puntos en la codificación agéntica en tres semanas es inusual para cualquier línea de modelos. Para contextualizar cómo se traducen las diferencias de los puntos de referencia entre modelos competidores, la comparación de Grok 4.6 vs GPT 5.6 vs Claude muestra cómo brechas similares se manifiestan en cargas de trabajo reales.
Mejoras en codificación y agentes
La tabla de puntos de referencia te dice qué mejoró. Las notas de lanzamiento de Google te dicen cómo se manifiesta en la práctica, y las afirmaciones son lo suficientemente específicas como para probarlas:
- Depuración. El modelo es mejor para localizar la causa de un fallo en lugar de parchear los síntomas. La mejora de DeepSWE es el número de apoyo aquí, ya que ese punto de referencia evalúa las correcciones de errores de varios archivos en repositorios reales.
- Código desplegable al primer intento. Google afirma que más código generado se ejecuta sin una ronda de corrección. La mejora de 9.2 puntos de FrontierCode es la medida pública más cercana.
- Manejo de obstáculos. Cuando una llamada a una herramienta falla o falta un archivo, 3.7 Flash adapta su plan en lugar de entrar en un bucle. Este es el comportamiento que AutomationBench enfatiza.
- Aclaración de intenciones. El modelo hace una pregunta cuando la solicitud es ambigua en lugar de adivinar. En un pipeline de agentes, una aclaración es más barata que una respuesta incorrecta de 5,000 tokens.
- Fidelidad de las instrucciones. Las solicitudes de formato de salida, los límites de longitud y las restricciones negativas se mantienen de forma más fiable en conversaciones largas.
El conjunto de herramientas es tan importante como las puntuaciones brutas. La llamada a funciones y la búsqueda como herramienta se mantienen desde 3.6, y el soporte para el uso de computadoras significa que el modelo puede manejar un navegador cuando no existe una API para la tarea. Esa última capacidad se encuentra en un lugar peculiar para los desarrolladores: potente, pero más lenta y menos determinista que un endpoint estructurado. El análisis de uso de computadora vs APIs estructuradas cubre cuándo cada enfoque vale la pena.
Precios: a mitad de precio hasta el 31 de diciembre de 2026
Gemini 3.7 Flash se lanza con un calendario de precios de dos fases en la API de Gemini:
| Período | Entrada (por 1M de tokens) | Salida (por 1M de tokens) |
|---|---|---|
| Hasta el 31 de diciembre de 2026 | $0.75 | $3.75 |
| A partir del 1 de enero de 2027 | $1.50 | $7.50 |
La tarifa introductoria es la mitad de lo que costó Gemini 3.6 Flash en su lanzamiento, lo que convierte los próximos cuatro meses y medio en la ventana más económica que esta familia de modelos ha tenido. El inconveniente es la duplicación del precio el 1 de enero. Si construyes un presupuesto basado en tokens de entrada de $0.75, ese presupuesto se romperá en cinco meses a menos que lo planifiques ahora.
Dos conclusiones prácticas. Primero, verifica las tarifas actuales en la página oficial de precios antes de lanzar cualquier cosa; las ventanas de introducción han cambiado antes. Segundo, modela tus costos de 2027 con la tarifa estándar, no con la tarifa promocional. Los ejemplos completos, incluyendo el cálculo de tokens para chatbots, pipelines de documentos y bucles de agentes, se encuentran en el análisis de precios de Gemini 3.7 Flash.
Dónde puedes usarlo hoy
Google lanzó 3.7 Flash en toda su superficie desde el primer día, en más de 160 países:
- API de Gemini. La ruta para desarrolladores. Obtén una clave de AI Studio y llama directamente a
gemini-3.7-flash. - Google AI Studio. Entorno de pruebas basado en navegador para testear prompts antes de escribir código.
- Aplicación Gemini. La aplicación de chat para consumidores adoptó el nuevo modelo en su lanzamiento.
- Gemini Spark. Disponible para suscriptores de AI Pro y Ultra.
- Google Antigravity. El entorno de desarrollo agéntico de Google se ejecuta sobre él.
- Android Studio. La integración del IDE obtiene el modelo para asistencia de código.
- Gemini Enterprise. La oferta gestionada para organizaciones con requisitos de cumplimiento.
Para el acceso a la API a gran escala, también tienes la ruta de Vertex AI en aiplatform.googleapis.com con OAuth, IAM y registro de auditoría. Mismo modelo, mismo esquema de solicitud, diferentes garantías de autenticación y alojamiento.
Por qué Google lanzó Flash antes que Gemini 3.5 Pro
El orden de lanzamiento es inusual. Los modelos insignia normalmente lideran y los niveles más baratos siguen. Google invirtió eso: 3.6 Flash a finales de julio, 3.7 Flash tres semanas después, y Gemini 3.5 Pro todavía sin fecha. Axios informa que Google está lanzando deliberadamente actualizaciones de Flash antes de su próximo modelo insignia mientras Pro permanece retrasado.
Visto como estrategia más que como un desliz en el calendario, el movimiento tiene sentido. La mayor parte del tráfico de producción se ejecuta en modelos de nivel medio porque es donde el costo por token se encuentra con una calidad aceptable. Mejorar Flash mejora el modelo que la mayoría de los clientes utilizan a diario. También mantiene a Google en la conversación del ciclo de lanzamientos durante un período en el que cada laboratorio importante está lanzando rápido, sin quemar el anuncio del modelo insignia.
Para los desarrolladores, la consecuencia práctica es que el nivel Flash ya no es el rezagado. Las capacidades de agente están llegando aquí primero. Si pospusiste mover cargas de trabajo de 3.6 porque estabas esperando a Pro, la guía de migración de 3.6 a 3.7 Flash cubre el cambio, que para la mayoría de los códigos es un cambio de una línea en el ID del modelo más una pasada de regresión.
Cómo probar la API en cinco minutos
Necesitas una clave API de AI Studio. Crea una, expórtala y envía tu primera solicitud:
export GEMINI_API_KEY="AIza..."

curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.7-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{
      "parts": [{ "text": "Review this function for bugs: def dedupe(items): return list(set(items))" }]
    }],
    "generationConfig": {
      "temperature": 0.4,
      "maxOutputTokens": 1024
    }
  }'
La respuesta se presenta como un array candidates con el texto generado en content.parts, más un bloque usageMetadata que informa los recuentos exactos de tokens de entrada y salida. Vigila ese bloque desde el primer día; es tu medidor de costos. Para streaming, cambia :generateContent por :streamGenerateContent?alt=sse y la API devolverá eventos enviados por el servidor.
Una vez que la primera llamada funcione, lleva la experimentación fuera de tu terminal. En Apidog, importa la especificación de la API de lenguaje generativo, enlaza GEMINI_API_KEY al encabezado x-goog-api-key como una variable de entorno y guarda el ID del modelo como una variable de ruta. Ahora puedes volver a ejecutar el mismo prompt contra gemini-3.6-flash y gemini-3.7-flash lado a lado, ver cómo se renderizan los flujos SSE en vivo y guardar las respuestas como ejemplos para que las comprobaciones de regresión no consuman tokens. Es la forma más rápida de verificar la afirmación de Google de "mejor seguimiento de instrucciones" con tus propios prompts en lugar de fiarte de la palabra de la publicación de lanzamiento.
Preguntas frecuentes
¿Es Gemini 3.7 Flash de uso gratuito?
La API de Gemini tiene un nivel gratuito a través de AI Studio con una cuota diaria, que cubre la creación de prototipos. El uso de pago comienza con la tarifa introductoria de $0.75 por 1M de tokens de entrada hasta el 31 de diciembre de 2026. Si quieres ampliar aún más la cuota gratuita, la guía para el acceso gratuito a la API de Gemini cubre los límites y cómo trabajar dentro de ellos.
¿Cuál es la diferencia entre Gemini 3.6 Flash y 3.7 Flash?
Mismas especificaciones, mejor comportamiento. La ventana de contexto, el límite de salida, las modalidades y el soporte de herramientas no han cambiado. Las mejoras se observan en los puntos de referencia de codificación y agentes: DeepSWE sube 16.3 puntos, AutomationBench sube 13.4 puntos, WebDev Arena sube 50 Elo. Google también afirma una mejor depuración, seguimiento de instrucciones y planificación de múltiples pasos.
¿Gemini 3.7 Flash reemplaza a Gemini 3.5 Pro?
No. Pro sigue siendo el nivel insignia para las tareas de razonamiento más difíciles, y Gemini 3.5 Pro todavía está en desarrollo. Flash 3.7 es el modelo que Google recomienda para trabajos de producción de alto volumen donde el costo y la latencia importan tanto como la calidad.
¿Qué ocurre con los precios el 1 de enero de 2027?
La tarifa introductoria finaliza y entra en vigor la tarificación estándar: $1.50 por 1M de tokens de entrada y $7.50 por 1M de tokens de salida, el doble de la tarifa de lanzamiento. Presupuesta con la tarifa estándar para cualquier carga de trabajo que supere el año 2026.
¿Puede Gemini 3.7 Flash procesar imágenes y PDFs?
Sí. Las modalidades de entrada cubren texto, imagen, video, audio y PDF en el mismo array contents. La salida es solo texto. La puntuación de referencia de GDP.pdf del 34.0%, frente al 22.0%, es la evidencia de Google de que la comprensión de documentos mejoró junto con las ganancias en codificación.
Dónde encaja 3.7 Flash en tu pila
Gemini 3.7 Flash es un modelo de nivel medio con puntuaciones de referencia de nivel de agente y un descuento de precios de cuatro meses. Esa combinación hace que la decisión no sea tanto si evaluarlo, sino cuán rápido. Las mejoras agénticas son números reales en puntos de referencia públicos, las especificaciones coinciden con lo que ejecutas hoy en 3.6, y el precio introductorio significa que probarlo ahora cuesta la mitad de lo que costará la misma evaluación en enero.
La secuencia sensata: ejecuta tu suite de prompts existente contra gemini-3.7-flash, compara las salidas y el uso de tokens con tu modelo actual, y deja que los resultados elijan al ganador. Descarga Apidog para ejecutar esa comparación en un solo espacio de trabajo; guarda tus respuestas de 3.6 como ejemplos, reproduce las mismas solicitudes contra 3.7, y sabrás en una tarde si la historia de los benchmarks se mantiene para tu carga de trabajo.