
REA, abreviatura de Reverse Engineer Anything, es un servidor MCP y una CLI de código abierto que proporcionan a un agente de programación las herramientas para desmontar software sin su código fuente. Apunta a Claude Code, Codex, Cursor u otro agente hacia un binario nativo, una aplicación Electron, un ensamblado .NET, un APK de Android, un sitio web o una captura de red guardada, pregunta cómo funciona una función y REA devuelve pseudocódigo, gráficos de módulos, registros de solicitudes y la evidencia detrás de cada afirmación. Después, el agente explica el comportamiento o lo reconstruye.
El repositorio morluto/rea se creó en abril de 2026 y permaneció casi inadvertido hasta la primera semana de octubre. El 12 de octubre ya había superado las 115.000 estrellas y los 25.000 forks, una de las subidas más rápidas que GitHub ha visto. Esta guía cubre qué hace REA, cómo instalarlo, dónde es fuerte, dónde el bombo supera la realidad y la parte que la mayoría de la cobertura omite: REA lee capturas HAR y mitmproxy, lo que lo convierte en un front end para la ingeniería inversa de APIs que puedes terminar en Apidog.
Los números detrás del bombo
El seguimiento diario de Trendshift muestra la forma del pico. REA apareció por primera vez en la lista de tendencias el 4 de octubre con unas 1.400 estrellas nuevas en un día. Después creció de forma compuesta durante una semana.
| Fecha | Nuevas estrellas ese día |
|---|---|
| 4 oct. | 1.373 |
| 7 oct. | 5.602 |
| 9 oct. | 19.375 |
| 10 oct. | 26.572 |
| 11 oct. | 31.255 |
El repositorio mantuvo el primer puesto en GitHub Trending durante cinco de los siete días del 6 al 12 de octubre. Las versiones siguieron el mismo ritmo: la 3.2 llegó el 3 de octubre, la 4.0 el 5, la 5.0 el 7, la 6.0 el 8 y de la 6.1 a la 6.4 entre el 9 y el 11 de octubre. Ese ritmo importa para quien lo adopta, y volveremos a ello.
Ningún tuit ni publicación de lanzamiento explica el salto por sí solo. El argumento hizo el trabajo: “Ve una función que te gusta. Entiende cómo funciona, hasta el nivel del binario”. Los vídeos de agentes reconstruyendo aplicaciones de escritorio desde sus binarios se difundieron rápido, junto con las afirmaciones habituales de que el software está acabado. La lectura más útil es más estrecha. REA es un conector bien empaquetado entre agentes y herramientas de ingeniería inversa que ya existían.
Qué hace REA
REA se ejecuta como un servidor MCP local. Tu agente llama a sus herramientas, REA inspecciona el objetivo con el motor adecuado y el agente recibe hallazgos estructurados junto con sus limitaciones e incógnitas. Los mismos flujos de trabajo están disponibles como comandos CLI, así puedes automatizarlos sin ningún agente.
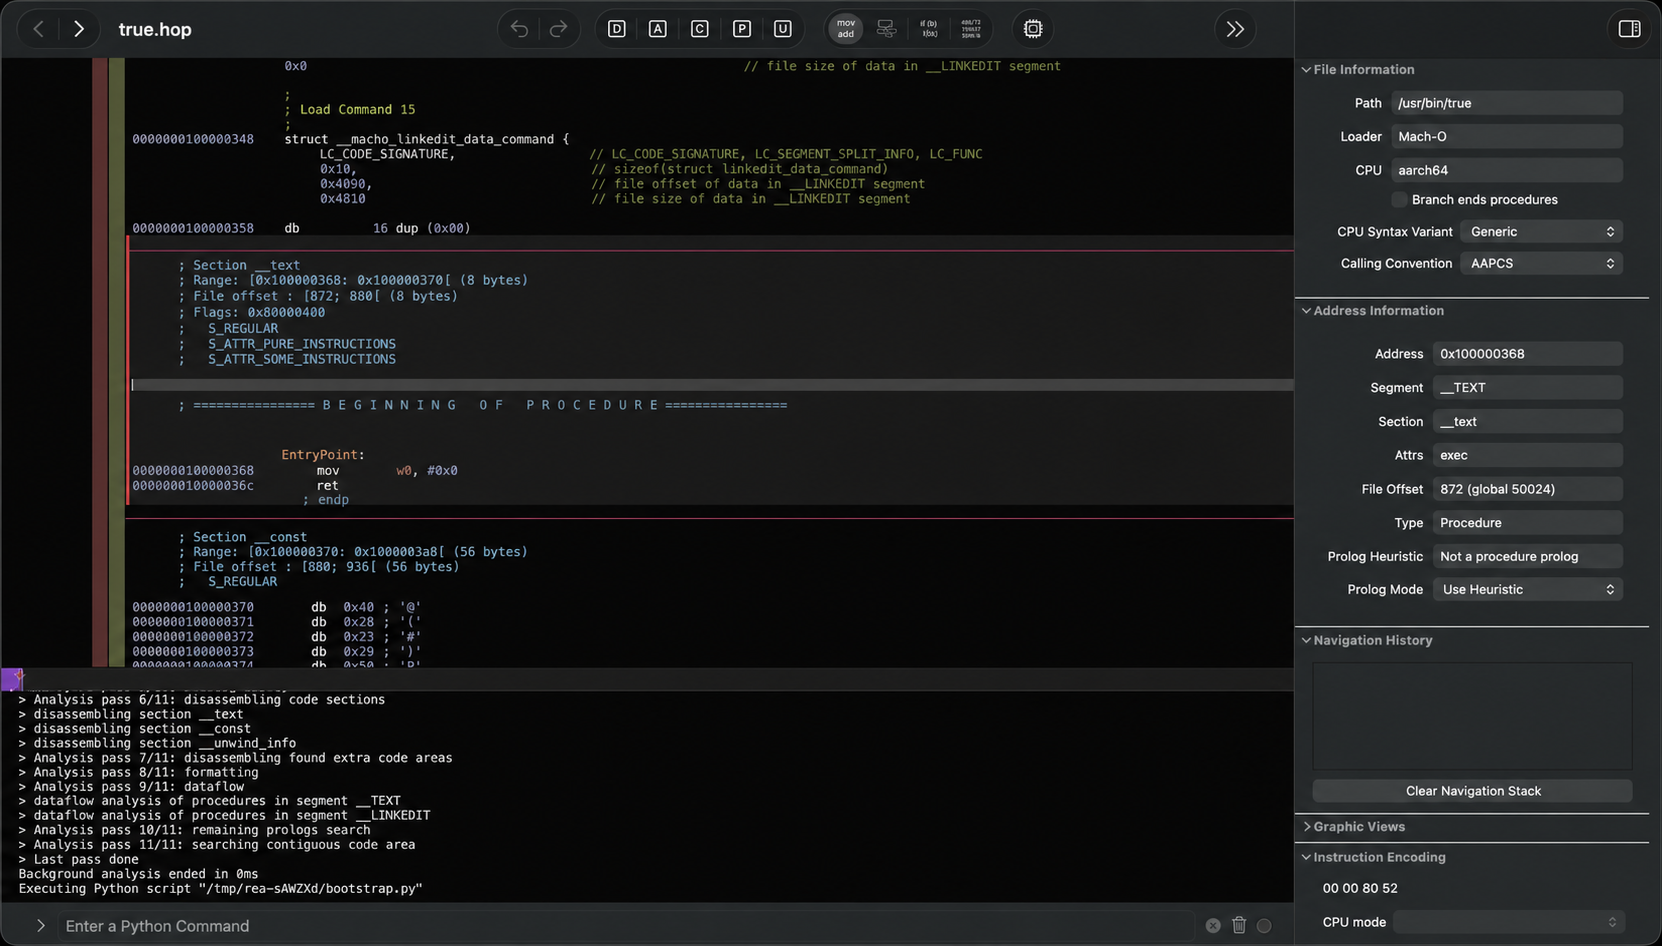
Lo que analiza, según la tabla de objetivos del README:
| Objetivo | Qué devuelve REA | Necesita |
|---|---|---|
| Binarios nativos | Pseudocódigo, ensamblador, cadenas, símbolos, referencias cruzadas | Hopper, Ghidra o IDA |
| Binarios Go | Versión del compilador, módulos, ajustes de compilación | Nada adicional |
| Aplicaciones JavaScript y Electron | Módulos, importaciones, source maps, rutas, límites IPC | Solo Node.js |
| Sitios web | Estructura de la página, scripts, observaciones de red, capturas de pantalla | Un navegador de la familia Chrome |
| Capturas de red guardadas | Solicitudes, respuestas, payloads, ubicaciones de origen | HAR; mitmdump en Linux para mitmproxy |
| Ensamblados .NET | Metadatos, CIL, dependencias nativas | Nada adicional |
| APKs y dispositivos Android | Manifiesto, métodos descompilados, registros, capturas de pantalla | JADX más un JDK; adb |
| Firmware | Regiones, resultados de extracción | Binwalk o Unblob en Linux |
| Bytecode WASM y EVM | Secciones, importaciones y exportaciones, selectores de dispatch | WABT; Linux x64 |
La decisión de diseño que distingue a REA de un envoltorio delgado es el modelo de evidencia. Cada resultado lleva su procedencia: resúmenes de archivos, rangos de bytes, punteros JSON hacia la captura y una lista explícita de lo que el análisis no pudo establecer. El proyecto lo repite en su documentación. El análisis se ejecuta en tu máquina, pero el FAQ del README es directo: el proveedor del modelo del agente sigue recibiendo los resultados de las herramientas según su propia política de datos.
Cómo instalar REA
Necesitas Node.js 22.19 o posterior (23 y 25 no son compatibles) y npm. Un comando registra el servidor MCP e instala las instrucciones de skill correspondientes para tu agente:
npx rea-agents setup
La configuración muestra un plan, hace una copia de seguridad de la configuración existente y solo escribe después de tu aprobación. Según la guía de instalación, es compatible con Claude Code, Claude Desktop, Codex, Cursor, Gemini CLI, Windsurf, Devin, OpenCode, Antigravity, GitHub Copilot CLI, VS Code, Grok Build, Hermes y más, seleccionables con un marcador --client. Reinicia el agente después y pregúntale algo como:
Understand how search works in the Notes app, show me the evidence,
and build a similar feature for my project.
Para una CLI global:
npm install --global rea-agents
rea doctor --json
El análisis de JavaScript estático, .NET, sitios web y capturas funciona sin ningún motor adicional. El análisis nativo profundo necesita Hopper, Ghidra 12.1 con JDK 21 o superior, o IDA. La configuración puede instalar Hopper con tu aprobación, pero Hopper es un software comercial independiente con su propia licencia. Ghidra en Windows está marcado como experimental.
En qué es bueno, según los ejemplos destacados
Los casos de estudio del propio proyecto son el punto de referencia más honesto. En el estudio de DX-Boll, el agente siguió una llamada de sonido hasta su helper de posición a panorámica, convirtió pseudocódigo incompleto en C y la reconstrucción superó los 3.205 casos de prueba x86 originales mientras reproducía los 63 bytes de la función compilada. En el estudio de Notion, rastreó la API del portapapeles desde el renderer, a través de preload e IPC, hasta el proceso principal de Electron. Un tercero recuperó un cálculo de ángulo de anillo de balas a partir de instrucciones de 16 bits de un juego para PC-98 de los años noventa.
Observa el patrón. Son preguntas con un alcance estrecho sobre una función o una ruta de datos, con una forma de verificar la respuesta. Ahí funciona hoy la ingeniería inversa dirigida por agentes. Las demostraciones de “reconstruye esta aplicación completa” lucen bien en vídeo y producen algo parecido al objetivo, pero una reseña temprana que comparó REA con un agente básico en una aplicación Mac sencilla encontró una diferencia pequeña y una ejecución más lenta con REA. El valor aparece cuando la pregunta es específica y el objetivo es complejo.
REA para trabajo con APIs: de la captura a una especificación probada
Aquí está la parte relevante para cualquiera que construya contra APIs. La herramienta inspect_web_network_capture de REA lee un archivo HAR (o una captura nativa de mitmproxy en Linux) sin conexión. Nunca vuelve a solicitar las URLs grabadas. Valida cada entrada, conserva los cuerpos de solicitud y respuesta con sus resúmenes criptográficos y excluye estructuralmente de la evidencia los encabezados de autorización, las cookies y las credenciales de la URL.
Luego hace algo que un equipo de APIs reconocerá de inmediato. Pasa la evidencia retenida a inspect_analysis_view con la vista api-surface y REA agrupa cada solicitud por método, origen y plantilla de ruta inferida. Los IDs numéricos se convierten en {numeric}, los UUID en {uuid}, las cadenas hexadecimales largas en {hex} y las fechas en {iso-date}. Cada grupo cita los registros de los que proviene y marca estados o tipos de contenido mixtos. La guía de capturas tiene cuidado al decir que la vista no hace afirmaciones sobre esquemas ni manejadores. Es un inventario inferido, no una especificación.
Ese inventario es exactamente el punto de partida del flujo de nuestra guía de ingeniería inversa de APIs, y Apidog lo termina:
- Captura una vez. En Chrome DevTools, reproduce el flujo y guarda todas las solicitudes como un HAR con contenido. Registra con una cuenta de prueba; un HAR incluye tokens activos.
- Deja que el agente lo mapee. Pide a tu agente que ejecute REA sobre el HAR y resuma la superficie de la API. Obtienes la lista de endpoints, los patrones de ID y qué llamadas devolvieron errores, con punteros de vuelta a los registros originales.
- Importa el mismo HAR en Apidog. Apidog convierte las solicitudes capturadas en endpoints, con una opción para generar un caso de prueba predeterminado por endpoint y descartar recursos estáticos al importar. Nuestra guía de importación de HAR cubre la limpieza.
- Promueve las plantillas inferidas a parámetros de ruta reales. Los marcadores
{numeric}y{uuid}de REA te indican qué segmentos parametrizar en las definiciones de endpoints de Apidog. - Simula y prueba. Activa el smart mock de Apidog para que tu código cliente pueda ejecutarse contra la API reconstruida antes de tocar la real; luego escribe aserciones sobre las formas de respuesta capturadas y ejecútalas desde la CLI de Apidog en CI.
La división es limpia. REA es bueno leyendo evidencia y explicándola. Apidog es donde los endpoints se convierten en un contrato documentado, simulado y probado que tu equipo puede compartir. Ninguno hace el trabajo del otro.
Advertencias antes de adoptarlo
La velocidad de versiones corta en ambos sentidos. Siete versiones menores se publicaron en nueve días, y la política always-bump-minor del proyecto significa que un aumento menor puede ser disruptivo. La guía de migración a 6.2 cambió la forma de cada resultado MCP. Si escribes scripts contra la salida JSON de REA, fija una versión y lee el changelog antes de actualizar.
Es un conector, no un sandbox. La política de seguridad del proyecto afirma que su puente local de proveedores no es un sandbox y que abrir un binario no confiable ejecuta su análisis con tus permisos de usuario. Analiza objetivos no confiables en un entorno aislado, igual que aislarías las llamadas de herramientas de cualquier agente.
Las limitaciones de plataforma son específicas. La decodificación nativa de mitmproxy necesita exactamente mitmdump 12.2.3, en Linux y suministrado por ti. Las rutas de extracción de firmware, EVM y WASM son para Linux x64. Hopper no tiene versión para Windows.
La responsabilidad legal sigue siendo tuya. El README limita REA a investigación, análisis y reconstrucción legales, y dice que tú eres responsable de la autorización. Copiar una función de la competencia sigue siendo la misma cuestión legal que antes de que existiera la herramienta. El proyecto también ha tenido que declarar que no ha emitido ningún token y que las monedas que usan su nombre no están afiliadas.
Está en una etapa temprana. Más de 100 colaboradores y más de 170 issues y pull requests abiertos al escribir esto. La documentación es exhaustiva, pero espera asperezas fuera de los caminos destacados.
Preguntas frecuentes
¿REA es gratis? Sí. El código tiene licencia MIT y el paquete npm es gratuito. Hopper es un producto de pago si lo eliges para análisis nativo; Ghidra es gratis.
¿REA sube mi aplicación o binario? No. El análisis se ejecuta localmente. Los resultados de las herramientas van al modelo que use tu agente, por lo que se aplica la política de datos de ese proveedor.
¿Necesito Ghidra o IDA para empezar? No para análisis de JavaScript, Electron, .NET, sitios web o capturas. Solo la descompilación de binarios nativos necesita un motor.
¿Puede REA producir una especificación OpenAPI a partir del tráfico? No. Su vista api-surface es un inventario inferido con plantillas de ruta. Importa el HAR en Apidog para obtener definiciones editables de endpoints y exporta OpenAPI desde allí. Descarga Apidog para probar la importación con una captura que ya tengas.
Dónde te deja esto
REA se ganó sus estrellas al empaquetar motores reales de ingeniería inversa detrás de un servidor MCP y documentar la evidencia que devuelve. Úsalo para preguntas con alcance definido: cómo funciona una función, qué canal IPC transporta un mensaje, qué aspecto tiene el tráfico de una aplicación. Trata las demostraciones de reconstruirlo todo como demostraciones.
Para los equipos de APIs, la ventaja práctica es la ruta de captura. Deja que el agente lea el HAR con REA, importa el mismo archivo en Apidog y convierte el inventario en endpoints que puedes simular, probar y documentar.