
Alibaba lanzó oficialmente Qwen 3.8-Max a principios de agosto de 2026, y llega con una combinación inusual: un modelo Mixture-of-Experts de 2.4 billones de parámetros que solo activa 95B parámetros por token, un precio fijo de $2/$6 por millón de tokens en un contexto completo de 1M, y la promesa de que los pesos se harán públicos en Hugging Face y ModelScope en una semana. Esa última parte importa. Ningún modelo de la clase Qwen-Max ha lanzado pesos abiertos antes.
El anuncio oficial lo califica como el Qwen más capaz hasta la fecha, y la tabla de benchmarks del proveedor lo respalda con algunos resultados realmente sólidos y algunas pérdidas honestas. Esta guía desglosa lo que realmente es Qwen 3.8-Max, qué dicen los números, cómo se posiciona frente a Kimi K3, Fable 5 y GPT-5.6 Sol, y todas las formas en que puedes ejecutarlo hoy. Si planeas construir usando la API, el modelo se envía con endpoints compatibles con OpenAI y con Anthropic, lo que hace que un cliente consciente del protocolo como Apidog sea útil para probar ambas formas con la misma clave.
Qwen 3.8-Max de un vistazo
| Especificación | Qwen 3.8-Max |
|---|---|
| Desarrollador | Alibaba (equipo Qwen) |
| Lanzamiento | Principios de agosto de 2026 (Disponibilidad general en Model Studio, 3 de agosto) |
| Arquitectura | MoE, construida sobre la base de Qwen 3.5 |
| Parámetros totales | 2.4T |
| Parámetros activos | 95B (~4% de activación) |
| Ventana de contexto | 1,000,000 tokens |
| Salida máxima | 65,536 tokens |
| Modalidades | Entrada de texto + imagen, salida de texto |
| Controles de razonamiento | reasoning_effort: xhigh (predeterminado), medium, low |
| ID del modelo API | qwen3.8-max |
| Precios | $2 entrada / $6 salida por 1M de tokens, fijo en todo el contexto |
| Pesos abiertos | Prometido para la próxima semana (~10 de agosto); aún no descargable a principios de agosto de 2026 |
| Protocolos API | Compatible con OpenAI y compatible con Anthropic |
Todo lo que figura en esa tabla proviene de los materiales de lanzamiento de Alibaba y de la página de precios de Model Studio. Ahora, los detalles.
Qué es Qwen 3.8-Max
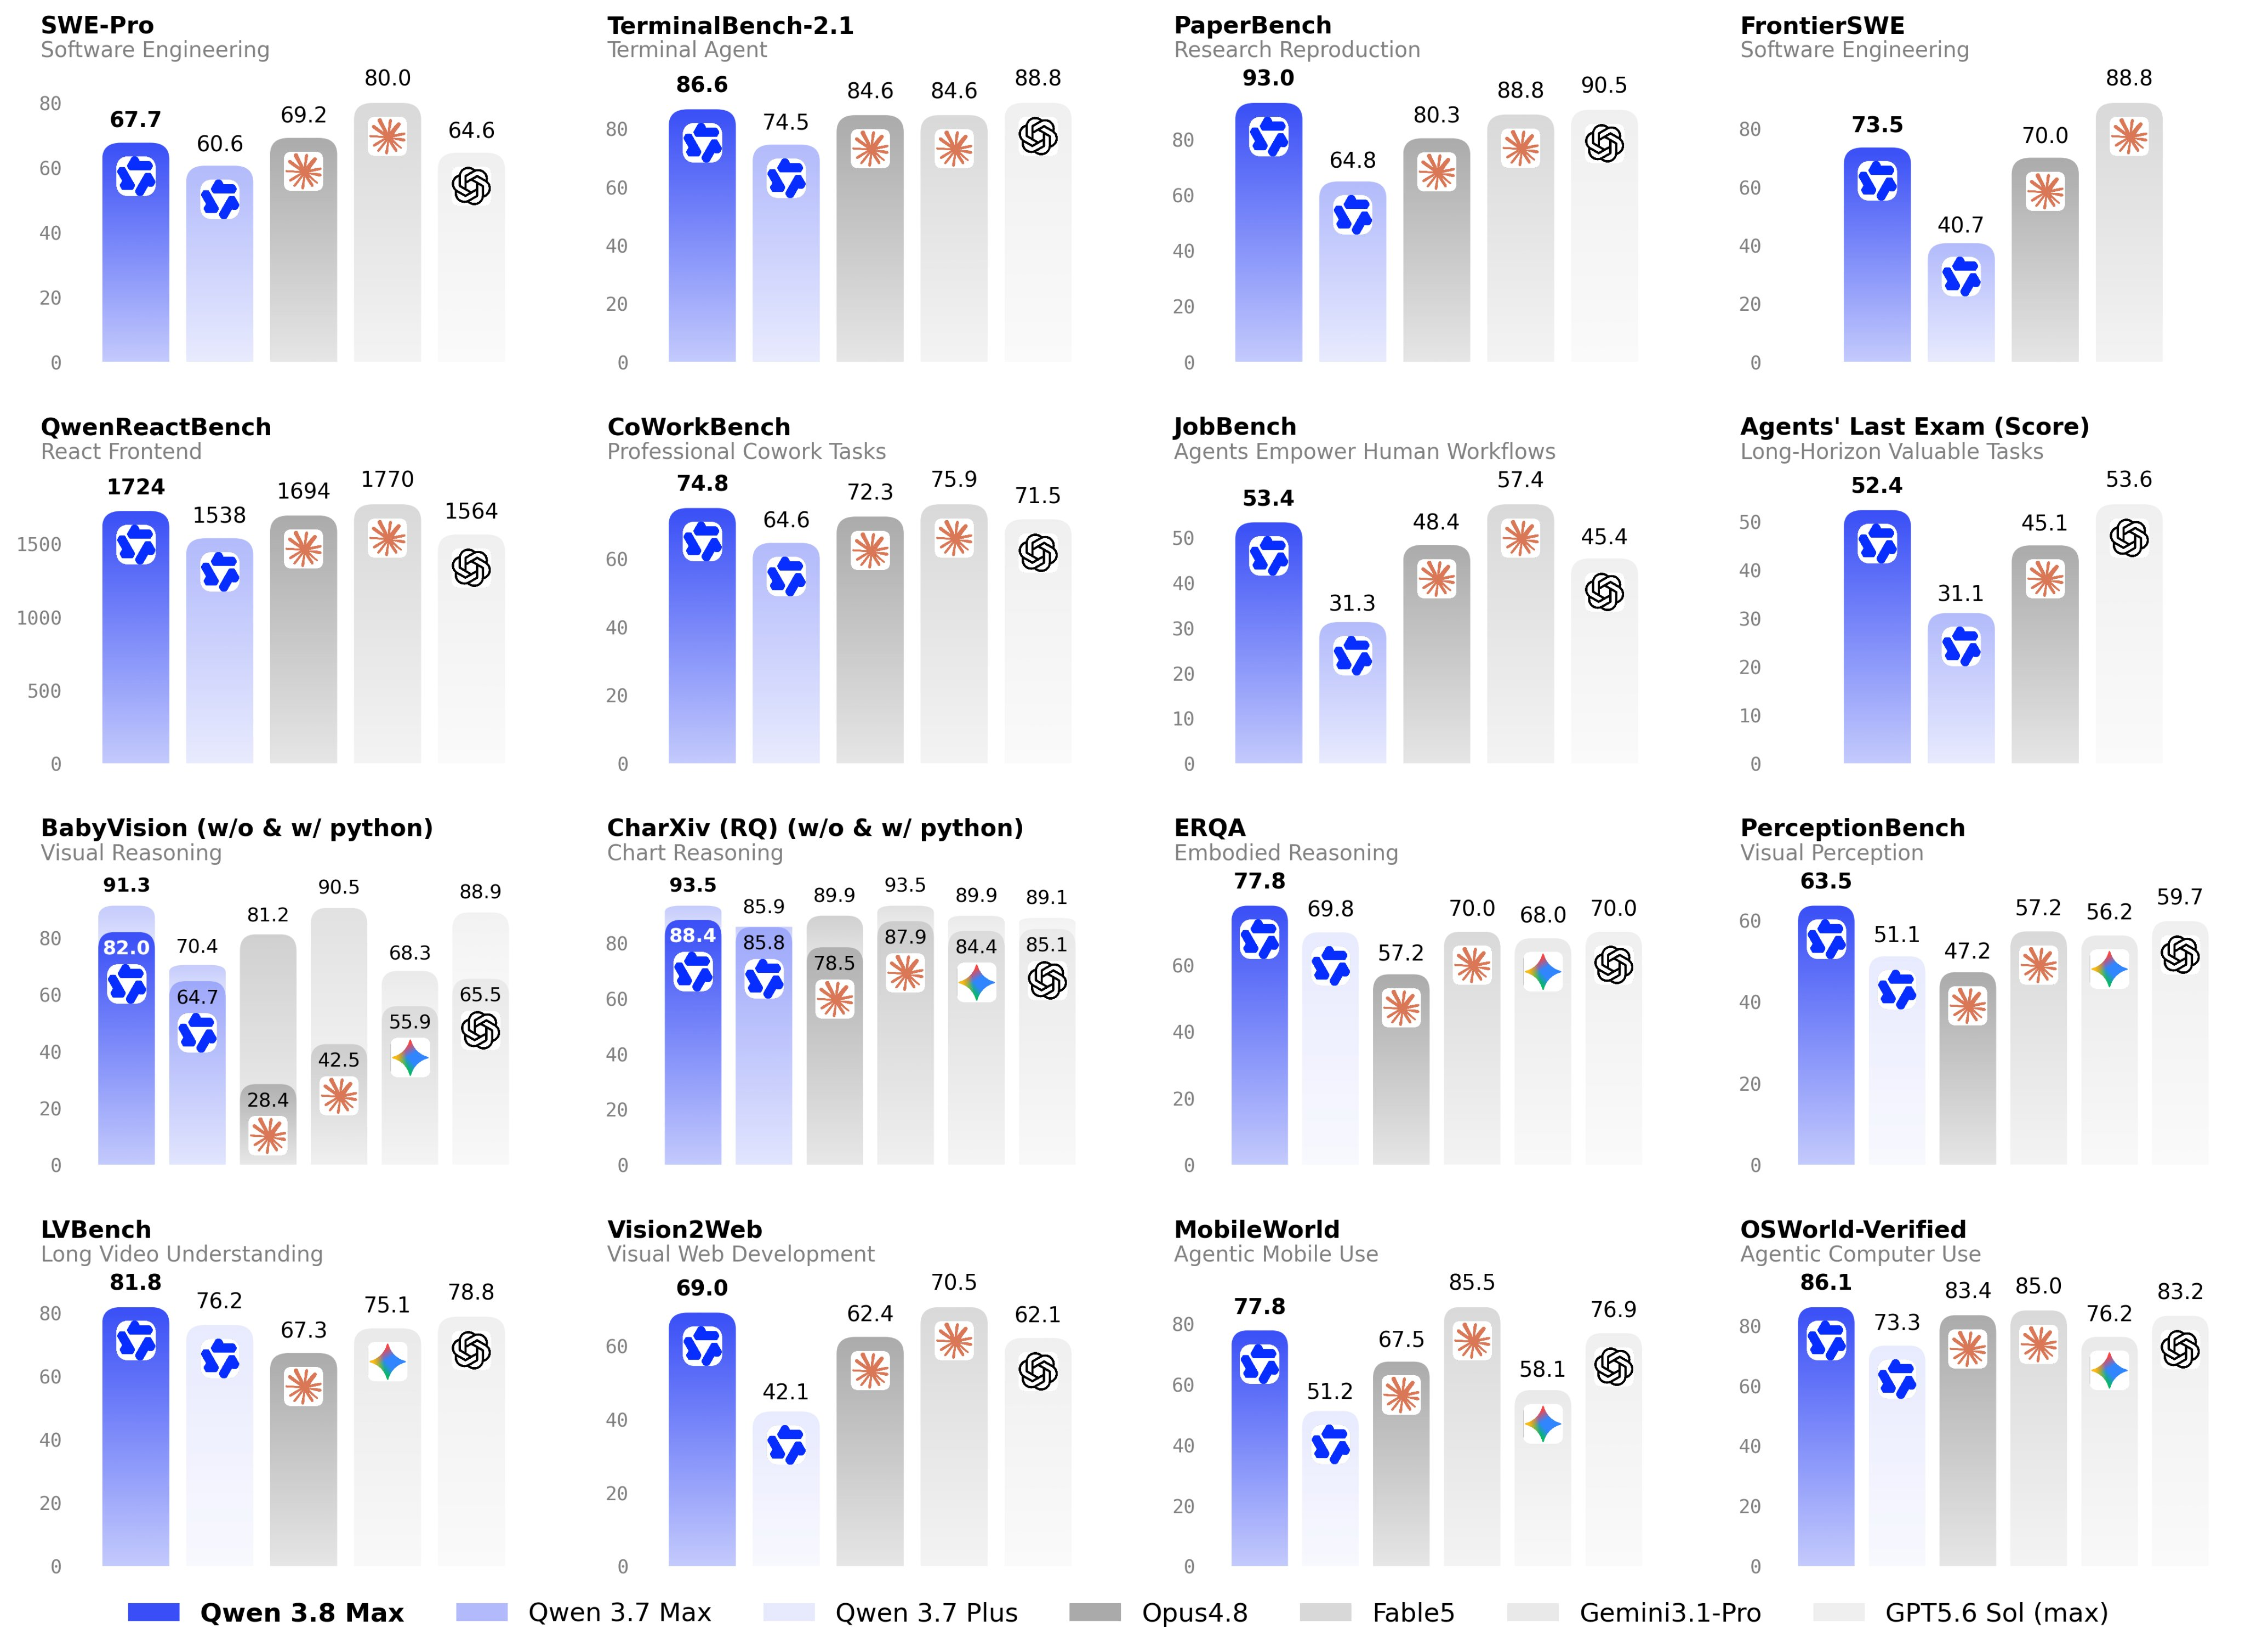
Qwen 3.8-Max es el nuevo buque insignia de la familia Qwen de Alibaba, construido sobre la base arquitectónica de Qwen 3.5. Reemplaza a Qwen3.7-Max en la cima de la línea, y la tabla del proveedor muestra saltos significativos respecto a su predecesor: Terminal Bench 2.1 pasa de 74.5 a 86.6, y PaperBench pasa de 64.8 a 93.0. Si estás decidiendo si cambiar del modelo anterior, las diferencias se presentan en nuestra comparación de Qwen 3.8 vs Qwen 3.7 Max.
La especificación principal es la división de parámetros. 2.4T de parámetros totales suena enorme, y lo es, pero el diseño MoE activa solo 95B por pasada hacia adelante. Esa relación de activación de aproximadamente el 4% es la razón por la que Alibaba puede ofrecer un modelo tan grande a $2/$6 por millón de tokens. Como contexto, Kimi K3 ejecuta 2.8T totales con 104B activos, por lo que Qwen 3.8-Max es el modelo más pequeño en ambos aspectos.
En cuanto a la entrada, el modelo acepta texto e imágenes a través de la API. El blog de Alibaba también demuestra la comprensión de documentos largos (PDFs de más de 200 páginas) y la comprensión de videos de 100 horas a través de lo que llama gráficos de memoria. Trate estas como capacidades demostradas en el blog en lugar de tipos de entrada de API separados; las configuraciones de API publicadas enumeran el texto y la imagen como las modalidades de entrada.
El razonamiento se controla a través de un parámetro `reasoning_effort` con tres niveles: xhigh (el predeterminado), medium y low. También existen `enable_thinking` y `preserve_thinking`, con el pensamiento preservado por defecto. Un detalle de precios que vale la pena conocer con antelación: los modos con y sin pensamiento se facturan a la misma tarifa, pero los tokens de pensamiento cuentan como salida, por lo que las facturas reales con el valor predeterminado xhigh serán más altas que un cálculo ingenuo del precio de etiqueta.
El primer Qwen de clase Max de pesos abiertos
Este es el movimiento estratégico más grande del lanzamiento. Alibaba ha liberado muchos modelos Qwen como código abierto a lo largo de los años, pero nunca la capa Max. Qwen 3.8-Max rompe ese patrón: la compañía dice que los pesos llegarán a Hugging Face y ModelScope "la próxima semana", lo que se traduce en alrededor del 10 de agosto.
Dos advertencias, declaradas claramente:
- Los pesos aún no son descargables. A principios de agosto de 2026, la promesa es una promesa. Kimi K3 sentó un precedente reciente aquí: sus pesos llegaron 11 días después del lanzamiento, por lo que un pequeño retraso no sería sorprendente.
- Alojar un modelo de 2.4T por cuenta propia es un proyecto multinodo. Incluso agresivamente cuantizado, esto no es algo que se ejecute en una estación de trabajo. Para la mayoría de los equipos, "pesos abiertos" significará un acceso alojado más económico a través de proveedores externos en lugar de una implementación local.
Si tu interés en Qwen 3.8-Max se centra principalmente en no pagar el precio de lista, las rutas realistas actuales son Qwen Chat y la cuota gratuita de Model Studio, ambas cubiertas en nuestra guía sobre cómo usar Qwen 3.8 gratis.
Lo que muestran los benchmarks, incluidas las pérdidas
Alibaba publicó una tabla completa de benchmarks comparando Qwen 3.8-Max con Claude Opus 4.8, Fable 5, GPT-5.6 Sol y Qwen3.7-Max. Dos aclaraciones antes de cualquier número: estos son resultados ejecutados por el proveedor, y la mayoría de las filas de codificación se ejecutaron utilizando el arnés Claude Code para todos los modelos. Varios benchmarks (QwenSWEBench, QwenQoderBench, CoWorkBench, RecreationBench) son creaciones internas de Alibaba. No existían números independientes de fuentes como Artificial Analysis en el momento de la redacción.
Con ese marco, las filas destacadas según la tabla de Alibaba:
Donde gana:
- PaperBench: 93.0, su mejor resultado insignia, por delante de GPT-5.6 Sol (90.5), Fable 5 (88.8) y Opus 4.8 (80.3)
- IFBench: 82.8, la puntuación más alta en la fila, por delante de los 72.7 de Sol
- Terminal Bench 2.1: 86.6, superando a Opus 4.8 y Fable 5 (ambos 84.6), solo por detrás de Sol (88.8)
- Multimodal es su punto fuerte: MathVision 95.2, LogicVista 91.9, OSWorld-Verified 86.1, y filas OCR que superan a casi todo en la tabla
Donde pierde:
- SWE-bench Pro: 67.7, muy por detrás de los 80.0 de Fable 5 y ligeramente por detrás de los 69.2 de Opus 4.8 (supera los 64.6 de Sol)
- HLE: 43.6, la puntuación insignia más baja en la fila; Fable 5 obtiene 53.3, Sol 47.2 y Opus 4.8 45.7
El resumen honesto: según los propios números de Alibaba, Qwen 3.8-Max supera a Opus 4.8 en varias filas de agentes, se queda atrás de Fable 5 en la mayoría del trabajo de codificación principal, y gana mucho en inteligencia multimodal y de documentos. En GPQA Diamond se sitúa en 92.6, empatado con Fable 5 y justo detrás de los 94.1 de Sol, por lo que el razonamiento científico puro es competitivo. Para un recorrido completo por la tabla, incluyendo la letra pequeña del arnés y qué verificación independiente buscar, consulta nuestro desglose de benchmarks de Qwen 3.8.
Alibaba también publicó una serie de demostraciones: una sesión de codificación autónoma de 16 días en un repositorio público (265 commits, 127 solicitudes de extracción), una ejecución de reproducción de un artículo que superó el resultado AIME24 del artículo original, y una entrada al concurso Tianchi que superó a 458 de 526 equipos humanos en 24 horas. Estas son las propias demostraciones del proveedor, así que interprétalas como anuncios de capacidad en lugar de evaluaciones controladas. La historia de la codificación, incluyendo cómo reproducir las configuraciones del arnés, recibe un tratamiento dedicado en Qwen 3.8 para codificación.
Dónde se sitúa frente a Kimi K3, Fable 5 y GPT-5.6 Sol
Vs Kimi K3. Esta es la rivalidad natural: dos laboratorios chinos, dos modelos MoE gigantes de pesos abiertos, lanzados con semanas de diferencia. K3 es más grande (2.8T total, 104B activos vs 2.4T/95B), solo texto donde Qwen es multimodal, y sus pesos ya están disponibles mientras que los de Qwen son todavía una promesa. Los precios también divergen bruscamente: K3 cobra $3 de entrada/$15 de salida con $0.30 por aciertos de caché, frente a los $2/$6 fijos de Qwen. Aún no existe una evaluación directa cara a cara; cada proveedor publicó su propia tabla. Los comparamos fila por fila en Qwen 3.8 vs Kimi K3, y si eres nuevo en el modelo de Moonshot, empieza con qué es Kimi K3.
Vs Fable 5. El buque insignia de Anthropic sigue siendo el referente de codificación a batir, y Qwen 3.8-Max no lo supera: SWE-bench Pro (67.7 vs 80.0) y HLE (43.6 vs 53.3) son claras diferencias, según la propia tabla de Alibaba. Lo que Qwen ofrece en su lugar es precio (una fracción de las tarifas de vanguardia), un contexto de 1M, pesos abiertos en camino y filas multimodales más fuertes.
Vs GPT-5.6 Sol. Sol se lleva Terminal Bench (88.8 vs 86.6), GPQA (94.1 vs 92.6) y HLE (47.2 vs 43.6), mientras que Qwen 3.8-Max gana PaperBench (93.0 vs 90.5) e IFBench (82.8 vs 72.7). En cuanto al precio, los $2/$6 de Qwen rebajan los $2/$12 de GPT-5.6 Terra en salida, y el acceso a la capa Sol cuesta aún más.
Un punto de referencia más: Claude Opus 5 figura a $5/$25. Independientemente de lo que pienses de las tablas de los proveedores, Alibaba está fijando el precio de su buque insignia a un nivel que cambia las cuentas para cargas de trabajo de alto volumen.
Precios: $2/$6, fijo en 1M de tokens
El precio es lo suficientemente simple como para decirlo en una frase: $2 por millón de tokens de entrada, $6 por millón de tokens de salida, una tarifa plana desde el token cero hasta el límite de contexto de 1M, en modo de pensamiento o no.
La tarifa plana es la parte inusual. La mayoría de los modelos de contexto largo aumentan los precios a medida que crece tu prompt; Qwen 3.8-Max no lo hace. También se lanza más barato que el precio de lista de Qwen3.7-Max de $2.5/$7.5, aunque ese modelo más antiguo actualmente tiene una promoción del 50% ($1.25/$3.75), lo que lo mantiene relevante como una opción de valor.
El almacenamiento en caché del contexto mejora las cargas de trabajo con prefijos repetidos: los aciertos de caché se facturan al 10% de la tarifa de entrada, y la creación explícita de caché cuesta el 125%. También hay una cuota gratuita (1M de tokens, solo región de Singapur, válida por 90 días) para probarlo. El desglose completo de costos, con ejemplos de tareas resueltas y el "truco" de los tokens de pensamiento cuantificado, se encuentra en nuestra guía de precios de Qwen 3.8.
Cómo acceder a Qwen 3.8-Max
La matriz de acceso es más amplia que un lanzamiento típico. Cinco rutas:
1. Qwen Chat. La aplicación para el consumidor, no se necesita clave API. La forma más rápida de formarse una opinión.
2. La API en Alibaba Cloud Model Studio (DashScope). Obtén una clave de home.qwencloud.com, configura `DASHSCOPE_API_KEY` y llama al ID del modelo `qwen3.8-max` a través de los endpoints de chat-completions o respuestas compatibles con OpenAI. Hay tres URLs base regionales activas: Beijing (`dashscope.aliyuncs.com/compatible-mode/v1`), Singapur (`dashscope-intl.aliyuncs.com/compatible-mode/v1`) y EE.UU.-Virginia (`dashscope-us.aliyuncs.com/compatible-mode/v1`). La página de modelos de Model Studio lo lista en la parte superior de la pila recomendada.
3. El endpoint compatible con Anthropic. Este es el realmente inusual: `https://dashscope-intl.aliyuncs.com/apps/anthropic` utiliza el protocolo de mensajes de Anthropic, por lo que las herramientas construidas para Claude pueden apuntar a Qwen con dos variables de entorno.
4. Arneses de codificación. Alibaba publicó configuraciones oficiales para cinco agentes: Claude Code (a través de `ANTHROPIC_BASE_URL` más `ANTHROPIC_MODEL=qwen3.8-max`), Codex, Qoder, Qwen Code y OpenClaw. Cabe señalar que Alibaba ejecutó la mayoría de sus benchmarks de codificación dentro del arnés Claude Code, por lo que la configuración que publicó es también la configuración detrás de sus propios números.
5. Pesos abiertos, pronto. Hugging Face y ModelScope, prometidos para la próxima semana, aún no descargables a principios de agosto de 2026.
Los detalles de configuración para las rutas 2 a 4, con Python y cURL para copiar y pegar, se encuentran en nuestra guía de API de Qwen 3.8.
Prueba de la API de protocolo dual
El mismo modelo respondiendo en dos formas de protocolo diferentes crea una pregunta práctica de prueba: ¿se comporta su solicitud de manera idéntica en ambos? Aquí es donde un cliente de API demuestra su valía. En Apidog, puede guardar las tres URLs base regionales como entornos y cambiar de región sin editar las solicitudes, enviar el mismo prompt a través del endpoint compatible con OpenAI y el endpoint de protocolo Anthropic uno al lado del otro, e inspeccionar el flujo SSE para ver cómo llegan los deltas de `reasoning_content` antes de la respuesta final. Esa última parte es útil para verificar cuánto pensamiento genera realmente el valor predeterminado xhigh, ya que esos tokens se facturan como salida. Descargue Apidog gratis si desea seguir las instrucciones al configurar los endpoints; el mismo espacio de trabajo también facilita la comparación A/B de `qwen3.8-max` con `qwen3.7-max` o `kimi-k3` en prompts idénticos antes de comprometer una carga de trabajo.
Dónde encaja Qwen 3.8-Max en la línea de productos
Si estás mapeando la familia más amplia, Qwen 3.8-Max ahora se sitúa por encima de Qwen3.7-Max y los modelos de nivel plus, y nuestra guía de los mejores modelos Qwen cubre qué nivel se adapta a cada carga de trabajo. La versión corta: 3.8-Max es la elección cuando necesitas el techo multimodal y de agente, 3.7-Max con un 50% de descuento es el buque insignia de valor mientras dure la promoción, y los modelos plus siguen siendo los caballos de batalla baratos para tareas rutinarias.
Preguntas frecuentes
¿Es Qwen 3.8 de código abierto?
Todavía no, pero está cerca. Alibaba prometió los pesos para Hugging Face y ModelScope "la próxima semana" a partir del lanzamiento a principios de agosto de 2026, lo que lo convertiría en el primer Qwen de clase Max de pesos abiertos. Nada es descargable al momento de escribir. Hasta entonces, el acceso se realiza a través de la API o Qwen Chat; consulta cómo usar Qwen 3.8 gratis para las rutas sin costo.
¿Cuánto cuesta Qwen 3.8-Max?
$2 por millón de tokens de entrada y $6 por millón de tokens de salida, en una única tarifa plana en todo el contexto de 1M. Los aciertos de caché se facturan al 10% de la entrada. Los tokens de pensamiento se facturan como salida, y el esfuerzo de razonamiento predeterminado es xhigh, así que presupuesta por encima de la tarifa base para trabajos que requieran mucho razonamiento.
¿Es Qwen 3.8-Max mejor que Kimi K3?
Aún no hay una evaluación directa cara a cara; ambos proveedores publicaron sus propias tablas. Sobre el papel, Qwen 3.8-Max es más pequeño (2.4T/95B activo vs 2.8T/104B), multimodal donde K3 es solo texto, y más barato en salida ($6 vs $15). La ventaja de K3 hoy es que sus pesos ya son públicos.
¿Puedo usar Qwen 3.8-Max en Claude Code?
Sí. Alibaba publicó una configuración oficial: apunte `ANTHROPIC_BASE_URL` al endpoint DashScope compatible con Anthropic y configure `ANTHROPIC_MODEL=qwen3.8-max`. Codex, Qoder, Qwen Code y OpenClaw también tienen configuraciones oficiales.
Qué hacer a continuación
Qwen 3.8-Max es un lanzamiento insignia real, no una vista previa para la prensa: disponibilidad general en tres regiones de API, precios publicados, una tabla completa de benchmarks (ejecutados por el proveedor) con victorias y derrotas, y pesos abiertos a días de distancia. La lectura honesta es que no destrona a Fable 5 en codificación central, pero supera a Opus 4.8 en varias filas de agentes, lidera en trabajo con documentos y multimodal, y cuesta $2/$6 mientras lo hace.
El movimiento sensato es probarlo con tu propia carga de trabajo en lugar de basarse en la tabla de cualquier otro. Obtén la cuota gratuita, conecta ambos endpoints de protocolo y compara las salidas en los prompts que realmente ejecutas. Comienza con la guía de configuración de la API, y vuelve a consultar alrededor del 10 de agosto para ver si los pesos se publicaron según lo previsto.