
Jev es un nuevo tipo de modelo de TypeSafe AI. No escribe texto. Se le entrega un fragmento del estado del programa, se declaran las preguntas que necesitan respuesta, y devuelve respuestas tipadas con probabilidades calibradas: una probabilidad de sí/no, una elección de una lista, o una puntuación en una rúbrica. TypeSafe lo llama un "Modelo de Sistema Uno", y la propuesta es simple: la mayoría de las llamadas de IA dentro del software no piden prosa, piden una decisión. Si has conectado un LLM a un clasificador y luego has escrito un analizador para extraer una etiqueta de su respuesta, Jev está construido precisamente para ese trabajo, de la misma manera que las salidas estructuradas fueron un primer paso hacia ello.
Llegó a Vercel AI Gateway el 16 de septiembre de 2026, lo que lo puso al alcance de la mayoría de los desarrolladores. Esta guía cubre qué es Jev, cómo difiere de un modelo de lenguaje, los tres tipos de preguntas, cómo llamarlo directamente y a través de Gateway, y cómo probarlo y simularlo en Apidog antes de que toque su lógica de enrutamiento.
Qué es Jev
La publicación de lanzamiento de TypeSafe describe a Jev como "una llamada a función de inteligencia de frontera: estado no estructurado de entrada, decisiones probabilísticas tipadas de salida". Tres propiedades lo definen.
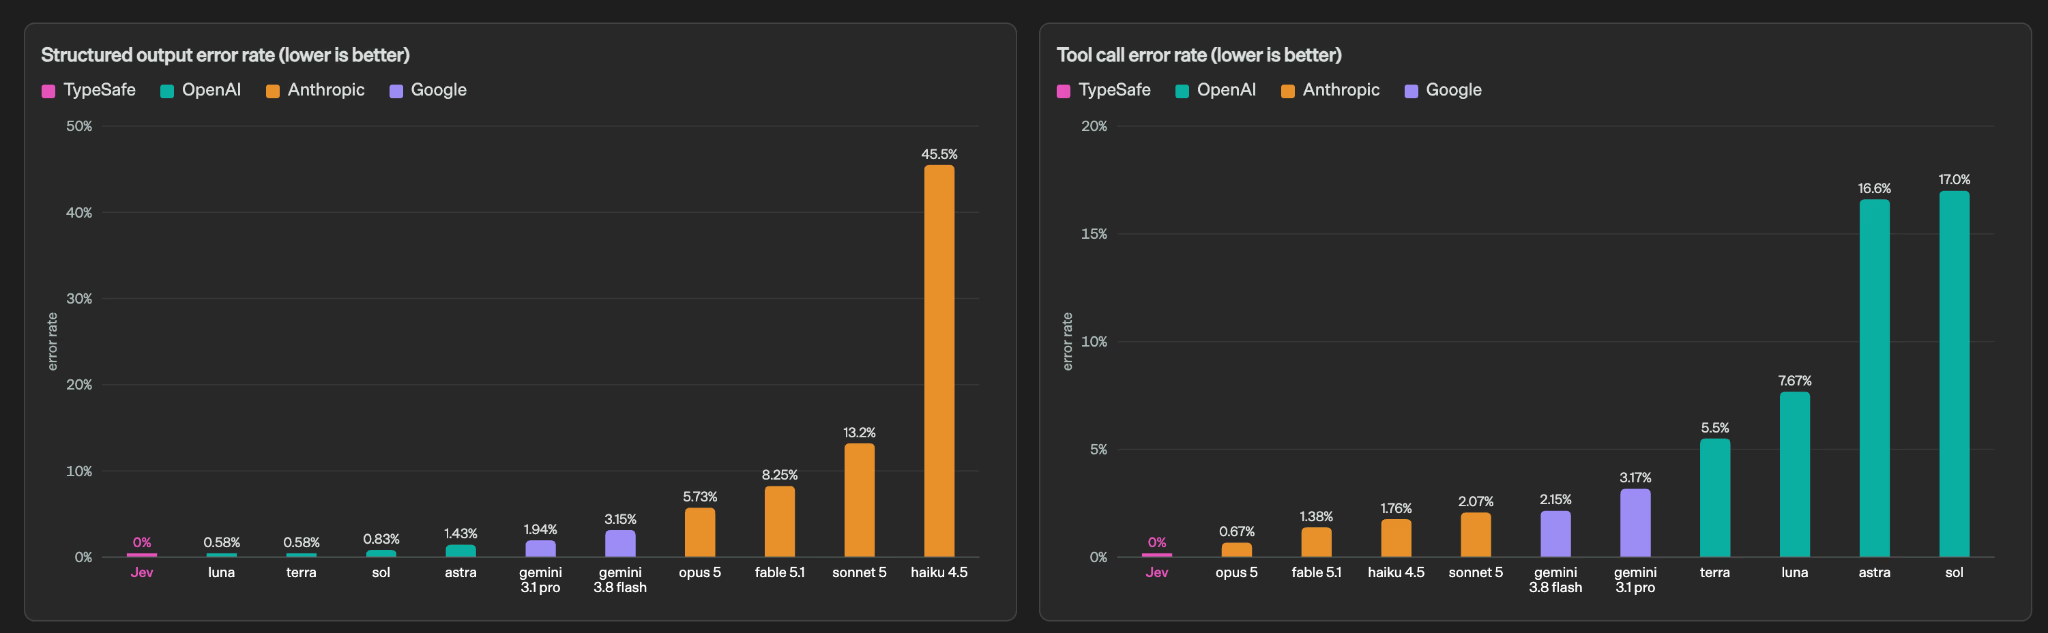
La salida está tipada y declarada antes de la llamada. Se define la forma de cada pregunta de antemano. El modelo solo puede responder dentro de esa forma, por lo que no hay nada que analizar y no hay ninguna discrepancia de esquema que detectar. La palabra de TypeSafe para esto es que Jev "nunca comete errores de tipo".
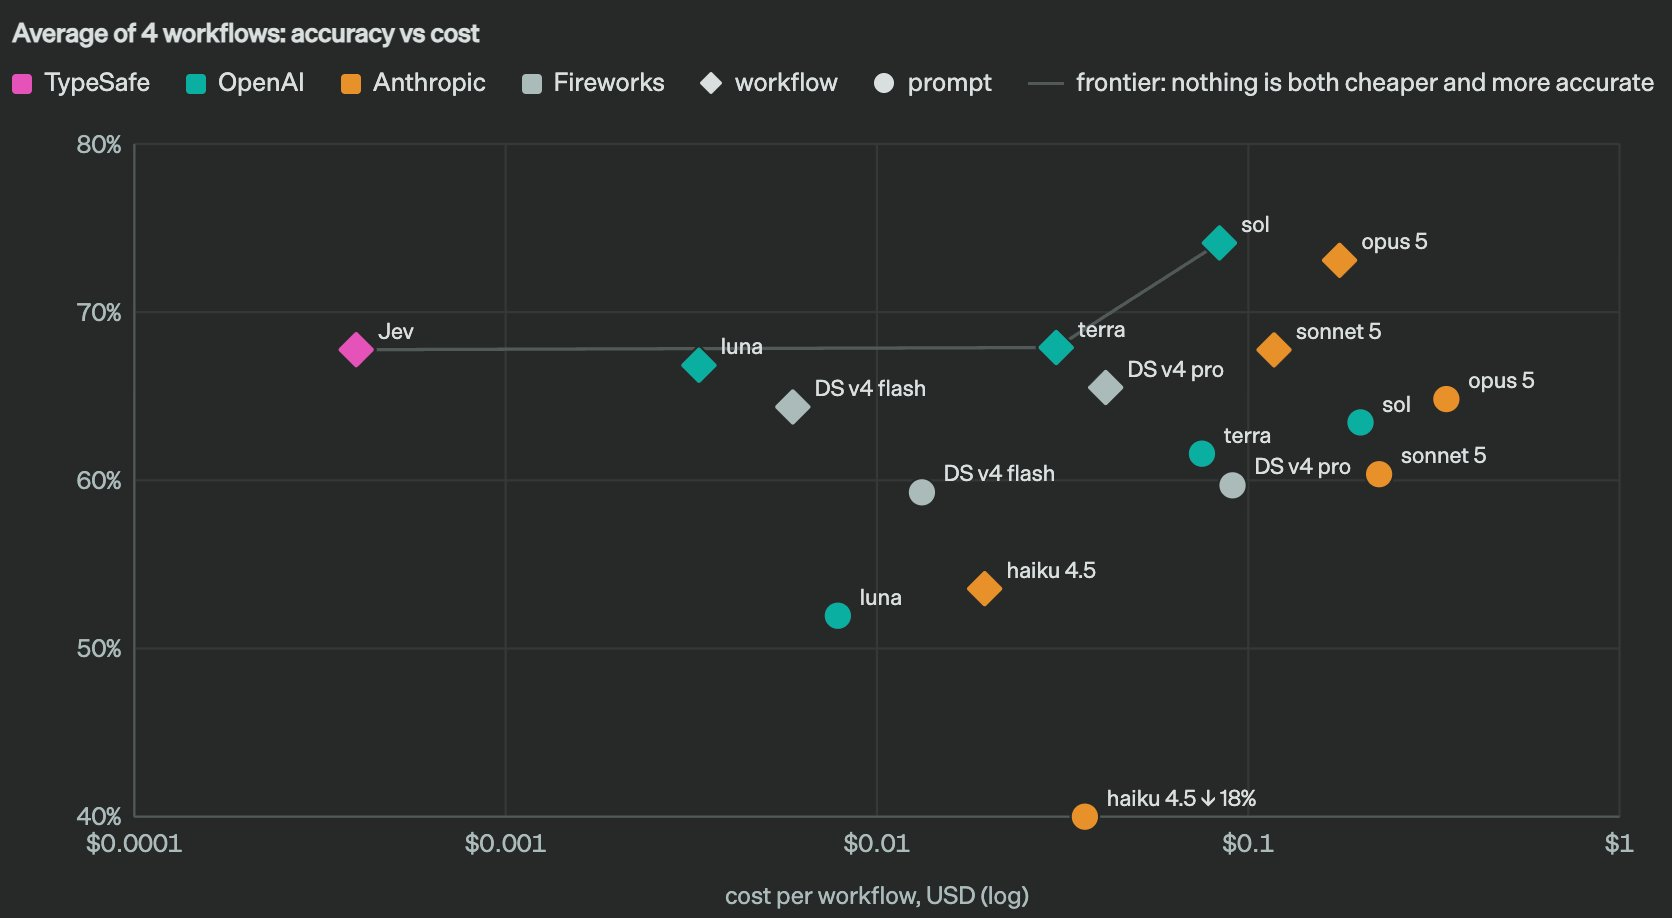
Cada respuesta lleva una probabilidad. Una pregunta de sí/no no devuelve true; devuelve un número como 0.97. Una elección devuelve la distribución completa entre las opciones. TypeSafe entrenó el modelo con un método que llama Aprendizaje por Refuerzo para Decisiones Calibradas, y la afirmación es que una mayor confianza significa una mayor precisión, por lo que se puede establecer un umbral: automatizar los casos claros, y los inciertos dirigirlos a un humano.
Las preguntas se responden en paralelo, en una sola solicitud. Un modelo de lenguaje produce un token a la vez. Jev evalúa todas las preguntas declaradas a la vez contra el mismo estado, por eso TypeSafe cita tiempos de respuesta de extremo a extremo de 70ms a 500ms. Esos son los números del propio proveedor; trátelos como una afirmación a verificar con su carga de trabajo, no como un punto de referencia.
Cómo Jev difiere de un modelo de lenguaje
| Modelo de lenguaje | Jev | |
|---|---|---|
| Salida | Texto libre que usted analiza | Valores tipados que usted declaró |
| Muestreo | Secuencial, token por token | Todas las preguntas en paralelo |
| Confianza | No expuesta por defecto | Una probabilidad en cada respuesta |
| Mejor para | Escribir, chatear, resumir | Decidir, enrutar, puntuar, verificar |
| Entrada | Mensajes | Estado estructurado: una cadena, objeto o array |
| Imágenes | A menudo soportado | Solo texto, por ahora |
La compensación es explícita: Jev renuncia por completo a la generación de cadenas. No es un modelo de chat y no resumirá un documento. Donde encaja es en la "sentencia if inteligente" dentro de una aplicación: qué equipo maneja este ticket, cuán grave es este error, si esta respuesta es segura para enviar, si la compilación pasó.
Los tres tipos de preguntas
La API directa de Jev expone tres primitivas. Cada una es un objeto JSON bajo una clave que usted elija.
Noul: una probabilidad de sí/no. El nombre de TypeSafe para el tipo booleano. Devuelve la probabilidad de que la respuesta sea sí, y usted la umbraliza en el código.
{ "is_urgent": { "type": "noul", "instructions": "¿Este mensaje expresa urgencia?" } }
Respuesta: { "type": "noul", "noul": 0.99 }.
Choice: elige una opción de un conjunto nombrado. criteria mapea los nombres de las opciones a descripciones, hasta 255 opciones. La respuesta lleva la opción principal más la distribución completa y una cifra de confianza.
{ "department": { "type": "choice", "instructions": "¿Qué equipo debe manejar esto?",
  "criteria": { "billing": "Cargos, facturas, problemas de pago",
                "shipping": "Estado de la entrega, retrasos, paquetes perdidos",
                "returns":  "Cambios, reembolsos, artículos dañados" } } }
Respuesta: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }.
Score: una posición en una escala ordenada. criteria es un array de 2 a 10 descripciones de nivel, el más bajo primero. La puntuación es la posición ponderada por probabilidad, por lo que puede caer entre los peldaños.
{ "bug_severity": { "type": "score", "instructions": "¿Qué tan grave es el problema reportado?",
  "criteria": [ "Cosmético; sin impacto en la funcionalidad",
                "Función rota, pero existe una solución alternativa",
                "Problema bloqueante; sin solución alternativa" ] } }
Respuesta: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "Cosmético...", "1": "Roto...", "2": "Bloqueante..." } }.
Una pequeña peculiaridad de los nombres: a través del Vercel AI SDK, el tipo sí/no se llama boolean y el campo de respuesta es probability. Contra la propia API de TypeSafe, es noul. Misma idea, clave diferente.
Dos maneras de llamar a Jev
Directamente. Obtenga una clave en console.typesafe.ai/settings/keys, luego envíe POST https://api.typesafe.ai/v1/systemone con un token Bearer. El ID del modelo es jev-latest, que actualmente se resuelve en jev-1.13.0; jev-preview apunta a la compilación más reciente, oficial o no. Existen SDKs de Python y JavaScript, según el inicio rápido, pero el endpoint puro es un solo POST, que es la forma que usaremos en Apidog.
A través de Vercel AI Gateway. El ID del modelo es typesafe-ai/jev y se llama con experimental_evaluate desde el AI SDK (versión 7 o posterior). Una advertencia de la documentación de evaluación: la evaluación está disponible solo a través del AI SDK, no a través de los endpoints compatibles con OpenAI o Anthropic de Gateway. Si ya enruta modelos a través de Gateway, como en nuestro tutorial GPT-5.6 Sol en AI Gateway, este es el camino natural; nuestra guía del Vercel AI SDK cubre la configuración.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'Was a refund issued?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
Su primera solicitud con curl
Esto clasifica un mensaje de soporte con los tres tipos en una sola llamada:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My card was charged twice for one order and I need this fixed today.",
    "questions": {
      "department": { "type": "choice", "instructions": "¿Qué equipo maneja esto?",
        "criteria": { "billing": "cargos y reembolsos", "shipping": "entrega", "technical": "errores" } },
      "urgency": { "type": "score", "instructions": "¿Qué tan urgente es esto?",
        "criteria": ["baja", "media", "alta"] },
      "wants_refund": { "type": "noul", "instructions": "¿El cliente está pidiendo la devolución del dinero?" }
    }
  }'
La respuesta contiene model, un objeto answers con las claves de sus IDs de pregunta, y usage con input_tokens y output_tokens. Lea answers.department.choice, answers.urgency.score y answers.wants_refund.noul, luego aplique sus umbrales.
Pruebe y simule Jev en Apidog
Un modelo que devuelve probabilidades cambia la forma en que se ve una prueba. Ya no se afirma una cadena; se afirma que un número cruza una línea. Apidog convierte esto en una verificación guardada y repetible en lugar de un `curl` único.
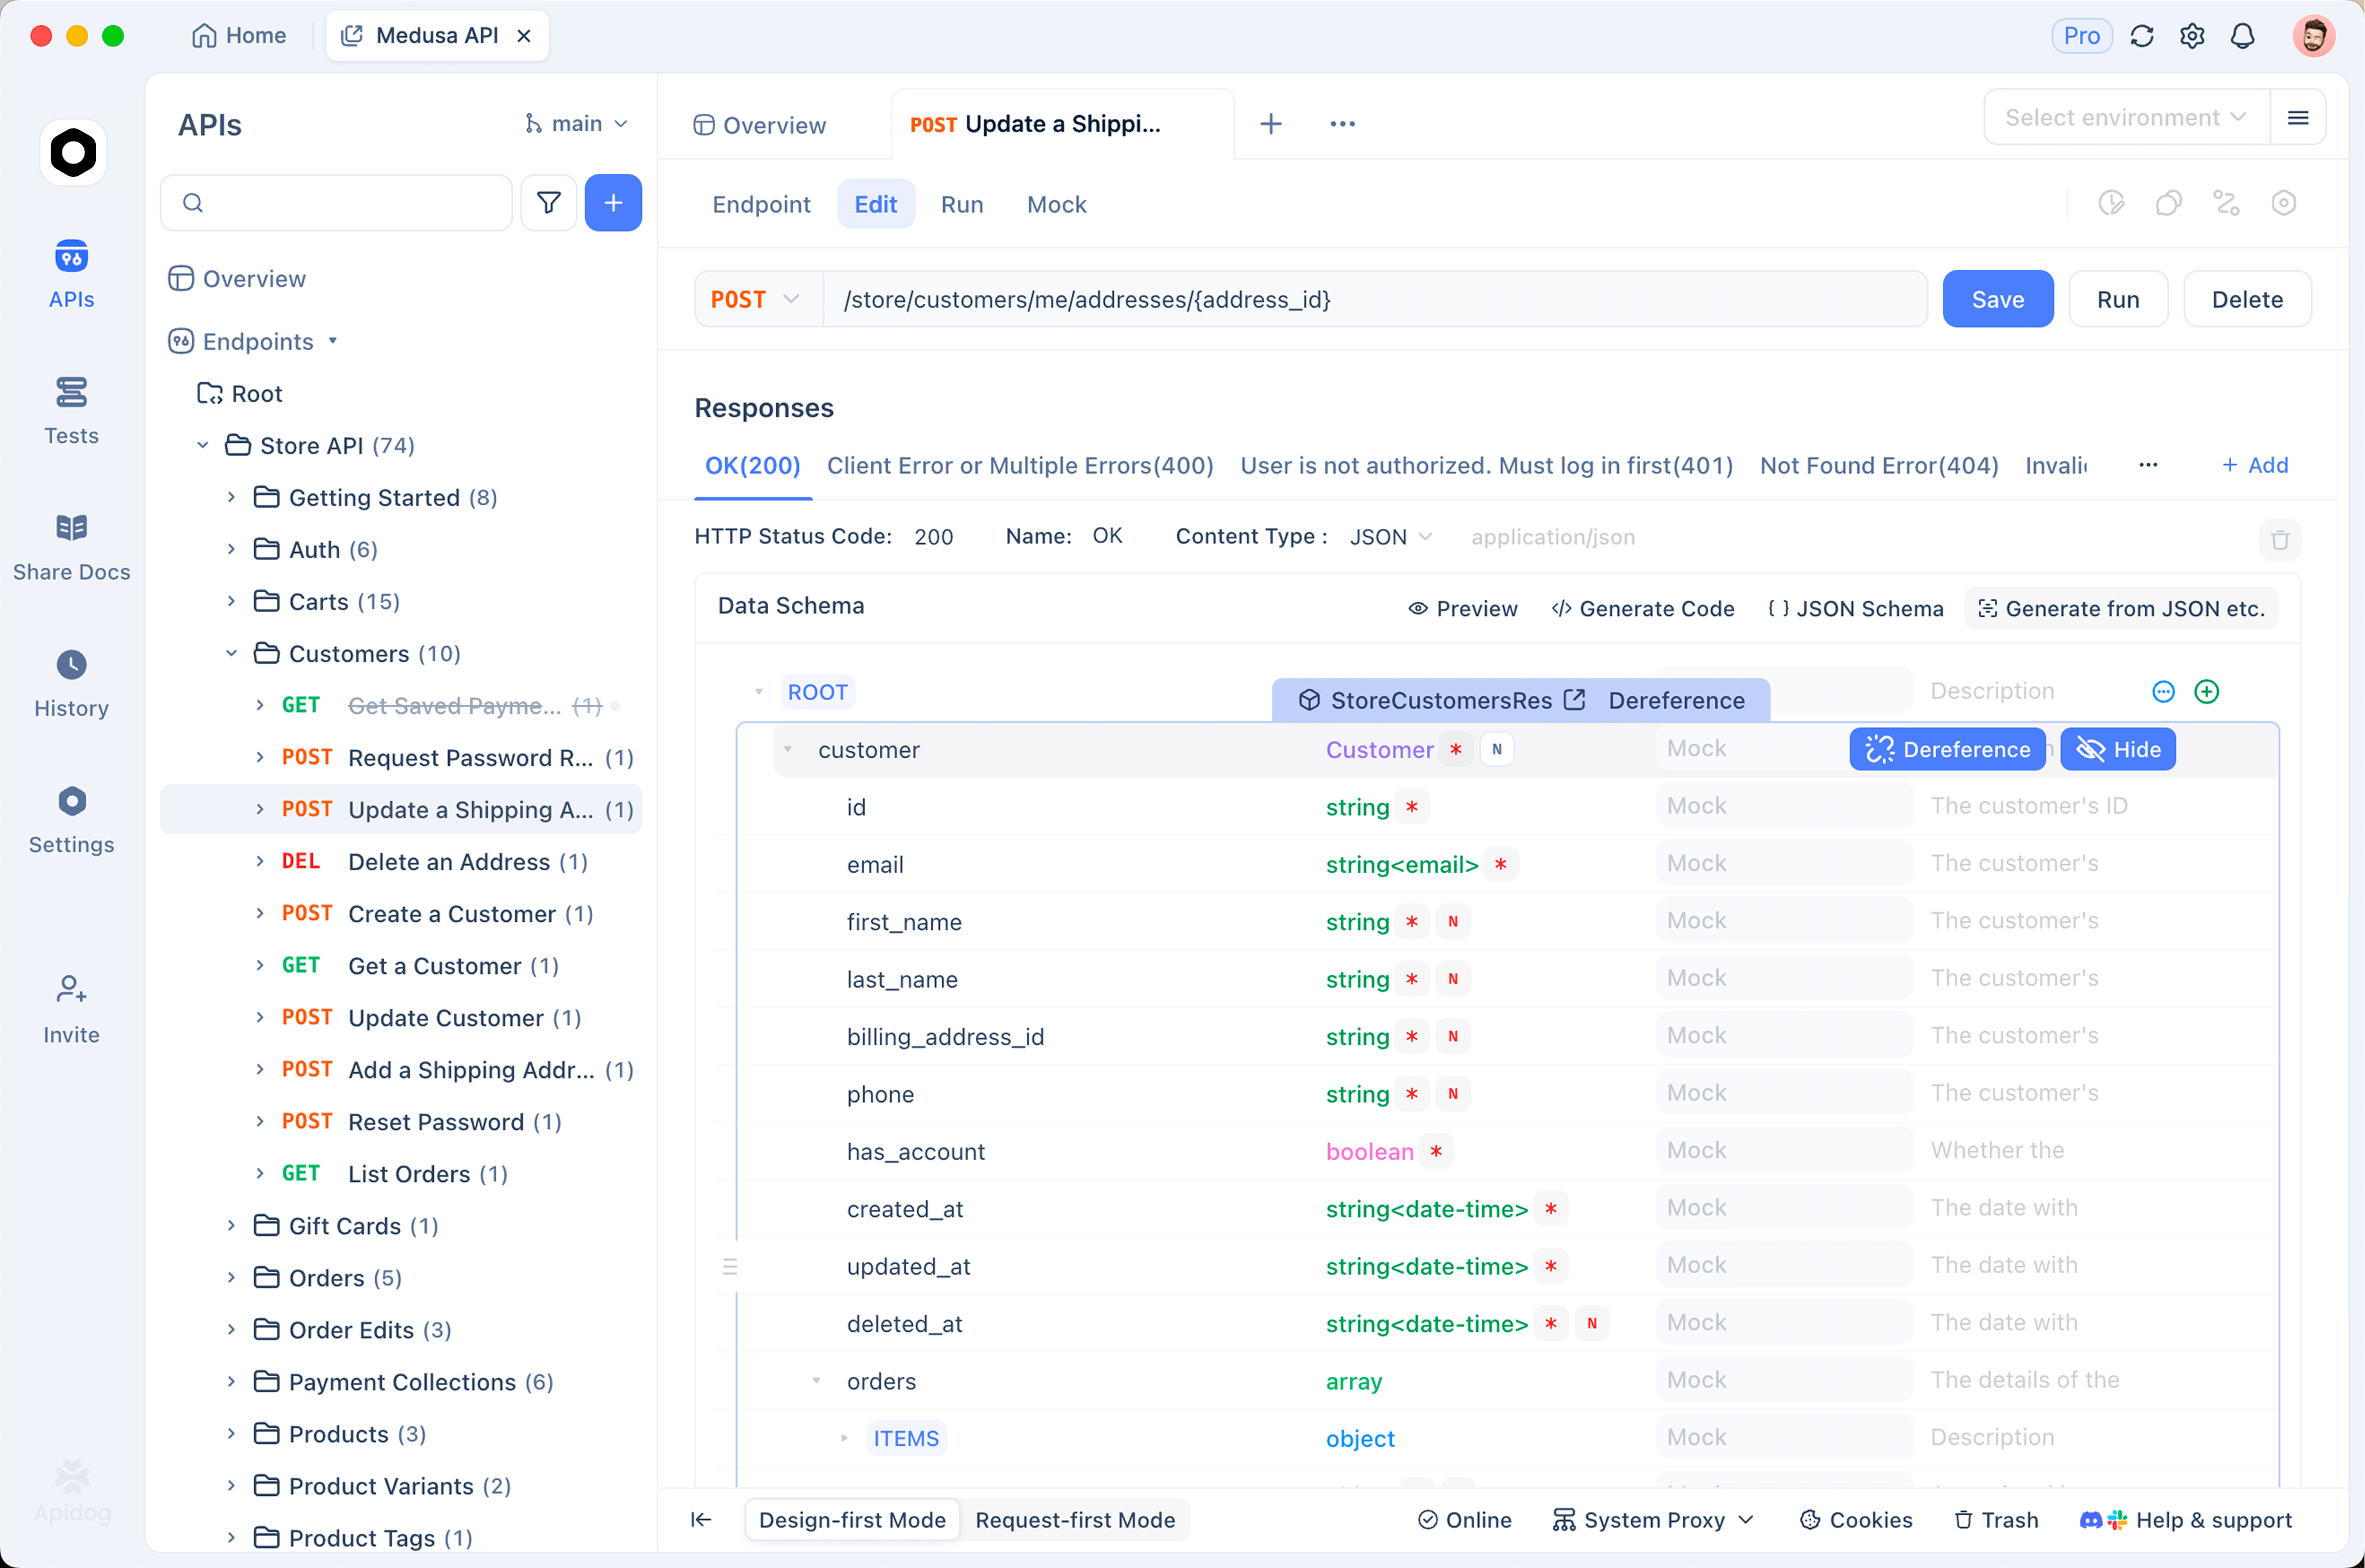
Guarde la clave. Abra la Gestión de Entornos, cree un entorno llamado TypeSafe y añada TYPESAFE_API_KEY con el valor real en el campo local, para que permanezca en su máquina y nunca se sincronice con el equipo. Nuestra guía sobre entornos y variables secretas cubre las reglas de ámbito.
Construya la solicitud. Nueva solicitud, POST https://api.typesafe.ai/v1/systemone, tipo de autenticación Bearer Token con {{TYPESAFE_API_KEY}}, cuerpo JSON del ejemplo de curl. Envíela y lea las respuestas en el panel de respuesta.
Afirme la decisión, no el texto. Agregue aserciones de posprocesador como answers.department.choice es igual a billing, answers.wants_refund.noul es mayor que 0.9, y answers.urgency.score es mayor que 1.5. Ahora una regresión en el comportamiento de Jev, o en la redacción de sus propios criterios, falla una prueba en lugar de enrutar silenciosamente los tickets de manera incorrecta.
Simúlelo para el frontend. Guarde la respuesta como una simulación, y su interfaz de usuario de tickets podrá construirse y probarse contra un objeto answers estable sin gastar tokens ni esperar al modelo. Dado que la forma está declarada, la simulación y la respuesta real no pueden desviarse.
Guárdelo como un escenario. Encadene algunos estados, un mensaje tranquilo, uno enojado, uno ambiguo, y afirme que la confianza disminuye en el caso ambiguo. Esa es la verificación que le dice que su umbral está haciendo su trabajo. Descargue Apidog para configurarlo; el plan gratuito cubre un equipo de cuatro.
Precios, límites y errores
De la página de modelos de TypeSafe:
- Precio: $0.042 por millón de tokens de entrada. Los tokens de salida no se cobran. El Gateway lista el mismo $0.042 por millón de entrada.
- Límites de tasa: 250,000 tokens por segundo y 1,200 solicitudes por minuto, ajustados dinámicamente.
- Contexto: 64k tokens por solicitud, de los cuales 32k son para
statemás la pregunta más larga. - Entrada: solo texto. Una cadena, un objeto JSON o un array de texto. No imágenes, audio o video.
- Idioma: el inglés es lo mejor; otros idiomas funcionan con menor precisión.
Los errores se devuelven como códigos de estado HTTP: 401 para una clave faltante o inválida, 422 cuando el cuerpo no pasa la validación (un Score con un nivel, una Choice sin criterios), 429 para límites de tasa y 529 cuando el servicio está sobrecargado. Espere y reintente en los dos últimos; los SDKs lo hacen por defecto.
Preguntas frecuentes
¿Es Jev un reemplazo para un LLM?
No. Reemplaza la parte de una llamada a LLM donde usted estaba pidiendo una decisión y analizando texto para obtenerla. La generación, el chat y el resumen aún necesitan un modelo de lenguaje.
¿Puede Jev alucinar?
Puede equivocarse, pero no puede producir una respuesta fuera del esquema que usted declaró. El argumento de TypeSafe es que la coincidencia de esquemas está garantizada, por lo que una etiqueta "alucinada" es imposible; una etiqueta incorrecta de baja confianza todavía es posible, por eso la probabilidad importa.
¿Qué significa "calibrado" en la práctica?
Si el modelo dice 0.9, debería acertar aproximadamente el 90% de las veces en ese tipo de pregunta. Eso es lo que le permite elegir un umbral y automatizar por encima de él. Pruébelo con sus propios datos antes de confiar en el número; un escenario guardado en Apidog con estados etiquetados es una forma económica de hacerlo.
¿Necesito Vercel para usar Jev?
No. La API directa en api.typesafe.ai funciona por sí misma con una clave Bearer. Vercel AI Gateway es una conveniencia si ya usa el AI SDK, y es la única ruta que soporta experimental_evaluate. De cualquier manera, los fundamentos de JSON Schema detrás de las formas declaradas valen la pena conocerlos.
Dónde encaja Jev
Recurra a Jev cuando la pregunta tenga un conjunto fijo de respuestas y necesite una probabilidad asociada: enrutamiento, clasificación, puntuación, verificación, barreras de seguridad. Mantenga su modelo de lenguaje para todo lo que necesite palabras. Declare la forma, pruebe los umbrales en Apidog y deje que el número de confianza decida qué se automatiza.