
Grok 4.6 es el modelo de lenguaje de frontera de xAI, lanzado el 12 de agosto de 2026. Se basa en Grok 4.5 con un enfoque en agentes de larga duración, codificación agéntica y trabajo interactivo o visual, ofreciendo una ventana de contexto de 500,000 tokens a $2 por millón de tokens de entrada y $6 por millón de salida. En el Índice de Inteligencia de Artificial Analysis, obtiene una puntuación de 61, igualando al GPT-5.6 Sol de OpenAI y quedando un punto por debajo del Claude Fable 5 de Anthropic, lo que lo convierte en el modelo más económico actualmente en la frontera de la inteligencia.
Esa es la respuesta en un párrafo. El resto de esta publicación cubre lo que realmente cambió con respecto a Grok 4.5, lo que significan los números de los benchmarks, dónde puedes usar el modelo hoy y qué significa para ti si estás construyendo con APIs de LLM. Si esa última parte te describe, Apidog te ofrece un espacio de trabajo gratuito para diseñar, probar y simular llamadas a la API de LLM, útil para probar Grok 4.6 sin tener que escribir un cliente primero.
En resumen
- Lanzamiento: 12 de agosto de 2026, por xAI.
- Enfoque: agentes de largo horizonte, codificación multi-paso, trabajo interactivo y visual. xAI dice que el modelo se auto-prueba y verifica su propio trabajo más a menudo antes de continuar.
- Especificaciones: ventana de contexto de 500K, fecha límite de conocimiento 1 de febrero de 2026.
- Precios: $2 / 1M de entrada, $6 / 1M de salida. Una variante más rápida cuesta el doble. La primera semana incluye el doble de uso en Grok Build y Cursor.
- Benchmarks: Índice de Inteligencia 61 (empata con GPT-5.6 Sol), grandes saltos sobre 4.5 en DeepSWE (54 → 65.9) y APEX-Agents (47.1 → 57.5).
- Dónde usarlo: API de xAI, Grok Build, Cursor, OpenRouter, Vercel y Cloudflare.
Grok 4.6 de un vistazo
| Especificación | Grok 4.6 |
|---|---|
| Desarrollador | xAI |
| Fecha de lanzamiento | 12 de agosto de 2026 |
| Ventana de contexto | 500,000 tokens |
| Fecha límite de conocimiento | 1 de febrero de 2026 |
| Precio entrada / salida | $2 / $6 por 1M de tokens |
| Variante rápida | 2x el precio |
| Índice de Inteligencia | 61 (GPT-5.6 Sol: 61, Claude Fable 5: 62) |
| Disponibilidad | API de xAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
Qué hay de nuevo en comparación con Grok 4.5
Grok 4.6 no es una revelación arquitectónica, es una historia de entrenamiento. Según xAI, el modelo pasó por una fase de entrenamiento suplementario más larga que Grok 4.5, con tres ingredientes que realizaron el trabajo pesado:
- Datos curados generados por modelos dirigidos al razonamiento y conceptos técnicos avanzados.
- Conjuntos de datos de ingeniería de alta calidad, continuando la dieta intensiva en codificación que comenzó cuando xAI inició el entrenamiento con sesiones de desarrollo reales.
- Un optimizador y una receta de entrenamiento mejorados, con trayectorias de ajuste fino supervisado regeneradas a través de áreas de razonamiento y específicas del dominio.
El cambio de comportamiento que los desarrolladores notarán es la auto-verificación. Durante las ejecuciones agénticas largas, Grok 4.6 verifica su propio trabajo antes de pasar al siguiente paso, ejecutando la prueba que acaba de escribir, releyendo el archivo que acaba de editar, en lugar de avanzar precipitadamente basándose en una suposición no verificada. xAI también informa de intentos iniciales más sólidos en proyectos interactivos y visuales: paneles de control, pequeñas aplicaciones y trabajos de interfaz de usuario se acercan más a ser utilizables en la primera pasada.
Si el enfoque de entrenamiento de Grok 4.5 te interesó, nuestro análisis de lo que significó el entrenamiento de sesiones de Cursor para los desarrolladores cubre el linaje sobre el que se construye este modelo.
Los benchmarks, con diferencias significativas
Los números de lanzamiento de los proveedores merecen escepticismo, pero las diferencias de 4.5 a 4.6 son lo suficientemente grandes como para ser significativas. Aquí está el panorama, incluyendo la posición de la competencia:
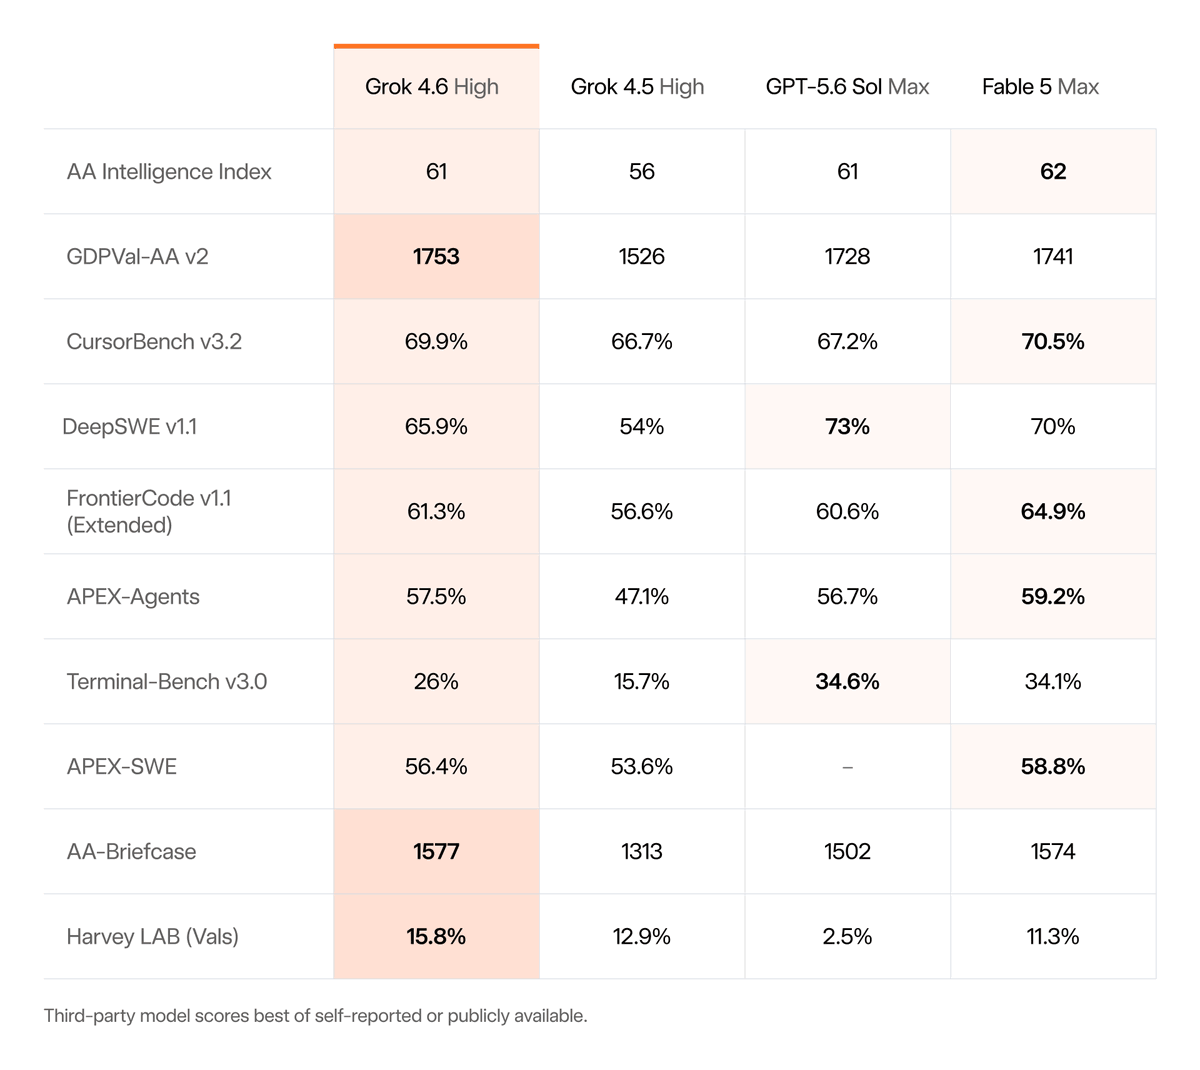
Tres conclusiones clave:
- La brecha de agentes se redujo. El salto de 10.4 puntos en APEX-Agents mueve a Grok de estar “claramente rezagado” a estar a 1.7 puntos de Fable 5 Max, y ligeramente por delante de GPT-5.6 Sol Max (56.7%).
- La codificación a escala de repositorio mejoró más. El aumento de DeepSWE en casi 12 puntos es la diferencia entre un modelo que tropieza con cambios en múltiples archivos y uno que compite, aunque Sol Max todavía lidera ese benchmark por un amplio margen.
- Los números independientes respaldan la historia. Artificial Analysis midió un costo promedio de $0.84 por tarea en sus evaluaciones agénticas, el más bajo entre los modelos de nivel de frontera, y un Elo de 1753 en GDPval-AA v2 para el trabajo de conocimiento profesional.
Para contextualizar cómo interpretar los lanzamientos de benchmarks de xAI, y las advertencias que también se aplicaron a la generación anterior, consulta nuestro análisis de benchmarks de Grok 4.5.
Precios: la propuesta de valor de la frontera
Grok 4.6 mantuvo los precios de Grok 4.5: $2 por millón de tokens de entrada, $6 por millón de salida. Frente a los modelos con los que ahora se compara, esa es una gran diferencia:
| Modelo | Precio de salida / 1M de tokens |
|---|---|
| Grok 4.6 | $6 |
| Claude Opus 4.8 | $25 |
| GPT-5.6 Sol | $30 |
Esa es una diferencia de 5x en el lado de la salida frente a GPT-5.6 Sol para un modelo que lo empata en el índice de inteligencia compuesto. Los tokens baratos no significan automáticamente tareas baratas; una ejecución más débil que necesita revisión y reparación cuesta más que su factura de tokens, pero los datos independientes de costo por tarea sugieren que la eficiencia es real, no solo un precio de etiqueta bajo.
La variante más rápida a 2x el precio ($4/$12) está destinada al uso interactivo sensible a la latencia. Y hasta el 19 de agosto, los usuarios de Grok Build y Cursor obtienen el doble de uso incluido para probar el modelo.
Dónde puedes usar Grok 4.6 hoy
- API de xAI a través de console.x.ai, compatible con OpenAI. Nuestra guía de la API de Grok 4.5 se aplica directamente; solo cambia el nombre del modelo.
- Cursor, disponible como opción de modelo; Cursor publicó sus propias notas de lanzamiento junto con las de xAI.
- Grok Build, el propio espacio de trabajo agéntico de xAI, con el bono de uso doble de la semana de lanzamiento.
- OpenRouter, Vercel y Cloudflare, para equipos que enrutan múltiples modelos a través de una única puerta de enlace; listado como
x-ai/grok-4.6en OpenRouter.
Aquí no hay un lanzamiento separado para el consumidor que desenmarañar: esta es una versión prioritaria para desarrolladores, y la forma más rápida de evaluarla es a través de la API o un IDE que ya la incluya.
Limitaciones y preguntas abiertas
Una evaluación de la semana de lanzamiento debe incluir las advertencias junto con los números principales:
- Los benchmarks son en su mayoría reportados por el proveedor. Artificial Analysis ha publicado puntuaciones independientes que concuerdan en general, pero los números específicos de codificación (DeepSWE, FrontierCode, CursorBench) provienen de la propia tabla de lanzamiento de xAI. Las cifras de lanzamiento de Grok 4.5 se mantuvieron solo parcialmente bajo pruebas independientes; asuma cierta regresión a la media aquí también.
- La ventana de contexto es la más pequeña en la frontera. 500K tokens cubren la mayoría de las cargas de trabajo reales, pero GPT-5.6 Sol ofrece 1.05M y Claude Fable 5 ofrece 1M. Si procesas monorepos enteros o grandes conjuntos de documentos en una sola llamada, esa brecha es significativa.
- Sol aún lidera donde es más difícil. El déficit de 7 puntos en DeepSWE significa que el trabajo totalmente autónomo en grandes bases de código existentes sigue siendo más fuerte en GPT-5.6 Sol Max, y esa es la carga de trabajo de agente más valiosa económicamente.
- La madurez del ecosistema está rezagada. El procesamiento por lotes, los niveles de caché de prompts y los controles de uso en la plataforma xAI son más jóvenes que los equivalentes de OpenAI y Anthropic. La compatibilidad con OpenAI cubre la mayor parte, pero no todo.
Ninguna de estas es descalificatoria. Definen dónde encaja Grok 4.6: la opción de precio-rendimiento que se evalúa seriamente, no la predeterminada que se adopta por reputación.
Qué significa para los desarrolladores de API
La lectura estratégica: la frontera ahora tiene un competidor de precio genuino. Hasta este lanzamiento, igualar la salida de nivel GPT-5.6 Sol significaba pagar entre $25 y $30 por millón de tokens de salida. Grok 4.6 lo hace por $6, lo que cambia las cuentas en los bucles de agentes especialmente; un agente que realiza 40 llamadas al modelo por tarea siente una diferencia de precio de salida de 5x inmediatamente.
Prácticamente, la API compatible con OpenAI significa que evaluarlo cuesta una tarde, no un sprint. Dirige tu cliente existente a https://api.x.ai/v1, ejecuta tu carga de trabajo real contra él y compara. Configura esa comparación en Apidog y podrás mantener las solicitudes de GPT-5.6, Claude y Grok 4.6 lado a lado en un solo proyecto, con entornos por proveedor y aserciones que verifiquen la calidad de la salida, el uso de tokens y la latencia en los tres, una evidencia útil antes de comprometer una carga de trabajo de producción con cualquiera de ellos.
El enfoque del modelo en los agentes también eleva la importancia de la corrección de las llamadas a herramientas. Si tu integración con Grok implica la llamada a funciones, prueba las cargas útiles que genera, no solo el texto que escribe.
Preguntas Frecuentes
¿Qué es Grok 4.6 en una frase? Es el modelo de frontera de xAI de agosto de 2026, optimizado para agentes de larga duración y codificación, con una ventana de contexto de 500K y puntuaciones de benchmark de nivel de frontera a aproximadamente un quinto del precio de salida de los competidores.
¿Es Grok 4.6 mejor que GPT-5.6? Empatan en el Índice de Inteligencia de Artificial Analysis con 61 puntos. GPT-5.6 Sol Max lidera en codificación a escala de repositorio (DeepSWE); Grok 4.6 supera ligeramente en APEX-Agents y cuesta aproximadamente 5 veces menos por token de salida.
¿Cuál es la diferencia entre Grok 4.5 y 4.6? Mismo precio, misma API, modelo significativamente mejor: +11.9 puntos en DeepSWE, +10.4 en APEX-Agents, y una nueva tendencia a la auto-verificación durante tareas largas.
¿Puedo probar Grok 4.6 gratis? Grok Build y Cursor incluyen el doble de uso durante la semana de lanzamiento, y los métodos de nuestra guía para usar Grok 4.5 gratis se aplican en gran medida a 4.6.