
GPT-Live-1.1 es el modelo de voz full-duplex de OpenAI, disponible en la API desde el 20 de noviembre de 2026. Escucha mientras habla, delega el razonamiento y las llamadas a herramientas en un modelo backend que tú eliges, y factura por minuto: $0.05 por minuto activo y $0.02 por minuto en espera. Se accede a través de un único endpoint, v1/live/sessions, no de la Realtime API.
Nuestra publicación anterior sobre qué es GPT-Live cubría la función de voz de ChatGPT antes de que los desarrolladores pudieran llamarla. Esta guía aborda el modelo de la API: qué hay de nuevo, cuánto cuesta, cómo funciona una sesión y cómo se compara con GPT-Realtime.
¿Qué es GPT-Live-1.1?
GPT-Live-1.1 es un modelo de voz que mantiene una conversación hablada en tiempo real mientras un modelo backend separado se encarga del razonamiento. Acepta audio y texto, devuelve audio y texto, y sigue escuchando mientras habla, por lo que quien llama puede interrumpir o añadir detalles a mitad de una frase. Su ID de modelo es gpt-live-1.1, y admite streaming y function calling.
La página del modelo GPT-Live-1.1 lo describe como un «modelo de voz full-duplex para conversaciones multilingües». Full-duplex significa que el audio fluye en ambas direcciones a la vez, como en una llamada telefónica, y no como en un walkie-talkie donde un lado debe esperar.
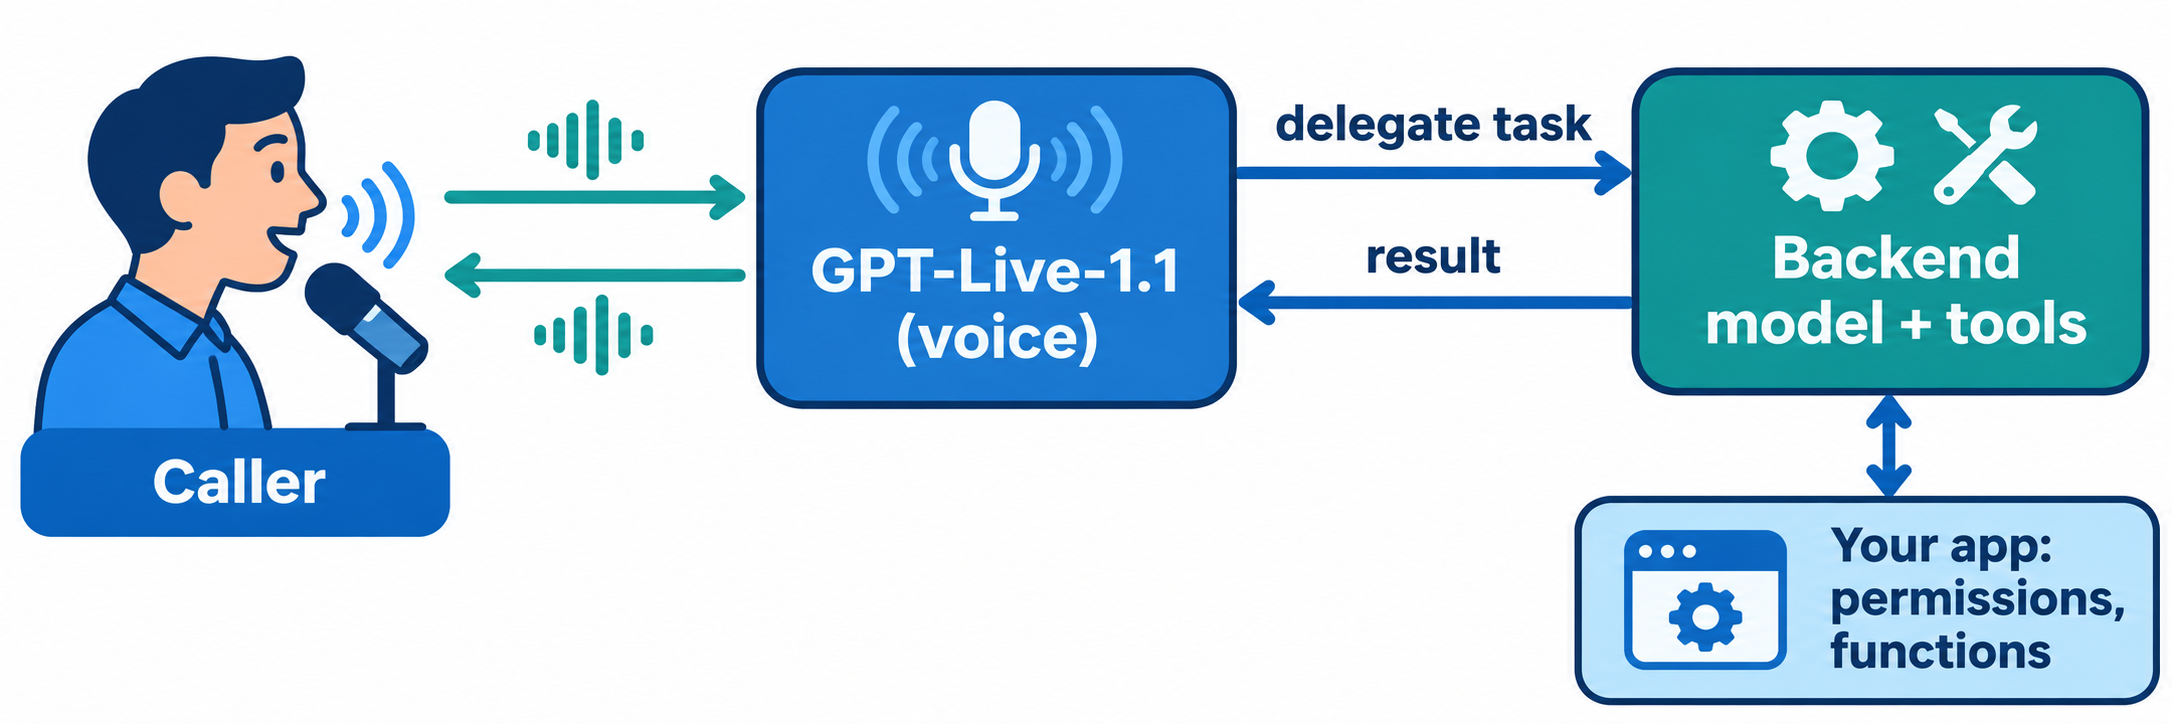
La otra mitad del diseño es la delegación. GPT-Live decide cuándo una solicitud requiere trabajo real, la envía a un backend (un modelo de Responses de OpenAI o tu propio agente), sigue hablando mientras el backend se ejecuta y luego explica el resultado en voz alta.
Qué cambió respecto a GPT-Live-1
GPT-Live-1.1 mantiene el mismo endpoint, precios y conjunto de funciones que GPT-Live-1. Los cambios están en la calidad de voz y el manejo de tareas. Esto es lo que OpenAI indica en la documentación del modelo y en su anuncio en X:
| Área | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| Transcripción de voz | Punto de referencia | Más precisa, según la página del modelo |
| Acento y voz en distintos idiomas | Punto de referencia | Más consistentes, según la página del modelo |
| Sesiones inactivas | Tarifa en espera listada en su página | Modo en espera anunciado como opción nueva, $0.02/min |
| Finalización de tareas | Punto de referencia | «Completa tareas con aún más fiabilidad», según el anuncio de OpenAI |
| Endpoint | v1/live/sessions |
v1/live/sessions |
| Precio (activo) | $0.05/min | $0.05/min |
| Límites de tasa | Sesiones concurrentes | Límite de sesiones concurrentes independiente |
OpenAI no ha publicado cifras de benchmarks sobre las mejoras en transcripción ni fiabilidad, así que trátalas como afirmaciones del proveedor hasta que las midas por ti mismo. Además, el anuncio de OpenAI presenta el modo en espera como novedad de esta versión, mientras que la página de GPT-Live-1 ya lista la misma tarifa de espera de $0.02.
Ambos modelos comparten endpoint y precios, así que el cambio empieza por establecer el model de la sesión en gpt-live-1.1. Después, vuelve a ejecutar tus propias pruebas de evaluación de voz para confirmar las mejoras con tu tráfico.
Precios de GPT-Live-1.1
GPT-Live-1.1 factura las sesiones de voz por duración, no por tokens. Estas son las tarifas de la página de precios de OpenAI, verificadas el 20 de noviembre de 2026:
| Métrica | Precio |
|---|---|
| Tiempo de sesión activo | $0.05 por minuto |
| Tiempo de sesión en espera | $0.02 por minuto |
| Modelo backend y herramientas | Se factura por separado a las tarifas normales de ese modelo |
Algunos detalles de facturación son importantes al estimar costos:
- Facturación por segundo. La duración no se redondea al minuto completo siguiente.
- El modo en espera es solo para WebRTC. La tarifa reducida aplica a sesiones WebRTC mientras la inferencia está en pausa.
- Cargo de inicialización. Crear una sesión WebRTC factura 15 segundos durante la configuración, que se descuentan de los cargos de duración una vez que la sesión está en marcha.
- El backend es una segunda factura. Los tokens delegados de Responses y las llamadas a herramientas también se cobran.
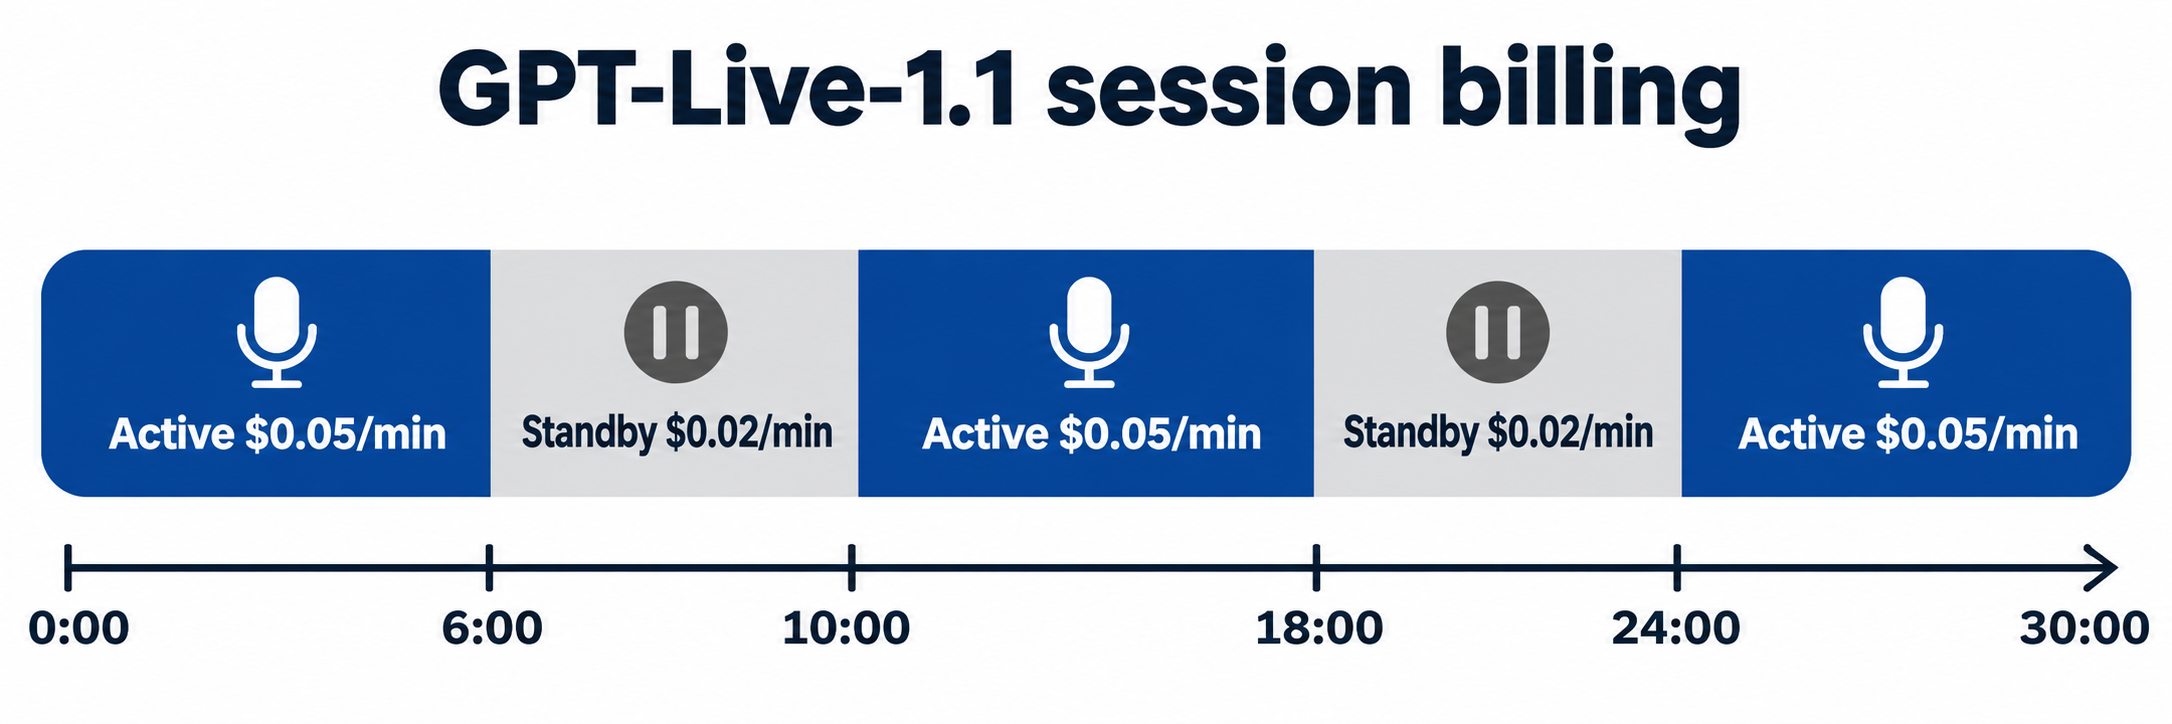
Ejemplo práctico con la línea de tiempo anterior: una sesión de soporte de 30 minutos pasa 20 minutos activa y 10 minutos en espera mientras quien llama busca algo. Costo de voz: 20 x $0.05 + 10 x $0.02 = $1.20. Sin modo en espera, la misma sesión costaría 30 x $0.05 = $1.50. Añade lo que el modelo backend gaste en sus tareas delegadas.
Cómo funciona GPT-Live-1.1: voz más delegación
Una aplicación con GPT-Live tiene dos partes. La guía de inicio las separa así:
- GPT-Live gestiona la conversación. Escucha, habla y decide cuándo pedir ayuda al backend. Le das un prompt breve sobre el estilo de habla y cuándo delegar.
- El backend se encarga de las tareas delegadas. Razona, llama a herramientas y devuelve resultados para que GPT-Live los diga en voz alta. Las instrucciones detalladas, las reglas de negocio y los flujos de trabajo de herramientas viven aquí.
- Tu aplicación controla las partes críticas. Verifica permisos, recopila confirmaciones, ejecuta funciones que interactúan con tus sistemas y guarda el progreso de las tareas.
Al crear la sesión eliges uno de los dos modos de delegación, y no puedes cambiar de modo a mitad de sesión:
| Modo | Quién ejecuta el backend | Elígelo cuando |
|---|---|---|
| Delegación Responses | OpenAI llama al modelo de Responses que configuras y pasa el contexto y los resultados | Quieres que GPT-Live gestione las solicitudes al backend por ti |
| Delegación del cliente | Tu aplicación ejecuta cualquier modelo, agente o servicio y devuelve los resultados | Necesitas validar, censurar o combinar resultados, o usar un backend que no sea de OpenAI |
La guía de delegación recomienda empezar con la delegación Responses. La delegación del cliente encaja con los equipos que añaden voz a un agente de texto existente.
Crea tu primera sesión con GPT-Live-1.1
GPT-Live tiene su propio endpoint. La página del modelo lista v1/live/sessions como compatible y marca Chat Completions, Responses y v1/realtime como no compatibles. OpenAI recomienda WebRTC para el audio, con WebSockets y SIP como alternativas.
El flujo WebRTC de la guía rápida se ejecuta en cinco pasos:
- El navegador solicita acceso al micrófono y añade sus pistas a una conexión peer-to-peer.
- Crea un canal de datos y, después, una oferta SDP.
- El navegador envía la oferta a tu servidor.
- Tu servidor envía
sessionytransport: { type: "webrtc", sdp }aPOST /v1/live/sessionscon tu clave de API. - El navegador aplica la respuesta SDP recibida y espera
session.started.
Aquí está la llamada del servidor del ejemplo en TypeScript de OpenAI, recortada a la configuración de la sesión:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
Mantén la clave de API en el servidor y no envíes session.start por el canal de datos: la petición HTTP ya inicia la sesión. OpenAI también ofrece la OpenAI Live Console, una aplicación de ejemplo local para observar conversaciones, delegación y actividad de las herramientas del backend.
Modo en espera: reduce los costos de inactividad
El modo en espera mantiene abierta la conexión WebRTC mientras nadie habla y reanuda la inferencia cuando alguien habla. La conexión y el ID de sesión permanecen iguales, y el historial de conversación se recupera cuando la sesión se reanuda.
Se activa con dos campos de la sesión:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"espera a detectar voz antes de iniciar la inferencia.idle_timeout_sacepta un número entero entre 5 y 60. Tras esa cantidad de segundos sin transcripciones de entrada ni salida, la sesión pasa a modo en espera.vad_thresholdva de 0 a 1 y su valor predeterminado es 0.5. Valores más altos requieren evidencia más clara de voz para activarse.
Escucha los eventos session.paused y session.resumed para seguir el estado, y mantén activa la pista del micrófono. Una limitación señalada en la guía de gestión de sesiones: la primera respuesta a una frase corta tras el modo en espera puede tardar más. En pausas largas, cerrar la sesión e iniciar una nueva puede costar menos que el modo en espera.
GPT-Live-1.1 vs GPT-Realtime
La guía de agentes de voz de OpenAI plantea la elección según la arquitectura. GPT-Live encaja en conversaciones full-duplex con un backend separado. La Realtime API encaja en un único modelo que escucha, razona, llama a herramientas y habla en una sola sesión.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Diseño | Frontend de voz más backend delegado | Un solo modelo de voz a voz |
| Entrada | Audio, texto | Texto, audio, imagen |
| Facturación | $0.05/min activo, $0.02/min en espera | Por token: $32 de entrada, $64 de salida por cada 1M de tokens de audio |
| Costo del backend | Se factura por separado | Incluido en el precio por token |
| Ideal para | Añadir voz a un agente de texto existente | Agentes de voz autónomos |
La facturación por minuto hace que los costos de voz de GPT-Live sean fáciles de prever en llamadas largas. La facturación por tokens en Realtime depende de cuánto audio y texto fluya, e incluye el razonamiento en un solo precio. Para ver en detalle la comparación anterior, consulta GPT-Live vs GPT-Realtime y nuestra guía de la API de GPT-Realtime-2.
Límites de tasa y acceso
Los límites de GPT-Live cuentan sesiones concurrentes, no tokens. GPT-Live-1.1 y GPT-Live-1 tienen límites independientes que aplican en todas las regiones de inferencia. La página de GPT-Live-1 lista 50 sesiones concurrentes en el tier Build, 300 en Launch y 500 en Grow, y marca el tier Free como no compatible. La página de GPT-Live-1.1 aún no publica su propia tabla, así que consulta la página de límites de tu organización antes de planificar la carga.
Prueba tu servidor de sesiones con Apidog CLI
Tu integración de GPT-Live tiene una superficie HTTP que es tuya: el endpoint /api/session que intercambia ofertas SDP. El ejemplo de OpenAI devuelve 403 para un origen inesperado y 400 para una oferta SDP ausente. Esas rutas nunca llegan a OpenAI, así que puedes probarlas en cada commit a costo cero de voz. Deja que tu agente de programación escriba y ejecute las pruebas con Apidog CLI.
Instala la CLI, inicia sesión y añade la skill de Apidog a tu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un solo prompt:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
El agente lee los esquemas, valida sus payloads, crea el endpoint y los casos, y después los ejecuta:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
El mismo apidog run con -r junit se integra en CI; consulta cómo ejecutar Apidog CLI en un pipeline de CI/CD. Si usas Claude Code, la guía de Apidog CLI en Claude Code explica la configuración paso a paso. El plan Free de Apidog cubre equipos de hasta 4 usuarios.
Preguntas frecuentes
¿Está GPT-Live-1.1 disponible en la API? Sí. OpenAI puso GPT-Live-1.1 a disposición en la API el 20 de noviembre de 2026, con el ID de modelo gpt-live-1.1 en el endpoint v1/live/sessions. Nuestra publicación anterior sobre la API de GPT-Live es anterior a ese lanzamiento.
¿Cuánto cuesta GPT-Live-1.1? $0.05 por minuto activo y $0.02 por minuto en espera, facturados por segundo. El uso del modelo backend y de las herramientas se factura por separado a sus tarifas normales.
¿Cuál es la diferencia entre GPT-Live-1 y GPT-Live-1.1? GPT-Live-1.1 transcribe la voz con mayor precisión, mantiene un acento y una voz más consistentes entre idiomas y añade una opción de espera para sesiones inactivas. Los precios y el endpoint son los mismos.
¿Puede GPT-Live-1.1 ver imágenes? No directamente. Envía las imágenes a un modelo backend con capacidades de visión, que devuelve texto para que GPT-Live lo utilice.
¿GPT-Live-1.1 admite function calling? Sí. La página del modelo lista streaming y function calling. En la práctica, tu backend gestiona las llamadas a herramientas mediante delegación, y tu aplicación ejecuta las funciones personalizadas.