
El nivel más barato en una familia de modelos solía ser el nivel en el que no confiabas. Enviabas tráfico de clasificación, resumen y reintento allí, mantenías cualquier cosa 'agentic' en el modelo insignia, y aceptabas que el modelo económico fallaría en el momento en que una tarea necesitara más de un paso.
GPT-6 Luna, anunciado el 22 de septiembre de 2026, tiene un precio similar a ese nivel y no se comporta como tal. Cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida, tiene una ventana de contexto de 1 millón de tokens, y los números publicados por OpenAI lo sitúan dentro del rango de modelos de vanguardia en los benchmarks de codificación 'agentic' a una pequeña fracción de su costo por tarea.
Una cosa que aclarar primero: este no es el GPT-5.6 Luna que quizás ya tengas conectado en una cadena de respaldo. Mismo nombre de nivel, nuevo modelo, nuevo precio, nueva ventana de contexto. Asumir lo contrario es una manera fácil de introducir un cambio de comportamiento silencioso y solo enterarte por un ticket de soporte.
GPT-6 Luna de un vistazo
| Elemento | Valor |
|---|---|
| ID del modelo API | gpt-6-luna |
| Precio de entrada | $0.10 por millón de tokens |
| Precio de salida | $0.50 por millón de tokens |
| Lecturas de entrada en caché | 90% de descuento |
| Ventana de contexto | 1,000,000 de tokens |
| Índice de Inteligencia de Análisis Artificial | 37 |
| Anunciado | 22 de septiembre de 2026, junto con GPT-6 Sol |
| Disponible en | ChatGPT Work y Codex, la aplicación de escritorio para usuarios Free y Go, además de la API |
| No disponible en | Chat, a partir del lanzamiento |
Dentro de la misma familia, GPT-6 Sol cuesta $2/$10 con una ventana de 872,000 tokens y un índice de 48, y GPT-6 Astra cuesta $10/$50. OpenAI afirma que Astra "sigue siendo nuestro mejor modelo en todos los aspectos", por lo que Luna no se vende como el modelo más inteligente. Se vende como aquel en el que el costo por tarea se desplomó.
Es un modelo nuevo, no un nivel renombrado
La familia GPT-5.6 estaba compuesta por Sol, Terra y Luna. La familia GPT-6 está compuesta por Astra, Sol y Luna. Dos nombres se mantuvieron, Terra no, y Astra es nuevo. OpenAI describe a Sol y Luna como entrenados con métodos similares a GPT-6 Astra, lo que significa que son nuevos modelos que comparten una convención de nombres con los antiguos.
No hay GPT-6 Terra. Si construiste una lógica de enrutamiento basada en el esquema de nombres de GPT-5.6, el escalón intermedio ya no existe, y nuestra comparación anterior de Sol contra Terra y Luna ahora se lee como historia en lugar de una guía actual.
El linaje de precios muestra cuánto se movió el nivel:
| Nivel | Precio de lista GPT-5.6 | Promocional GPT-5.6 | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | no hay GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Todas las cifras son por millón de tokens de entrada y por millón de tokens de salida. Las filas de GPT-5.6 provienen de nuestra cobertura en ese momento, precios de GPT-5.6 y la reducción de precio de GPT-5.6.
OpenAI describe a Sol y Luna como un 50% más baratos que los precios promocionales de GPT-5.6. La palabra "promocional" es propia de OpenAI y cambia el significado de la afirmación: la comparación se realiza frente a una tarifa con descuento, no la tarifa con la que se lanzó GPT-5.6. Medido contra el precio de lista de GPT-5.6 Luna de $1/$6, GPT-6 Luna a $0.10/$0.50 representa un recorte del 90% en la entrada y un 92% en la salida. La reducción real es mayor que el titular, y el titular se mide a partir de un descuento. Coloca el segundo número en tu modelo de presupuesto, no el primero.
El modelo económico tiene la ventana de contexto más grande
Este es el detalle que la mayoría de la cobertura de lanzamiento pasó por alto. Luna se entrega con una ventana de contexto de 1,000,000 de tokens. Sol, con un precio veinte veces mayor, se entrega con 872,000.
Eso invierte una suposición que mucho código de enrutamiento codifica: que se promueve una solicitud a un modelo más caro cuando la carga útil crece. Con GPT-6, la ventana más grande de la familia se encuentra en la parte inferior de la lista de precios. Un documento de 900,000 tokens no cabe en Sol y sí cabe en Luna.
La aritmética se deriva de los dos precios. Llenar la ventana completa de Luna una vez cuesta $0.10 en tokens de entrada. Llenar la ventana de 872,000 tokens de Sol una vez cuesta aproximadamente $1.74. Llenar la ventana de 1M de Claude Opus 5.5 a $4 por millón cuesta $4.00. La misma clase de carga útil, una diferencia de cuarenta veces en lo que pagas por leerla.
Si se añade el trabajo de almacenamiento en caché de OpenAI, la brecha se amplía de nuevo. GPT-6 aplica un descuento del 90% a las lecturas de entrada en caché, por lo que un prefijo de 1 millón de tokens que permanece en caché en varias llamadas cuesta aproximadamente $0.01 volver a leerlo en lugar de $0.10. OpenAI también dice que GPT-6 obtiene mayores tasas de acierto de caché por defecto, que cambiar el esfuerzo de razonamiento o la disponibilidad de herramientas ya no invalida la caché, y que los puntos de interrupción explícitos permiten controlar dónde termina un prefijo en caché. GitHub informa de más del 50% menos de tokens de prompt que necesitan procesamiento nuevo en miles de millones de solicitudes.
Lo que publicó OpenAI
Cada número a continuación proviene del material de lanzamiento de OpenAI. Los ajustes de esfuerzo de razonamiento aparecen entre paréntesis, porque estos modelos puntúan de manera muy diferente en distintos niveles de esfuerzo y una fila de benchmark sin su ajuste de esfuerzo no es un número utilizable.
| Referencia | GPT-6 Luna | Punto de comparación |
|---|---|---|
| DeepSWE 1.1 | 66.6% (máx.) | Comparable a Claude Opus 5 y Claude Fable 5 en nivel medio, 93% más barato por tarea que Opus 5 y 96% más barato que Fable 5 |
| AutomationBench 1.0.6 | Supera a su predecesor en 5.4 puntos (alto) | Con un 58% menos de costo por tarea |
| OSWorld 2.0 offline | Supera a GPT-5.6 Sol (medio) con el máximo esfuerzo | Aproximadamente a una décima parte del costo |
| Veracidad | Iguala a GPT-5.6 Sol con mayor esfuerzo | Aproximadamente a una centésima parte del costo |
La fila de DeepSWE es la que hay que considerar. Un modelo a $0.10 por millón de tokens de entrada que obtiene un 66.6% en un benchmark de ingeniería de software 'agentic', en el mismo territorio que dos modelos de vanguardia con esfuerzo medio, por un 93% menos por tarea que uno de ellos, es una propuesta diferente a la de un nivel económico. No significa que Luna reemplace a un modelo de vanguardia en tu trabajo más difícil. Significa que el límite entre "enviar esto al modelo barato" y "esto necesita el caro" se ha movido, y dondequiera que hayas trazado esa línea antes de septiembre de 2026, ahora está trazada en el lugar equivocado.
El resultado de veracidad es el que probablemente más importe para el trabajo de producto ordinario. Igualar el nivel medio de la generación anterior en precisión fáctica, a aproximadamente una centésima parte de su costo, es lo que hace que Luna sea viable para la extracción y el resumen orientados al usuario en lugar de solo trabajos internos por lotes.
Cada comparación aquí es contra Claude Opus 5
Fíjate contra qué modelo de Claude se comparan esas filas. Claude Opus 5.
Anthropic lanzó Claude Opus 5.5 el mismo día, a $4/$20 frente a los $5/$25 de Opus 5, y ocupó el primer puesto en el Índice de Inteligencia de Análisis Artificial con 58, clasificado como el primero de 212 modelos. La publicación de lanzamiento de OpenAI se escribió antes de que existiera Opus 5.5, por lo que cada comparación de costo por tarea contra Opus 5 se mide contra un modelo que fue reemplazado a las pocas horas de su publicación.
Eso no hace que las cifras de OpenAI sean incorrectas. Son precisas para la comparación que se realizó. Sí significa que no deberías llevar "93% más barato que Opus 5" a un documento de adquisición como el estado actual del mercado sin decir a qué Opus se refiere. Ningún proveedor ha publicado una comparación directa de Luna contra Opus 5.5, y las comparaciones que circulan en las redes sociales provienen de probadores individuales en lugar de cualquiera de los laboratorios. Nuestro pilar de la guerra de precios rastrea los tres lanzamientos entre sí en una sola tabla.
Latencia: el modelo económico no es el modelo rápido
Las mediciones de terceros de Artificial Analysis sitúan a GPT-6 Luna en 153.9 tokens de salida por segundo con un tiempo hasta el primer token de 124.23 segundos. Se aplican dos advertencias y ambas son cruciales. Son cifras de terceros, no publicadas por el proveedor. Y se miden en la variante de razonamiento máximo, la configuración más lenta y cara disponible.
Incluso con ambas advertencias, la dirección merece ser asimilada: Luna mide un tiempo hasta el primer token más lento que Sol, que mide 102.15 segundos. El precio y la latencia no están correlacionados en esta familia. Una espera de dos minutos antes de que llegue el primer token romperá un tiempo de espera predeterminado del cliente HTTP, dejará inactivo un equilibrador de carga y excederá el límite de ejecución en la mayoría de los entornos sin servidor. Si estás enrutando un endpoint síncrono a Luna con mucho esfuerzo, el trabajo de integración reside en tu capa de tiempo de espera y streaming, no en tu prompt.
Pruébalo con tu propia carga de trabajo antes de enrutarle tráfico
Las tablas de referencia son agregadas. Tu prompt no lo es. La pregunta útil es si Luna se mantiene en tu tráfico a un nivel de esfuerzo que puedes permitirte, y eso lleva unos diez minutos responderlo correctamente.
Configura una solicitud por modelo, parametriza el ID del modelo y ejecuta la misma carga útil en todos los niveles:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Confirma el endpoint y los nombres de los parámetros con la referencia del modelo actual de OpenAI antes de construir sobre esta estructura. El ID del modelo `gpt-6-luna` es la parte que se confirma a partir del material de lanzamiento.
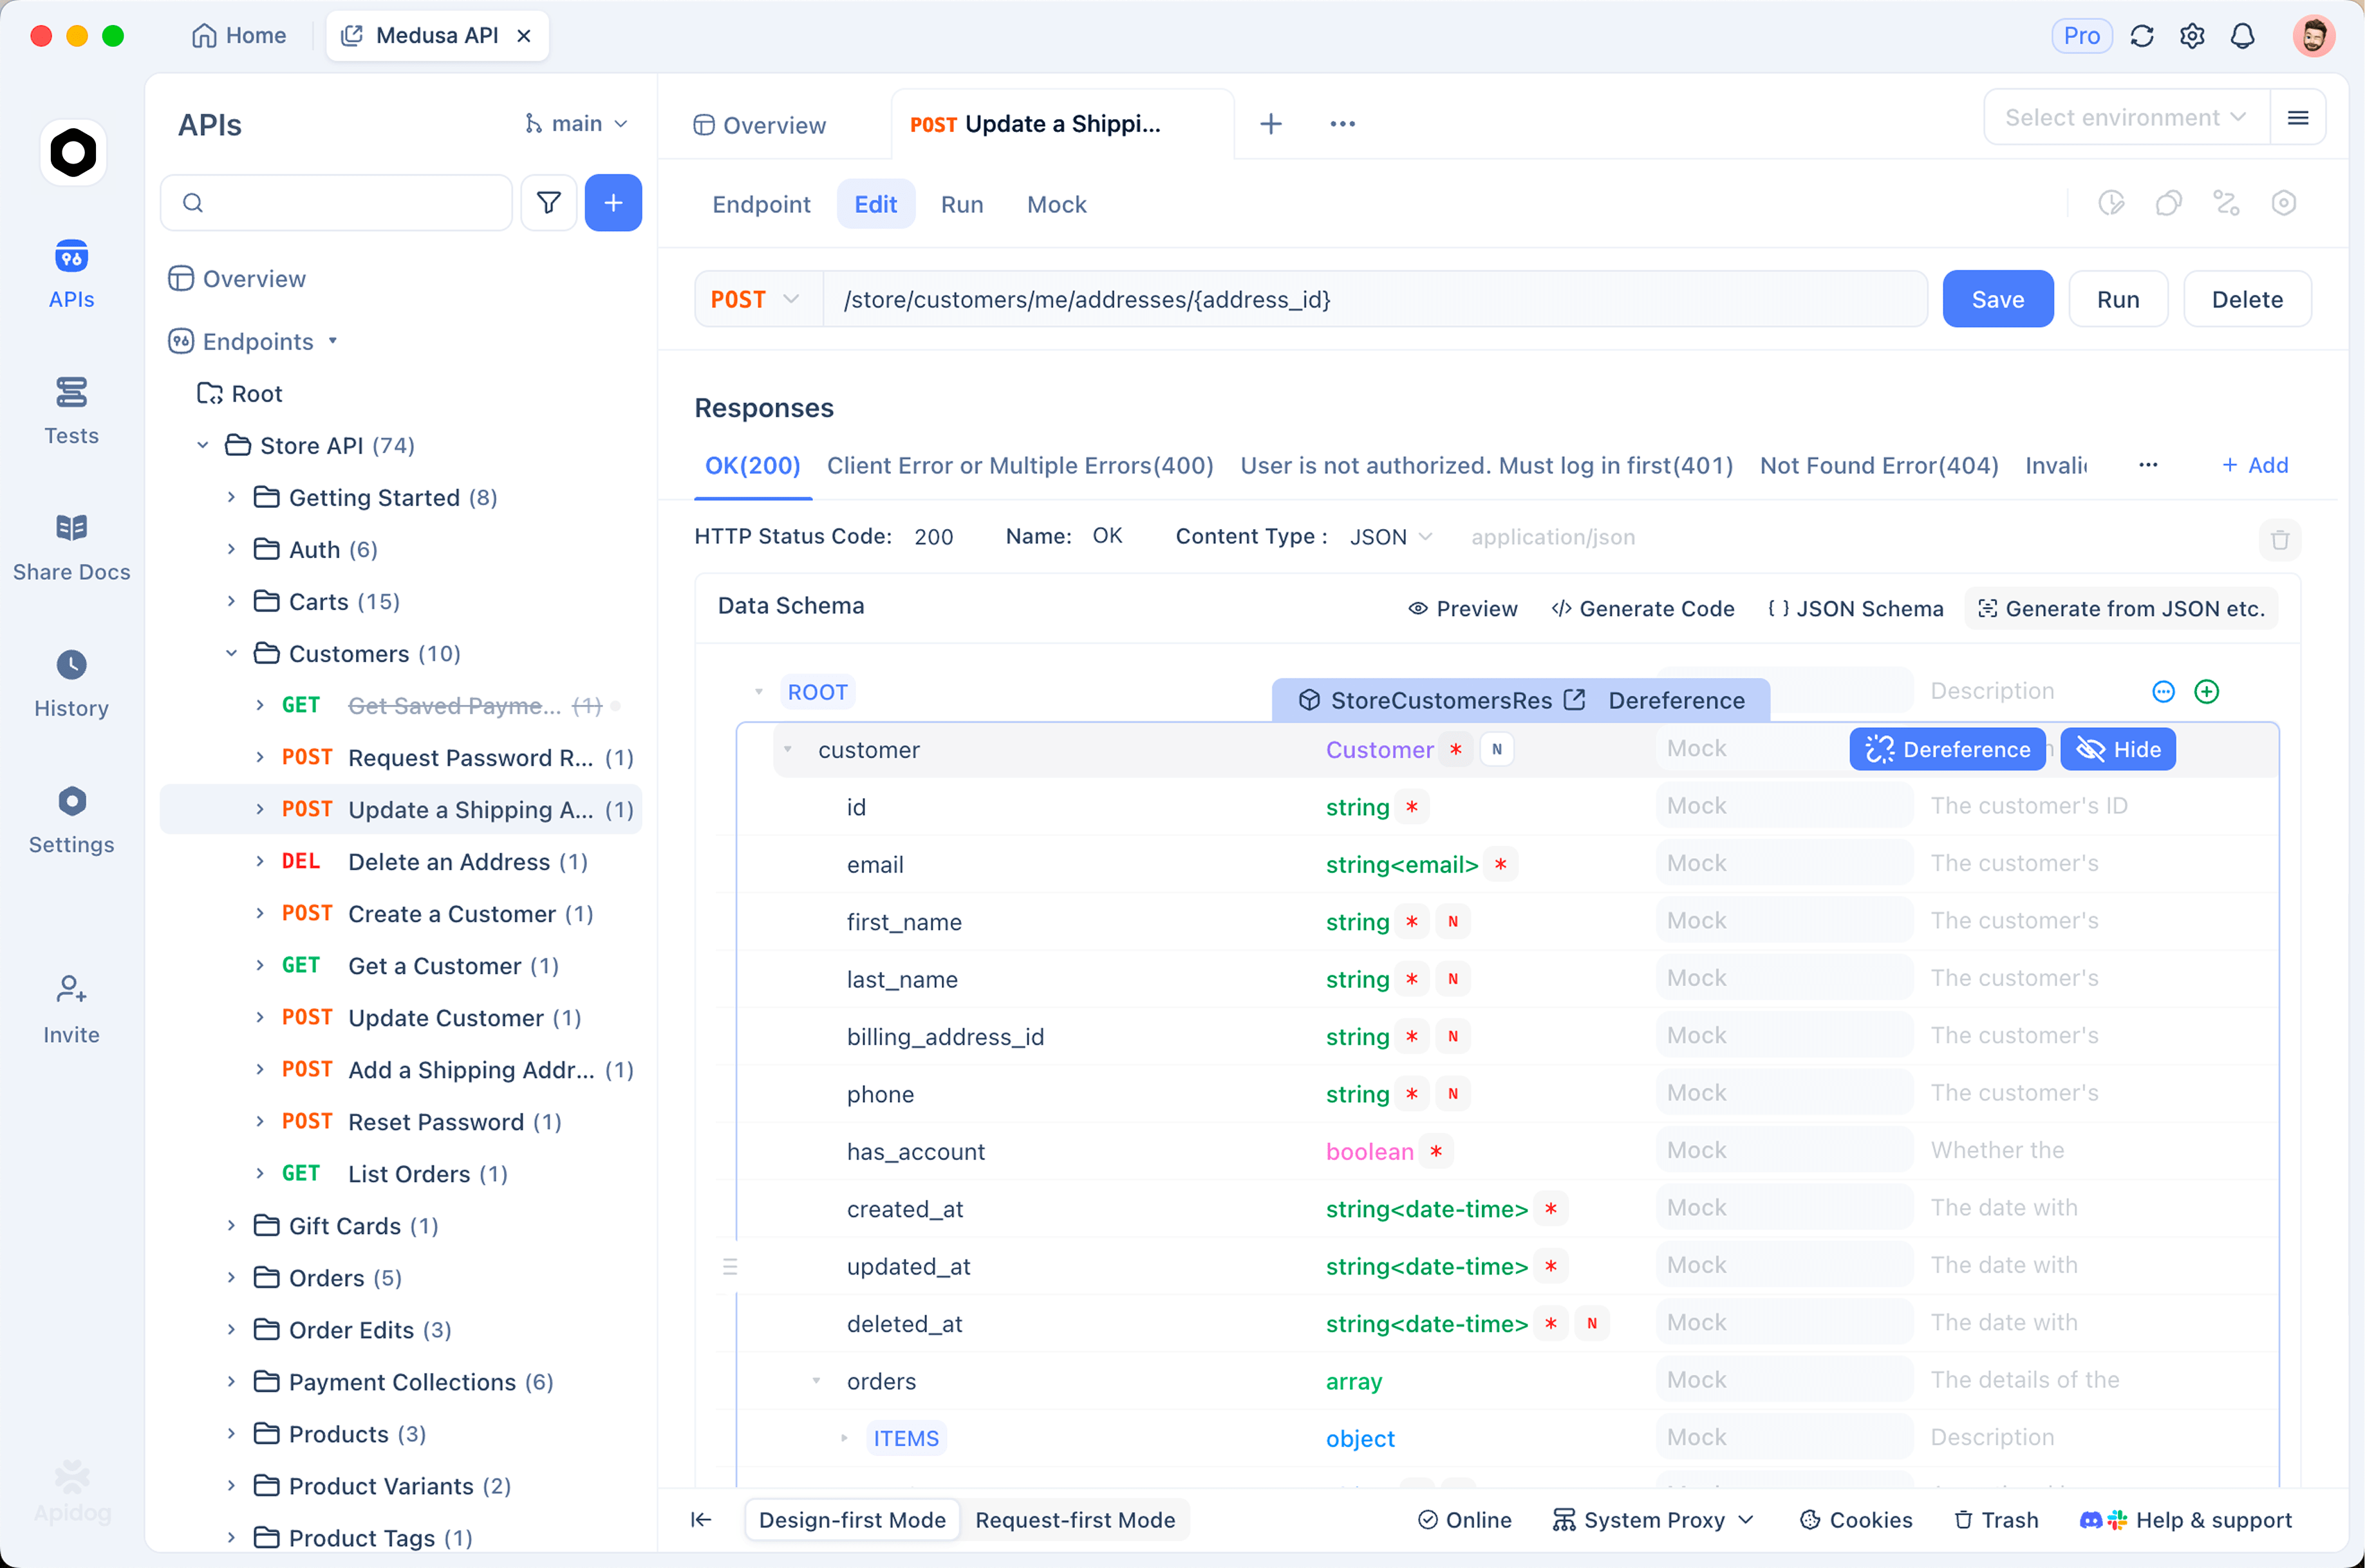
En Apidog, la misma solicitud se convierte en un endpoint guardado con el ID del modelo como variable de entorno, de modo que una única colección cubre Luna, Sol y Astra sin duplicar nada. Ejecútalo como un escenario de prueba y obtendrás el tiempo de respuesta y el uso de tokens por ejecución, además de aserciones sobre la forma de la respuesta, que es lo que detecta el verdadero modo de fallo de un modelo más barato: no una respuesta incorrecta, sino una respuesta que deja de ajustarse al esquema JSON que tu analizador espera. Ejecuta el mismo escenario en tres niveles de esfuerzo y tendrás una tabla de costos, latencia y fiabilidad para tus propios prompts, en lugar de para el conjunto de benchmarks de otra persona.
Cuándo Luna es la elección correcta
Enruta a Luna cuando la carga útil es grande, la tarea está bien especificada y puedes verificar la salida programáticamente. La extracción de documentos, el análisis de especificaciones, el triaje de logs, la generación de pruebas, la clasificación de gran volumen y cualquier trabajo por lotes donde una ventana de 1M te ahorra una pipeline de fragmentación, todo califica, y el descuento por caché se incrementa cuando un prefijo largo se mantiene estable entre llamadas.
Reserva el nivel caro para el trabajo donde no puedes verificar la respuesta de forma económica, y para cualquier cosa sensible a la latencia hasta que hayas medido el tiempo hasta el primer token en tu propio tráfico. Luna movió la línea. No la borró.