
Gemini 4 Neon es el nuevo modelo intermedio de Google en la familia Gemini 4, lanzado el 18 de noviembre de 2026, para programación compleja, análisis y flujos de trabajo empresariales que se ejecutan con frecuencia. Cuesta 3 $ por millón de tokens de entrada y 15 $ por millón de tokens de salida, comparte una ventana de contexto de 1 M de tokens con su salida, ofrece cuatro niveles de razonamiento y está disponible solo en el nivel de pago de la API de Gemini.
Si Hydrogen te resulta demasiado ligero para tus pasos difíciles y Carbon demasiado pesado para ejecutarse todo el día, Neon es la respuesta de Google. Esto es lo que se ha lanzado, dónde encaja y qué sigue sin estar claro.
¿Qué es Gemini 4 Neon?
Gemini 4 Neon (gemini-4-neon) es el nivel equilibrado de la familia Gemini 4 de Google. Google lo describe como “inteligencia de frontera con finalización rápida de tareas de extremo a extremo” para ingeniería de software, trabajo del conocimiento y ciencia. Se sitúa entre Gemini 4 Hydrogen, el modelo rápido para el día a día, y Gemini 4 Carbon, el modelo para tus proyectos más difíciles de largo alcance.
Los datos clave, extraídos de la publicación de lanzamiento de Google y de la página del modelo en AI Studio:
| Especificación | Gemini 4 Neon |
|---|---|
| ID del modelo | gemini-4-neon (estable) |
| Lanzamiento | 18 de noviembre de 2026 |
| Entrada | Texto, imagen, video, audio, PDF |
| Salida | Solo texto |
| Ventana de contexto | 1.048.576 tokens, compartida entre entrada y salida |
| Salida máxima | 65.536 por solicitud, hasta 1.048.576 con long decode |
| Niveles de razonamiento | low, medium, high (predeterminado), xhigh |
| Precio (estándar) | 3,00 $ entrada, 15,00 $ salida por 1 M de tokens |
| Entrada en caché | 0,15 $ por 1 M de tokens (solo caché implícita) |
| Nivel gratuito de API | No |
Es compatible con function calling, salidas estructuradas, ejecución de código, computer use, búsqueda de archivos, contexto de URL y grounding con Google Search y Google Maps. No genera imágenes ni audio, y no está disponible en la Live API.
Gemini 4 Neon vs Carbon vs Hydrogen
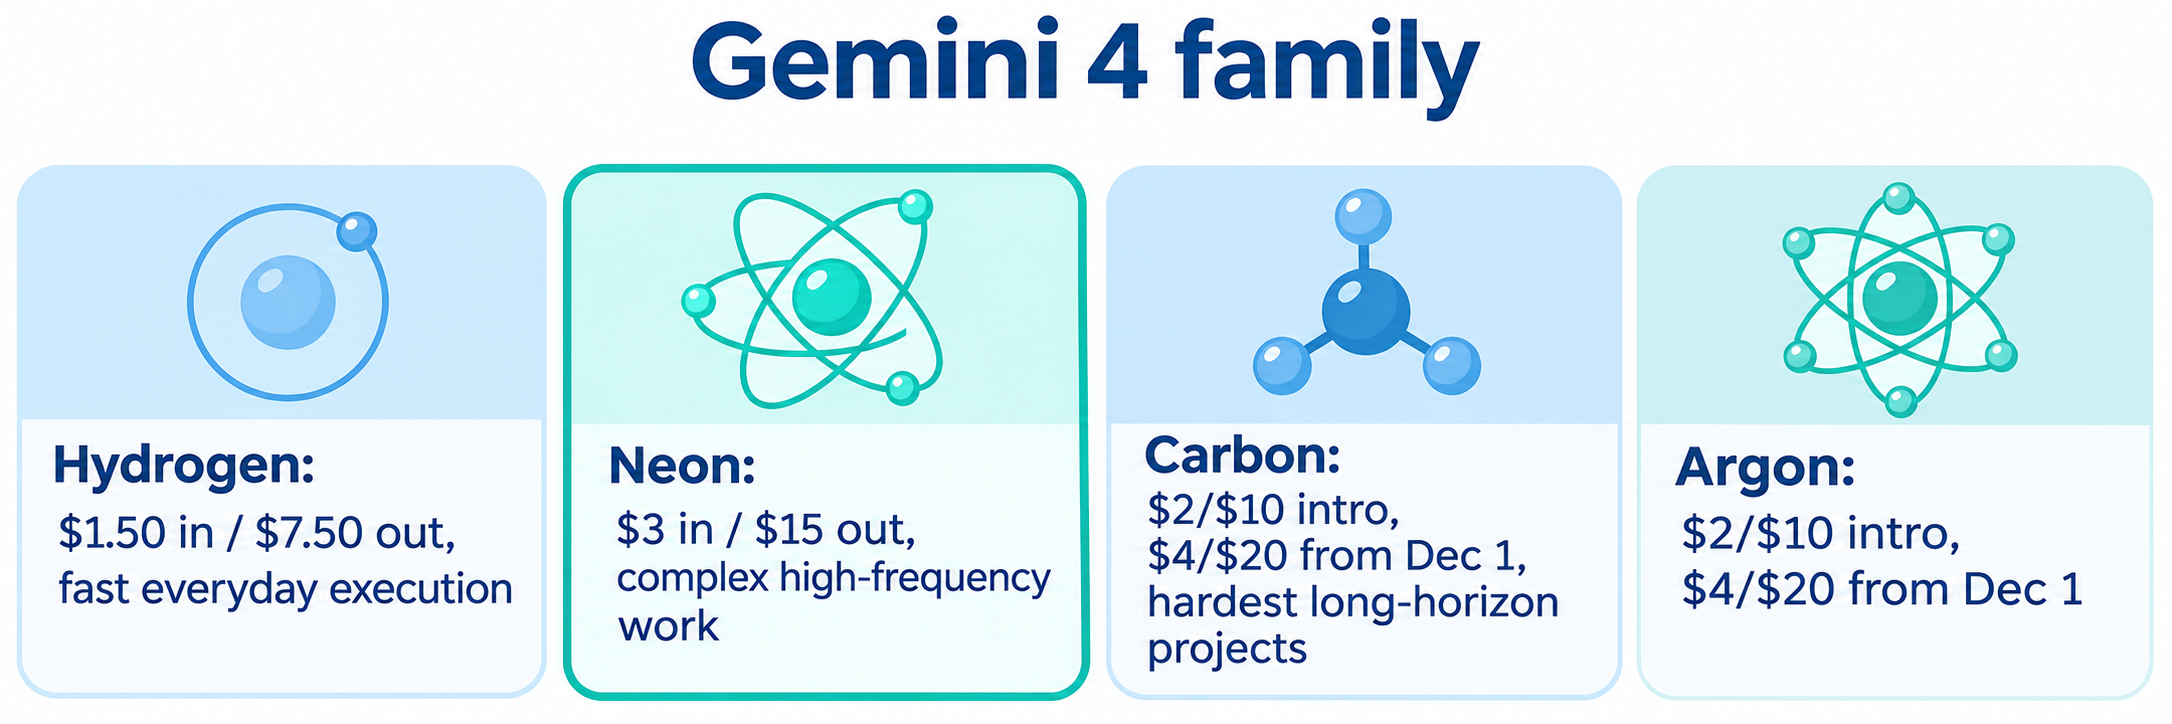
En resumen: Hydrogen para volumen, Neon para trabajo complejo que se ejecuta con frecuencia, Carbon para los problemas individuales más difíciles. La guía Novedades de Gemini 4 Neon de Google lo plantea así: usa Neon para tareas complejas de ingeniería y análisis, Carbon para tus problemas más difíciles de arquitectura, depuración, ciencia y seguridad, y mantén Hydrogen como predeterminado para la programación y los agentes cotidianos.
| Modelo | Entrada / salida por 1 M de tokens | Ideal para |
|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ | Programación cotidiana rápida y pasos de agentes |
| Gemini 4 Neon | 3,00 $ / 15,00 $ | Programación y análisis complejos y de alta frecuencia |
| Gemini 4 Carbon | 2 / 10 $ de lanzamiento, 4 / 20 $ desde el 1 de diciembre | Proyectos de largo alcance más difíciles |
| Gemini 4 Argon | 2 / 10 $ de lanzamiento, 4 / 20 $ desde el 1 de diciembre | Modelo de frontera anterior de Gemini 4 |
Los precios se verán raros durante unos días más. Hasta el 30 de noviembre, la tarifa de lanzamiento de Carbon está por debajo del precio de lista de Neon. A partir del 1 de diciembre, el precio de Carbon se duplica a 4/20 $ (consulta nuestro análisis de precios de Gemini 4 Carbon), y Neon se convierte en el más barato de los dos por token.
El precio por token no lo es todo. Google afirma que Neon a nivel high cuesta un 32 % menos por tarea que Carbon porque termina en menos pasos. Artificial Analysis midió un coste por tarea aproximadamente un 17 % más bajo. Prueba con tus propios prompts antes de fiarte de cualquiera de las dos cifras.
Niveles de razonamiento de Gemini 4 Neon
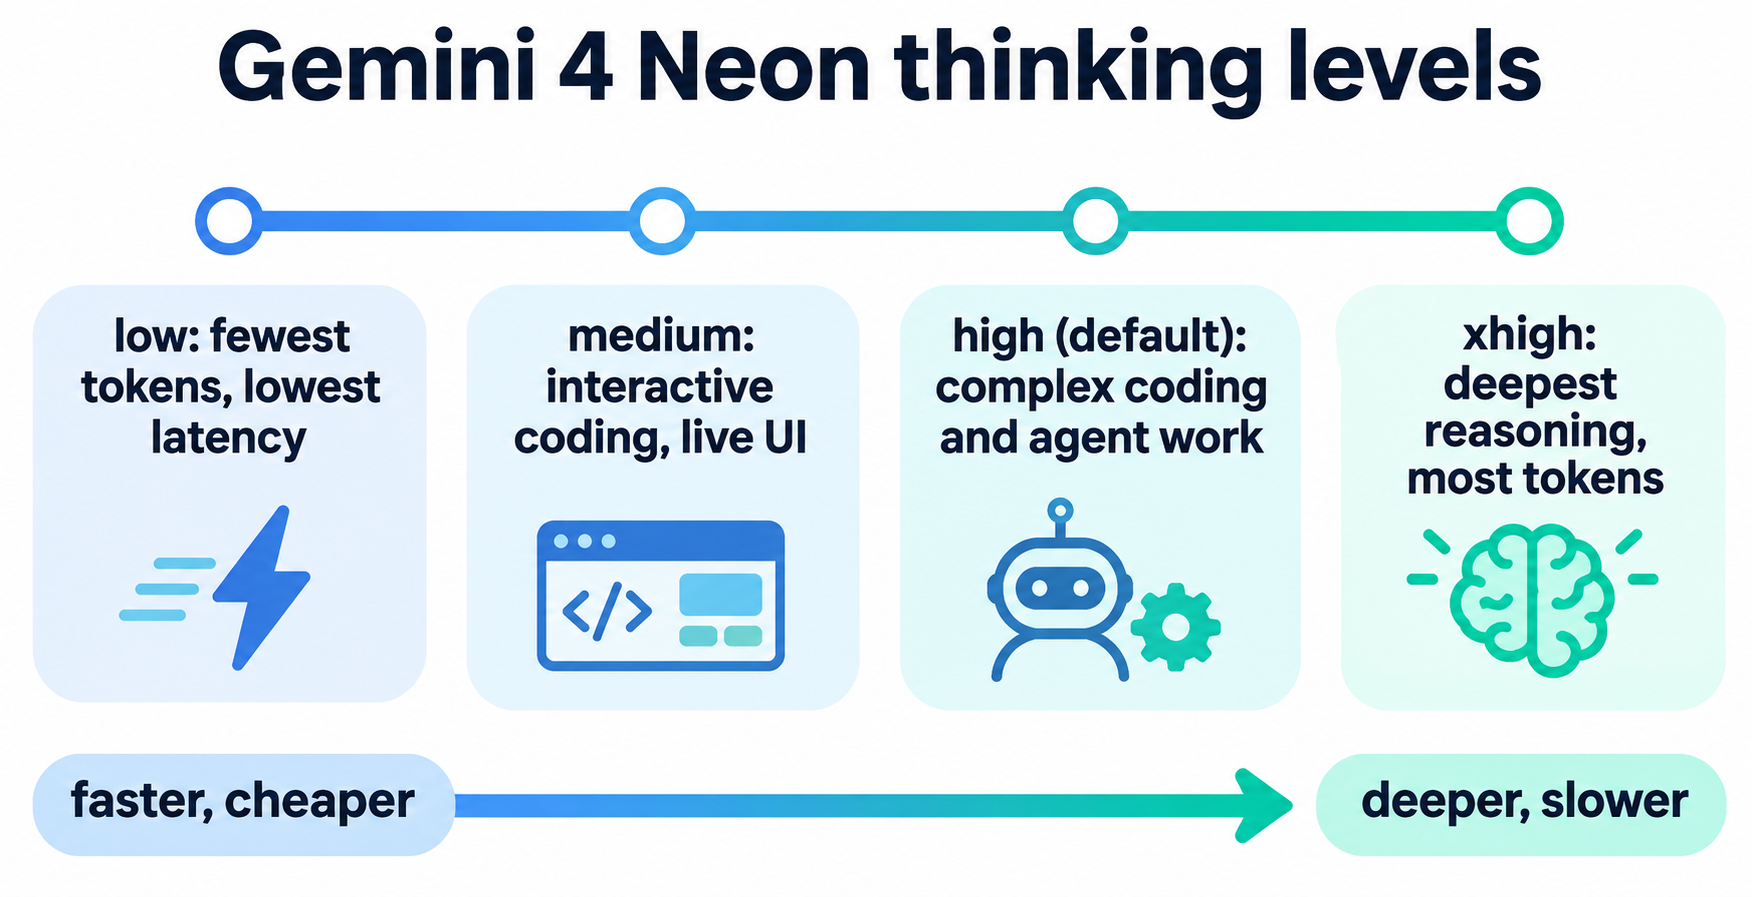
El nivel de razonamiento es tu principal control para la calidad, la latencia y el coste. Neon usa por defecto high, y Google recomienda empezar ahí:
low: menos tokens y la latencia más baja, para chat rápido y procesamiento de alto rendimiento.medium: programación interactiva, prototipado de UI en vivo y llamadas a herramientas sensibles a la latencia.high(predeterminado): programación compleja, ejecución de agentes, llamadas a herramientas y trabajo del conocimiento multimodal.xhigh: los problemas de ingeniería, análisis y ciencia más difíciles de varios pasos, con mayor latencia y gasto en tokens.
Consejo de Google: evalúa los cuatro niveles con un max_output_tokens alto y, después, elige el nivel más bajo que cumpla tu criterio. Los tokens de razonamiento se facturan como salida a 15 $ por millón.
Dos advertencias de migración de la guía para desarrolladores de Google Cloud: el nivel MINIMAL de los modelos Flash anteriores no es compatible, y el antiguo parámetro thinking_budget devuelve un HTTP 400 en lugar de mapearse silenciosamente. Los valores personalizados de temperature, top_k y top_p se ignoran, y frequency_penalty o presence_penalty devuelven un 400.
Benchmarks de Gemini 4 Neon
Todas las cifras siguientes provienen de la publicación de lanzamiento de Google, que cita varios rankings de terceros. Las ejecuciones independientes en tu propia carga de trabajo importan más, pero estas muestran hacia dónde apunta Google con el modelo:
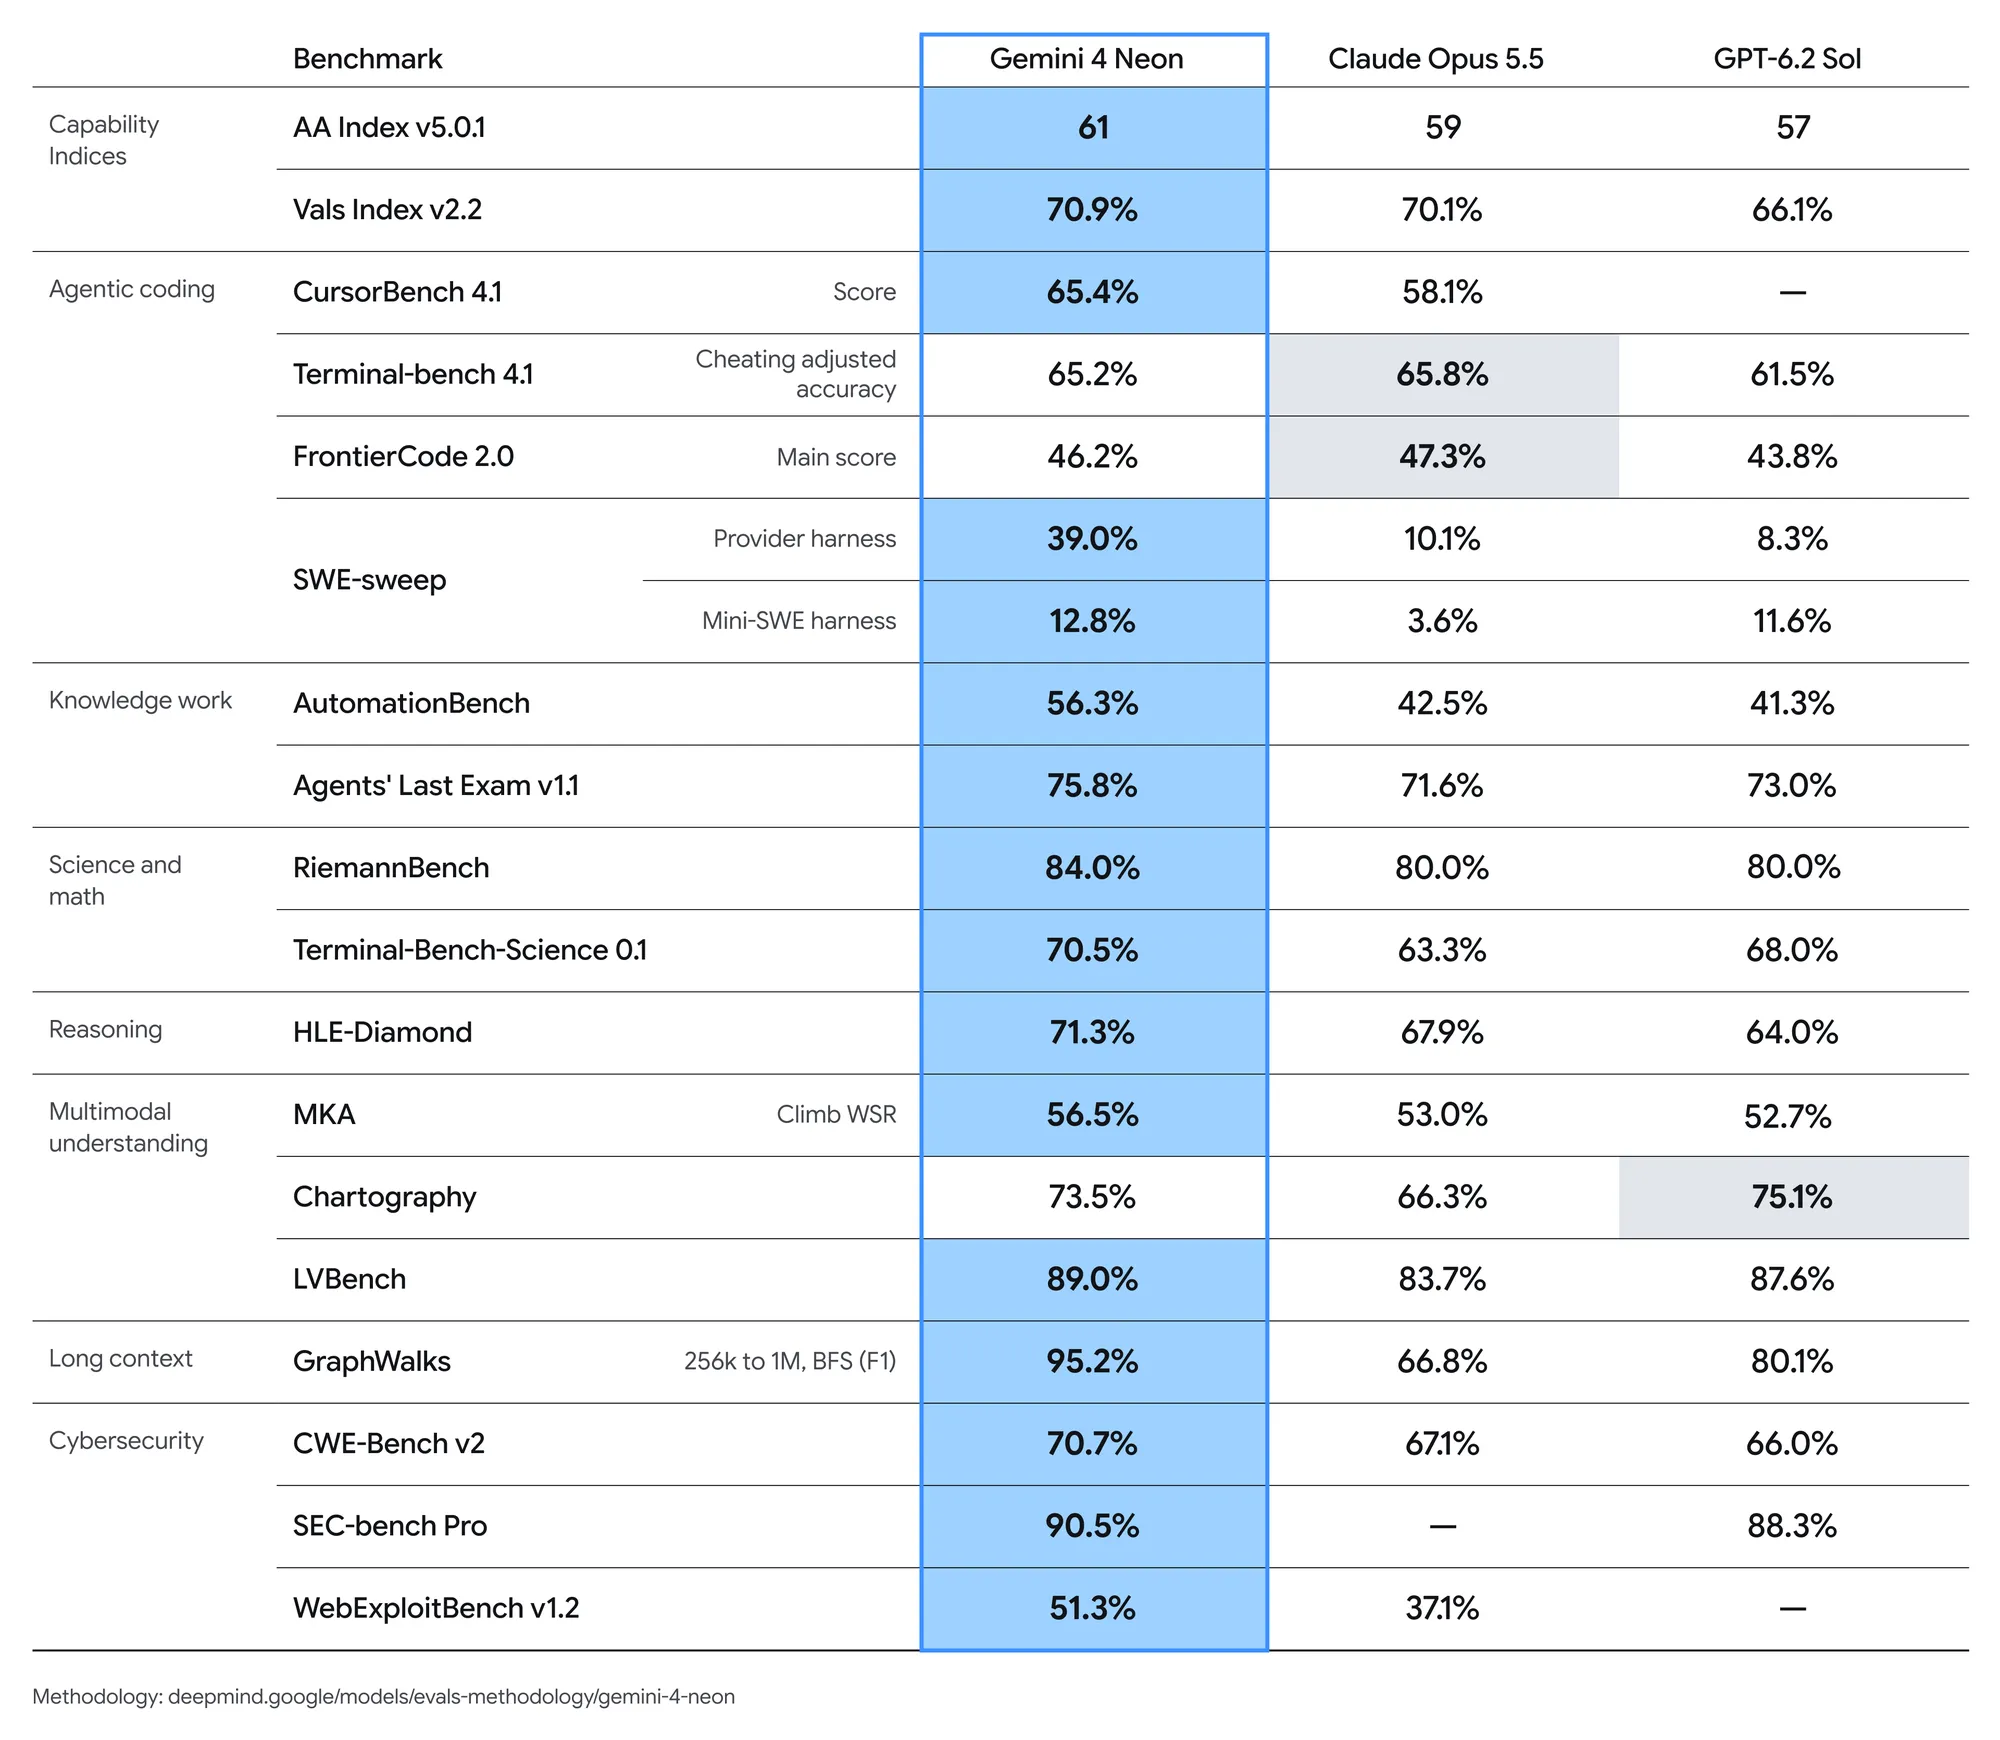
Neon está optimizado para el trabajo de agentes. Google dice que reduce las lecturas redundantes de archivos, gestiona la compactación del contexto en sesiones largas y registró su tasa de fabricación más baja hasta la fecha en pruebas internas de Antigravity.
Donde Neon no es el primero: en el Artificial Analysis Intelligence Index, el propio Google reconoce que Neon queda justo detrás de modelos más grandes y lentos. Vals AI situó a Neon 0,4 puntos por detrás de Claude Fable 5.2 en su índice, a menos de la mitad del coste por tarea. Para una visión neutral, consulta Artificial Analysis a medida que lleguen más ejecuciones independientes.
Dónde puedes usar Gemini 4 Neon hoy
Neon se lanzó el día del estreno en cinco plataformas:
- Gemini API (nivel de pago) en Google AI Studio y Android Studio, tanto en
generateContentcomo en la Interactions API. - Gemini Enterprise Agent Platform en Google Cloud, en el endpoint
globaly en las multirregionesusyeu. Google dice que está disponible para clientes empresariales verificados en regiones seleccionadas. - Google Antigravity para suscriptores de pago de Google AI Pro y Ultra, donde puede orquestar subagentes Hydrogen en paralelo.
- Aplicación Gemini para suscriptores Pro y Ultra, donde ahora impulsa Tasks.
- Gemini for business a través de la API y el menú desplegable de modelos.
No hay nivel gratuito de API: la página de precios de Google muestra todas las líneas de Neon como “No disponible” en el nivel gratuito. Los suscriptores Pro y Ultra pueden probarlo en AI Studio. Una variante de ciberdefensa llegará a defensores de confianza a través del Fairwind Program de Google en los próximos días.
La inferencia por lotes y Flex reduce el precio a la mitad, a 1,50 $ de entrada y 7,50 $ de salida por millón de tokens, si tus trabajos pueden esperar.
Neon como orquestador
Neon hereda el patrón planificador-trabajador que Google introdujo con Hydrogen. Planificas o verificas un flujo de trabajo con gemini-4-neon y, después, pasas previous_interaction_id a gemini-4-hydrogen para que el modelo más barato ejecute los pasos individuales. La guía de Cloud de Google lo muestra con la Interactions API:
from google import genai

client = genai.Client()

plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
Neon gasta 15 $ por millón de tokens de salida en criterio; Hydrogen gasta 7,50 $ en ejecución. Nuestra guía del orquestador de Gemini 4 Hydrogen cubre la versión con Carbon de este bucle.
Límites y preguntas abiertas
Algunas cosas que debes saber antes de mover tráfico de producción:
- Sin caché explícita. Solo se aplica la caché implícita, en prefijos de prompt compartidos de 4.096 tokens o más. Si construiste sobre
cached_contentcon un modelo anterior, esa llamada necesita reescribirse. - Las salidas largas requieren continuación. Una solicitud devuelve hasta 65.536 tokens. Para pasarte de esa cifra usas long decode, con ejecución en segundo plano o un bucle de continuación; las llamadas REST directas necesitan la ruta
v1beta1en Google Cloud. - Todos los tokens se facturan. Los tokens de razonamiento, además de las instrucciones de herramientas internas y las declaraciones de funciones que Google añade cuando usas grounding, cuentan en tu factura.
- Cambio de región para algunos usuarios de Argon. Si usabas
gemini-4-argoneneurope-west2oasia-southeast1, cambia aglobal,usoeu. - Límites de tasa. Consulta tu nivel en la página de límites de tasa de la API de Gemini antes de planificar tu rendimiento.
Prueba Gemini 4 Neon con Apidog CLI y tu agente de programación
La verdadera pregunta es si Neon justifica su precio frente a Hydrogen con tus prompts. Deja que tu agente de programación lo responda con una prueba repetible. Esta solicitud sigue el formato documentado de la Interactions API de Google; no la hemos ejecutado en vivo para esta publicación:
MODEL="${GEMINI_MODEL:-gemini-4-neon}"

curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{\"model\": \"${MODEL}\", \"input\": \"Find the race condition in this retry queue.\", \"generation_config\": {\"thinking_level\": \"high\"}}"
Apidog CLI ofrece a Claude Code, Codex, Cursor u OpenCode una forma de crear y ejecutar pruebas de API desde la línea de comandos. Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un solo prompt:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable and a GEMINI_API_KEY variable. Add a test case for POST
/v1beta/interactions that sends the same coding prompt at thinking_level high,
asserts HTTP 200 and a non-empty output, and records response time and token
usage. Run it for gemini-4-neon and gemini-4-hydrogen and compare the results.
El agente crea el entorno, valida el payload del caso de prueba contra su esquema y, después, lo ejecuta una vez por modelo:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
Incluye el mismo apidog run ... -r junit en CI con la guía de CI/CD de Apidog CLI, o empieza con Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Cuándo se lanzó Gemini 4 Neon? El 18 de noviembre de 2026, el mismo día que se puso a disposición en la API de Gemini, AI Studio, Antigravity y la aplicación Gemini.
¿Cuánto cuesta Gemini 4 Neon? 3 $ por millón de tokens de entrada, 15 $ por millón de tokens de salida (razonamiento incluido) y 0,15 $ por millón de tokens de entrada en caché. Batch y Flex cuestan la mitad: 1,50 $ y 7,50 $.
¿Es gratuito Gemini 4 Neon? No en la API. Google no ofrece nivel gratuito para Neon. Los suscriptores de Google AI Pro y Ultra pueden usarlo en AI Studio, la aplicación Gemini y Antigravity como parte de su plan.
¿Es Gemini 4 Neon mejor que Gemini 4 Carbon? Para la mayoría del trabajo frecuente y complejo, Google dice que Neon iguala o supera ligeramente a Carbon con un coste por tarea un 32 % menor. Google sigue recomendando Carbon para sus problemas más difíciles de arquitectura, depuración, ciencia y seguridad.
¿Cuál es el ID del modelo de Gemini 4 Neon? gemini-4-neon. Es un ID estable tanto en la API de Gemini como en la Gemini Enterprise Agent Platform de Google Cloud.