
Gemini 4 Hydrogen es el modelo Gemini 4 rápido y de menor costo de Google, lanzado el 12 de noviembre de 2026 y diseñado para el trabajo diario de programación y agentes. Cuesta 1,50 USD por millón de tokens de entrada y 7,50 USD por millón de tokens de salida en un contexto de 1M de tokens, ofrece cuatro niveles de razonamiento (low, medium, high, xhigh) y está disponible en el nivel gratuito de la API de Gemini.
Si usas Gemini 3.8 Flash, Hydrogen es la actualización recomendada por Google. Si pagas por Carbon o Argon en pasos rutinarios, Hydrogen está pensado para hacerse cargo de esas tareas. Aquí te contamos qué se lanzó, cómo encaja y qué sigue siendo una incógnita.
¿Qué es Gemini 4 Hydrogen?
Gemini 4 Hydrogen (gemini-4-hydrogen) es el nivel de velocidad de la familia Gemini 4 de Google. Google lo llama el "caballo de batalla diario para flujos de trabajo agénticos": un modelo que escribe código, llama herramientas, ejecuta pruebas y lee documentos con rapidez, ya sea por sí solo o como motor de ejecución bajo un modelo frontera como Gemini 4 Carbon.
Los datos clave, según la publicación de lanzamiento de Google y la guía de novedades de AI Studio:
| Especificación | Gemini 4 Hydrogen |
|---|---|
| ID del modelo | gemini-4-hydrogen |
| Lanzamiento | 12 de noviembre de 2026 |
| Precio de pago | 1,50 USD / 1M de entrada, 7,50 USD / 1M de salida (precio plano en todo el contexto) |
| Entrada en caché | 0,075 USD / 1M de tokens mediante caché implícita |
| Ventana de contexto | 1.048.576 tokens, compartidos entre entrada, razonamiento y salida |
| Salida por solicitud | 65.536 tokens síncronos; hasta 1M con ejecución en segundo plano |
| Niveles de razonamiento | low, medium, high (predeterminado), xhigh |
| Entradas | Texto, imágenes, PDF, hojas de cálculo, gráficos, audio, video |
| Nivel gratuito | Sí, con límites de tasa, en AI Studio y la API de Gemini |
| APIs | generateContent y la API de Interactions |
Los tokens de salida incluyen los tokens de razonamiento, por lo que una solicitud en xhigh cuesta más que la misma solicitud en low, incluso cuando la respuesta visible tiene la misma longitud.
Hydrogen frente a Carbon frente a Argon: dónde encaja cada uno
Los tres modelos Gemini 4 comparten el mismo contexto unificado de 1M, el diseño de decodificación larga y las herramientas integradas. Se diferencian en cuánto razona cada uno por turno y en lo que cuesta.
| Hydrogen | Argon | Carbon | |
|---|---|---|---|
| Rol | Ejecución rápida, programación diaria | La mayoría de las tareas de largo alcance, menos tokens que Carbon | El modelo frontera más potente |
| Razonamiento predeterminado | high |
medium |
medium |
| Razonamiento máximo | xhigh |
high |
high |
| Salto sin streaming | 65.536 tokens | 32.768 tokens (REST) | 32.768 tokens (REST) |
| Recomendación de Google | Camino de actualización desde 3.8 Flash | Tareas largas avanzadas | Arquitectura compleja, seguridad, ciencia |
La propia recomendación de Google es combinarlos: deja que Carbon planifique interfaces o resuelva un bug difícil, y luego pasa las ediciones de código, el trabajo de subagentes en paralelo y la ejecución de pruebas a Hydrogen. Cambiar de modelo dentro de una misma conversación funciona mediante previous_interaction_id en la API de Interactions, sin cambios en el esquema de la solicitud.
Para un análisis más profundo entre los dos modelos frontera, lee Gemini 4 Carbon vs Argon. Para sus costos, consulta los desgloses de precios de Carbon y precios de Argon.
Los cuatro niveles de razonamiento
El nivel de razonamiento de Hydrogen es tu principal control sobre velocidad, calidad y gasto. Se configura con el campo thinking_level, y Google recomienda empezar con el predeterminado y cambiarlo solo cuando tus evaluaciones lo indiquen.
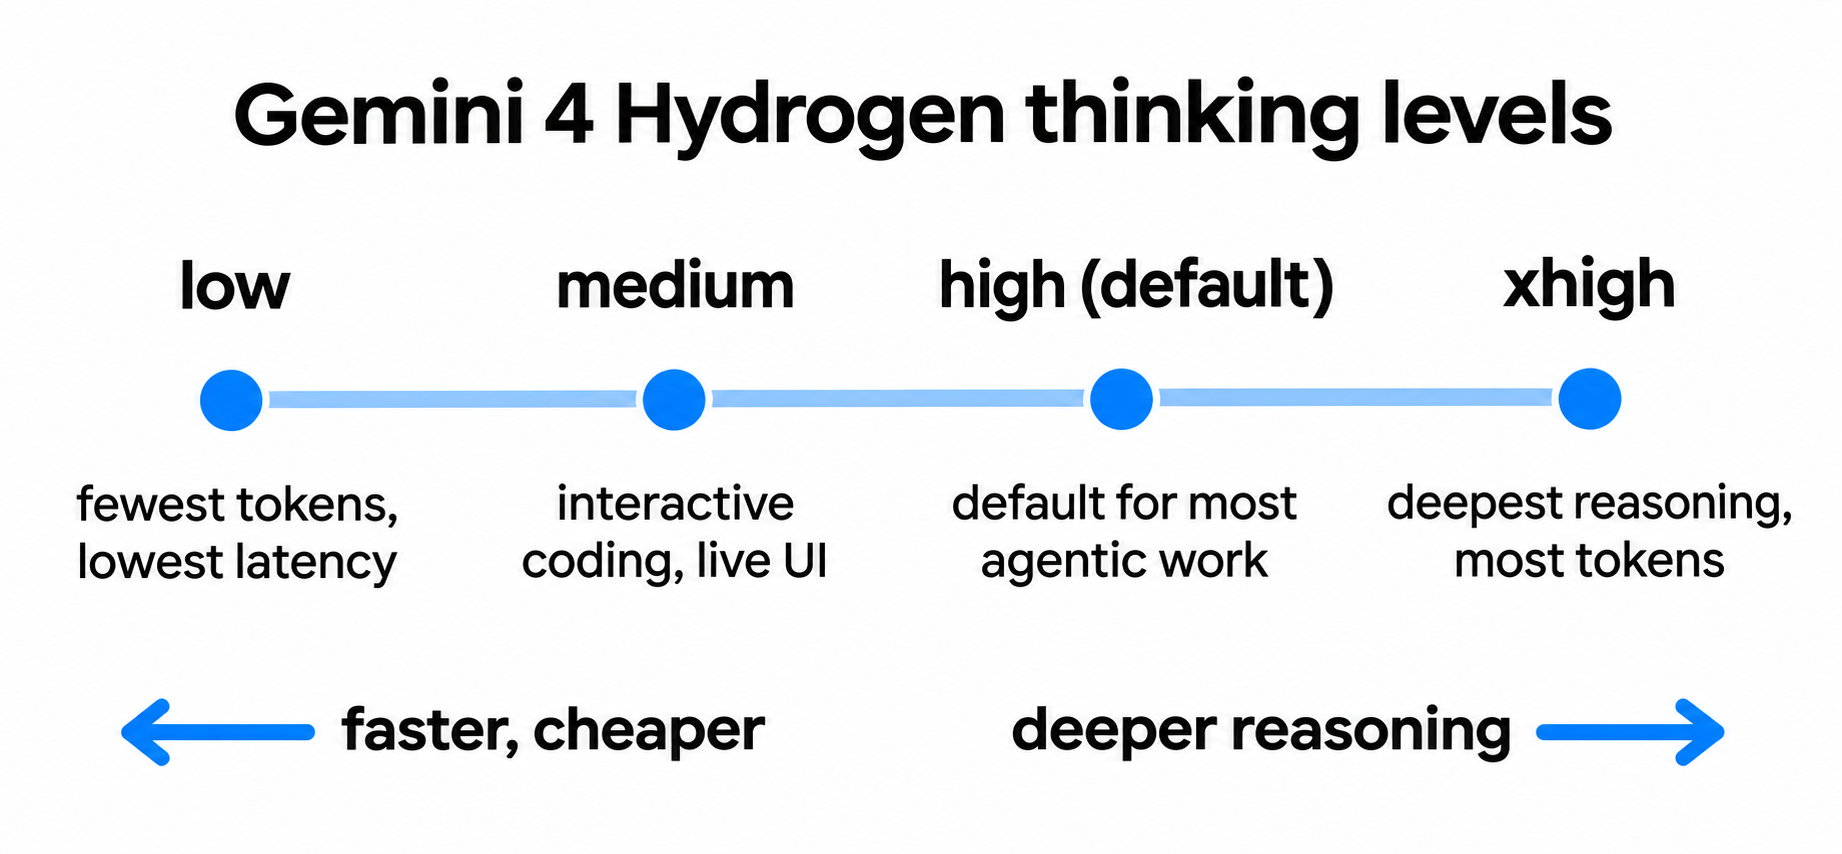
low: la menor cantidad de tokens, la latencia más baja. Chat rápido y procesamiento de alto rendimiento.medium: programación interactiva, prototipado de UI en vivo y llamadas a herramientas sensibles a la latencia.high(predeterminado): programación compleja, ejecución agéntica, llamadas a herramientas y trabajo con documentos multimodales.xhigh: nuevo con Hydrogen. Problemas difíciles de varios pasos dondehighse queda corto.
Google advierte que xhigh puede sobreanalizar prompts simples, añadiendo latencia y tokens sin mejorar la respuesta. Su consejo: ejecuta tu suite de evaluación en los cuatro niveles con un max_output_tokens generoso y luego elige el nivel más bajo que cumpla tu umbral de calidad. Si migras desde 3.8 Flash, ten en cuenta que Hydrogen rechaza minimal con un error y usa high como predeterminado en lugar de medium. La guía de precios de Hydrogen detalla lo que cuesta cada nivel.
Benchmarks de Gemini 4 Hydrogen
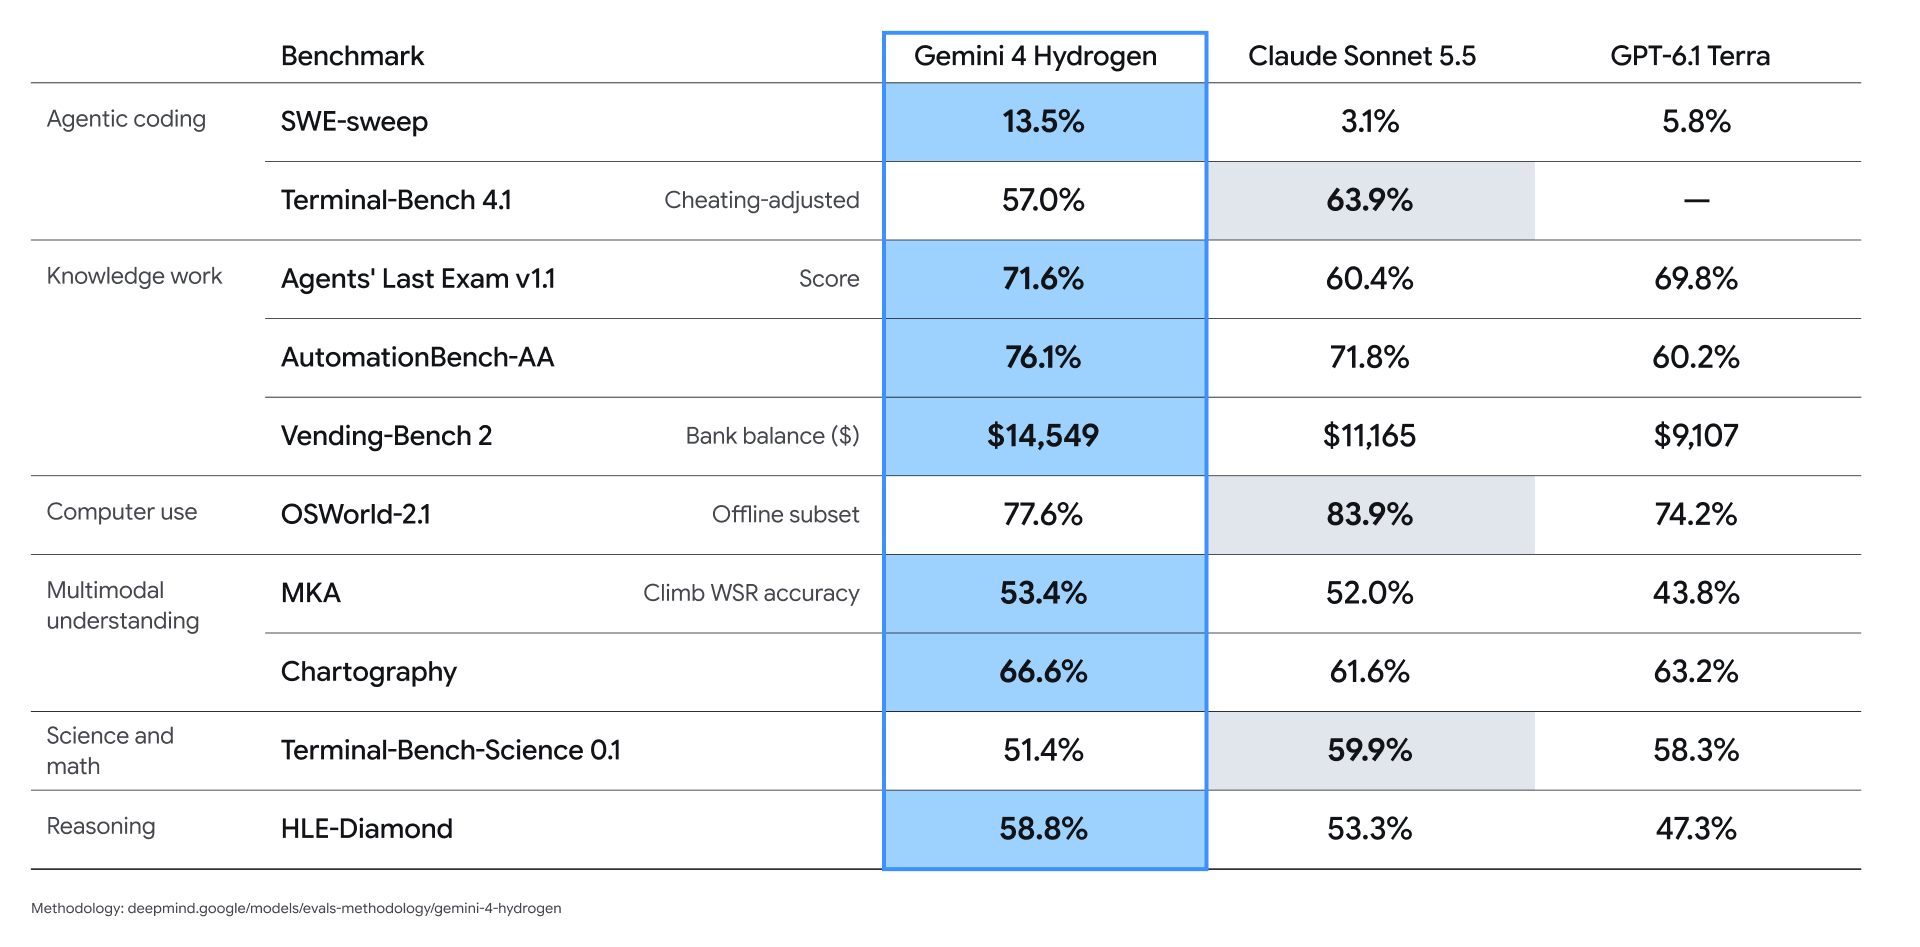
Todas las cifras siguientes son de Google, publicadas en el lanzamiento. La replicación independiente era escasa un día después del lanzamiento, así que trátalas como afirmaciones del proveedor.
Frente a Argon y sus propias configuraciones
- Índice de Inteligencia de Artificial Analysis: 51 en
high, por delante del 50 de Argon, y 54 enxhigh.
Frente a Gemini 3.8 Flash
- 2,5 veces más rápido con el valor predeterminado
high. - Terminal-Bench 4.1: 57 % frente a 18,2 %.
- Más de 5 veces menos afirmaciones fabricadas.
- Los socios del lanzamiento reportan ejecuciones de 2 a 2,8 veces más rápidas y entre un 12 % y un 23 % menos de tokens en cargas de trabajo de grafos, SQL y datos intensivos.
Trabajo agéntico y por dominio
- HLE-Diamond: 58,8 %, que según Google lidera su categoría.
- Vals Tax Agent Bench: primer puesto con 52,3 %.
- Vals Legal Research Bench: primer puesto empatado con 55,8 %.
- Agent Arena (arena.ai): puesto 5.
- Multimodal Knowledge Agent (MKA): 53,4 %.
- Agents' Last Exam v1.1: 71,6 %.
Seguridad, según Google
- Hasta un 81 % menos de exceso de intervención y hasta un 79 % menos de servicio insuficiente en tareas agénticas.
- 12 veces menos acciones desalineadas y atajos de tareas en las evaluaciones de uso de herramientas y programación.
- 96,7 % en la evaluación interna de honestidad de agentes de Google.
- Más de 2,3 veces más resistente a la inyección de prompts indirectos en el benchmark Gray Swan IPI.
El patrón importa más que cualquier puntuación individual: Hydrogen iguala aproximadamente a Argon en inteligencia general y supone un gran salto respecto a 3.8 Flash en programación agéntica. Pruébalo con tu propia carga de trabajo antes de confiar en él. La ficha del modelo contiene las notas de evaluación completas de Google.
Dónde puedes usar Gemini 4 Hydrogen hoy
Google implementó Hydrogen en productos para desarrolladores, empresas y consumidores el día del lanzamiento:
- API de Gemini, Google AI Studio y Android Studio: todos los niveles, gratuitos y de pago. El nivel gratuito tiene límites de tasa; la guía gratuita de Hydrogen cubre lo que obtienes sin tarjeta.
- Gemini para empresas: a través de la API, el menú desplegable de modelos, Antigravity y Gemini en Google Sheets para planes empresariales elegibles.
- Aplicación Gemini: en el menú desplegable de modelos. Los usuarios gratuitos solo obtienen Hydrogen mediante la selección automática de modelo, cuando Gemini decide que encaja con el prompt.
- Google Search: generando respuestas para todos los usuarios.
- Google Sheets: empezando por los suscriptores de Google AI Pro y Ultra.
- Google Antigravity: para suscriptores de pago de Google AI Pro y Ultra.
Hydrogen es ahora también el modelo predeterminado detrás del agente Antigravity en Gemini Managed Agents, por lo que quien llame a ese agente a través de la API ya está usando Hydrogen, salvo que configure otro modelo.
Orchestrator: Hydrogen y Carbon en una sola sesión
Orchestrator es una nueva opción de modelo en Google Antigravity que alterna entre Carbon y Hydrogen dentro de una misma tarea, en ambas direcciones. Carbon explora y planifica, Hydrogen escribe ediciones, actualiza paquetes y ejecuta pruebas, y cuando Hydrogen encuentra fricción devuelve el control a Carbon para reparar el plan. Sustituye al enrutador estático que adivina la dificultad una sola vez a partir de tu primer prompt.
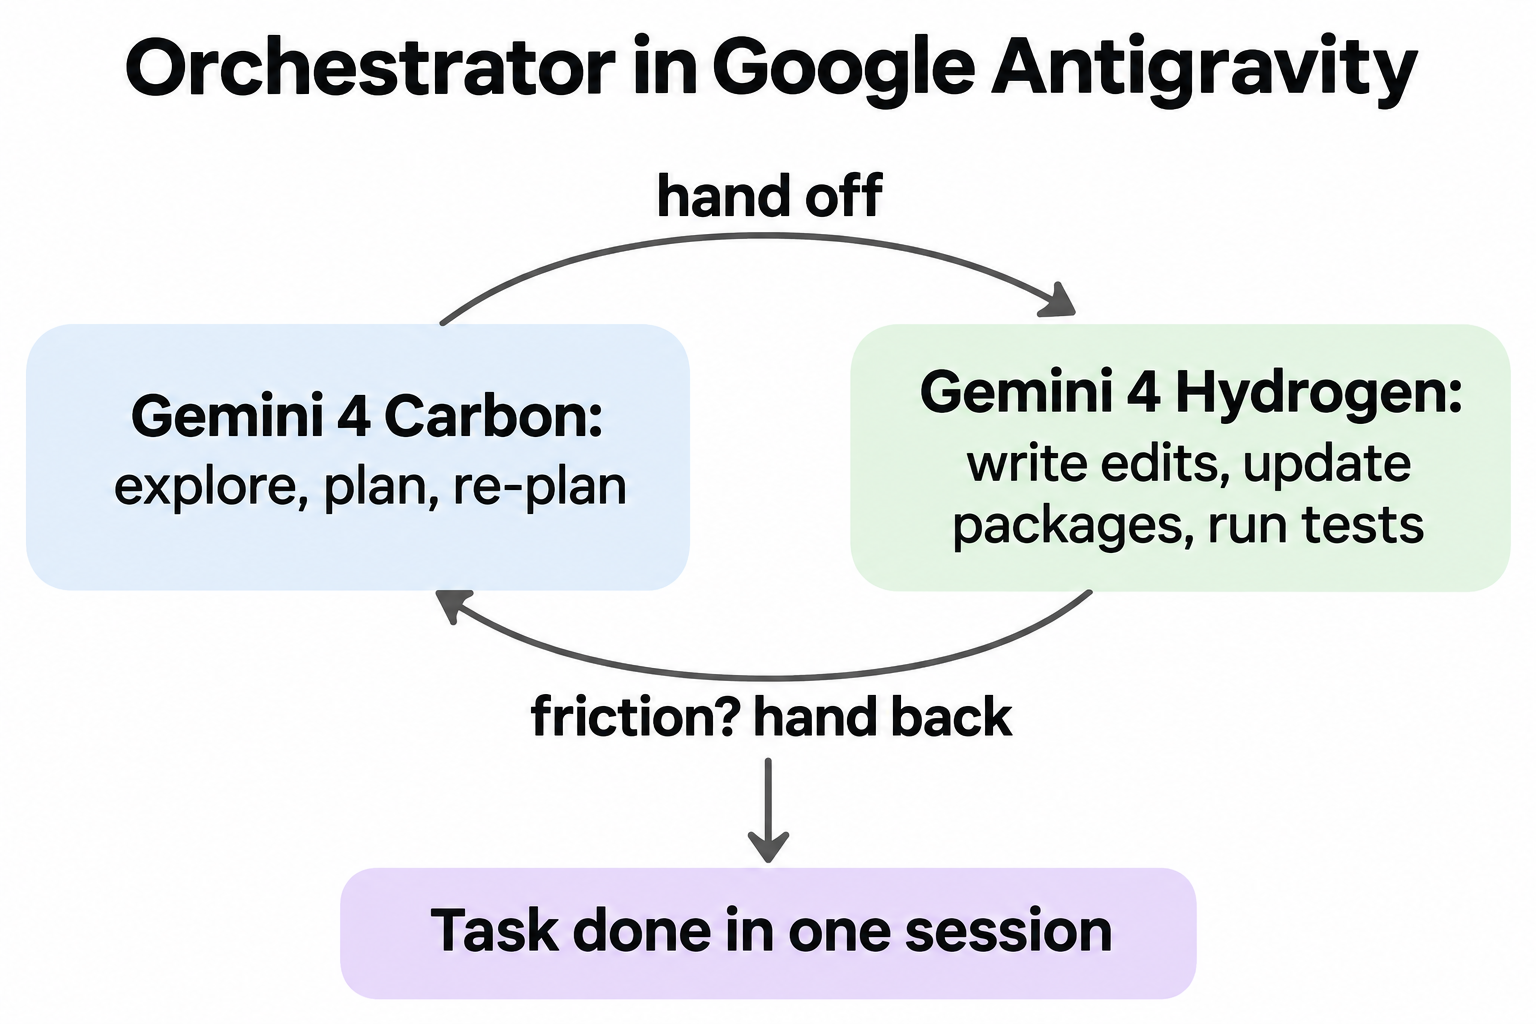
En Terminal-Bench, Google afirma que Orchestrator alcanzó tasas de éxito cercanas a las de Carbon mientras usaba un 24 % menos de cuota y terminaba un 19 % más rápido en promedio. Ten en cuenta que las dos publicaciones de lanzamiento de Google citan versiones distintas del benchmark para este resultado (4.0 en la publicación principal, 4.1 en la publicación de Antigravity).
La disponibilidad es por niveles. Los suscriptores Ultra obtienen Orchestrator (Carbon) y Orchestrator (Argon); los suscriptores Pro de pago obtienen Orchestrator (Argon). Si prefieres conectar los roles tú mismo, el SDK de Antigravity te permite asignar agentes Hydrogen y Carbon de forma explícita. La guía de Gemini 4 Hydrogen Orchestrator profundiza en el tema.
Limitaciones y preguntas abiertas
Un día después del lanzamiento, planifica teniendo en cuenta esto:
- Los benchmarks son autoreportados. Todas las cifras anteriores provienen de Google o de sus socios de lanzamiento.
- Sin caché explícita.
cachedContentsycaches.createno son compatibles; solo aplica la caché implícita en prompts de 4.096 tokens o más. - Los parámetros de muestreo se ignoran.
temperature,top_pytop_kno tienen efecto, por lo que no puedes ajustar la aleatoriedad de esa forma. - Los límites del nivel gratuito están en una página aparte. Google remite a su página de límites de tasa en lugar de listar los números de Hydrogen en la guía de lanzamiento.
- Orchestrator es exclusivo de Antigravity. No existe un Orchestrator a nivel de API; en tu propio código tú enrutas los modelos.
Prueba Gemini 4 Hydrogen con Apidog CLI y tu agente de programación
Para decidir si Hydrogen puede reemplazar a 3.8 Flash, ejecuta la misma solicitud contra ambos y compara. Deja que tu agente de programación lo haga, para que el cambio se convierta en un resultado de prueba y no en una suposición. Esta solicitud sigue el formato documentado de generateContent de Google; no la hemos ejecutado en vivo para este artículo:
MODEL="${GEMINI_MODEL:-gemini-4-hydrogen}"

curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"contents": [{"parts": [{"text": "List three checks a CI job should run before a release."}]}]}'
Apidog CLI ofrece a Claude Code, Codex, Cursor u OpenCode una forma de línea de comandos para crear y ejecutar pruebas de API. Configúralo una sola vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un único prompt:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable set to gemini-4-hydrogen and a GEMINI_API_KEY variable. Add a test case
for POST /v1beta/models/{MODEL}:generateContent that asserts HTTP 200, a non-empty
candidates array, and that usageMetadata is present. Run it for gemini-4-hydrogen
and gemini-3.8-flash and compare response time and token counts.
El agente crea el entorno, valida el payload del caso de prueba contra su esquema y luego lo ejecuta una vez por modelo:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-3.8-flash" -r cli,json
Incorpora el mismo apidog run ... -r junit en CI con la guía de CI/CD de Apidog CLI, o empieza con Apidog CLI en Claude Code. Para ejemplos completos de solicitudes, consulta la guía de la API de Gemini 4 Hydrogen. El plan gratuito de Apidog cubre hasta 4 usuarios.
Preguntas frecuentes
¿Gemini 4 Hydrogen es gratuito? Sí, dentro de ciertos límites. Google incluye Hydrogen en el nivel gratuito de la API de Gemini y en Google AI Studio, con límites de tasa. El uso de pago cuesta 1,50 USD por millón de tokens de entrada y 7,50 USD por millón de tokens de salida.
¿Cuál es el ID del modelo Gemini 4 Hydrogen? gemini-4-hydrogen. Funciona tanto con generateContent como con la API de Interactions.
¿Gemini 4 Hydrogen es mejor que Gemini 4 Argon? Según las cifras de Google, Hydrogen obtiene 51 en el Índice de Inteligencia de Artificial Analysis en high frente al 50 de Argon, y 54 en xhigh. Argon sigue siendo la opción recomendada para la mayoría de las tareas avanzadas de largo alcance, así que prueba ambos con tu propia carga de trabajo.
¿Qué es el nivel de razonamiento xhigh? Es un cuarto nivel de razonamiento, nuevo con Hydrogen, por encima del predeterminado high. Gasta la mayor cantidad de tokens para el razonamiento más profundo. Google solo lo recomienda para problemas difíciles de varios pasos donde high se queda corto.
¿Gemini 4 Hydrogen reemplaza a Gemini 3.8 Flash? Google lo presenta como la actualización recomendada desde 3.8 Flash. Cambia el ID del modelo, sube los límites bajos de max_output_tokens, elimina la caché explícita y los parámetros de muestreo, y vuelve a probar tu nivel de razonamiento.
¿Puedo usar Orchestrator a través de la API de Gemini? No. Orchestrator es una opción de modelo dentro de Google Antigravity para suscriptores de pago de AI Pro y Ultra. En la API, tú enrutas entre Carbon y Hydrogen por tu cuenta, por ejemplo con previous_interaction_id entre turnos.