
Google actualizó su nivel Flash el 21 de julio de 2026, y Gemini 3.5 Flash-Lite es la opción económica de este. Es el Gemini más barato y rápido que puedes usar hoy, diseñado para trabajos de gran volumen y sensibles a la latencia: clasificación, extracción, respuestas cortas en chats y respuestas sencillas de recuperación donde el rendimiento y el costo importan más que el razonamiento profundo. Si estás realizando millones de pequeñas solicitudes al día, este es el nivel que Google quiere en tu ruta crítica.
La actualización lanzó tres modelos a la vez, y la nomenclatura confunde a la gente, así que vamos a aclararlo rápidamente y luego pasaremos a las especificaciones, precios, puntos de referencia y cómo probar el endpoint tú mismo.
¿Qué es Gemini 3.5 Flash-Lite?
Gemini 3.5 Flash-Lite es el modelo más pequeño y barato de la familia Gemini de Google. Está optimizado para la velocidad y el volumen, no para el razonamiento más difícil. Google lo calcula en aproximadamente 350 tokens de salida por segundo, por lo que las respuestas se sienten casi instantáneas incluso bajo carga. Lo llamas a través de la API de Gemini con el ID de modelo gemini-3.5-flash-lite.
Piensa en ello como el nivel al que apuntas para trabajos aburridos, repetitivos y de alta frecuencia. Etiquetar tickets de soporte. Extraer campos de un documento. Responder a una pregunta corta de un fragmento de texto recuperado. Alimentar un widget de chat que necesita responder antes de que el usuario note un retraso. En cada uno de estos, estás enviando muchas solicitudes y quieres que cada una sea barata y rápida. Flash-Lite es la respuesta de Google para ese tipo de carga de trabajo.
Se lanzó como parte de una actualización de Flash de tres modelos: el nuevo modelo principal Gemini 3.6 Flash, este Gemini 3.5 Flash-Lite y un modelo de seguridad restringido llamado Gemini 3.5 Flash Cyber. Puedes leer el propio resumen de Google en el blog de Google y los detalles del modelo en la página de DeepMind Flash. Flash-Lite se sitúa en la parte inferior de esa pila en cuanto a precio y en la superior en cuanto a velocidad bruta.
Espera, ¿por qué es 3.5 y no 3.6?
Aquí está la parte confusa. El nuevo modelo principal es Gemini 3.6 Flash. Pero Flash-Lite se mantuvo en 3.5, al igual que el modelo de seguridad Cyber. Así que un lanzamiento, un día, tres modelos, dos números de versión. Eso no es un error tipográfico por parte de Google ni un error en este artículo. Google lanzó versiones mixtas: el Flash insignia saltó a 3.6, mientras que las variantes Lite y Cyber mantuvieron la etiqueta 3.5.
¿Por qué hace esto Google? El número de versión sigue al modelo, no al evento de lanzamiento. El modelo principal obtuvo un salto generacional mayor, por lo que se ganó la etiqueta 3.6. Flash-Lite también es un modelo nuevo, pero Google optó por mantenerlo alineado con la línea 3.5. Es molesto de seguir, pero así es como quedaron las etiquetas.
Una fuente más de confusión que vale la pena aclarar ahora. Gemini 3.5 Flash-Lite no es el Gemini 3.1 Flash-Lite anterior de la generación previa. Mismo nombre "Flash-Lite", diferente modelo, diferentes números. Si construiste sobre 3.1 Flash-Lite anteriormente, este es el reemplazo más nuevo y rápido, no un cambio de nombre de lo que ya tenías. Comprueba el ID del modelo antes de asumir: gemini-3.5-flash-lite es el nuevo.
Especificaciones y precios
Aquí tienes lo que cuesta Flash-Lite y cómo se comporta. Todos los precios son por millón de tokens a través de la API de Gemini.
| Atributo | Valor |
|---|---|
| ID de modelo | gemini-3.5-flash-lite |
| Precio de entrada | $0.30 / 1M tokens |
| Precio de salida | $2.50 / 1M tokens |
| Velocidad | ~350 tokens de salida/segundo |
| Nivel gratuito | Sí (Google AI Studio, con límite de tasa) |
| Caché de contexto | $0.03 / 1M tokens + $1.00 / 1M/hora de almacenamiento |
Esos $0.30 de entrada y $2.50 de salida son las tarifas publicadas más baratas en la línea actual de Gemini. En comparación, el modelo principal 3.6 Flash cuesta $1.50 de entrada y $7.50 de salida, por lo que Flash-Lite es aproximadamente una quinta parte del costo de entrada y un tercio del costo de salida. Cuando procesas millones de llamadas cortas, esa diferencia es el punto clave. Puedes confirmar los números actuales en la documentación de precios de la API de Gemini, ya que Google actualiza esa página directamente.
El almacenamiento en caché de contexto reduce aún más el costo para las solicitudes que envías repetidamente, como un prompt de sistema fijo o un documento de referencia largo. Pagas una pequeña tarifa para almacenar en caché los tokens más una tarifa de almacenamiento por hora, y la entrada en caché es mucho más barata en cada reutilización.
¿Qué tan bien funciona?
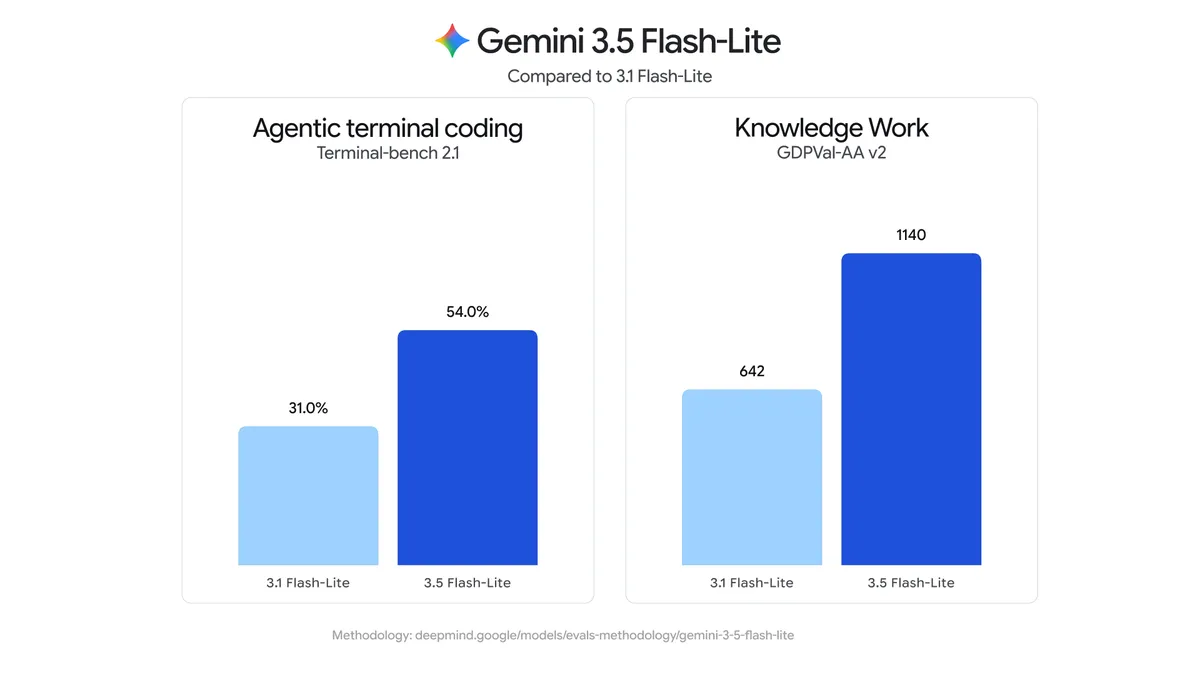
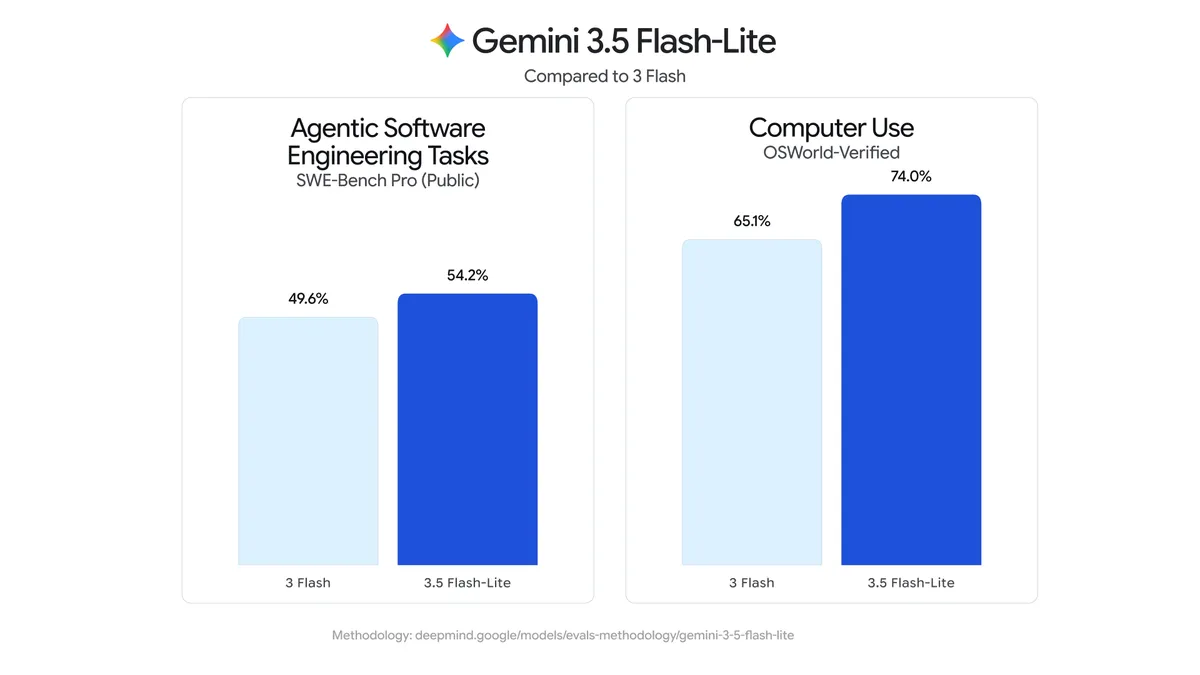
El número principal: Gemini 3.5 Flash-Lite obtiene un 54% en Terminal-Bench 2.1, frente al 31% de su predecesor. Este es un salto real para un modelo de clase Lite, y significa que el nivel pequeño ahora es genuinamente útil para tareas que solían escaparse.
Donde brilla: clasificación, extracción, respuestas de chat y respuestas sencillas aumentadas por recuperación. Esos son los trabajos donde un modelo rápido y barato se justifica. Clasificar entradas en cubos, extraer datos estructurados de texto desordenado, responder una pregunta corta basada en un pasaje recuperado, mantener un asistente ligero receptivo. Flash-Lite maneja todo eso bien y rápido.
Ahora el límite honesto. Flash-Lite sacrifica calidad por costo y velocidad. No es el modelo para la codificación agencial más difícil, cadenas de herramientas largas de varios pasos o problemas de razonamiento profundo. Cuando una tarea necesita planificar muchos pasos, llamar herramientas de forma fiable en secuencia o razonar a través de una base de código complicada, querrás Gemini 3.6 Flash o un modelo más grande. Elegir Flash-Lite para ese trabajo ahorra dinero hasta que las respuestas incorrectas te cuesten más de lo que ahorraste. Adapta el nivel a la tarea.
Dónde utiliza Google Flash-Lite
Google no solo vende Flash-Lite a los desarrolladores. Está incorporando el modelo en la Búsqueda de Google. Esta es una señal útil: cuando Google pone un modelo frente al tráfico a escala de la Búsqueda, está apostando a que el modelo es lo suficientemente rápido y barato como para ejecutarse en un número enorme de consultas sin fallar en la latencia o el presupuesto.
Para ti, eso es una prueba. Las mismas propiedades que hacen que Flash-Lite sea adecuado para la Búsqueda, alto rendimiento y bajo costo por llamada, son exactamente lo que lo hacen adecuado para un punto final de producción ocupado. Si puede atender el tráfico de la Búsqueda, puede atender tu pipeline de clasificación.
Flash-Lite vs Gemini 3.6 Flash: ¿cuál deberías elegir?
Versión corta: elige Flash-Lite cuando el trabajo sea simple, de alto volumen y sensible a la velocidad. Elige 3.6 Flash cuando el trabajo requiera un razonamiento más sólido, codificación o trabajo de agente de varios pasos.
Flash-Lite gana en precio y latencia. Es el Gemini más barato y funciona a unas 350 tokens por segundo, por lo que es la opción predeterminada adecuada para clasificación, extracción, chat corto y RAG simple a escala. Gemini 3.6 Flash cuesta más por token pero razona con mayor profundidad, codifica mejor y se mantiene en flujos de trabajo de agente donde Flash-Lite tropezaría. El precio de 3.6 Flash refleja eso: pagas por la capacidad adicional.
Un patrón práctico es enrutar por dificultad. Envía las llamadas fáciles y frecuentes a Flash-Lite y escala las difíciles a 3.6 Flash. Obtienes un rendimiento barato en la mayor parte del tráfico y un razonamiento más sólido solo donde vale la pena el costo. Para una comparación completa lado a lado de velocidad, precio y calidad, consulta Gemini 3.5 Flash-Lite vs 3.6 Flash.
Cómo acceder y probarlo
Flash-Lite se ejecuta en la API de Gemini. La forma más rápida de empezar es Google AI Studio: obtén una clave API, y el nivel gratuito te permite probar el modelo antes de configurar la facturación. Ten en cuenta que el nivel gratuito tiene límites de tasa, y Google puede usar los datos del nivel gratuito para mejorar sus productos, así que mantén las entradas sensibles con una clave de pago. La referencia completa se encuentra en la documentación de la API de Gemini. Configura el modelo en gemini-3.5-flash-lite y estarás llamando al nivel más barato.
Una vez que tus solicitudes funcionen, querrás que sigan funcionando. Los precios, los límites de tasa y las formas de respuesta cambian a medida que Google actualiza la API, y un modelo Lite que es rápido pero ocasionalmente incorrecto necesita aserciones para detectar desviaciones. Ahí es donde un cliente API ayuda. Con Apidog puedes construir la solicitud POST al endpoint de Gemini, almacenar tu clave API como una variable de entorno para que nunca esté en el cuerpo de la solicitud, y agregar aserciones sobre el código de estado y los campos JSON de los que dependes.
A partir de ahí, puedes convertir esa solicitud en una prueba de regresión guardada y programarla para que se ejecute, de modo que detectes una respuesta rota o un cambio de precios antes que tus usuarios. Apidog no ejecuta el modelo ni reemplaza la API de Gemini; es el cliente que usas para llamar, validar y monitorear el endpoint. Descarga Apidog si quieres probar el endpoint gemini-3.5-flash-lite junto con el resto de tu pila de API.
Preguntas Frecuentes
¿Es Gemini 3.5 Flash-Lite lo mismo que Gemini 3.6 Flash? No. Son dos modelos diferentes de la misma actualización del 21 de julio de 2026. Flash-Lite es el nivel más barato y rápido para trabajos simples de gran volumen. 3.6 Flash es el modelo principal más caro con un razonamiento y codificación más fuertes.
¿Por qué es 3.5 y no 3.6? Versionado mixto. Google actualizó el modelo principal Flash a 3.6, pero mantuvo Flash-Lite y el modelo de seguridad restringido Cyber en la etiqueta 3.5 en el mismo lanzamiento. El número sigue la línea del modelo, no la fecha de lanzamiento.
¿Es este el antiguo Gemini 3.1 Flash-Lite? No. Gemini 3.5 Flash-Lite es un modelo más nuevo. El antiguo 3.1 Flash-Lite es la generación anterior. Mismo nombre de familia, diferente modelo y versión, así que comprueba el ID del modelo gemini-3.5-flash-lite para asegurarte de que estás en el nuevo.
¿Es Gemini 3.5 Flash-Lite gratuito? Hay un nivel gratuito a través de Google AI Studio, y está limitado por tasa. Está bien para pruebas y uso ligero. Para volumen de producción, se pasa a una clave API de pago, y Google puede usar datos del nivel gratuito para mejorar sus productos.
¿Para qué es mejor Flash-Lite? Clasificación, extracción, respuestas cortas de chat y respuestas sencillas aumentadas por recuperación a gran volumen. No es la opción para codificación agencial difícil o razonamiento largo de varios pasos, donde 3.6 Flash encaja mejor.