
Firecrawl Local es un único binario de Rust que hace scraping, crawling y mapeo de sitios web a markdown limpio en tu propia máquina. Se instala con cargo install firecrawl-local y puede servir la API v2 de Firecrawl en localhost:3002 sin clave de API, sin base de datos, sin cola y sin contenedor. La búsqueda y algunas otras funciones todavía recurren a Firecrawl Cloud, y puedes desactivarlo.
A continuación: qué se ejecuta en tu portátil, qué va a la nube, cómo instalarlo, las rutas de API que sirve, sus límites y cómo permitir que tu agente de programación pruebe la API local con Apidog CLI.
¿Qué es Firecrawl Local?
Firecrawl Local es la edición de código abierto y en el dispositivo de Firecrawl. Es un solo binario que obtiene páginas web, las limpia con el mismo código de limpieza de HTML que usa la API alojada de Firecrawl y devuelve markdown, HTML o enlaces. Se ejecuta como CLI, como servidor MCP para agentes de IA o como copia local de la API v2 de Firecrawl.
Firecrawl lo anunció el 18 de noviembre de 2026 en una publicación de lanzamiento en X, y el código está en la carpeta apps/local del repositorio de Firecrawl. El paquete está publicado en crates.io como firecrawl-local, y el repositorio tiene licencia AGPL-3.0.
Firecrawl afirma que es 37 veces más rápido que Firecrawl autoalojado y que usa 230 veces menos memoria (11 MB en reposo). El README no publica ningún método de benchmark, así que conviene tomarlo como afirmaciones del proveedor.
Si conoces la API alojada o la CLI de Firecrawl, la idea es sencilla: las mismas llamadas, respondidas en tu máquina.
Cómo funciona Firecrawl Local: un binario, diez comandos
Cada función está detrás de un subcomando de firecrawl-local. Esta es la lista completa del README:
| Comando | Qué hace | Se ejecuta en |
|---|---|---|
scrape <urls...> |
Hace scraping de una o varias URL | Tu máquina |
crawl <url> |
Sigue enlaces desde una URL de inicio | Tu máquina |
map <url> |
Lista las URL de un sitio a partir de los sitemaps y la página de inicio | Tu máquina |
serve |
Ejecuta la API v2 de Firecrawl en localhost | Tu máquina |
mcp |
Ejecuta el servidor MCP de Firecrawl por stdio | Tu máquina, algunas herramientas en la nube |
init |
Añade el servidor MCP a las herramientas de IA de esta máquina | Tu máquina |
search <query> |
Busca en la web | Firecrawl Cloud |
find-tools <query> |
Busca proveedores de datos de Alexandria | Firecrawl Cloud, inicio de sesión |
data <provider> <capability> |
Ejecuta un proveedor de datos de Alexandria | Firecrawl Cloud, inicio de sesión |
login |
Inicia sesión en Firecrawl en el navegador | Firecrawl Cloud |
Tres comandos cubren la mayor parte del uso diario:
# Print one page as markdown
firecrawl-local scrape https://example.com --markdown

# Crawl up to 50 pages and save one markdown file per page
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# List every URL on a site
firecrawl-local map https://firecrawl.dev
Sin --markdown, scrape imprime el JSON de la API de Firecrawl. --format acepta markdown, html, rawHtml y links. Los PDF y los documentos de Office también se procesan localmente.
Para páginas con JavaScript, utiliza el Chrome o Chromium que ya tengas. Sin uno, las páginas estáticas siguen funcionando y una página que necesitaba un navegador devuelve una advertencia. --browser auto|never|always decide cuándo se usa Chrome.
Qué se ejecuta localmente y qué en Firecrawl Cloud
El scraping, el crawling, el mapeo y el procesamiento de documentos se ejecutan en tu máquina y no envían nada a Firecrawl. Tres funciones van a Firecrawl Cloud porque un portátil no tiene el índice, la red ni los datos:
- Búsqueda. No hay ningún índice de búsqueda en tu máquina. La búsqueda sin clave funciona, pero tiene límite de frecuencia.
- Páginas que rechazan tu máquina. Si un sitio bloquea tanto la petición directa como el navegador local, Firecrawl Cloud lo obtiene. No hace falta cuenta.
- Proveedores de datos de Alexandria. Se ejecutan en Firecrawl Cloud y requieren una cuenta gratuita. Nuestra explicación de Firecrawl Alexandria cubre qué son.
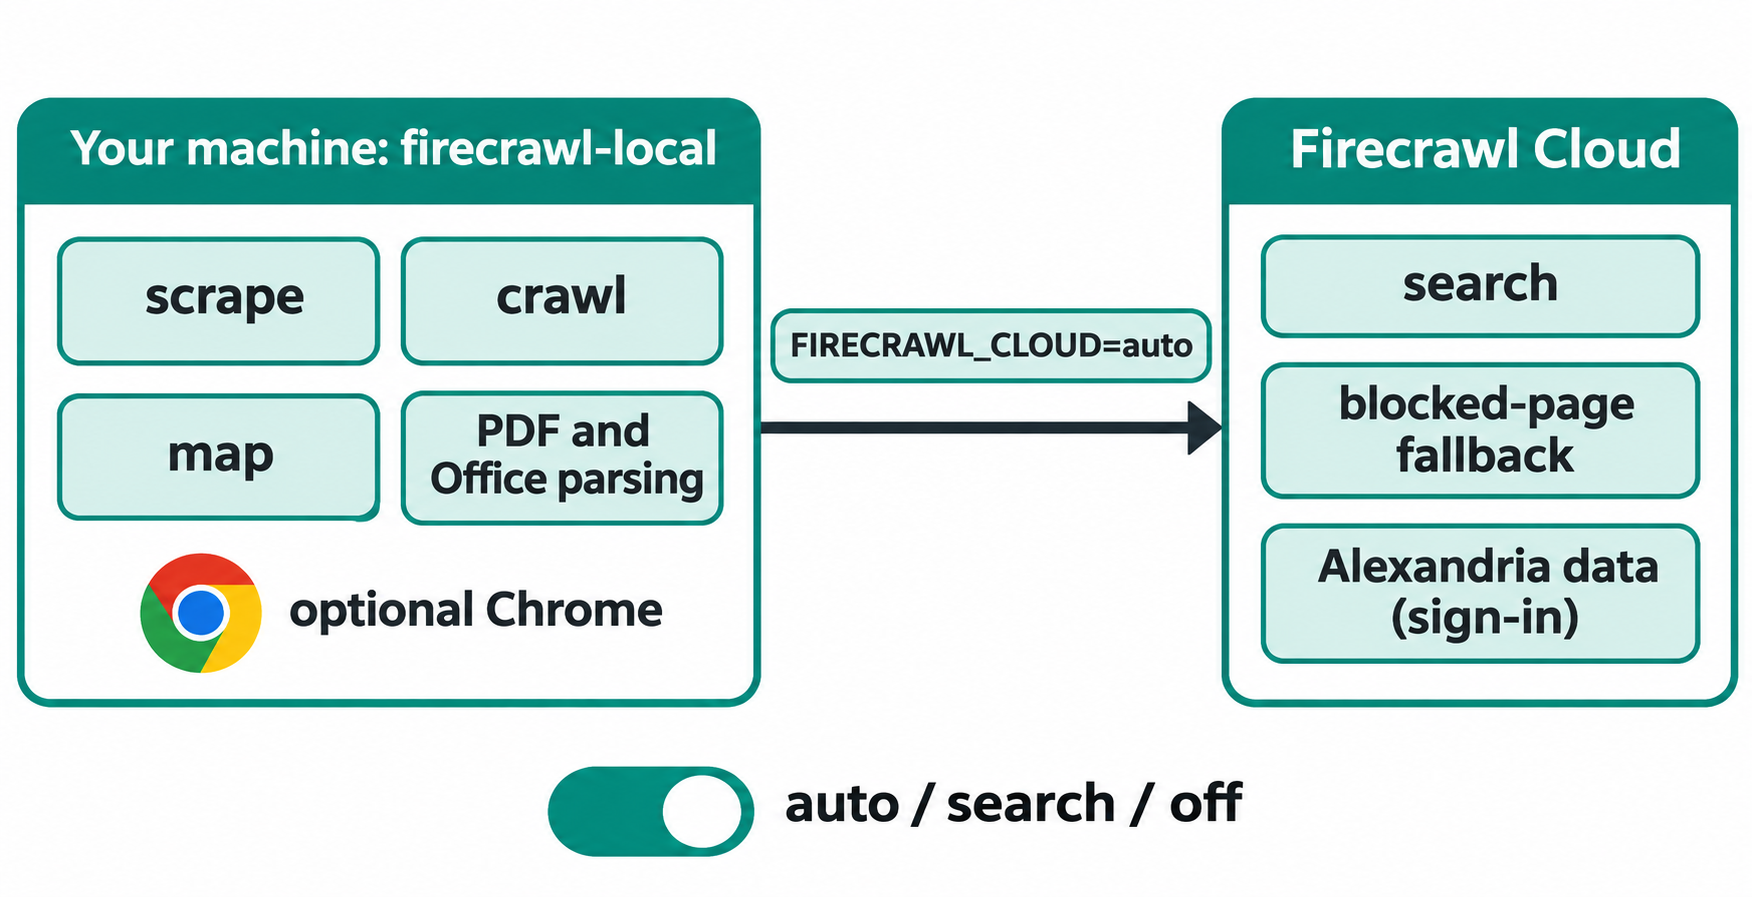
La variable de entorno FIRECRAWL_CLOUD controla el traspaso:
| Valor | Efecto |
|---|---|
auto (predeterminado) |
Funcionan la búsqueda, el recurso alternativo para páginas bloqueadas y Alexandria |
search |
Solo la búsqueda va a Firecrawl Cloud |
off |
Nada va a Firecrawl Cloud |
Un valor no reconocido cuenta como off. Los resultados obtenidos de la nube llevan "source": "firecrawl-cloud"; si la nube también falla, obtienes "blocked": true.
Las llamadas a la nube llevan un ID de instalación aleatorio y el nombre de la herramienta que llama, que es como Firecrawl cuenta las instalaciones.
Cómo instalar Firecrawl Local
Necesitas Rust y un compilador de C. Después:
- Instala las herramientas de compilación. En macOS ejecuta
xcode-select --install. En Debian o Ubuntu instalabuild-essential. - Añade Chrome o Chromium (opcional) si necesitas páginas renderizadas con JavaScript o capturas de pantalla.
- Añade Node.js 22 o superior (opcional) si quieres el servidor MCP, que ejecuta el paquete npm
firecrawl-mcpmediantenpx. - Inicia sesión (opcional) con
firecrawl-local loginpara los proveedores de Alexandria.
Instala el binario desde crates.io.
cargo install firecrawl-local
firecrawl-local --version
Para compilar el código más reciente, ejecuta cargo build --release en apps/local de un clon del repositorio.
La API de Firecrawl Local: las rutas v2 en localhost:3002
firecrawl-local serve responde a la API v2 de Firecrawl en el puerto 3002. No se necesita clave de API para las rutas locales.
firecrawl-local serve

# in another terminal
curl -s http://localhost:3002/v2/scrape \
  -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
Estas rutas se ejecutan en tu máquina:
| Ruta | Qué hace |
|---|---|
POST /v2/scrape |
Hace scraping de una URL |
POST /v2/map |
Lista las URL de un sitio |
POST /v2/crawl, GET y DELETE /v2/crawl/{id} |
Inicia, consulta y cancela un crawl |
POST /v2/batch/scrape, GET y DELETE /v2/batch/scrape/{id} |
Inicia, consulta y cancela un scraping por lotes |
GET /health |
Comprobación de estado |
Cualquier otra ruta /v2, como /v2/search, se reenvía a Firecrawl Cloud salvo que FIRECRAWL_CLOUD indique lo contrario. Las rutas v0 y v1 no se sirven.
El código existente se migra cambiando un solo ajuste: apunta la URL de la API de cualquier SDK de Firecrawl a http://localhost:3002. Tu scraper o pipeline de RAG conserva su código y dejas de gastar créditos de la nube mientras iteras. Para una visión más amplia de los pipelines de scraping, consulta nuestra guía de web scraping con Firecrawl.
Firecrawl Local como servidor MCP para agentes de IA
firecrawl-local init registra Firecrawl Local como servidor de Model Context Protocol en todas las herramientas de IA que encuentra. Reconoce Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI y Codex, hace una copia de seguridad de cada archivo de configuración antes de modificarlo y admite --dry-run para previsualizar los cambios o --agent cursor para configurar una sola herramienta.
Tu agente obtiene las herramientas estándar del MCP de Firecrawl: el scraping, el crawling, el mapeo y el scraping por lotes se ejecutan localmente, y el resto va a Firecrawl Cloud.
Si tu agente navega por sitios en los que no confías, regístralo como firecrawl-local mcp --public-only. De lo contrario, una página con instrucciones ocultas podría dirigir al agente a abrir una URL interna de tu red.
Límites de Firecrawl Local
Firecrawl Local no es el servidor Firecrawl completo. El README enumera lo que falta:
- No hay formatos
jsonnisummaryen local. Los scrapes locales los omiten con una advertencia, porque necesitan un modelo. - No hay
actionsde navegador. Los pasos de clics, desplazamientos y escritura se ignoran. - Las capturas de pantalla necesitan Chrome.
- Los trabajos viven en memoria. Los trabajos de crawl y por lotes caducan una hora después de empezar y se pierden cuando
servese detiene. - No hay rutas v0 ni v1 de la API.
Para colas, workers y todos los formatos, el servidor completo en apps/api sigue existiendo, cubierto en la guía de autoalojamiento de Firecrawl.
Valores predeterminados de seguridad que deberías conocer
Los valores predeterminados varían según el comando, porque serve recibe solicitudes de otros programas:
scrape,crawl,mapymcpse ejecutan para la persona frente al teclado, por lo que pueden acceder alocalhosty a tu red privada.scrape,crawlymcpaceptan--public-onlypara rechazar esas direcciones.servese vincula a127.0.0.1y rechaza objetivos de localhost y privados a menos que pases--allow-private. Vincular otra dirección con--hostrequiere--token.- Las direcciones link-local y de metadatos de nube siempre están bloqueadas, incluso después de redirecciones y de la resolución DNS.
Chrome se ejecuta en modo headless y en un sandbox con un perfil desechable. Al hacer crawling, Firecrawl Local lee robots.txt según el Protocolo de exclusión de robots, donde los propietarios de sitios pueden dirigirse a él como FirecrawlLocal.
Para quién es Firecrawl Local
- Desarrolladores que crean scrapers o pipelines de RAG y quieren iterar de forma gratuita y rápida antes de pagar por volumen en la nube.
- Usuarios de agentes de programación que quieren lectura web dentro de Claude Code, Cursor o Codex sin enviar cada página a través de un tercero.
- Equipos con normas sobre datos que necesitan que el contenido obtenido permanezca en la máquina, usando
FIRECRAWL_CLOUD=off.
Encaja peor si dependes de la extracción con json, de acciones de navegador o de trabajos de crawl de larga duración. Si solo necesitas búsqueda para agentes, consulta nuestra recopilación de búsqueda web de código abierto para Claude.
Deja que tu agente de programación pruebe la API local con Apidog CLI
Cuando serve se está ejecutando, tienes una API HTTP real en localhost:3002. Antes de conectar un pipeline, comprueba que las rutas responden como espera tu código. Dale a tu agente de programación Apidog CLI y un solo prompt en lugar de ir haciendo clic en cada solicitud.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Después pídeselo a tu agente:
Start firecrawl-local serve in the background. Write an OpenAPI 3 file for its
local routes (POST /v2/scrape, POST /v2/map, GET /health) and import it into
Apidog project <id>. Create an environment pointing at http://localhost:3002,
add test cases that assert /health returns 200 and /v2/scrape returns
success: true with non-empty data.markdown for https://example.com, then run
them and summarize any failures.
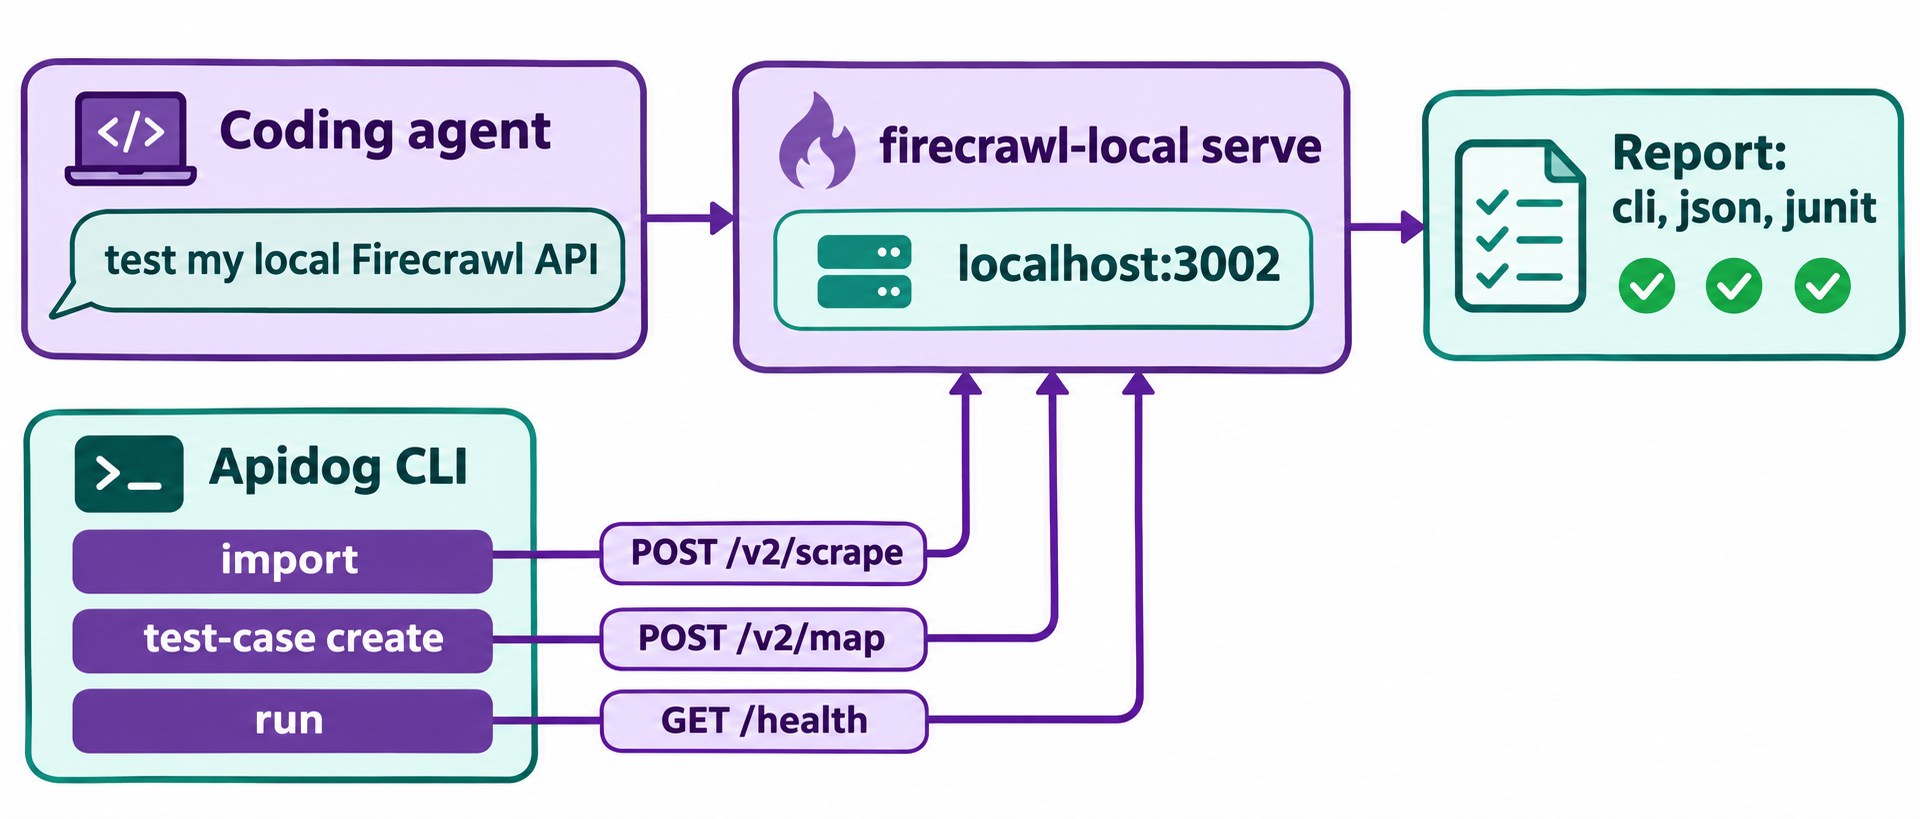
El agente lee el esquema, valida su payload y ejecuta comandos como estos:
firecrawl-local serve &
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file ./case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Apidog CLI envía las solicitudes desde tu máquina, así que localhost:3002 es accesible. Cambia -r cli,json por -r junit y la misma ejecución se integra en CI; nuestra guía de Apidog CLI para pipelines de CI/CD muestra la configuración, y Apidog CLI en Claude Code recorre el lado del agente. El plan gratuito de Apidog cubre equipos de hasta 4 usuarios.
Preguntas frecuentes
¿Firecrawl Local es gratuito? El binario es de código abierto bajo AGPL-3.0, y el scraping, el crawling y el mapeo locales no necesitan clave de API. La búsqueda, el recurso alternativo para páginas bloqueadas y Alexandria van a Firecrawl Cloud, y Alexandria requiere una cuenta gratuita.
¿Puedo usar el código de mi SDK de Firecrawl existente con Firecrawl Local? Sí, para las rutas locales. Configura la URL de la API del SDK en http://localhost:3002. El scraping, el mapeo, el crawling y el scraping por lotes se ejecutan localmente; las rutas v0 y v1 no se sirven.
¿Cómo evito que Firecrawl Local llame a la nube? Establece FIRECRAWL_CLOUD=off. La búsqueda y el recurso alternativo para páginas bloqueadas dejan de funcionar, y nada sale de tu máquina excepto un login explícito.
¿En qué se diferencia Firecrawl Local de Firecrawl autoalojado? Firecrawl autoalojado es el servidor completo en apps/api, con colas, workers y todos los formatos. Firecrawl Local es un único binario más ligero que prescinde de los formatos json y summary, de las acciones de navegador y de los trabajos persistentes.