
DeepSeek retiró su modelo insignia con su modelo más pequeño. El 10 de septiembre de 2026, DeepSeek-V4.1-Flash estuvo disponible de forma general (GA) en la API, y la nota de lanzamiento incluye una frase que la mayoría de los laboratorios ocultarían: a partir del 14 de septiembre, cada solicitud a deepseek-v4-pro se redirige a V4.1-Flash y se factura a precios de Flash. El modelo Flash de 552 mil millones de parámetros, con 8 mil millones de parámetros activos en la entrada, ahora responde por toda la familia V4.
Esa es la historia detrás de las búsquedas "deepseek v4.1 flash" de esta semana, y es importante por dos razones. Primero, la arquitectura es nueva. Una división de codificador-decodificador causal, caché KV FP4 a 890 bytes por token, y visión nativa desde el primer paso de preentrenamiento no son cambios incrementales en DeepSeek V4. Segundo, la hoja de precios se movió con ella. Si estaba pagando tarifas de V4-Pro, su factura se reducirá en un 70% o más el día 14, cambie lo que cambie.
Esta guía cubre lo que se lanzó, cómo funciona la arquitectura en términos de desarrollador, lo que dicen los puntos de referencia del proveedor y el cálculo de precios. Concluye con un flujo de trabajo para probar el modelo con sus propias indicaciones en Apidog, porque una tabla de referencia es un punto de partida, no un veredicto.
TL;DR
- DeepSeek-V4.1-Flash está disponible de forma general (GA) a partir del 10 de septiembre de 2026. ID del modelo:
deepseek-flash. URL base sin cambios enhttps://api.deepseek.com. - MoE de 552B (763B con el codificador de visión), 8B activos para el prellenado, 16B activos para la decodificación. Contexto de 1M, salida máxima de 384K.
- Según los propios números de DeepSeek, supera a V4-Pro en HumanEval, GSM8K, DeepSWE y Terminal-Bench.
- Precio máximo: $0.30 por 1M de entrada con fallo de caché, $1.20 por 1M de salida. Fuera de horas punta es la mitad.
- Las solicitudes de V4-Pro se redirigen a V4.1-Flash el 14 de septiembre a las 04:00 UTC.
Lo que se lanzó el 10 de septiembre
DeepSeek realizó una beta interna de dos días a partir del 8 de septiembre bajo el nombre de modelo deepseek-v4.1-flash-expires-on-0910, con un límite de 20 solicitudes concurrentes por cuenta y con el mismo precio que deepseek-v4-flash. TechNode informó sobre esa beta. Dos días después, el modelo se lanzó de forma general (GA), con una entrada en el registro de cambios con fecha 10 de septiembre de 2026 y un anuncio en X.
Tres cambios de nombre son importantes para su código:
- El nuevo ID del modelo es
deepseek-flash. Úselo para nuevas integraciones. - Los nombres heredados
deepseek-v4-flashydeepseek-v4-flash-vision-exptodavía se resuelven, pero son servidos por V4.1-Flash. V4-Flash y V4-Flash-Vision-Exp se retiran como modelos separados. deepseek-v4-prosigue funcionando hasta el 14 de septiembre, luego se redirige a V4.1-Flash.
Las URL base no se movieron: https://api.deepseek.com para el formato OpenAI, https://api.deepseek.com/anthropic para el formato Anthropic. La API de respuestas ya era compatible con la línea Flash, por lo que las integraciones tipo Codex se mantienen. Para obtener detalles de los parámetros, incluyendo la entrada de imágenes y el esfuerzo de razonamiento, vea cómo usar la API de DeepSeek-V4.1-Flash.
La arquitectura de codificador-decodificador causal para desarrolladores
La tarjeta del modelo describe un diseño que DeepSeek llama Codificador-Decodificador Causal, o CED. Esto es lo que significa cada número cuando usted es quien paga por los tokens.
552B parámetros, 763B con visión. La columna vertebral del lenguaje es un modelo de mezcla de expertos de 552 mil millones de parámetros. Agregue el codificador DeepSeek-ViT, entrenado desde cero para este lanzamiento, y el modelo completo alcanza los 763 mil millones. Esos son parámetros almacenados, no el costo de una solicitud.
8B activos para prellenado, 16B activos para decodificación. Este es el cambio principal. Las 40 capas se dividen en 20 capas de codificador y 20 de decodificador. La lectura de su prompt (prellenado) activa unos 8B parámetros por token. La escritura de la respuesta (decodificación) activa unos 16B. Los modelos MoE anteriores de DeepSeek utilizaban un presupuesto de parámetros activos para ambas fases.
¿Por qué es importante esa división? El prellenado está limitado por la computación: se procesa un documento de 200K tokens a través del modelo en una sola pasada. La decodificación está limitada por la memoria: se genera un token a la vez, y el costo es leer pesos y caché KV de HBM. Menos parámetros en el prellenado reducen el tiempo hasta el primer token en entradas largas. Más en la decodificación mejora la calidad de la respuesta donde la computación extra es barata en relación con el tráfico de memoria. Un rastreo de agente con contexto de 1M que produce una respuesta de 2K tokens toma la ruta barata para el 99.8% de sus tokens.
384 expertos enrutados más 1 experto compartido por capa. El enrutador selecciona algunos de los 384 expertos por token, y el experto compartido se ejecuta siempre. Así es como 552 mil millones de parámetros almacenados se convierten en 8 mil millones o 16 mil millones activos.
CSA2 y la caché KV FP4. Compressed Sparse Attention 2 se lanza con tres modos de atención estáticos. Junto con el almacenamiento FP4 para la caché KV principal, la huella de la caché global es de 890 bytes por token, aproximadamente una cuarta parte de DeepSeek-V4-Flash. La nota de lanzamiento lo establece como 1/4 del HBM y 1/8 del almacenamiento SSD de la generación anterior. Con 890 bytes por token, un contexto completo de 1M de tokens necesita aproximadamente 0.9 GB de caché KV. Eso es parte de la razón por la que el límite de concurrencia es de 2,500 para Flash frente a 500 para Pro.
Contexto de 1M, salida de 384K. La atención dispersa se entrenó a 64K y se extendió a 1M en la marca de 34T tokens de un corpus multimodal de 45T tokens. El esfuerzo de razonamiento se describe como continuamente controlable en una escala de 1 a 100; la forma exacta del parámetro de la API para esa escala es [VERIFICAR] contra la documentación.
Puntos de referencia: lo que informa DeepSeek
Cada número en esta sección es informado por DeepSeek de la tarjeta del modelo. Ninguna evaluación independiente se había publicado hasta el 10 de septiembre. Léalos como la afirmación del proveedor, luego ejecute los suyos propios.
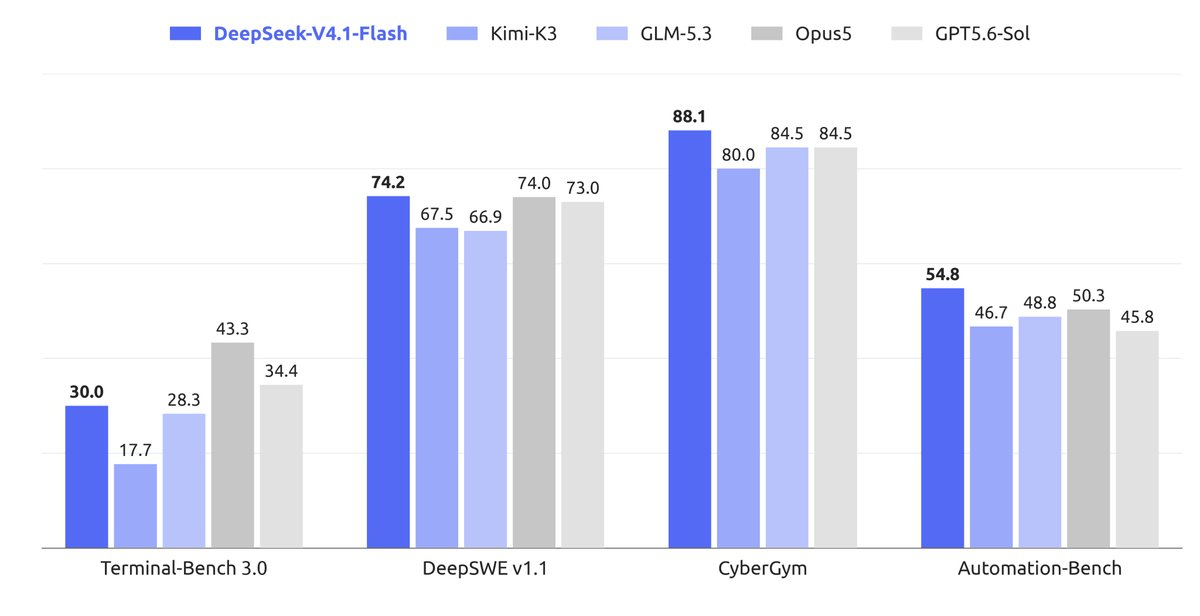
El patrón es consistente: V4.1-Flash se sitúa por encima de V4-Pro en todas las filas, con la brecha más amplia en codificación agentiva. DeepSWE salta 11.5 puntos por encima de Pro y casi 20 por encima del antiguo Flash. GSM8K está saturado, por lo que la ventaja de 0.4 puntos dice poco.
Puntuaciones de visión, nuevamente reportadas por el proveedor: MMMU-Pro 56.5, CVBench 77.9, DocVQA 95.6, RefCOCO 86.0. DocVQA es el número a seguir, ya que el análisis de documentos es donde se dirige la mayor parte del tráfico de visión de producción.
El encuadre de DeepSeek para la redirección de V4-Pro es que V4.1-Flash "ha superado completamente a V4 Pro en rendimiento, costo, velocidad y tiempo total", citando pruebas de múltiples partes. Las partes no se nombran. Trate esa frase como una afirmación que puede verificar.
Precios y la redirección de V4-Pro
Las tarifas a continuación provienen de la página de precios, efectivas a partir del 10 de septiembre a las 04:00 UTC, en USD por 1M de tokens.
| deepseek-flash fuera de horas punta | deepseek-flash horas punta | deepseek-v4-pro fuera de horas punta | deepseek-v4-pro horas punta | |
|---|---|---|---|---|
| Entrada, acierto de caché | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, fallo de caché | $0.15 | $0.30 | $0.66 | $1.32 |
| Salida | $0.60 | $1.20 | $1.98 | $3.96 |
Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC los días de semana; fuera de horas punta es el 50% del precio de horas punta. El almacenamiento en caché del contexto es automático, y un acierto de caché cuesta 50 veces menos que un fallo en cualquiera de los niveles.
Frente a las tarifas de agosto de V4-Flash, V4.1-Flash reduce la entrada con acierto de caché en aproximadamente un 57%, la entrada con fallo de caché en aproximadamente un 32% y la salida en aproximadamente un 9%.
La columna V4-Pro es la que hay que observar. Después del 14 de septiembre, una solicitud enviada a deepseek-v4-pro paga la columna Flash. En horas punta, eso es $0.30 en lugar de $1.32 por 1M de entrada con fallo de caché (77% menos) y $1.20 en lugar de $3.96 por 1M de salida (70% menos). Obtendrá el recorte sin tocar el código, aunque debería actualizar el ID del modelo de todos modos en lugar de depender de un alias retirado. La guía de migración repasa la lista de verificación, y el análisis detallado de precios cubre el cálculo de acierto de caché para sesiones de agente largas.
Evalúe V4.1-Flash con sus propios prompts en Apidog
La tabla del proveedor dice que el modelo es bueno en DeepSWE. No dice si maneja su esquema de extracción, su formato de llamada a herramientas o sus transcripciones de soporte de 300K tokens. Aquí tiene un flujo de trabajo en Apidog que responde a esas preguntas en una tarde y sigue respondiéndolas después de cada actualización silenciosa del modelo.
- Almacene la clave como una variable de entorno. Cree un entorno Apidog y añada
DEEPSEEK_API_KEYdesde la plataforma DeepSeek. Refiérala en el encabezado de Autorización comoBearer {{DEEPSEEK_API_KEY}}. - Añadir el endpoint. Cree
POST https://api.deepseek.com/chat/completions, o importe una especificación OpenAPI. - Guarde una solicitud por cada prompt real. Tome de cinco a diez prompts de los registros de producción y guarde cada uno como su propia solicitud con
"model": "deepseek-flash". Mantenga una copia apuntando adeepseek-v4-prohasta el día 14 para que pueda comparar las salidas una al lado de la otra. - Transmita y observe los eventos. Establezca
"stream": true. Apidog renderiza las respuestas SSE evento por evento, por lo que los deltas de razonamiento y los deltas de respuesta aparecen por separado en lugar de como una pared de líneasdata:. Es la forma más rápida de ver el tiempo hasta el primer token en un prellenado largo. - Añada aserciones y construya un escenario de prueba. Aserte sobre el código de estado, sobre un campo
tool_callsdonde espere uno, y sobre la validez JSON de la salida. Encadene las solicitudes guardadas en un escenario de prueba. - Vuelva a ejecutar en cada actualización del modelo. Cuando DeepSeek impulse el siguiente cambio detrás de
deepseek-flash, ejecute el escenario. Conéctelo a CI conapidog-clipara que se ejecute en cada implementación.
Aquí está el cuerpo de uno de esos prompts guardados, utilizando el SDK de OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
Descargue Apidog y pegue ese cuerpo en una solicitud guardada. Apidog prueba la capa de la API, no un host de modelo, por lo que lo que verá es la respuesta que obtendrán sus usuarios.
Preguntas Frecuentes
¿Es DeepSeek-V4.1-Flash un reemplazo para V4-Pro? Sí, por decisión de DeepSeek. A partir del 14 de septiembre a las 04:00 UTC, las solicitudes a deepseek-v4-pro serán atendidas por V4.1-Flash a precios Flash. No queda ningún modelo más grande en la línea de la API V4.
¿Necesito cambiar mi ID de modelo? No inmediatamente. deepseek-v4-flash, deepseek-v4-flash-vision-exp y (después del día 14) deepseek-v4-pro se resuelven todos a V4.1-Flash. Cambie a deepseek-flash la próxima vez que toque la integración. La guía de la API contiene la referencia completa de los parámetros.
¿Qué significa 8B de prellenado / 16B de decodificación para la latencia? Menos parámetros activos en la entrada significan un tiempo más rápido hasta el primer token en prompts largos. Más en la salida significa que la computación se destina a donde se decide la calidad de la generación. La caché KV de 890 bytes por token mantiene las sesiones largas baratas de mantener en memoria.
¿Puedo ejecutarlo localmente? Los pesos tienen licencia MIT en Hugging Face. El backbone solo es de aproximadamente 552 GB a 8 bits o 280 GB a 4 bits, por lo que este es un proyecto multi-GPU o de transmisión por SSD, no uno para laptop. El soporte del motor de inferencia de día cero es [VERIFICAR].
¿Son independientes los benchmarks? No. Todas las puntuaciones anteriores provienen de la tarjeta del modelo de DeepSeek. El informe técnico tiene la metodología.
Dónde esto deja la línea V4
DeepSeek colapsó una API de dos modelos en uno. La apuesta es que un modelo de 552 mil millones con un presupuesto de decodificación de 16 mil millones, una caché KV de un cuarto de tamaño y 2,500 sesiones concurrentes por cuenta, sirve mejor a las cargas de trabajo de agente que un modelo más grande a un precio tres o cuatro veces mayor. Los números del proveedor respaldan la apuesta; su carga de trabajo decide si se mantiene.
Apunte su SDK a deepseek-flash, ejecute sus propios prompts a través de él antes del día 14 y mantenga el escenario de prueba. Si construyó sobre la API original de V4-Flash, su integración ya funciona. Lo que cambió es el modelo detrás de ella, y esa es la parte que vale la pena medir.