
Para ejecutar Qwen 3.8 27B localmente, instala Ollama y ejecuta ollama pull qwen3.8:27b y luego ollama run qwen3.8:27b. La versión predeterminada es una descarga de 18 GB en 4 bits, por lo que necesitas una GPU con 24 GB de VRAM o un Mac con 32 GB de memoria unificada. Los pesos están bajo licencia Apache-2.0, así que el modelo en sí no cuesta nada. Tu único gasto es el hardware y la electricidad.
Esa es la versión corta. El resto de esta guía cubre los cuatro runners que vale la pena usar (Ollama, LM Studio, llama.cpp y MLX), cuánta memoria necesita cada quant, qué velocidad esperar en hardware real y cómo hacer que tu agente de programación pruebe el endpoint local con Apidog CLI una vez que esté en funcionamiento.
¿Eres nuevo en la familia? Qué es Qwen 3.8 cubre el buque insignia Max de 2,4 billones de parámetros. Esta guía trata sobre su hermano pequeño y denso que cabe en tu escritorio.
¿Qué es Qwen 3.8 27B?
Qwen 3.8 27B es un modelo de visión y lenguaje denso de 27 mil millones de parámetros del equipo Qwen de Alibaba, lanzado en agosto de 2026 bajo Apache-2.0. Lee texto, imágenes y vídeo, razona antes de responder de forma predeterminada y tiene una ventana de contexto nativa de 262.144 tokens que se extiende hasta 1 millón de tokens con el escalado YaRN.
La ficha oficial del modelo enumera estas especificaciones:
| Especificación | Qwen 3.8 27B |
|---|---|
| Parámetros | 27B denso (el Hub indica 28B incluyendo el encoder de visión) |
| Capas | 64, un híbrido de bloques Gated DeltaNet y Gated Attention |
| Contexto | 262.144 nativo, hasta 1.000.000 con YaRN |
| Entradas | Texto, imagen, vídeo |
| Razonamiento | Activado de forma predeterminada, reasoning_effort de xhigh, medium o low |
| Extras | Capas de predicción multi-token (MTP) |
| Licencia | Apache-2.0 |
En la propia tabla de benchmarks de Qwen obtiene 61,7 en SWE-bench Pro, 73,0 en Terminal Bench 2.1 y 89,2 en GPQA Diamond. Esas son cifras del proveedor. Nuestro análisis de los benchmarks de Qwen 3.8 explica cómo leer esa tabla, incluidas las filas que Qwen construyó internamente.
Por qué importa en local: un modelo denso de 27B en 4 bits cabe en una sola GPU de consumo, con llamada de herramientas, visión y razonamiento en el mismo archivo.
¿Cuánta RAM y VRAM necesitas para Qwen 3.8 27B?
Planifica con el tamaño del archivo de tu quant más 3 a 6 GB para la caché KV y el runtime. Para el Q4_K_M predeterminado, eso significa 24 GB de VRAM en una GPU o un Mac de 32 GB.
Estos son los tamaños de archivo GGUF del repositorio de quants de unsloth, verificados el 9 de noviembre de 2026:
| Quant | Tamaño del archivo | Hardware realista |
|---|---|---|
| UD-IQ2_XXS | 7,27 GB | Mac de 16 GB o GPU de 12 GB, pérdida de calidad notable |
| UD-Q3_K_XL | 13,1 GB | GPU de 16 GB, Mac de 24 GB |
| UD-Q4_K_M | 16,5 GB | GPU de 24 GB, Mac de 32 GB (el punto óptimo) |
| UD-Q5_K_M | 19,8 GB | GPU de 24 GB con contexto corto, Mac de 32 GB |
| UD-Q6_K | 22 GB | GPU de 32 GB, Mac de 48 GB |
| Q8_0 | 29 GB | GPU de 48 GB, Mac de 64 GB |
El projector de visión (mmproj-F16.gguf) añade 928 MB si quieres entrada de imágenes. La etiqueta predeterminada qwen3.8:27b de Ollama pesa 18 GB porque incluye visión.
La longitud del contexto es el coste oculto. El cálculo de planificación de llm-speed sitúa Q4_K_M en unos 21,9 GB con un contexto de 32.000 tokens. Por eso las tarjetas de 24 GB son el mínimo práctico para Q4, y por qué no deberías cargar la ventana completa de 262K a menos que te sobre memoria.
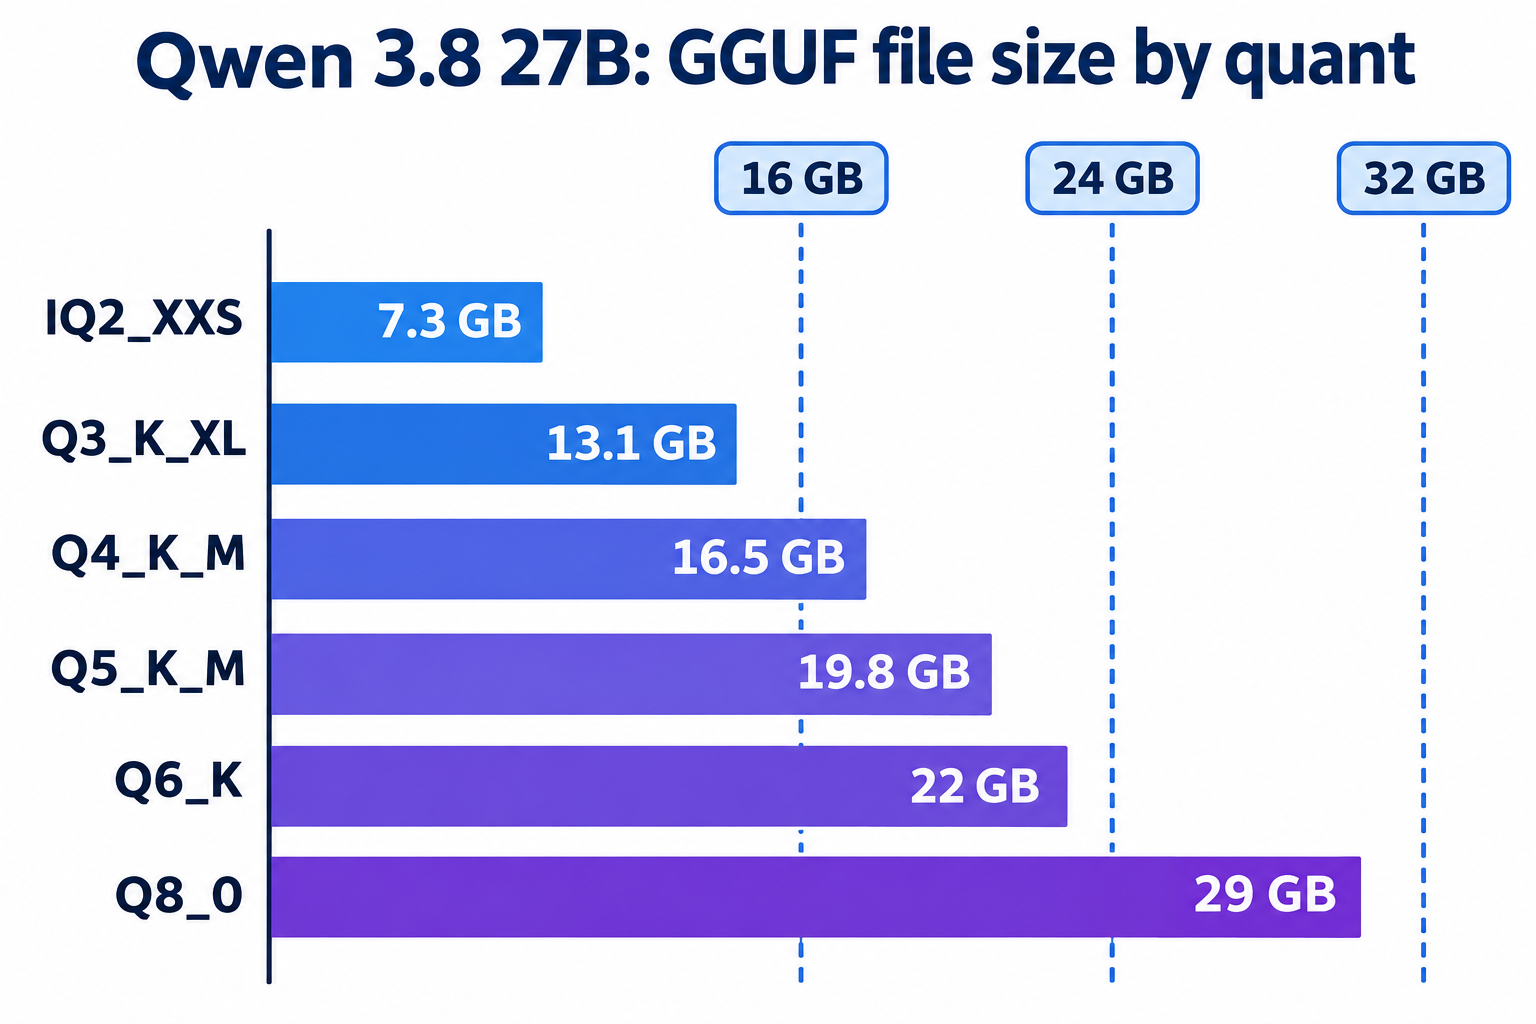
En Macs, recuerda que macOS reserva parte de la memoria unificada para el sistema. Un Mac de 24 GB puede técnicamente cargar Q4_K_M, pero te quedará poco margen para el contexto o tu navegador. Ahí elegiríamos Q3_K_XL.
¿Qué tan rápido funciona Qwen 3.8 27B en local?
Espera entre 38 y 44 tokens por segundo en una RTX 3090 o 4090 con Q4_K_M usando llama.cpp, y entre 65 y 75 en una RTX 5090. Un Mac Studio con M3 Ultra decodifica alrededor de 25 a 27 tokens por segundo.
No hicimos nosotros mismos los benchmarks. Estos son los resultados medidos publicados por llm-speed, con el hardware y runtime que declararon:
| Hardware | Quant / runtime | Decodificación tok/s | Prefill tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38.6 (chat corto, 4K ctx) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43.4 (chat corto, 4K ctx) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75.2 (chat corto, 4K ctx) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34.3 (chat corto) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25.2 (chat corto) | 45 |
| M3 Ultra 96 GB | 4 bits, MLX 0.31.3 | 27.3 (chat corto) | 12 |
La velocidad de decodificación apenas cae con el contexto en GPUs: la 4090 seguía haciendo 39.0 tok/s después de un prompt de 33.133 tokens. El prefill es donde los Macs se quedan atrás. Con un prompt de 11.827 tokens, el M3 Ultra procesó unos 283 tok/s, frente a aproximadamente 2.000-3.000 en la 4090, así que una base de código grande implica decenas de segundos antes del primer token.
El razonamiento también consume tu presupuesto de tiempo. Cuando Simon Willison le pidió a un Qwen 3.8 27B local identificar juegos a partir de pesos crudos de modelos, una respuesta tardó 46 minutos y 43.506 tokens de razonamiento. Para tareas cotidianas, reduce reasoning_effort a low o desactiva el razonamiento.
Ejecutar Qwen 3.8 27B con Ollama
Ollama es la vía más rápida en cualquier sistema operativo. Instálalo desde ollama.com y luego:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
En Apple Silicon, prueba la etiqueta qwen3.8:27b-mlx, que usa el backend MLX con los mismos 18 GB.
El contexto predeterminado de Ollama es pequeño, lo que rompe las sesiones largas de agentes. Auméntalo antes de iniciar el servidor:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
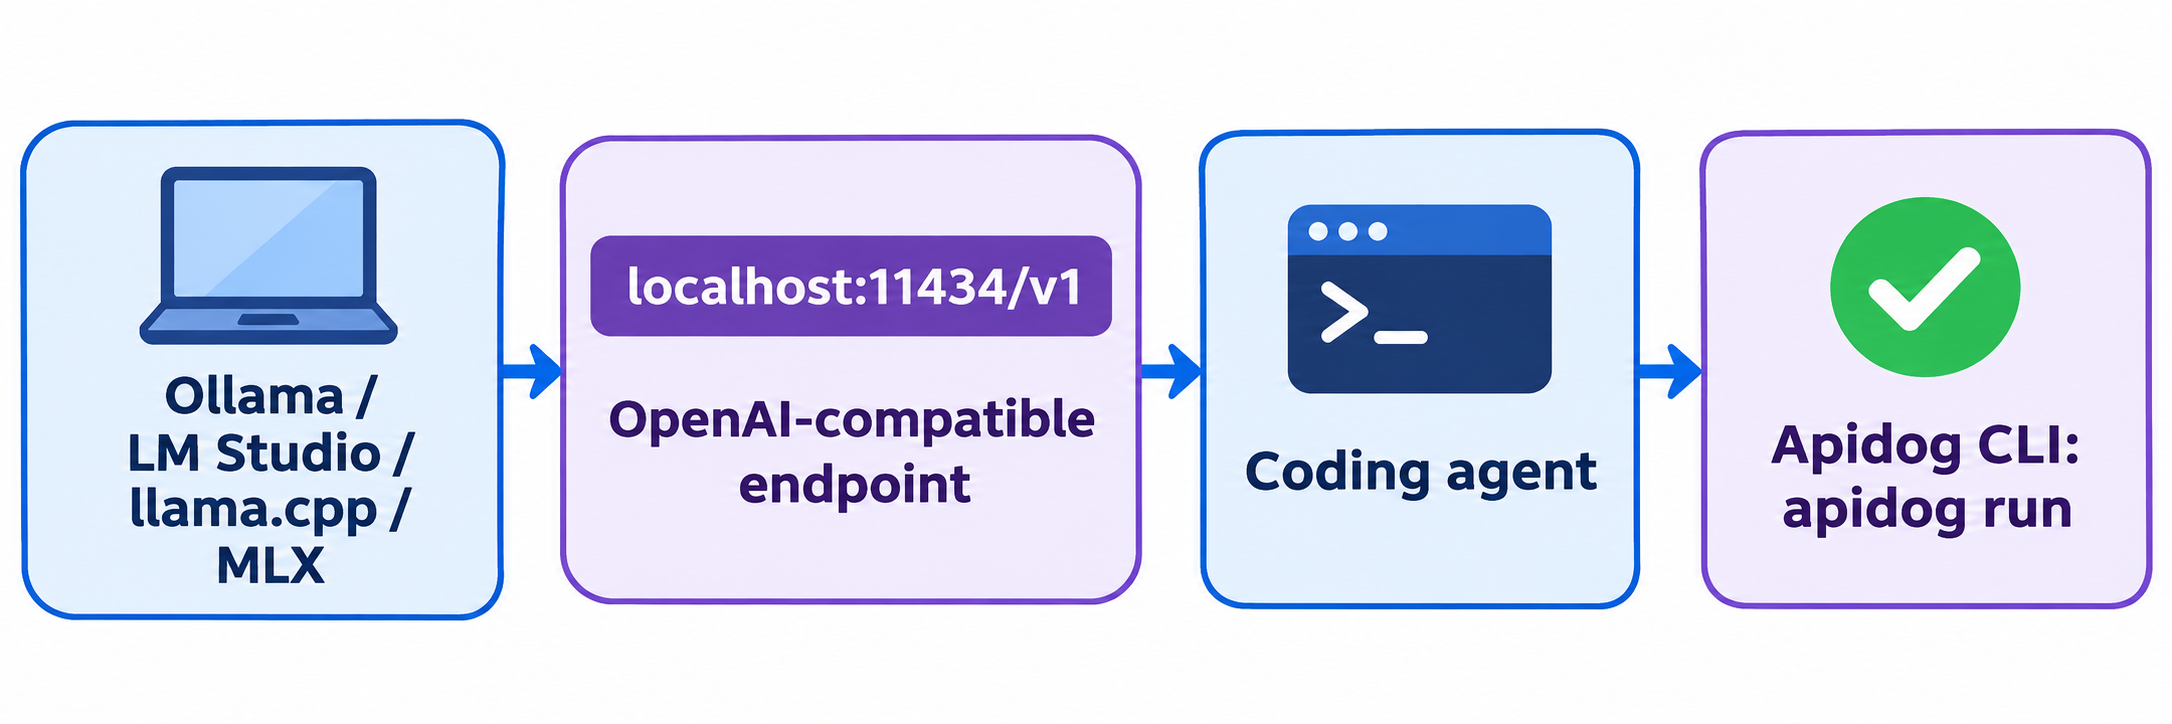
Ollama también expone una API compatible con OpenAI en http://localhost:11434/v1, por lo que cualquier SDK de OpenAI funciona cambiando la URL base:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
¿Lo quieres dentro de un agente de programación? Ollama incluye atajos de lanzamiento: ollama launch claude --model qwen3.8 inicia Claude Code contra el modelo local, y ollama launch opencode --model qwen3.8 hace lo mismo para OpenCode.
Ejecutarlo con LM Studio
LM Studio es la opción si quieres una interfaz gráfica y ajustes de carga por modelo. Busca Qwen 3.8 27B, descarga la versión lmstudio-community/Qwen3.8-27B-GGUF en Q4_K_M (16,8 GB) y cárgala.
Un ajuste importa: sube la longitud del contexto al cargar el modelo. Simon Willison descubrió que el contexto predeterminado de 8.192 tokens fallaba con errores en su prompt largo y tuvo que cargar una ventana mayor.
Luego abre la pestaña Developer y arranca el servidor local, o ejecuta lms server start desde una terminal. El endpoint compatible con OpenAI está en http://localhost:1234/v1.
Ejecutarlo con llama.cpp
llama.cpp te da el mayor control y mueve la mayoría de los benchmarks anteriores. En macOS o Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf descarga el quant directamente de Hugging Face, --jinja aplica la plantilla de chat del modelo (necesaria para llamadas a herramientas y razonamiento), -c fija el contexto y -ngl 99 pone todas las capas en la GPU. Los valores de muestreo son las recomendaciones de Qwen para el modo de razonamiento. Para el modo sin razonamiento, la ficha del modelo sugiere temperatura 0.7, top_p 0.8, top_k 20 y presence_penalty 1.5.
Para desactivar el razonamiento en una sola petición, envía "chat_template_kwargs": {"enable_thinking": false} en el cuerpo.
Ejecutarlo con MLX en un Mac
MLX es el framework de arrays de Apple y suele ser el runtime más rápido en Apple Silicon para la decodificación. Instala mlx-lm y usa la conversión de 4 bits de mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server expone una ruta /v1/chat/completions compatible con OpenAI. La organización mlx-community también publica variantes de 8 bits, mxfp4 y MTP si quieres intercambiar memoria por calidad o velocidad.
Deja que tu agente de programación pruebe el endpoint local con Apidog CLI
Cada runner sirve la misma estructura compatible con OpenAI, pero cada uno gestiona los bloques de razonamiento, las llamadas a herramientas y los timeouts de forma distinta. Antes de apuntar una aplicación a localhost, haz que tu agente de programación construya una prueba repetible con Apidog CLI, para que una plantilla rota o un límite de contexto se detecte en segundos, no a mitad de una tarea.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego da a Claude Code, Codex o Cursor un solo prompt:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
El agente lee cada esquema de payload, valida su JSON, crea los recursos y ejecuta el caso:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
El --timeout-request largo es importante aquí: un modelo de 27B en modo de razonamiento puede tardar minutos en un Mac. Cambia la URL base a http://localhost:1234/v1 o :8080/v1 y el mismo caso comprueba LM Studio, llama.cpp o MLX. Para más configuraciones de agentes, consulta Apidog CLI en Claude Code y la referencia del comando apidog run. El plan gratuito de Apidog cubre hasta 4 usuarios.
Local frente a la API alojada de Qwen 3.8
La ejecución local mantiene los prompts en tu máquina, funciona sin conexión y no cuesta nada por token. La contrapartida es velocidad y escala: un endpoint alojado sirve al mucho más grande Qwen 3.8-Max con contexto de 1M y sin espera de prefill. Si necesitas el buque insignia, lee nuestra guía de la API de Qwen 3.8 o las vías de acceso gratuito. Para programación agéntica con cualquiera de los dos tamaños, Qwen 3.8 para programación compara las configuraciones de harness.
Preguntas frecuentes
¿Es gratis ejecutar Qwen 3.8 27B en local? Sí. Los pesos están bajo Apache-2.0 en Hugging Face, y Ollama, LM Studio, llama.cpp y MLX son gratuitos. Solo pagas hardware y electricidad.
¿Puedo ejecutar Qwen 3.8 27B en un Mac de 16 GB? Solo con quants de 2 bits como UD-IQ2_XXS (7,27 GB) y con contexto corto, y la calidad baja notablemente. Un Mac de 32 GB con Q4_K_M es la configuración cómoda.
¿Funciona Qwen 3.8 27B en una RTX 3090? Sí. Q4_K_M cabe en 24 GB con espacio para un contexto de 16K a 32K, y llm-speed midió unos 38 tokens por segundo en llama.cpp.
¿Cómo desactivo el modo de razonamiento? Envía "chat_template_kwargs": {"enable_thinking": false} en llama.cpp o vLLM, o reduce reasoning_effort a low. Qwen recomienda temperatura 0.7 y top_p 0.8 para el modo sin razonamiento.
¿El modelo local admite imágenes? Sí. La etiqueta de 18 GB de Ollama incluye visión. Con llama.cpp, descarga el archivo mmproj-F16.gguf junto con el modelo.
¿Cuál es la diferencia entre Qwen 3.8 27B y Qwen 3.8-Max? Max es un buque insignia mixture-of-experts de 2,4 billones de parámetros servido a través de la API de Alibaba. 27B es un modelo denso lo bastante pequeño para una sola GPU o un Mac de 32 GB.