
Puedes ejecutar el nuevo NVIDIA Nemotron 3.5 Transcribe en una sola GPU y transcribir grabaciones de una hora en 40 idiomas sin pagar por minuto ni enviar audio a nadie. Es el mejor modelo de pesos abiertos en la Hugging Face Open ASR Leaderboard, se distribuye bajo la licencia OpenMDW-1.1, apta para uso comercial, y NVIDIA publicó los pesos BF16, FP8 y NVFP4 el día del lanzamiento, el 28 de octubre de 2026.
Esta guía cubre el hardware que necesitas, las tres formas de ejecutarlo (vLLM, SGLang-Omni y Transformers), los comandos exactos de la tarjeta oficial del modelo, y la configuración que suele causar problemas. Todos los comandos se copiaron de la tarjeta el 29 de octubre de 2026.
¿Eres nuevo en el modelo? Nuestra guía gratuita explica qué hace y cómo se posiciona. ¿No tienes una GPU? La API alojada cuesta $0.002 por minuto.
Por qué ejecutarlo localmente
- Sin factura por minuto. A $0.002 por minuto de DeepInfra, 10,000 horas cuestan $1,200. En tu propia GPU cuesta electricidad.
- Privacidad. Las llamadas de clientes, el dictado médico y las grabaciones legales nunca salen de tu red.
- Conjunto completo de funciones. La ruta de vLLM admite marcas de tiempo de palabras, diarización de hablantes, traducción y prompts de contexto. Algunos endpoints alojados solo exponen parte de eso.
- Ajuste fino. La publicación de lanzamiento de NVIDIA muestra un ajuste fino médico que reduce el WER del 30.8% al 11.8%. Solo puedes hacer eso con los pesos.
Hardware: qué lo ejecuta
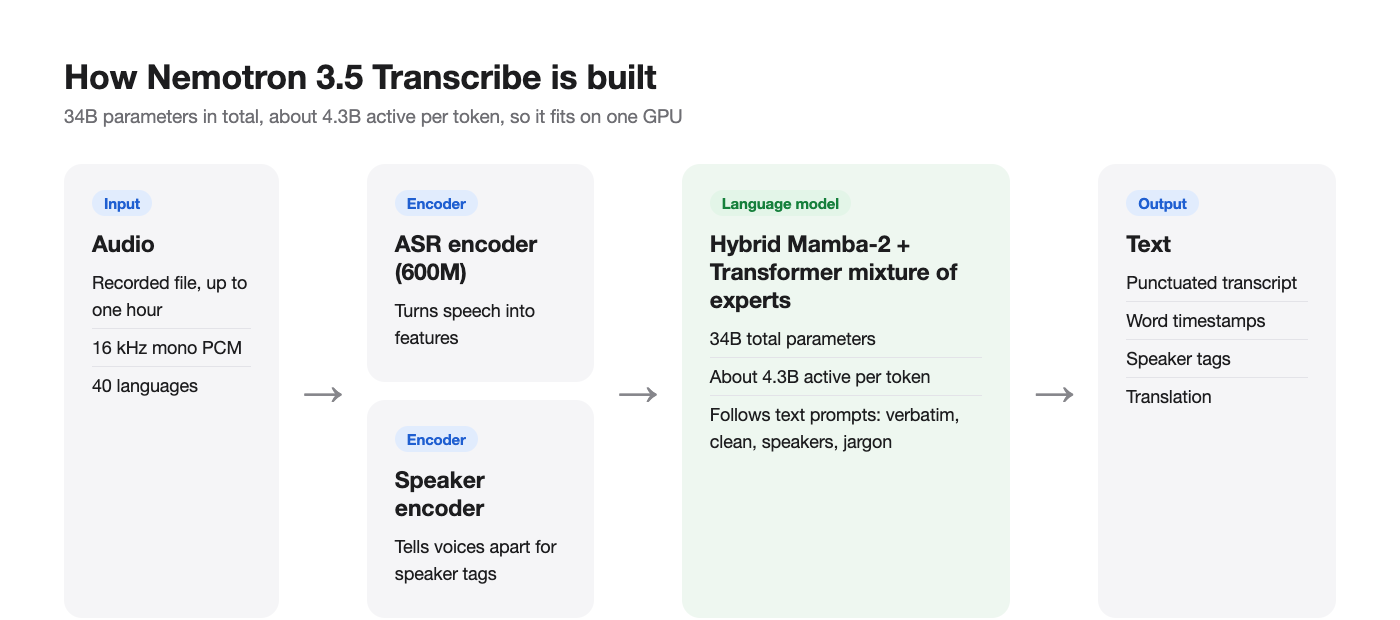
El modelo tiene 34B parámetros en total y aproximadamente 4.3B activos, por lo que los pesos son grandes aunque el cómputo por token es pequeño. El objetivo de referencia de NVIDIA es una H100 de 80 GB en BF16. La tabla de compatibilidad en la tarjeta del modelo:
| GPU | Precisiones | Entornos de ejecución |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | solo NVFP4 | vLLM 0.32.0, Transformers, GGML |
Elige el checkpoint para tu tarjeta:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
Una tarjeta de 24 GB como la RTX 4090 no está en la lista, y Apple Silicon no es compatible. Los sistemas operativos son Linux, o Windows a través de WSL2. GGML también se ejecuta en Windows nativo, pero la publicación de lanzamiento de NVIDIA dice que la compilación local de NeMo-Speech.cpp todavía es “próximamente”.
Opción 1: servidor vLLM (recomendado)
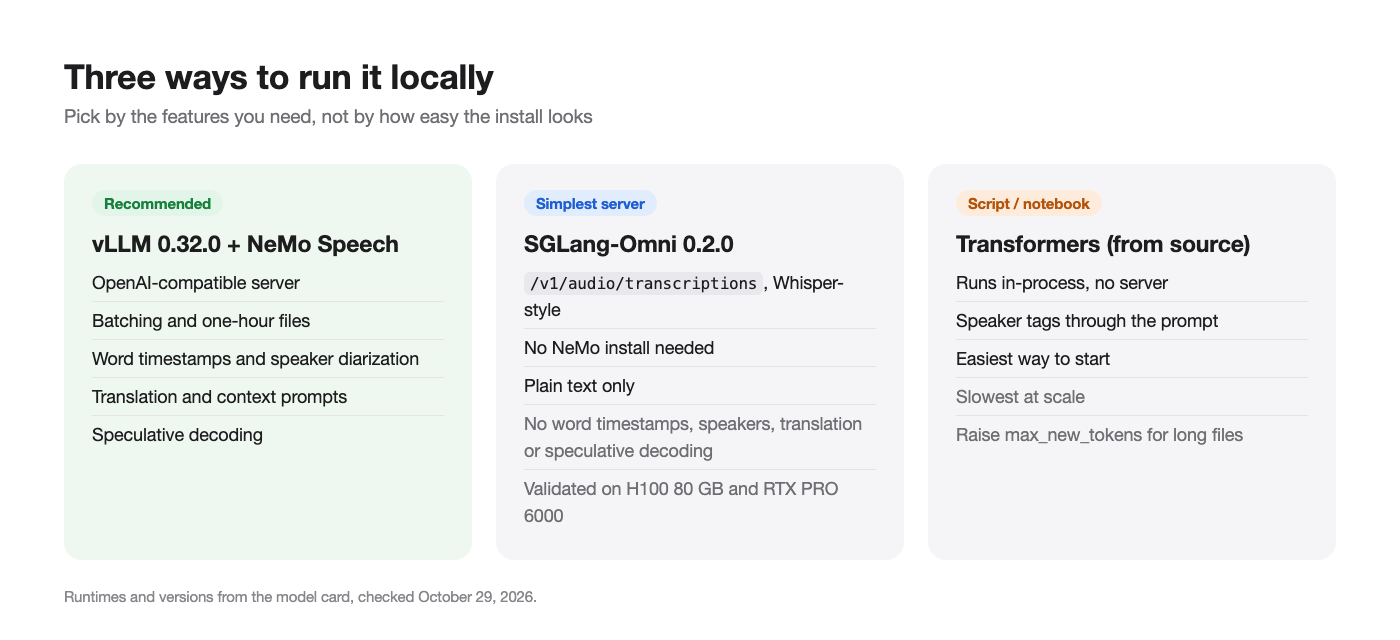
vLLM te ofrece un endpoint compatible con OpenAI con procesamiento por lotes, archivos de una hora, decodificación especulativa y marcas de tiempo de palabras. Necesita vLLM 0.32.0 más la última rama principal de NeMo Speech, que proporciona el plugin de vLLM del modelo.
Instalación
La tarjeta usa uv y Python 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av) le permite decodificar M4A y otros formatos comprimidos sin un FFmpeg del sistema. OpenCV está ahí porque vLLM lo necesita y la configuración de dependencias de NeMo lo omite.
Iniciar el servidor
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
Los flags que vale la pena entender:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600eleva el límite de audio de vLLM de 600 segundos a una hora. Si lo olvidas, los archivos largos fallan.VLLM_USE_V2_MODEL_RUNNER=0mantiene el runner V1, que las marcas de tiempo de palabras necesitan.--speculative-configactiva la predicción multi-token con ocho tokens de borrador (MTP8). En una H100, NVIDIA midió un RTFx de transcripción por lotes en inglés de 270 con MTP8 y 410 con MTP2, así que prueba"num_speculative_tokens":2si te importa más el rendimiento que la latencia.--middleware ... ctc_timestamp_middlewarey--trust-request-mm-kwargspermiten que las solicitudes pidan marcas de tiempo de palabras.- La configuración está pensada para una H100 de 80 GB. En otras tarjetas, reduce
--gpu-memory-utilization,--max-model-leno--max-num-seqs.
El servidor escucha en 127.0.0.1:8000. Añade --host 0.0.0.0 para acceder a él desde otras máquinas de tu red.
Enviar un archivo
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Cambia la instrucción de texto por cualquier prompt de tarea. Para una reunión con varias voces:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Las solicitudes de marcas de tiempo de palabras tienen reglas: una grabación por solicitud, stream=false y n=1. La respuesta entonces incluye un objeto ctc_timestamps con palabras, tiempos de inicio y fin en segundos, y etiquetas de hablante.
Opción 2: SGLang-Omni para transcripción simple
Si solo necesitas texto de archivos completos, SGLang-Omni 0.2.0 es más simple y no necesita NeMo. Está validado en una H100 de 80 GB y una RTX PRO 6000 Blackwell con el checkpoint BF16 o FP8.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Esa ruta /v1/audio/transcriptions coincide con la forma que usa la API de Whisper de OpenAI, por lo que el código de cliente de Whisper existente a menudo solo necesita una nueva URL base. La contrapartida: sin marcas de tiempo de palabras, etiquetas de hablante, traducción ni decodificación especulativa en esta integración.
Opción 3: Transformers en un script
Para notebooks y trabajos puntuales, ejecútalo en proceso con Hugging Face Transformers instalado desde el código fuente:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
Es la forma más fácil de empezar y la más lenta de ejecutar a escala. Aumenta max_new_tokens para archivos largos: una hora densa puede producir unos 20,000 tokens.
¿Qué tan rápido es en tu propia GPU?
La cifra destacada de NVIDIA es 2,238 segundos de audio por segundo en una RTX PRO 6000 Blackwell, con pesos NVFP4 y decodificación especulativa DFlash2, y 0.13 segundos para devolver un clip de 30 segundos. Lee la nota al pie: esos números provienen del NIM optimizado, cuyos cambios de serving aún no son de código abierto. La tarjeta dice que se espera que la integración abierta de vLLM sea aproximadamente dos veces más lenta.
Para transcripción por lotes en inglés con H100 en BF16, la tarjeta enumera estos números de RTFx (segundos de audio por segundo de cómputo):
| Decodificación especulativa | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
Incluso la fila más lenta procesa una hora de audio en menos de 15 segundos de tiempo de GPU en trabajo por lotes. Si quieres el modelo de borrador DFlash2, ten en cuenta que vLLM 0.32.0 necesita un pequeño parche de la tarjeta, DFlash2 desactiva las marcas de tiempo de palabras y no deberías combinarlo con MTP.
Problemas comunes y soluciones
- Archivos largos cortados a los 10 minutos. Omitiste
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600. - Sin marcas de tiempo en la respuesta. Verifica
VLLM_USE_V2_MODEL_RUNNER=0, el flag--middleware, y que la solicitud tengastream=falsey una grabación. - Sin memoria en tarjetas más pequeñas. Cambia al checkpoint FP8 o NVFP4 y reduce
--max-num-seqs. - Frases repetidas al final de una transcripción. La tarjeta recomienda una barrera contra bucles de generación en las salidas finales. Limita
max_tokensy recorta las repeticiones. - Ortografía incorrecta de nombres. Añade
Context terms: <names>al prompt. - Voces de fondo en la transcripción. Prueba el prompt experimental de campo cercano de la tarjeta, que redujo el WER en audio mixto del 27.32% al 4.78% en la prueba de NVIDIA.
Si eres nuevo en vLLM, nuestra explicación de vLLM cubre cómo procesa las solicitudes por lotes y gestiona la memoria de GPU.
Deja que tu agente de codificación pruebe el servidor local con Apidog CLI
Un modelo local solo es útil si su endpoint se mantiene correcto a través de actualizaciones de vLLM, ajustes de prompts y cambios de checkpoint. Deja que tu agente de codificación se encargue de eso con Apidog CLI, ejecutando comprobaciones contra http://127.0.0.1:8000 desde la misma máquina.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un prompt:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
El agente lee el esquema, valida su payload, escribe los casos y los ejecuta:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Ejecútalo después de cada actualización del servidor, o conecta apidog run ... -r junit a CI como se muestra en Apidog CLI en una canalización CI/CD. Para la configuración del agente, consulta Apidog CLI en Claude Code.
Preguntas frecuentes
¿Puedo ejecutar Nemotron 3.5 Transcribe en una RTX 4090? No está en la lista de compatibilidad de NVIDIA. La tarjeta de consumo más pequeña listada es la RTX 5090 con el checkpoint NVFP4.
¿Se ejecuta en una Mac? Ningún runtime oficial admite Apple Silicon a partir del 29 de octubre de 2026.
¿El uso local es gratuito para productos comerciales? La licencia OpenMDW-1.1 permite uso comercial y no comercial. Lee el texto de la licencia para los términos de atribución antes de lanzar.
¿Puede transcribir audio en vivo? No. Es un modelo offline para archivos grabados. NVIDIA ofrece un modelo separado Nemotron 3.5 ASR Streaming para uso en vivo.
¿Cuál es más rápido, vLLM o SGLang-Omni? NVIDIA no publica una comparación directa. Usa vLLM cuando necesites marcas de tiempo, hablantes o traducción, y SGLang-Omni para el servidor más simple solo de texto.
¿Cómo se compara con otros modelos locales? Lidera todos los modelos de pesos abiertos en la Open ASR Leaderboard del 28 de octubre. Nuestra lista de mejores modelos de código abierto de voz a texto lo compara con Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral y Whisper.
Ejecútalo
Descarga el checkpoint que se ajuste a tu GPU, inicia vLLM con el límite de audio de una hora y el middleware de marcas de tiempo, y envía un archivo WAV a través del cliente de OpenAI. Luego deja que tu agente ejecute comprobaciones de Apidog contra el endpoint local para que cada actualización demuestre que todavía transcribe antes de confiarle grabaciones reales.