
Para ejecutar ERNIE 5.5 Flash localmente, instala vLLM 0.32.0 más el plugin vLLM-ERNIE de Baidu, y luego ejecuta vllm serve baidu/ERNIE-5.5-Flash-Base con paralelismo de datos y de expertos en un nodo multi-GPU. Obtienes un servidor compatible con OpenAI en el puerto 8000. La pega: los pesos abiertos actuales corresponden al modelo Base, un checkpoint de preentrenamiento que continúa texto, no un modelo de chat.
A continuación: qué puedes descargar, el hardware que Baidu indica, los comandos exactos de serve y cómo probar el endpoint. Todos los comandos y cifras siguientes provienen de la ficha del modelo en Hugging Face y del repositorio vLLM-ERNIE, verificados el 12 de noviembre de 2026.
¿No conoces el modelo? Empieza por qué es ERNIE 5.5 Flash. Si quieres el modelo de chat sin un clúster de GPUs, la guía de la API de ERNIE 5.5 Flash es la vía más rápida.
¿Qué puedes ejecutar localmente hoy?
Puedes ejecutar ERNIE 5.5 Flash Base, publicado en Hugging Face en FP8 y BF16. Es un modelo disperso de mezcla de expertos de 280B de parámetros con 14B de parámetros activos por token, entrenado con 33.5T de tokens. La versión ajustada para chat, ERNIE 5.5 Flash Preview, está por ahora solo disponible vía API; Baidu dice que sus pesos llegarán "pronto" bajo Apache 2.0.
Así se comparan las dos publicaciones para autoalojamiento:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| Qué es | Checkpoint al final del preentrenamiento | Primer modelo con post-entrenamiento (chat, razonamiento, agente) |
| Pesos | Hugging Face y ModelScope, FP8 y BF16 | No publicados a fecha del 12 de noviembre de 2026 |
| Endpoint que llamas | /v1/completions (continuación de texto) |
Chat completions con razonamiento y herramientas |
| Licencia | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 prometido en el lanzamiento |
| Dónde usarlo ahora | Tus propias GPUs | API de Qianfan, OpenRouter |
Hoy, la colección ERNIE-5.5-Flash de Baidu contiene solo los dos checkpoints Base, y el README de vLLM-ERNIE marca el modelo de chat como "Coming soon". La publicación de lanzamiento del Preview no da ninguna fecha.
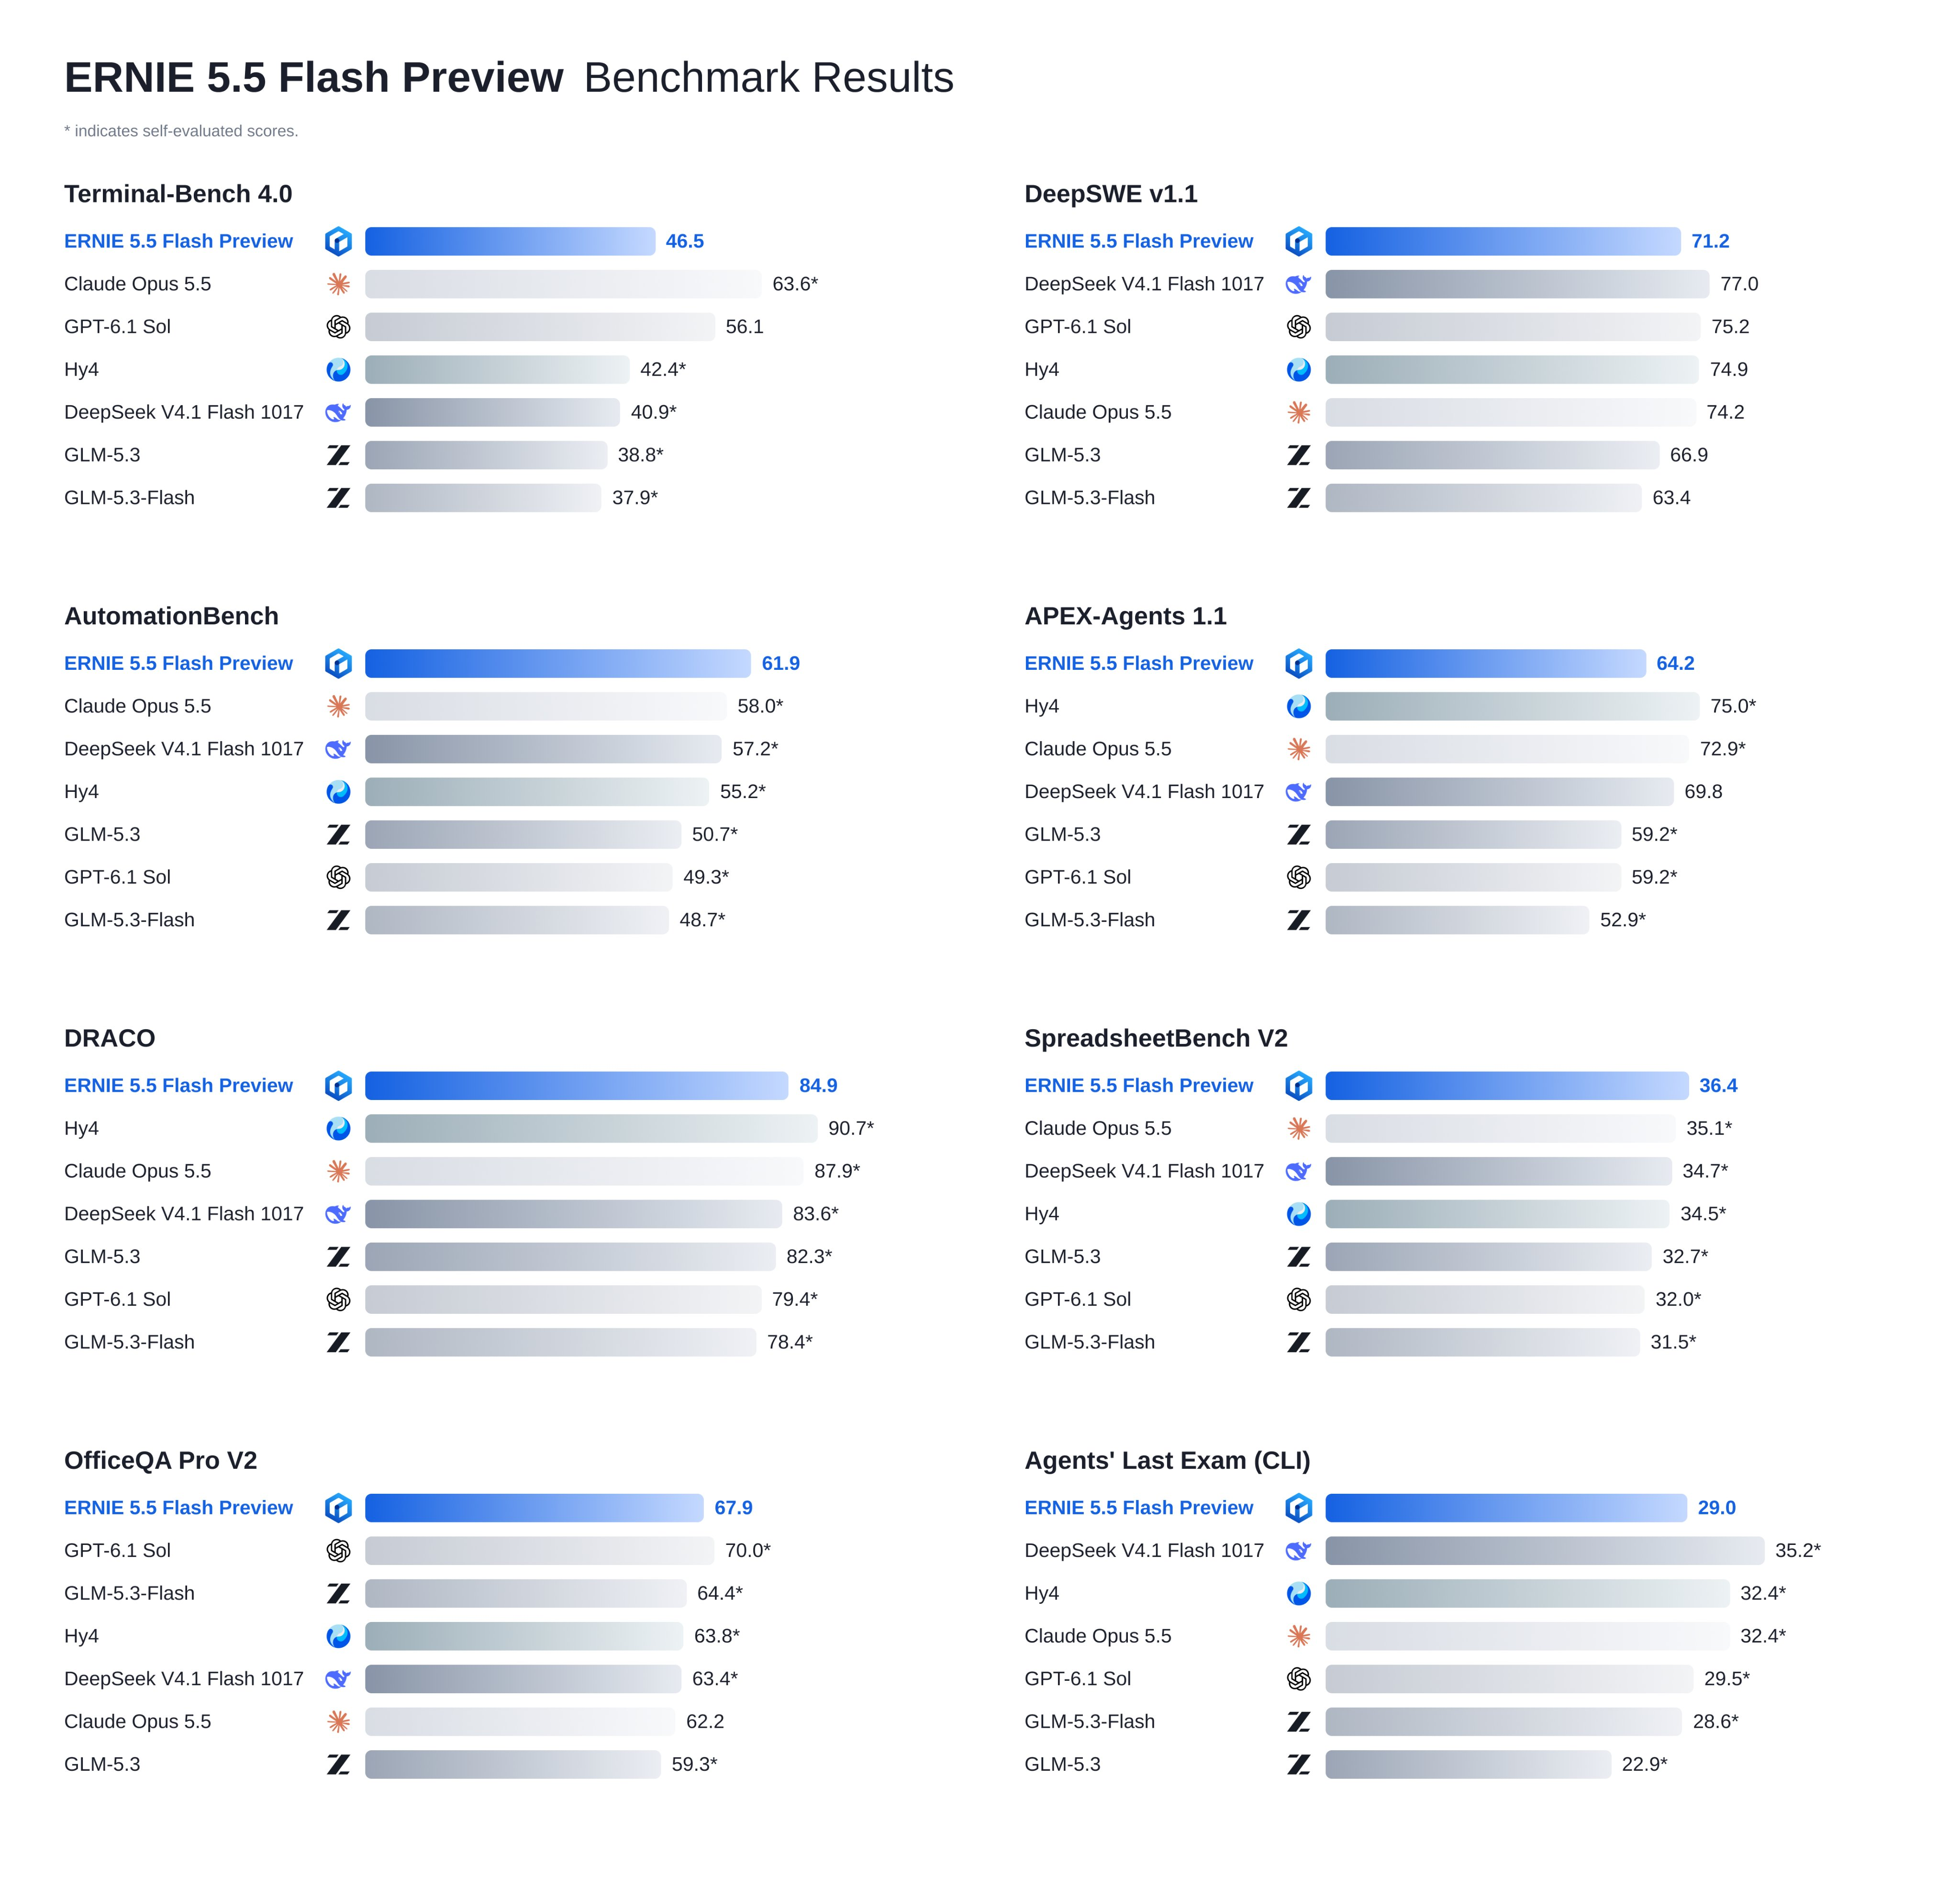
Si quieres un asistente de programación hoy, un modelo Base local no te lo dará. Si buscas un punto de partida para fine-tuning o investigación few-shot, Base es exactamente para lo que Baidu lo creó.
Requisitos de hardware de ERNIE 5.5 Flash
Los pesos FP8 ocupan unos 280 GB de memoria de GPU y los BF16 unos 560 GB, así que esto es trabajo para un servidor multi-GPU, no para un portátil. El README de vLLM-ERNIE indica las cantidades mínimas de GPUs que contienen los pesos, y el plugin solo funciona en GPUs NVIDIA.
| Memoria de GPU por tarjeta | FP8 (~280 GB de pesos) | BF16 (~560 GB de pesos) |
|---|---|---|
| 288 GB | 2 GPUs | 4 GPUs |
| 192 GB | 4 GPUs | 8 GPUs (o 2 nodos x 4 GPUs) |
| 80 GB | 8 GPUs | 2 nodos x 8 GPUs |
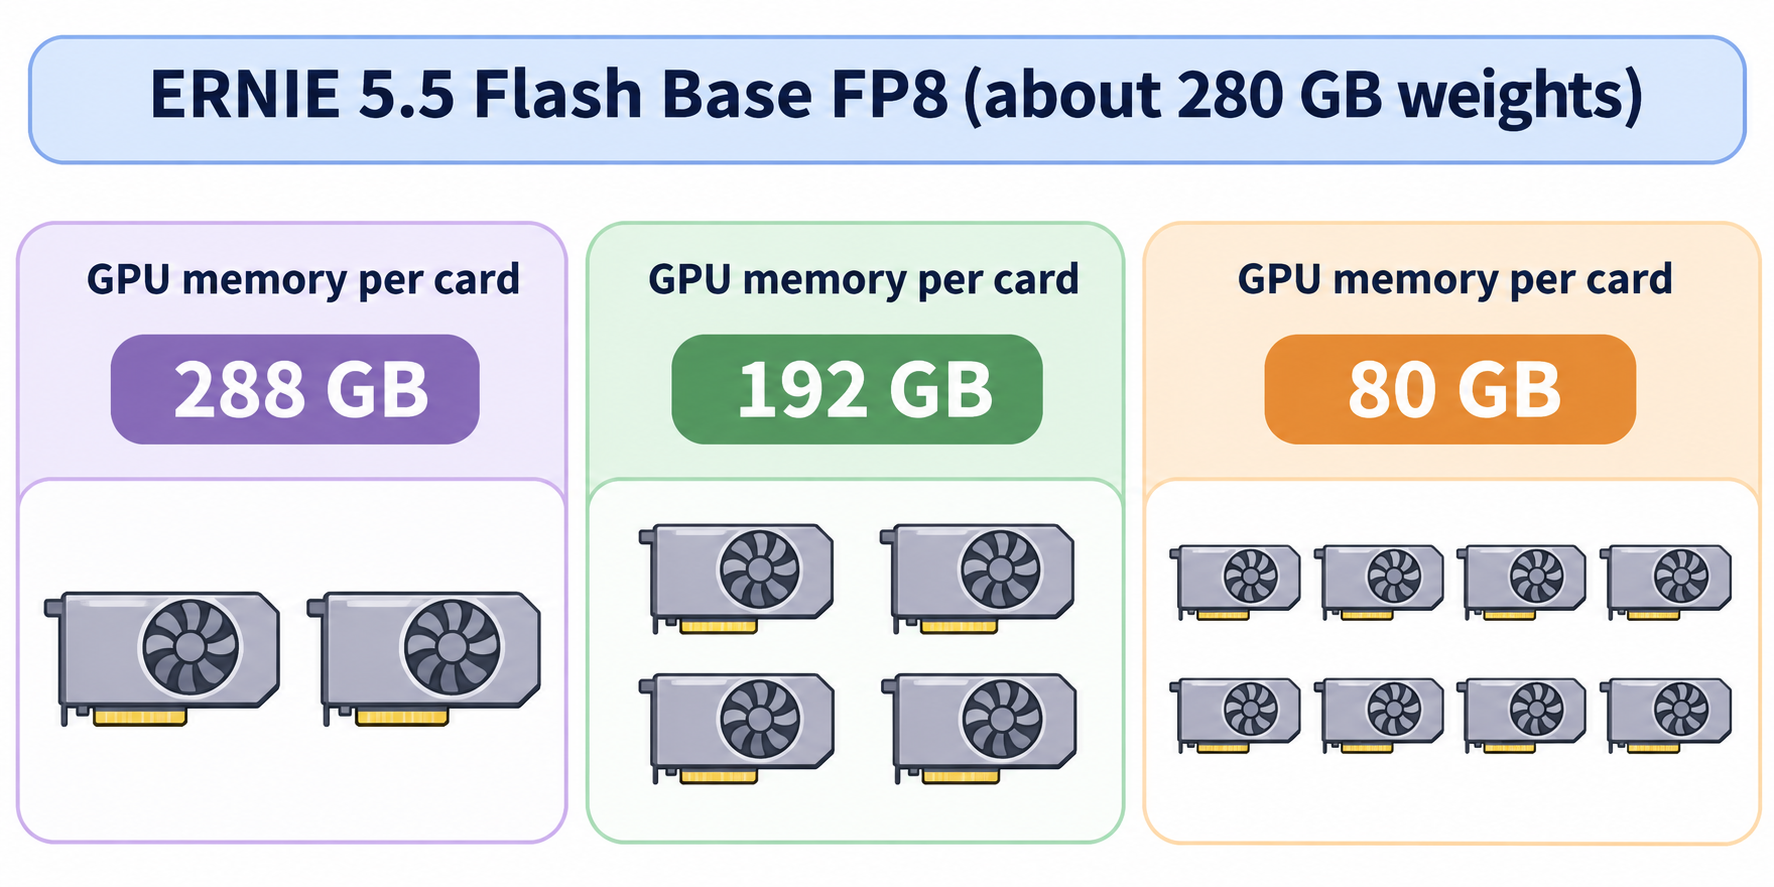
Esos son los mínimos para cargar los pesos. La caché KV necesita espacio adicional, por lo que la longitud de contexto que puedas servir depende de tus tarjetas:
- GPUs de 80 GB: sirve FP8 en 8 GPUs con
--data-parallel-size 8y--gpu-memory-utilization 0.93. Caben hasta 262.144 tokens; 1M no. - Contexto de 1M de tokens: los valores de Baidu son para GPUs con 184 GiB de memoria, con la utilización reducida a 0.85 porque un prefill de 1M de tokens necesita decenas de GB de memoria temporal.
- La arquitectura importa: los comandos FP8 pasan
--moe-backend humming, que soporta la activación SiTU del modelo con pesos FP8 en GPUs Blackwell. En GPUs Hopper, elimina ese flag y conserva el kernel MoE por defecto de vLLM.
"Localmente" significa hardware que tú controlas: un nodo de 8 GPUs alquilado, un servidor on-premise o un clúster de laboratorio.
Instalar vLLM y el plugin de ERNIE
vLLM no soporta la arquitectura de ERNIE 5.5 (Ernie5_5_MoeForCausalLM) de serie. Baidu la distribuye como un plugin que se ejecuta sobre el wheel de vLLM 0.32.0 publicado, sin modificaciones. Crea un entorno Python 3.12 e instala ambos:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
El plugin se carga a través del entry point vllm.general_plugins de vLLM en cada proceso de vLLM. Si más tarde vllm serve dice Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported, es que el plugin no está instalado en el entorno que ejecuta vllm, o VLLM_PLUGINS está configurado sin incluir ernie.
Para descargar los pesos de ModelScope en lugar de Hugging Face, configura VLLM_USE_MODELSCOPE=True. Los nombres de los repositorios son los mismos en ambos hubs. Si no conoces bien vLLM, nuestra introducción a vLLM explica el servidor y su API compatible con OpenAI.
El comando vllm serve para ERNIE 5.5 Flash
Este es el comando FP8 del README de vLLM-ERNIE, para un nodo de 4 GPUs con el contexto de entrenamiento de 128K y el decodificado especulativo ECHO activado:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Qué hace cada elección, según las notas de Baidu:
- Atención con paralelismo de datos más MoE con paralelismo de expertos (
--data-parallel-size 4 --enable-expert-parallel) retiene la mayor cantidad de caché KV y ofrece el mayor rendimiento. El paralelismo de tensores (--tensor-parallel-size2, 4 u 8) reduce la latencia con baja concurrencia pero retiene menos caché KV. - Caché KV en FP8 (
--kv-cache-dtype fp8) almacena la caché en FP8;autola mantiene en BF16. - Decodificado especulativo ECHO reutiliza la propia última capa del modelo como draft incorporado. Aquí redacta 2 pasos; 1 o 3 también funcionan. Elimina
--speculative-configpara servir sin draft.
La ficha del modelo muestra una variante más corta en el puerto 30000 sin la configuración especulativa.
Asegúralo. Estos comandos escuchan en 0.0.0.0 sin autenticación. El README de Baidu recomienda añadir --api-key <key> o escuchar en 127.0.0.1 a menos que la red sea de confianza. Haz una de las dos cosas antes de exponer el puerto.
BF16 y contexto de 1M
BF16 se ejecuta en dos nodos de 4 GPUs (DP8 más EP8) con --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} y --data-parallel-hybrid-lb; el segundo nodo añade --data-parallel-start-rank 4. Copia el comando completo del README; también configura la interfaz de red entre nodos.
Para la ventana completa de 1.048.576 tokens, pasa --max-model-len 1048576 y --gpu-memory-utilization 0.85, y reduce --max-num-seqs para que la caché KV de cada rank contenga solicitudes completas de 1M de tokens.
Llamar al endpoint compatible con OpenAI
vLLM expone rutas al estilo de OpenAI, pero un modelo base no tiene plantilla de chat, así que debes llamar a /v1/completions con un prompt en texto plano. Para uso few-shot, pon los ejemplos en el prompt y corta al final de una respuesta:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
El README de Baidu indica que el texto de la completación devuelve 36. Tres detalles hacen tropezar a la gente:
- Pasa
"temperature": 0para decodificado greedy. Elgeneration_config.jsondel modelo definedo_sample=false,temperature=1.0ytop_p=0.95. vLLM aplica la temperatura y el top_p pero ignorado_sample, así que tomará muestras a menos que lo sobrescribas. - No añadas
<|ERNIE_MASK|>tú mismo. El tokenizador lo antepone (token id 2) a los prompts de completación. - Usa el nombre correcto del modelo. Emplea
baidu/ERNIE-5.5-Flash-Base-BF16cuando sirvas los pesos BF16.
Cualquier SDK de OpenAI funciona si apuntas base_url a http://<host>:8000/v1 y llamas a completaciones, no a chat completions.
Base vs Preview: ¿cuál deberías usar?
Usa Base si planeas entrenar sobre él; usa Preview si necesitas un asistente funcional ahora. Base te da control total y datos que nunca salen de tus servidores. Preview te ofrece chat, razonamiento y llamada de herramientas, pero solo a través de Qianfan u OpenRouter.
Cuando lleguen los pesos del Preview, el plugin ya estará preparado para ellos. El README documenta los flags adicionales, marcados como "Coming soon": --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, además de un modelo draft DSpark para el decodificado especulativo. El razonamiento aparecerá en reasoning_content y las llamadas a herramientas en message.tool_calls, de modo que el mismo servidor que construyas hoy se convertirá en un backend de chat con un simple cambio de pesos y tres flags.
La licencia es la otra diferencia. Base se distribuye bajo el ERNIE 5.5 Flash Base Model License Agreement v1.0, no bajo Apache 2.0. Lee la licencia completa antes de construir un producto sobre él. El 12 de noviembre de 2026 decía:
- El uso no comercial es gratuito, sin necesidad de notificación previa.
- El uso comercial donde el producto relacionado genere hasta 50 millones de dólares al año está libre de cargos de licencia, pero debes mostrar "Powered by ERNIE" y enviar a Baidu una notificación única.
- Por encima de los 50 millones de dólares al año, necesitas primero la autorización escrita por separado de Baidu.
- El "Territorio" de la licencia excluye la Unión Europea, el Reino Unido y Corea del Sur.
Para un modelo de pesos abiertos más pequeño que puedas autoalojar con menos GPUs, consulta nuestra guía de autoalojamiento de GLM-5.3.
Deja que tu agente de programación pruebe el endpoint con Apidog CLI
Un despliegue nuevo de vLLM necesita una prueba de humo que puedas repetir tras cada cambio de flags: estado, esquema de respuesta y tokens por segundo. Encarga esa tarea a tu agente de programación y a Apidog CLI en lugar de reescribir curl a mano.
Configura la CLI una sola vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a Claude Code, Codex o Cursor un único prompt:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
El agente lee el esquema del payload, lo valida, crea el caso y lo ejecuta:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
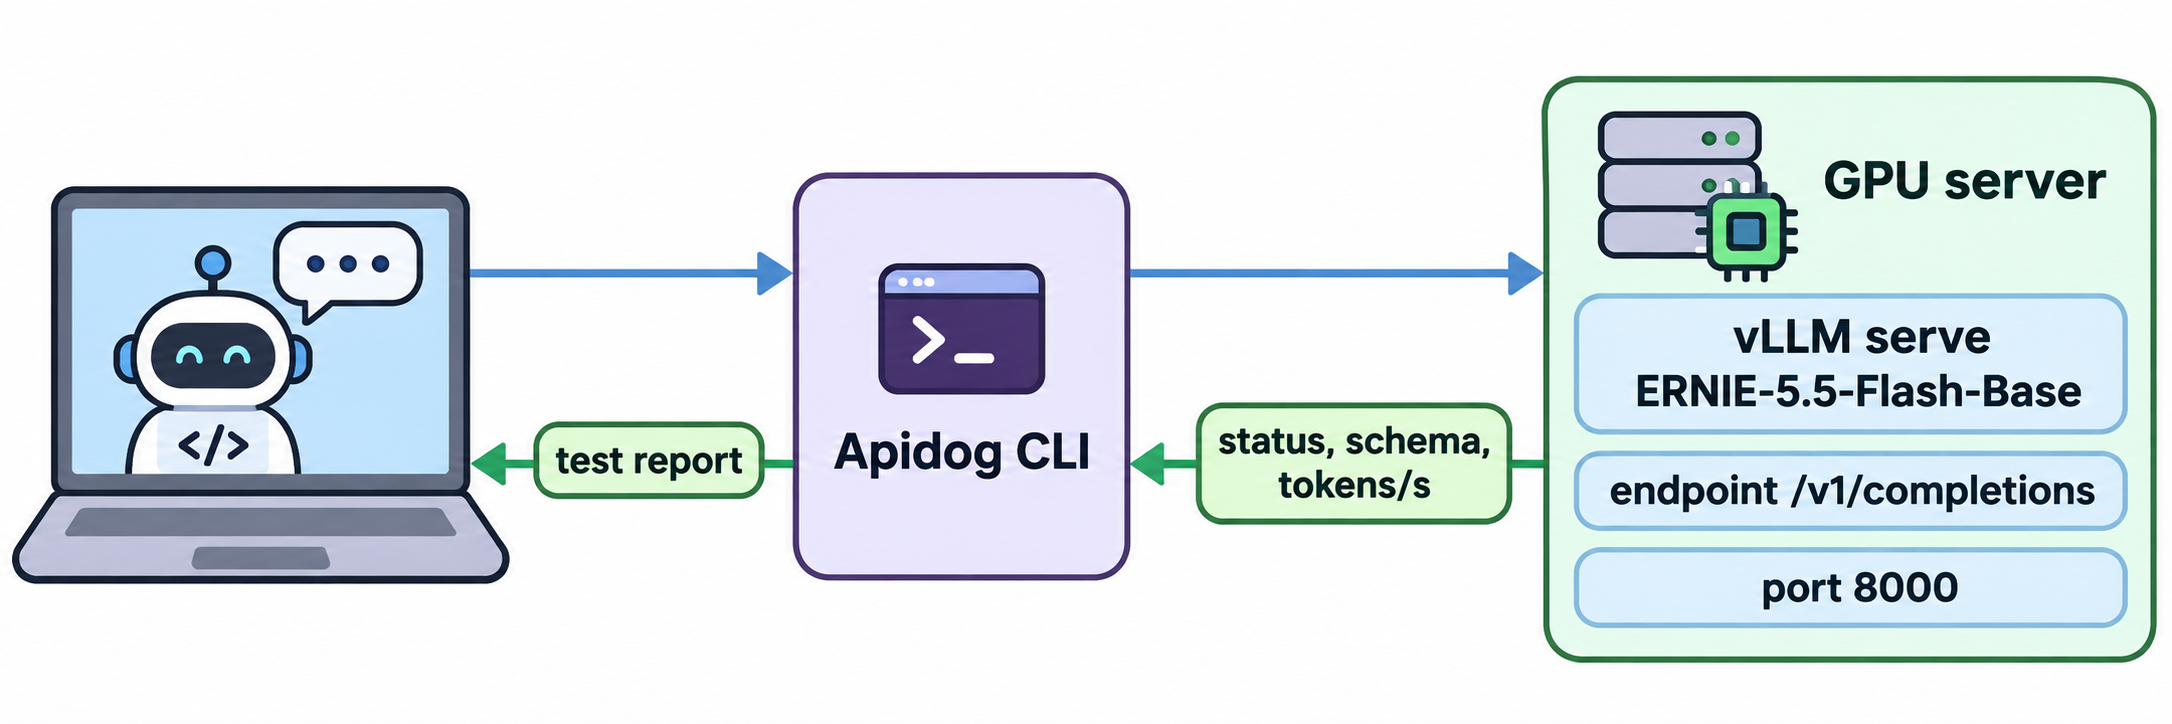
Ejecuta la CLI desde una máquina que pueda alcanzar el puerto 8000. Si configuraste --api-key en el servidor, pide al agente que la almacene como variable de entorno y la envíe como token Bearer. Repite el mismo caso después de cambiar --tensor-parallel-size, desactivar el decodificado especulativo o aumentar --max-model-len, y obtendrás una comparación equivalente. Añade -r junit y la misma ejecución se integra en CI. Para la configuración del agente paso a paso, consulta Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios.
FAQ
¿Puedo ejecutar ERNIE 5.5 Flash en una sola GPU de consumo? No. Los pesos FP8 ocupan unos 280 GB, y la configuración más pequeña que indica Baidu es de 2 GPUs con 288 GB cada una. Con tarjetas de 80 GB necesitas 8. Usa el Preview a través de la API si no tienes ese hardware.
¿Están disponibles los pesos de ERNIE 5.5 Flash Preview? No, a fecha del 12 de noviembre de 2026. Baidu dice que los abrirá bajo Apache 2.0 pronto, y el plugin vLLM-ERNIE lista el modelo de chat como "Coming soon". Solo los pesos Base (FP8 y BF16) están en Hugging Face.
¿Por qué falla /v1/chat/completions con el modelo Base? Base no tiene entrenamiento de chat ni plantilla de chat. Baidu lo sirve a través de /v1/completions con un prompt de texto plano. Pon ejemplos few-shot en el prompt y usa una secuencia de parada.
¿Soporta vLLM ERNIE 5.5 de forma nativa? No en el núcleo de vLLM. Necesitas el plugin vLLM-ERNIE de Baidu sobre vLLM 0.32.0. Funciona solo en GPUs NVIDIA. SGLang también sirve el modelo mediante una imagen de Docker específica nombrada en la ficha del modelo.
¿Puedo usar ERNIE 5.5 Flash Base comercialmente? Sí, bajo condiciones. Los productos que generen hasta 50 millones de dólares al año pueden usarlo sin cargos de licencia, con la atribución "Powered by ERNIE" y una notificación única a Baidu. Por encima de eso necesitas autorización escrita, y el territorio de la licencia excluye la UE, el Reino Unido y Corea del Sur.