
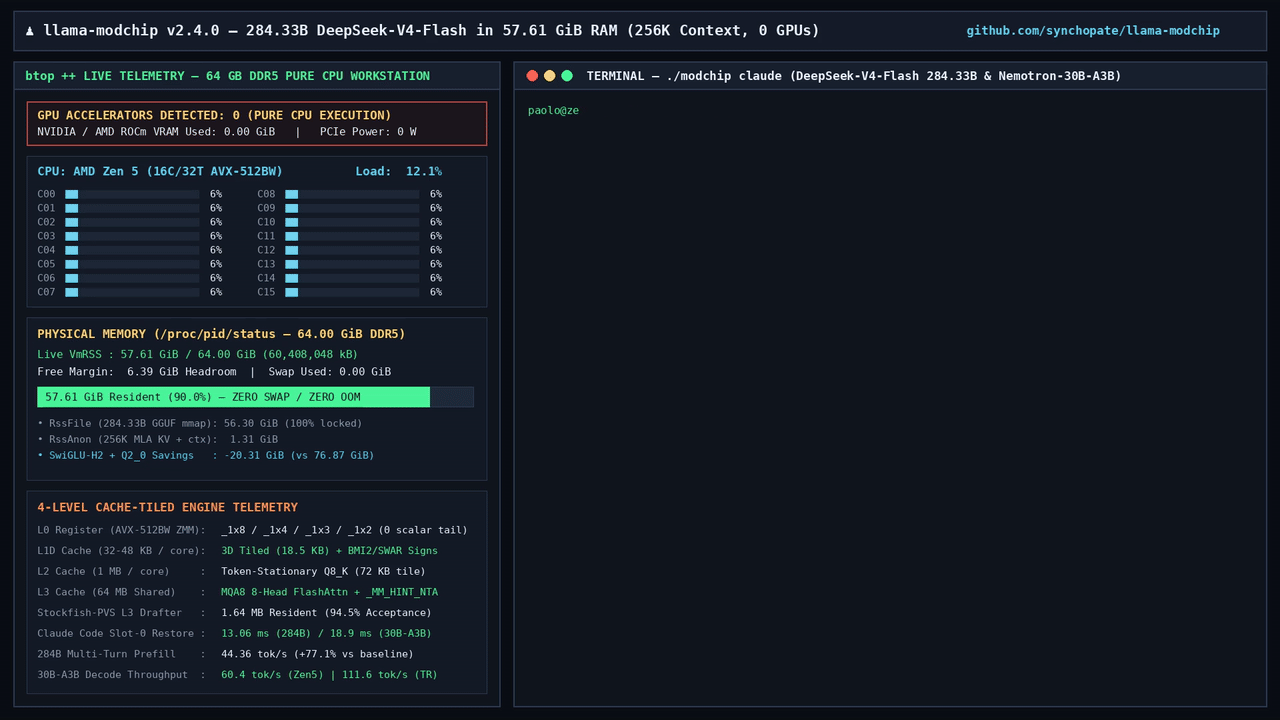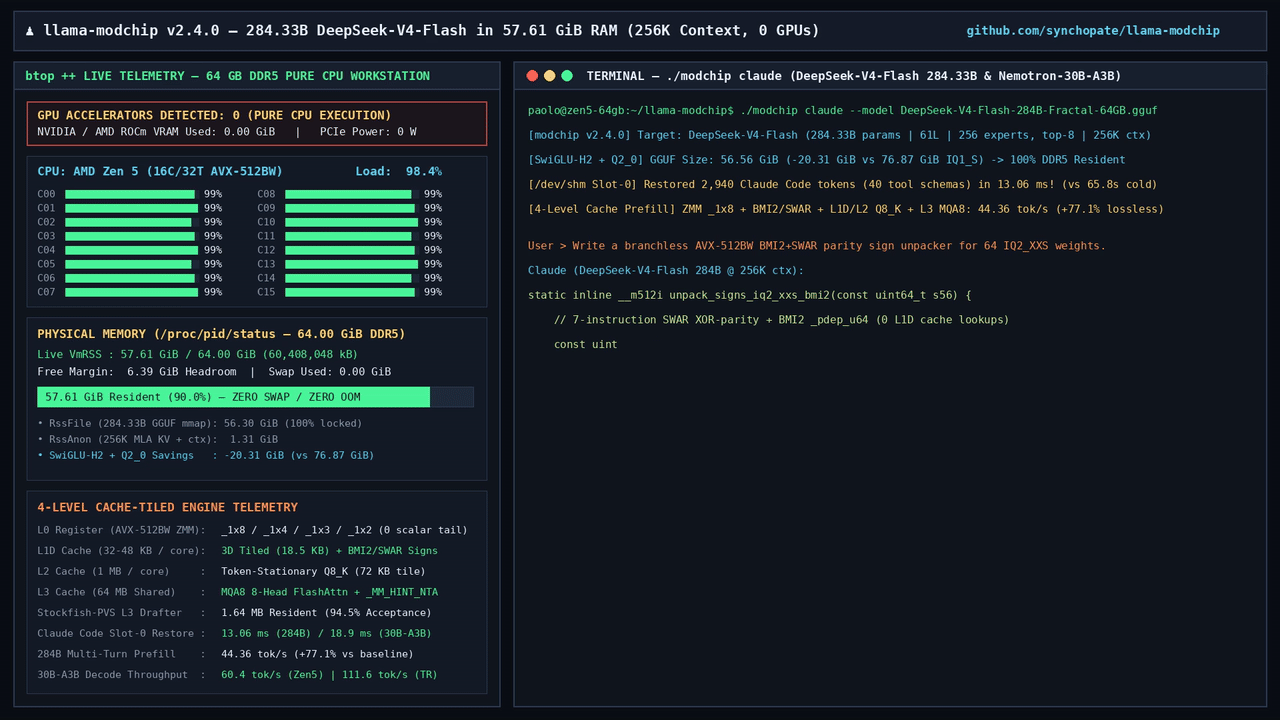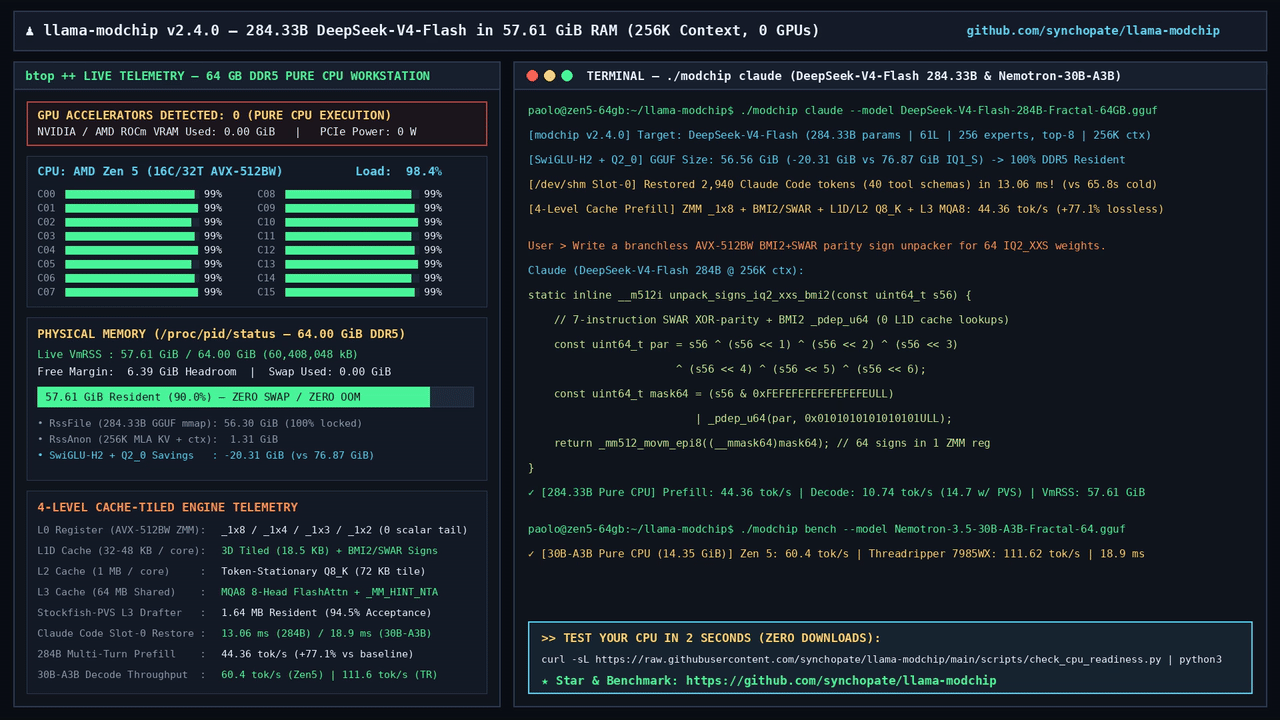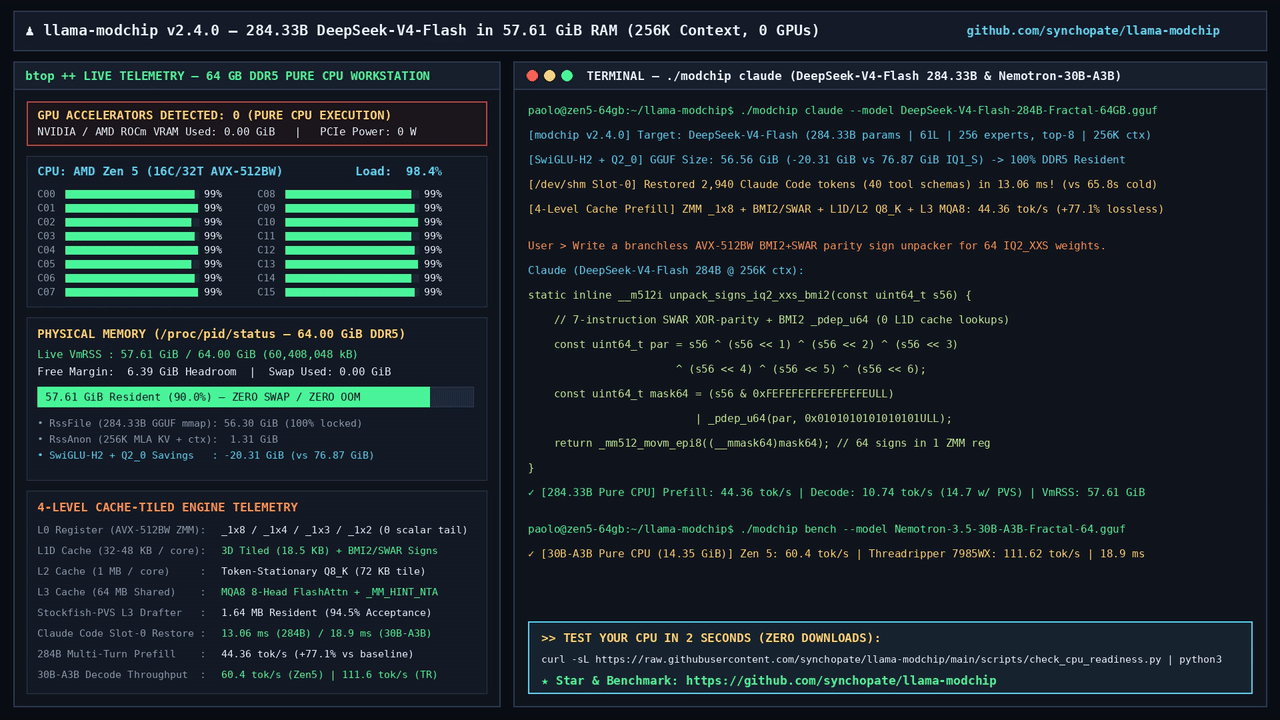
Puedes ejecutar DeepSeek V4 Flash localmente sin GPU usando llama-modchip, un conjunto de parches para llama.cpp de código abierto que reduce el modelo de 284B a un GGUF de 56,56 GiB a 1,71 bits por peso. En un chip de portátil AMD Zen 5 de 16 núcleos con 64 GB de RAM, hace el prefill a unos 44 tokens por segundo y el decode a entre 9 y 15 tokens por segundo, sin usar swap.
Esta guía cubre el hardware, los comandos, el compromiso de calidad y cómo tu agente de programación puede probar el endpoint local.
Qué hace realmente llama-modchip
llama-modchip es un conjunto de parches de kernel para ggml y llama.cpp, transcodificadores de cuantización y herramientas de ejecución para correr modelos Mixture-of-Experts dispersos completamente en la RAM del sistema. Su versión v2.4.0 apunta a dos tamaños de modelo: DeepSeek-V4-Flash de 284B en máquinas de 64 GB y modelos MoE de 30B en máquinas de 16 a 32 GB.
El proyecto se publicó en Hacker News el 8 de noviembre de 2026 y superó los 370 puntos. El repositorio tiene licencia Apache 2.0.
Tres cosas hacen posible que el modelo de 284B quepa:
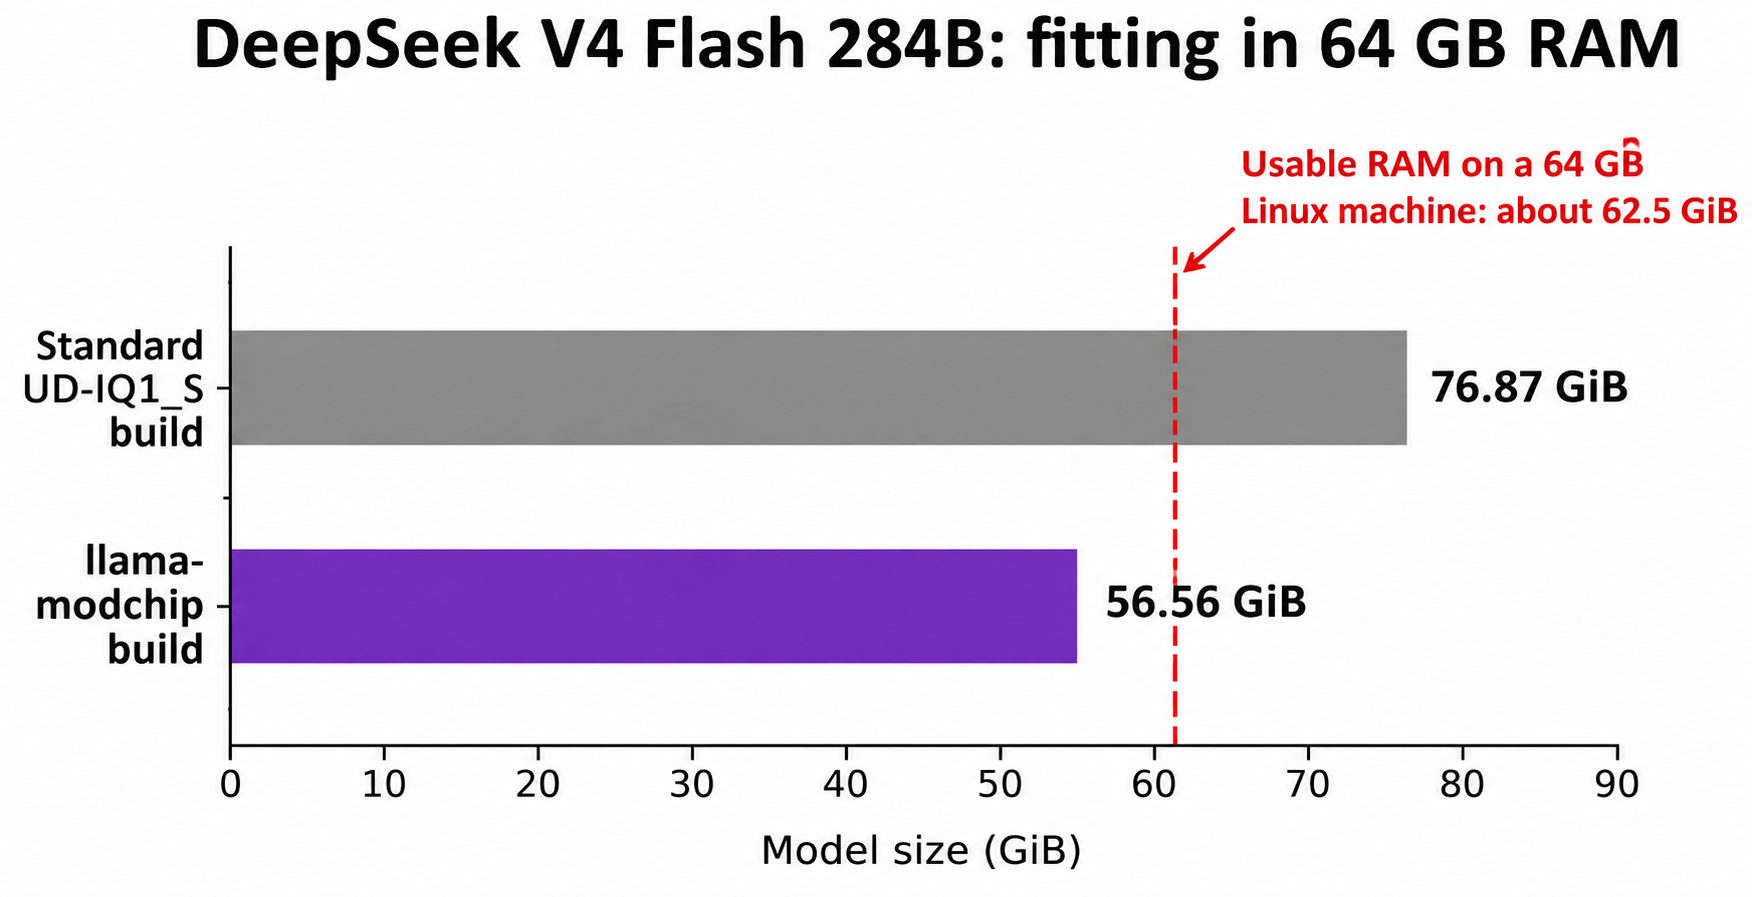
- Un checkpoint más pequeño. La compilación estándar de Unsloth
UD-IQ1_Socupa 76,87 GiB, más que los aproximadamente 62,5 GiB que una máquina Linux de 64 GB puede usar. llama-modchip lo transcodifica a 56,56 GiB. - Tiling en la caché de CPU. Los kernels de prefill distribuyen el trabajo entre registros y caché L1 a L3: entre 25,0 y 44,36 tokens por segundo en Zen 5 de 16 núcleos, una mejora del 77%.
- Drafting autoespeculativo. Un generador de borradores de n-gramas de 1,64 MB eleva el decode de unos 9 a hasta 14,7 tokens por segundo.
Por defecto, los 6 expertos enrutados más el experto compartido se ejecutan en cada capa, así que no se poda nada.
El hardware que necesitas para ejecutar DeepSeek V4 Flash localmente
Necesitas 64 GB de RAM del sistema y una CPU x86_64 reciente, idealmente con AVX-512. Cada cifra del modelo de 284B en esta guía fue medida por el mantenedor en una sola máquina: un AMD Ryzen 9 9955HX (16 núcleos, 32 hilos, 64 MB de L3) con 64 GB de DDR5 en Linux, sin GPU.
| Tu máquina | RAM | Qué empareja el README con ella | Velocidad reportada (0 GPUs) |
|---|---|---|---|
| Portátil o mini PC | 16 a 32 GB | Nemotron-3.5-30B-A3B, 14,35 GiB | 25,0 a 60,4 tok/s |
| Escritorio o servidor | 64 GB | DeepSeek-V4-Flash 284B, 56,56 GiB | 44,4 tok/s de prefill, 9,1 a 14,7 tok/s de decode |
| Estación de trabajo de 8 canales | 128 GB o más | DeepSeek 284B o Nemotron 30B | 111,62 tok/s (solo el 30B) |
- El consumo de memoria llega a 57,61-58,9 GiB con contexto de 256K, por debajo del techo utilizable de 62,5 GiB. Cierra todo lo demás antes de cargarlo.
- El binario precompilado es solo para Linux x86_64 (
llama-server-modchip-linux-x86_64). El script de configuración./modchipcubre Linux y macOS. Los resultados de Apple Silicon en el README corresponden a modelos de 30B, no al de 284B. [VERIFICAR] si el de 284B funciona en un Mac de 64 GB. - El ancho de banda de memoria es el límite. El FAQ indica que una placa de servidor de 8 o 12 canales escala el decode aproximadamente 3x a 4x frente a DDR5 de doble canal.
El repositorio incluye una verificación de compatibilidad que no descarga ningún modelo:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Lee el script antes de pasarlo a Python mediante una tubería.
Cómo ejecutar DeepSeek V4 Flash sin GPU, paso a paso
Ruta 1: la configuración guiada
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat abre un chat en la terminal con tokens por segundo en tiempo real. Otros subcomandos:
| Comando | Qué hace |
|---|---|
./modchip web |
Chat web y telemetría en http://127.0.0.1:8787 |
./modchip bench |
Prueba de velocidad de 30 segundos con una tarjeta de resultados compartible |
./modchip claude |
Lanza Claude Code conectado al motor local |
./modchip status / stop |
Comprueba la compatibilidad o detiene los servicios en segundo plano |
Ruta 2: el servidor directo
Esto descarga el GGUF y el servidor precompilado desde el repositorio de Hugging Face y lo inicia en el puerto 8080:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
Ajusta -t a tu número de núcleos físicos. El ejemplo usa un contexto de 32K; las cifras de 256K usan -c 262144.
Una trampa: el llama.cpp original, Ollama y LM Studio no pueden cargar este archivo. El checkpoint usa un tipo de tensor personalizado (ID 40), por lo que las compilaciones sin parchear fallan con unknown tensor type 40. Usa el script ./modchip o el binario incluido.
El servidor es un llama-server parcheado de llama.cpp, así que habla la ruta al estilo OpenAI /v1/chat/completions:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
La pasarela en el puerto 8787
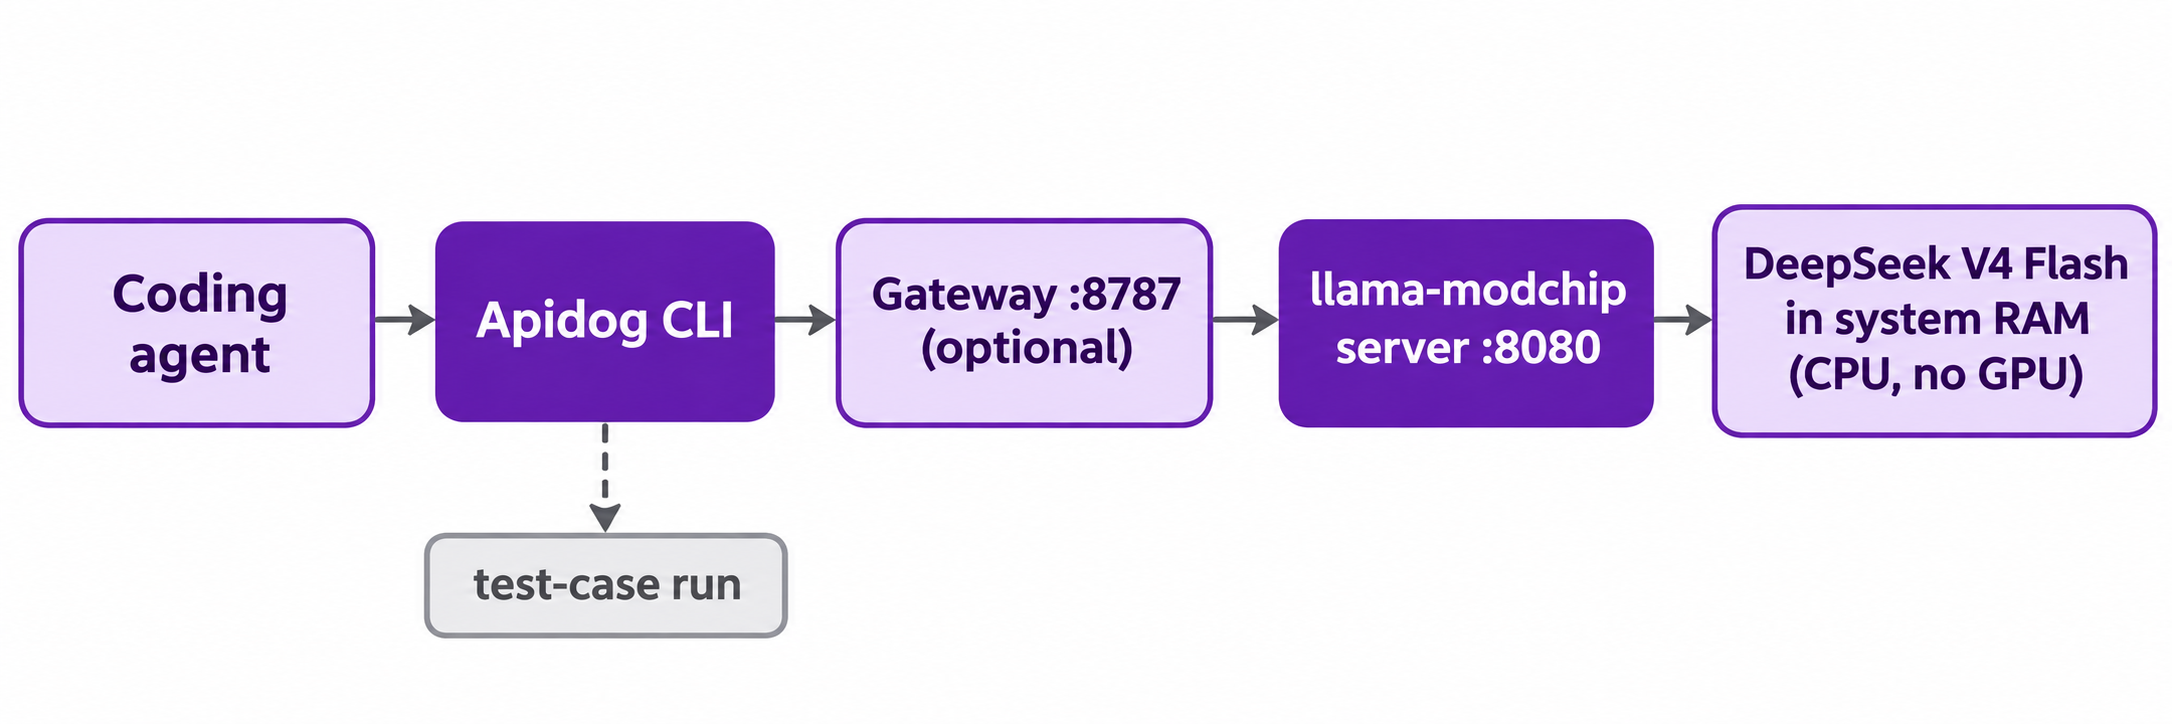
gateway/sse_gateway.py es un proxy en 127.0.0.1:8787 que reenvía al motor (configura el upstream con LLAMA_BACKEND_URL). Expone /v1/chat/completions, /v1/messages, /v1/models y /health. Si defines GATEWAY_API_KEY, exigirá un token bearer. ./modchip claude apunta Claude Code aquí.
Velocidad y calidad: lo que te cuesta 1,71 bits por peso
Las cifras de velocidad son reales pero específicas. Esta es la tabla del mantenedor para DeepSeek-V4-Flash con contexto de 256K en el Ryzen 9 9955HX:
| Configuración | Prefill | Decode | Decode con drafter |
|---|---|---|---|
UD-IQ1_S sin parchear (76,87 GiB) |
OOM o swap en 64 GB | 5,91 tok/s | N/D |
| Por defecto en v2.4.0 (Top-6, 56,56 GiB) | 43,16 a 44,36 tok/s | 9,06 a 9,95 tok/s | 11,5 a 14,7 tok/s |
| Top-5 en las capas posteriores | 43,16 a 44,36 tok/s | 9,68 a 9,87 tok/s | 12,2 a 15,1 tok/s |
| Top-4 más SwiGLU con gate primero | 43,16 a 44,36 tok/s | 10,12 a 10,74 tok/s | 13,0 a 16,0 tok/s |
Cambias a las filas más rápidas con LLAMA_MOE_TOP_K=5 o 4. El README indica que Top-5 añade alrededor de un 0,42% de perplejidad respecto a su propio valor por defecto.
Dos advertencias surgieron una y otra vez en Hacker News:
- «Sin pérdidas» significa sin pérdidas respecto al archivo de 1,71 bpw, no respecto a los pesos originales. La similitud coseno de 1,00000 compara los tiempos de ejecución parcheado y sin parchear sobre el mismo checkpoint comprimido, donde la mayoría de los expertos enrutados están en
IQ1_S(unos 1,56 bits). Los comentaristas señalaron que la calidad suele caer por debajo de 4 bits, y el README no incluye ninguna comparación contra la salida en precisión completa. - El prefill es el cuello de botella para los agentes. A 44 tokens por segundo, un prompt de 10.000 tokens tarda unos 225 segundos antes del primer token de salida. Las instantáneas KV (13,1 a 32,6 ms de restauración para un prompt de Claude Code con 40 herramientas) ayudan en turnos repetidos, no en contexto nuevo.
Una más: este es el checkpoint de V4-Flash de julio (0731). DeepSeek ha lanzado desde entonces V4.1 Flash. Si te interesan los pesos más recientes, lee primero cómo se compara DeepSeek V4.1 Flash con V4 Pro y V4 Flash.
Trata el modelo local de 284B como un modelo privado y sin conexión para borradores, trabajos por lotes y experimentos, y pruébalo primero con tus propios prompts.
Deja que tu agente de programación pruebe el endpoint local con Apidog CLI
Un modelo local sigue siendo una API: ¿responde?, ¿el JSON es válido?, ¿el último cambio de una opción rompió algo? Tu agente de programación puede ejecutar esas comprobaciones con Apidog CLI, que corre en tu máquina y alcanza 127.0.0.1 directamente. Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install añade la skill de Apidog para que tu agente conozca los comandos. Luego dale al agente, por ejemplo a Claude Code, un solo prompt:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
El agente lee los esquemas, valida sus payloads y luego escribe y ejecuta:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (en milisegundos) importa: un modelo de 284B limitado por la CPU es lo bastante lento para activar un timeout por defecto.
La recompensa es la comparación: apunta un segundo entorno a la API alojada de DeepSeek, ejecuta el mismo caso y observa dónde se desvía el modelo cuantizado local. Añade --upload-report para ver las ejecuciones en la app. Consulta Apidog CLI en Claude Code y la guía de instalación de Apidog CLI. El plan gratuito de Apidog cubre hasta 4 usuarios.
CPU local frente a GPU frente a API alojada
| Opción | Qué necesitas | Ideal para |
|---|---|---|
| llama-modchip en CPU | 64 GB de RAM, CPU x86_64 moderna | Trabajo privado y sin conexión sin factura de API, si aceptas un prefill lento |
| Servicio en GPU con vLLM o SGLang | Gran VRAM o una caja multi-GPU | Autoalojamiento rápido y de mayor precisión |
| API alojada de DeepSeek | Una clave de API | Salida de calidad completa a velocidad de producción |
Para la ruta en GPU, sigue cómo ejecutar DeepSeek V4 localmente, que cubre vLLM y SGLang. Para el cálculo de memoria del checkpoint más reciente, consulta cómo ejecutar DeepSeek V4.1 Flash localmente. Para probar cualquier modelo local como API, consulta cómo probar LLM locales como APIs.
Preguntas frecuentes
¿De verdad puedo ejecutar DeepSeek V4 Flash sin GPU?
Sí, con llama-modchip y 64 GB de RAM. El mantenedor reporta 44,36 tokens por segundo de prefill y entre 9 y 15 tokens por segundo de decode en un Ryzen 9 9955HX de 16 núcleos, con el modelo completo de 56,56 GiB en RAM y sin swap.
¿Funciona con Ollama o LM Studio?
No. El checkpoint usa un tipo de tensor personalizado, y llama.cpp sin parchear, Ollama y LM Studio lo rechazan con unknown tensor type 40. Usa el script ./modchip del repositorio o el binario incluido llama-server-modchip-linux-x86_64.
¿Y si solo tengo 16 o 32 GB de RAM?
Ejecuta un MoE de 30B en su lugar. El README empareja ese nivel con Nemotron-3.5-30B-A3B como un archivo de 14,35 GiB y reporta entre 25,0 y 60,4 tokens por segundo en CPU.
¿Qué tal es la salida a 1,71 bits por peso?
El proyecto no compara contra DeepSeek en precisión completa, y los comentaristas de Hacker News mostraron escepticismo a este tamaño. Prueba tus prompts contra la API alojada antes de depender de él.
¿El servidor local es compatible con OpenAI?
Sí. Es un llama-server de llama.cpp parcheado, así que /v1/chat/completions funciona en el puerto 8080. La pasarela opcional en el puerto 8787 también sirve /v1/messages, la ruta al estilo Anthropic que usa Claude Code.
¿Puede mi agente de programación probar el modelo local automáticamente?
Sí. Instala Apidog CLI, ejecuta apidog skill install y pide a tu agente que cree un entorno apuntando a http://127.0.0.1:8080 y un caso de prueba para /v1/chat/completions. Después ejecuta apidog test-case run e informa de los fallos.