
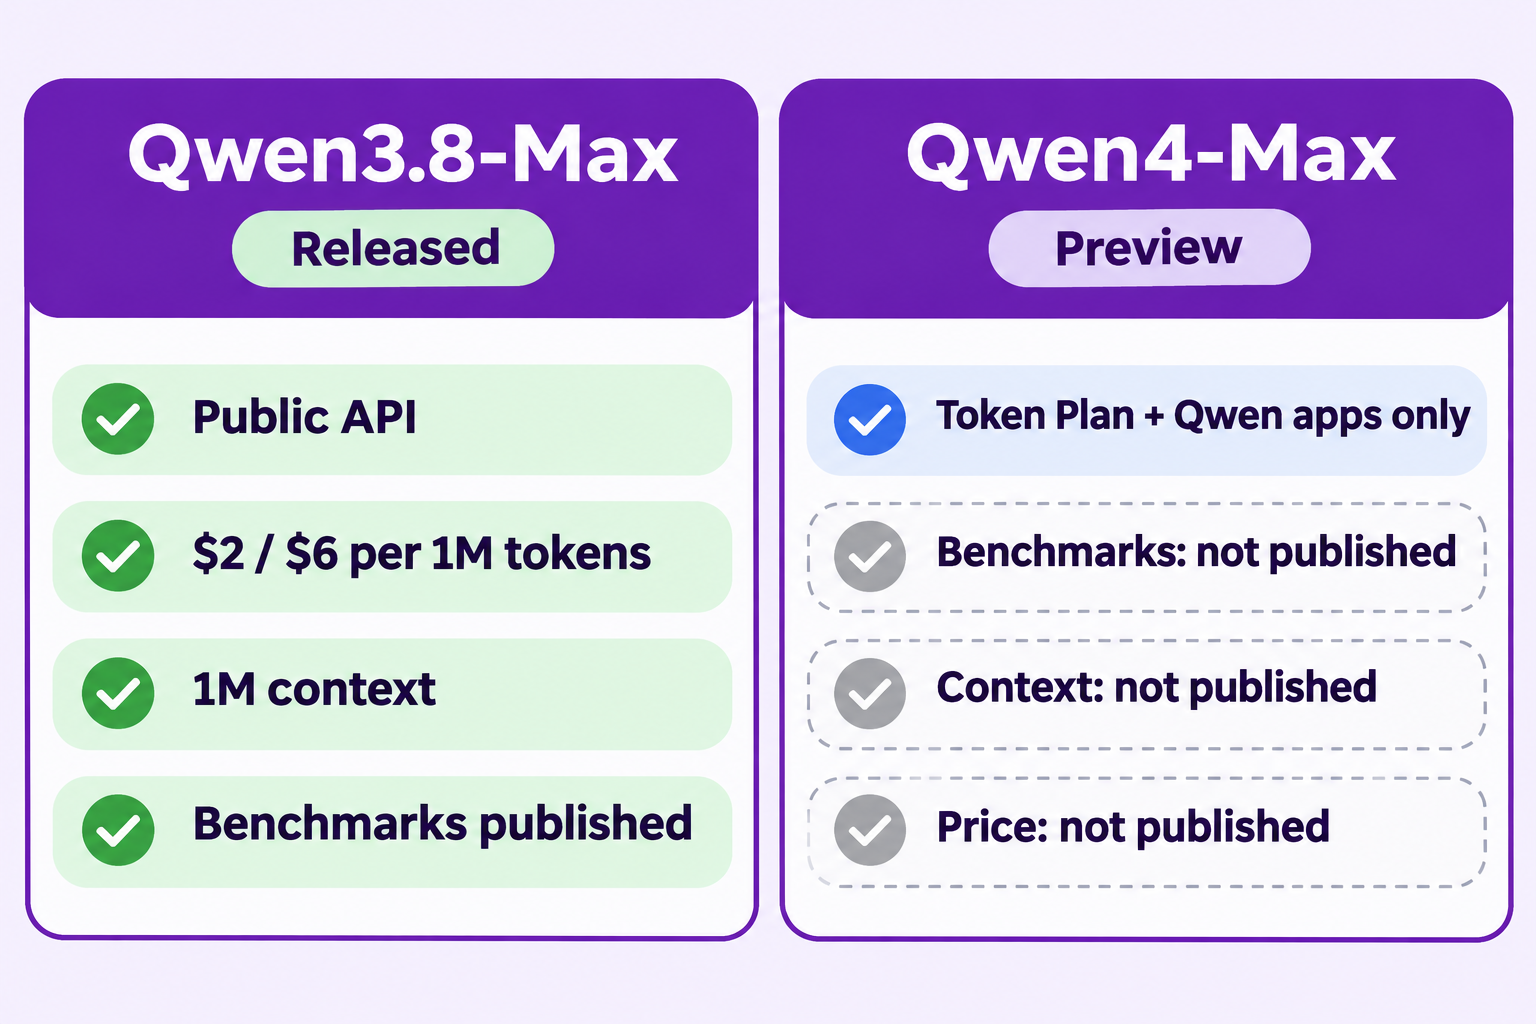
Qwen4-Max frente a Qwen 3.8 se resume así: Qwen4-Max es una vista previa que solo puedes usar a través del Token Plan de Alibaba y sus propias aplicaciones, sin benchmarks, longitud de contexto ni precio por token publicados. Qwen3.8-Max es un modelo lanzado con una API pública a 2 $/6 $ por millón de tokens, un contexto de 1M de tokens y un límite de salida de 131K. Elige Qwen 3.8 para producción. Prueba Qwen4-Max en tu propio trabajo.
Ese es el panorama al 11 de noviembre de 2026, el día que el equipo de Qwen de Alibaba puso Qwen4-Max en vista previa. A continuación: qué hay de nuevo, qué puedes verificar, qué aún no puedes y una prueba práctica. ¿Eres nuevo en alguno de los dos modelos? Empieza con qué es Qwen4-Max y qué es Qwen 3.8.
Qwen4-Max vs Qwen 3.8 de un vistazo
Cada fila proviene de las páginas propias de Alibaba, verificadas el 11 de noviembre de 2026.
| Qwen4-Max (vista previa) | Qwen3.8-Max | |
|---|---|---|
| Estado | Vista previa, anunciado el 11 de noviembre de 2026 | Lanzado, disponible con carácter general desde agosto de 2026 |
| ID del modelo | qwen4-max-preview (Token Plan) |
qwen3.8-max |
| API de pago por token | No publicada | Sí, compatible con OpenAI y Anthropic |
| Precio por token | No publicado | 2 $ entrada / 6 $ salida por cada 1M de tokens |
| Ventana de contexto | No publicada | 1M de tokens |
| Salida máxima | No publicada (valor por defecto de Qwen Code: 32 768) | 131K de tokens |
| Entradas | Texto e imágenes (etiquetas del Token Plan) | Texto, imágenes y vídeo |
| Parámetros | No publicados | 2,4 T en total, Mixture-of-Experts |
| Benchmarks oficiales | Ninguno | Tabla del proveedor publicada en el lanzamiento |
| En el Token Plan | Sí, «80 % de descuento por tiempo limitado» | Sí, «40 % de descuento nocturno» |
Fuentes: la página del modelo Qwen3.8-Max y la página de precios del Token Plan. Qwen4-Max aún no tiene página de modelo; su URL devolvía un 404 cuando la comprobamos.
Lo que Alibaba dice que cambió en Qwen4-Max
El anuncio en X abre con «Qwen4 is coming» y enumera cuatro mejoras. Estas son las afirmaciones del equipo de Qwen, no resultados medidos:
- Conocimiento más profundo. Mejores respuestas en temas especializados.
- Comprensión del mundo más rica. Mejor razonamiento sobre contextos del mundo real.
- Mayores capacidades de codificación y de agentes. Mejor planificación, uso de herramientas y trabajo en varios pasos.
- Diseñado para tareas del mundo real. La publicación menciona «codificación compleja y trabajo con conocimiento», «construcciones de front-end» y «flujos de trabajo de software profesional».
Fíjate en lo cerca que está esto de la propia propuesta de Qwen 3.8. La página del modelo Qwen3.8-Max ya describe «un salto integral en codificación y trabajo profesional» y proyectos autónomos que «abarcan más de 10 días». La dirección no ha cambiado; Qwen4-Max afirma ir más lejos por el mismo camino. La publicación cierra con «Pónlo a prueba en un problema real», lo cual es justo, porque todavía no existe ninguna hoja de especificaciones.
Lo que puedes comparar hoy
Cinco diferencias son verificables hoy.
1. Etapa de lanzamiento. Qwen3.8-Max es un modelo lanzado con límites de velocidad documentados (2 000 000 de tokens por minuto según su página de modelo). Qwen4-Max es una vista previa. Su comportamiento, sus límites o su ID pueden cambiar antes del lanzamiento general.
2. Cómo lo invocas. Qwen 3.8 funciona en la API estándar de pago por uso de Qwen Cloud, así que puedes ponerlo detrás de un backend de producción. Qwen4-Max funciona solo a través de los endpoints del Token Plan y las aplicaciones de Alibaba. Las preguntas frecuentes del Token Plan indican que el plan Individual es para «desarrollo interactivo personal a través de herramientas designadas» y prohíbe la automatización de producción, los scripts por lotes y las tareas programadas en segundo plano.
3. Longitud de salida en la práctica. Qwen3.8-Max indica una salida máxima de 131K. Para Qwen4-Max, el único número registrado es un valor por defecto del cliente: la guía de configuración de Qwen Code dice que qwen4-max-preview tiene por defecto un límite de salida de 32 768 tokens, que puedes aumentar con generationConfig.samplingParams.max_tokens. Es un ajuste de la herramienta, no un techo del modelo.
4. Tipos de entrada. El Token Plan etiqueta a Qwen4-Max con Generación de texto, Modelo de razonamiento y Comprensión visual. La página del modelo Qwen3.8-Max enumera entrada de texto, imagen y vídeo.
5. Funciones de la API. Qwen3.8-Max documenta function calling, salidas estructuradas, caché de contexto, archivos por lotes y fine-tuning. Nada de eso está documentado aún para Qwen4-Max.
Lo que aún no puedes comparar
Cuatro comparaciones que la gente querrá hacer no son posibles al 11 de noviembre de 2026.
- Benchmarks. Alibaba no publicó puntuaciones de Qwen4-Max. Para los números del proveedor de Qwen 3.8, consulta nuestro análisis de los benchmarks de Qwen 3.8.
- Ventana de contexto. Algunos informes dicen que Qwen4-Max tiene un contexto de 1M de tokens. Las páginas propias de Alibaba no lo dicen, y el análisis profundo de Kie.ai señala que la cifra de 1M pertenece a Qwen3.8-Max.
- Precio por token. No existe ninguna tarifa de pago por uso, así que no hay nada que poner junto al 2 $/6 $ de Qwen 3.8. El Token Plan no indica cuántos créditos cuesta una petición a Qwen4-Max.
- Tamaño y arquitectura. Alibaba no ha publicado un recuento de parámetros para Qwen4-Max. Qwen3.8-Max es un modelo Mixture-of-Experts de 2,4 T de parámetros.
Trata cualquier artículo que rellene estas casillas como especulación. Para detalles de acceso, consulta cómo usar Qwen4-Max.
Acceso y precios: Qwen4-Max vs Qwen 3.8
El Token Plan es el único plan que incluye ambos modelos. El 11 de noviembre de 2026, su página de la región de Singapur mostraba estos precios mensuales del plan Individual en dólares estadounidenses:
| Plan | Precio del evento | Precio de lista | Créditos al mes | Agentes concurrentes |
|---|---|---|---|---|
| Lite | 3,00 $ | 8,00 $ | 20 000 | 1-2 |
| Essential | 5,00 $ | 16,00 $ | 45 000 | 2-3 |
| Standard | 18,00 $ | 25,00 $ | 80 000 | 3-4 |
| Pro | 43,00 $ | 51,00 $ | 200 000 | 6-8 |
El precio del evento es para clientes nuevos, y la página dice que el precio final es el que muestre el pago tras iniciar sesión. Ambos modelos consumen del mismo fondo de créditos. qwen4-max-preview lleva la etiqueta «80 % de descuento por tiempo limitado», y qwen3.8-max lleva «40 % de descuento nocturno».
Qwen 3.8 tiene una hoja completa de precios de pago por uso: 2 $ de entrada, 6 $ de salida, 0,25 $ por aciertos de caché implícita, y 1 $ / 3 $ para archivos por lotes, por millón de tokens. Para el cálculo completo de costes de Qwen 3.8, lee nuestra guía de la API de Qwen 3.8.
Para un backend que invoca un modelo, Qwen 3.8 es la única opción de las dos. Para programar con un agente, el Token Plan te permite probar ambos con una sola suscripción.
Ejecuta tu propia prueba de Qwen4-Max vs Qwen 3.8
Sin benchmarks oficiales, tu propia prueba es la mejor evidencia. El trabajo con APIs encaja bien, porque un endpoint pasa sus pruebas o no las pasa.
La configuración de ejemplo de la guía de Qwen Code ya enumera ambos modelos en el mismo endpoint del Token Plan, así que cambiar entre ellos es una sola elección de menú:
{
  "$version": 4,
  "env": { "QWENCLOUD_TOKEN_PLAN_API_KEY": "YOUR_API_KEY" },
  "modelProviders": {
    "openai": [
      { "id": "qwen4-max-preview", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" },
      { "id": "qwen3.8-max", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" }
    ]
  }
}
Pon eso en ~/.qwen/settings.json. Luego prepara la prueba justa:
- Escribe el contrato una vez. Crea un
openapi.jsonpara una API pequeña, por ejemploPOST /ordersyGET /orders/{id}con reglas de validación y autenticación. Ninguno de los modelos escribe la especificación, así que ninguno corrige su propia tarea. - Crea dos carpetas vacías,
build-qwen4ybuild-qwen38, cada una con una copia de la especificación. - Envía el prompt de construcción idéntico en cada carpeta, con
qwen4-max-previewseleccionado en una yqwen3.8-maxen la otra: «Implementa la API de openapi.json con Express. Ejecútala en el puerto 3001 (o 3002). No cambies la especificación.» - Registra lo básico: tiempo hasta tener un servidor en marcha, archivos escritos y si tuviste que intervenir.
Luego prueba ambas construcciones contra la misma suite. Ahí es donde entra Apidog CLI.
Puntúa ambas construcciones con Apidog CLI
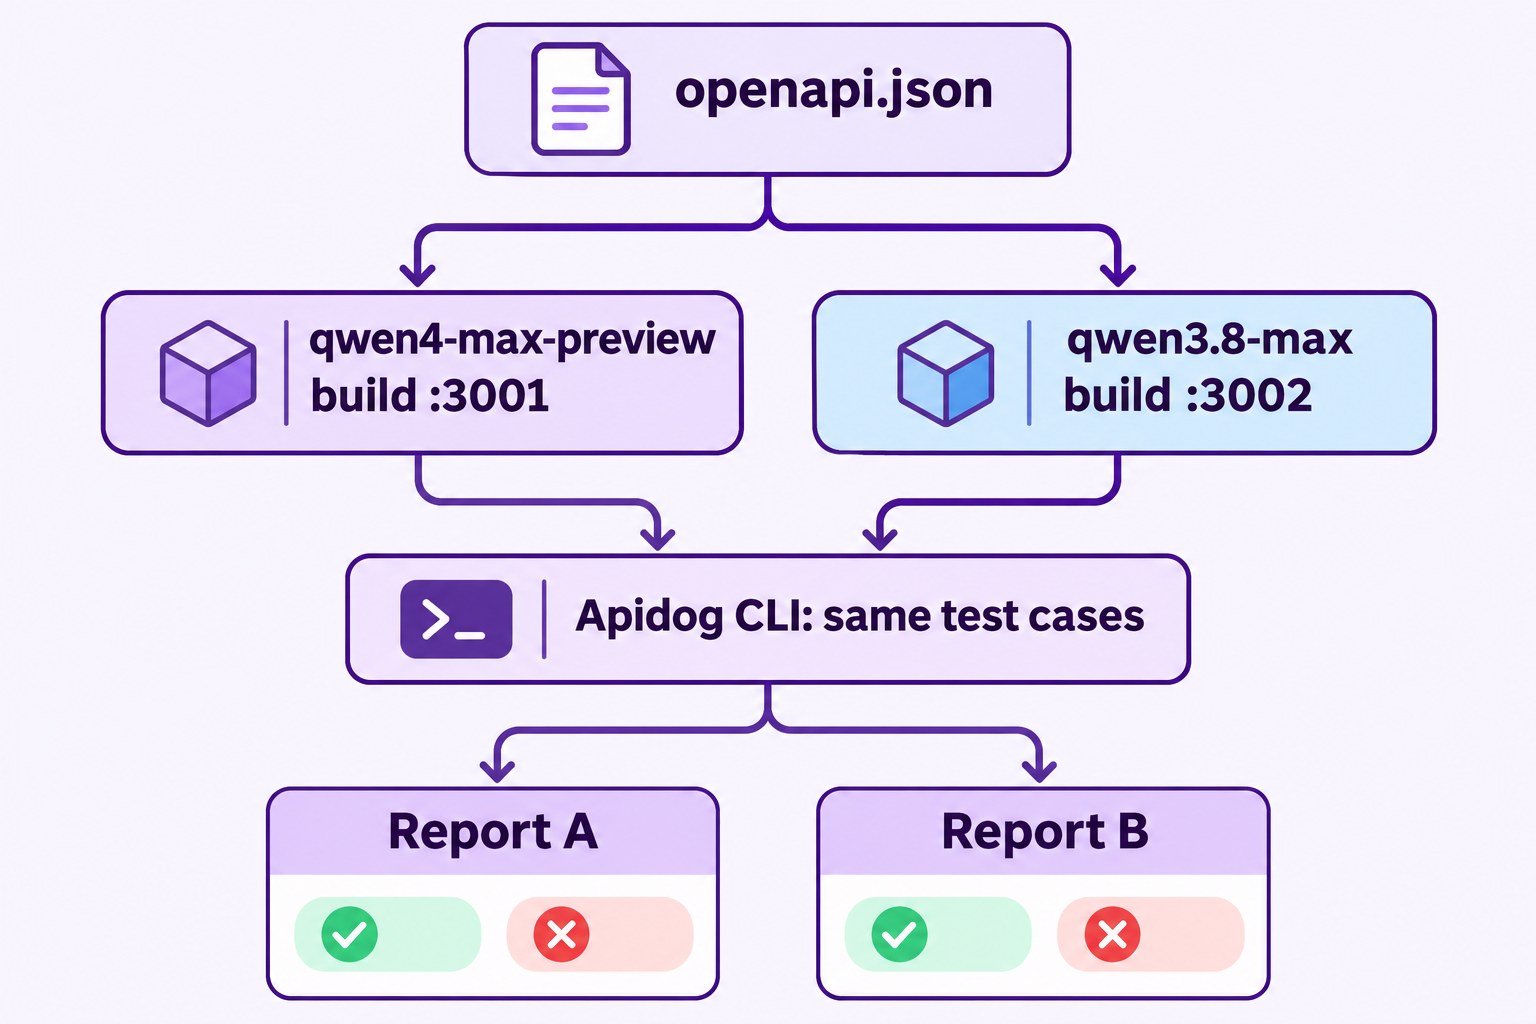
Tu agente de código maneja Apidog CLI: importa la especificación compartida, crea un único conjunto de casos de prueba a partir de ella y ejecuta ese conjunto contra cada construcción. Mismas pruebas, dos objetivos, dos informes.
Configura Apidog CLI una sola vez
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install enseña la CLI a tu agente. La guía de instalación cubre los tokens.
Dale a tu agente un solo prompt
Cualquier agente puede arbitrar; no tiene que ser un modelo de Qwen.
Import ./openapi.json into Apidog project <projectId>. Create two environments:
qwen4 at http://localhost:3001 and qwen38 at http://localhost:3002. From the spec,
create test cases for POST /orders: 201 on a valid order, 400 on a missing
customerId, 401 without a token, plus a GET /orders/{id} 404 case. Run every case
against both environments, save JSON reports, and give me a pass/fail table per model.
Don't modify either build.
Los comandos apidog que ejecuta
Cada flag de abajo proviene de apidog <command> --help en Apidog CLI 2.2.12:
apidog import --project <projectId> --format openapi --file ./openapi.json
apidog environment create qwen4 --project <projectId> --base-url http://localhost:3001
apidog environment create qwen38 --project <projectId> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case-201.json
apidog test-case create --project <projectId> --file ./case-201.json
apidog run --test-case <caseId> --project <projectId> -e <qwen4EnvId> -r cli,json --out-file qwen4-{GENERATE_TIME}
apidog run --test-case <caseId> --project <projectId> -e <qwen38EnvId> -r cli,json --out-file qwen38-{GENERATE_TIME}
cli-schema get le entrega al agente la forma JSON exacta de un caso de prueba, y cli-schema validate comprueba cada archivo antes de escribir nada. El agente repite test-case create y las dos líneas de apidog run para cada caso. El reportero cli imprime un resumen de aprobados y suspensos, y json guarda un informe en apidog-reports, que el agente lee para construir su tabla. Añade --upload-report para ver una ejecución en la aplicación de Apidog.
Qué leer en los informes
Cuenta tres cosas por modelo: casos aprobados en la primera construcción, rondas de corrección necesarias para llegar a todo en verde, y cualquier caso en que el modelo cambió el contrato en lugar del código. Ejecuta todo dos o tres veces, ya que una sola ejecución de un modelo en vista previa te dice poco. Para más patrones impulsados por agentes, consulta el flujo de trabajo del agente de Apidog CLI y Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios.
¿Cuál deberías usar hoy?
Ajusta el modelo al trabajo:
- Aplicación o backend de producción: Qwen 3.8. Tiene una API pública, un precio publicado y límites documentados. Las reglas del Token Plan descartan aquí a Qwen4-Max.
- Programar con un agente: prueba ambos en el Token Plan. Ejecuta la prueba anterior sobre una tarea de tu backlog real, no de juguete.
- Decisiones que necesiten números: espera. Los benchmarks, la longitud de contexto y el precio de Qwen4-Max aún no se han publicado.
Mantén el ID del modelo en un único valor de configuración, así que cambiar al ID estable de Qwen4-Max será un cambio de una línea. Consulta también Qwen 3.8 para programación y nuestra guía de los mejores modelos de Qwen.
Preguntas frecuentes
¿Es Qwen4-Max mejor que Qwen 3.8? Alibaba dice que tiene un conocimiento más profundo y mayores habilidades de codificación y de agentes, pero no ha publicado benchmarks. Ningún dato oficial lo demuestra todavía, así que prueba ambos en tu propia tarea.
¿Puedo invocar a Qwen4-Max a través de la API como Qwen 3.8? No con pago por uso. Qwen4-Max está disponible a través de los endpoints del Token Plan con el ID qwen4-max-preview, para uso interactivo en herramientas de código. Qwen3.8-Max (qwen3.8-max) tiene una API estándar.
¿Tiene Qwen4-Max un contexto de 1M de tokens como Qwen 3.8? Alibaba no lo ha dicho. Qwen3.8-Max tiene un contexto documentado de 1M. La cifra de 1M para Qwen4-Max proviene solo de informes de terceros.
¿Cuánto cuesta Qwen4-Max en comparación con Qwen 3.8? Qwen 3.8 cuesta 2 $ de entrada y 6 $ de salida por millón de tokens. Qwen4-Max aún no tiene precio por token. A través del Token Plan, ambos comparten un fondo de créditos en planes desde 3 $ al mes (precio del evento Lite, 8 $ de lista).
¿Debería migrar mi aplicación de Qwen 3.8 a Qwen4-Max? Todavía no. Una vista previa puede cambiar sin previo aviso, y el Token Plan prohíbe la automatización de producción. Mantén Qwen 3.8 en producción y ejecuta Qwen4-Max en paralelo en desarrollo.