
El precio de Qwen4-Max en la API de pago por token de QwenCloud es de 1,50 $ por cada 1M de tokens de entrada y 4,50 $ por cada 1M de tokens de salida en la región de Singapur, con entrada en caché a 0,075 $ por 1M. Los modos con razonamiento (thinking) y sin él cuestan lo mismo, y no hay tramos por longitud de entrada. Si prefieres pagar una cuota mensual fija para herramientas de programación, el mismo modelo está disponible en Token Plan, desde 6 $ al mes.
A continuación: la lista de tarifas, los costes reales de tareas, el ahorro por caché, Token Plan frente a pago por token y los precios de la competencia. ¿No conoces el modelo? Empieza por qué es Qwen4-Max.
Precio de la API de Qwen4-Max por 1M de tokens
Qwen4-Max se factura por millón de tokens, con tarifas separadas para entrada, salida, escritura en caché y lectura de caché. La salida cubre tanto los tokens de razonamiento (“thinking”) como la respuesta. Alibaba publica una columna de Singapur (Internacional) y otra más baja para Pekín/Global.
| Concepto facturado (por 1M de tokens) | Singapur (Internacional) | Pekín / Global |
|---|---|---|
| Entrada | $1.50 | $1.413 |
| Salida (razonamiento + respuesta) | $4.50 | $4.24 |
| Escritura en caché, TTL de 5 minutos | $1.875 | $1.767 |
| Escritura en caché, TTL de 1 hora | $3.00 | $2.827 |
| Lectura de caché (acierto explícito o implícito) | $0.075 | $0.071 |
Fuente: la documentación de precios de QwenCloud y la página del modelo Qwen4-Max, ambas consultadas el 16 de noviembre de 2026. La documentación indica que el despliegue Global está en Frankfurt, Hong Kong, Tokio y EE. UU. (Virginia).
Algunas reglas determinan la factura:
- Los tokens de razonamiento son salida. Si activas
enable_thinking, cada token de razonamiento se factura a 4,50 $ por 1M. - No hay recargo por contexto largo. Una solicitud de 900K tokens cuesta lo mismo por token que una de 9K.
- Las lecturas de caché cuestan el 5% del precio de entrada. 0,075 $ frente a 1,50 $ suponen un 95% de descuento en prefijos repetidos.
- Límites: contexto de 1M de tokens, hasta 991K de entrada (983K con razonamiento), hasta 393K de salida y 5.000.000 de tokens por minuto.
El id del modelo es qwen4-max. Si aún no has hecho ninguna llamada, nuestra guía de la API de Qwen4-Max cubre las claves, las URLs base y la primera petición.
Cuánto cuesta una tarea real con Qwen4-Max
Los precios por token son difíciles de dimensionar. Alibaba ofrece una cifra concreta en su publicación de lanzamiento: en su benchmark de agentes Work360, el coste medio por tarea bajó de 4,43 $ con Qwen3.8-Max a 1,67 $ con Qwen4-Max, un 62% menos. Alibaba también informa de que Qwen4-Max usó aproximadamente un 24% menos de tokens en el nivel de esfuerzo Xhigh y alrededor de un 35% menos en High en Work360. Son cifras del proveedor, así que tómalas como una orientación, no como una cotización para tu carga de trabajo.
Puedes estimar tu propio coste con aritmética sencilla. Aquí tienes tres ejemplos resueltos con los precios oficiales de Singapur:
- Llamada de chat corta. 2.000 tokens de entrada y 500 de salida: 2.000 x 1,50 $/1M + 500 x 4,50 $/1M = 0,003 $ + 0,00225 $ = 0,0053 $. Eso es unos 5,25 $ por cada 1.000 llamadas.
- La misma llamada con razonamiento activado. Supongamos que el modelo razona durante 6.000 tokens antes de la respuesta de 500 tokens. La salida pasa a ser de 6.500 tokens, así que la llamada cuesta 0,003 $ + 0,02925 $ = 0,032 $, unas seis veces más.
- Pregunta sobre un documento largo. 300.000 tokens de entrada y 2.000 de salida: 0,45 $ + 0,009 $ = 0,459 $ sin caché, o unos 0,032 $ si el documento de 300K es un acierto de caché.
El ejemplo 2 sorprende a mucha gente: el razonamiento puede dominar la factura incluso cuando la respuesta es corta. Para más datos sobre calidad por dólar, consulta el análisis de benchmarks de Qwen4-Max.
Cómo las tarifas de caché modifican la factura de Qwen4-Max
La caché de contexto es donde el precio de Qwen4-Max realmente cambia. QwenCloud ofrece dos modos para qwen4-max en la API de pago por token, y en las APIs compatibles con Chat Completions, DashScope y Anthropic son mutuamente excluyentes por solicitud.
| Modo | Cómo funciona | Precio | ¿Acierto garantizado? |
|---|---|---|---|
| Caché implícita | Automática, no se puede desactivar, reutiliza un prefijo común de 1.024+ tokens | $0.075 por 1M en caso de acierto | No. La validez es indeterminada |
| Caché explícita | Marcas un punto de interrupción con cache_control |
$1.875 (5 min) o $3 (1 h) por escribir, $0.075 por leer | Sí, mientras la caché sea válida |
La documentación sobre caché de contexto indica que una caché explícita de 5 minutos reinicia su temporizador en cada acierto, de modo que un bucle de agente con uso intensivo la mantiene activa.
Ahora toma una sesión de agente: un prompt de sistema de 200K tokens más definiciones de herramientas y contexto del repositorio, reutilizados a lo largo de 50 turnos, con 2K de entrada nueva y 3K de salida por turno.
- Sin aciertos de caché: 10,1M de tokens de entrada x 1,50 $ + 150K de salida x 4,50 $ = 15,83 $.
- Aciertos de caché implícita desde el turno 2: los primeros 202K a precio completo (0,30 $), 9,8M de tokens en caché a 0,075 $ (0,74 $), 98K de tokens nuevos (0,15 $) y la salida (0,68 $) = 1,86 $.
- Caché explícita de 5 minutos: una escritura de 0,375 $ en lugar del primer prefijo a precio completo, las mismas lecturas y la salida = unos 1,94 $, con acierto garantizado.
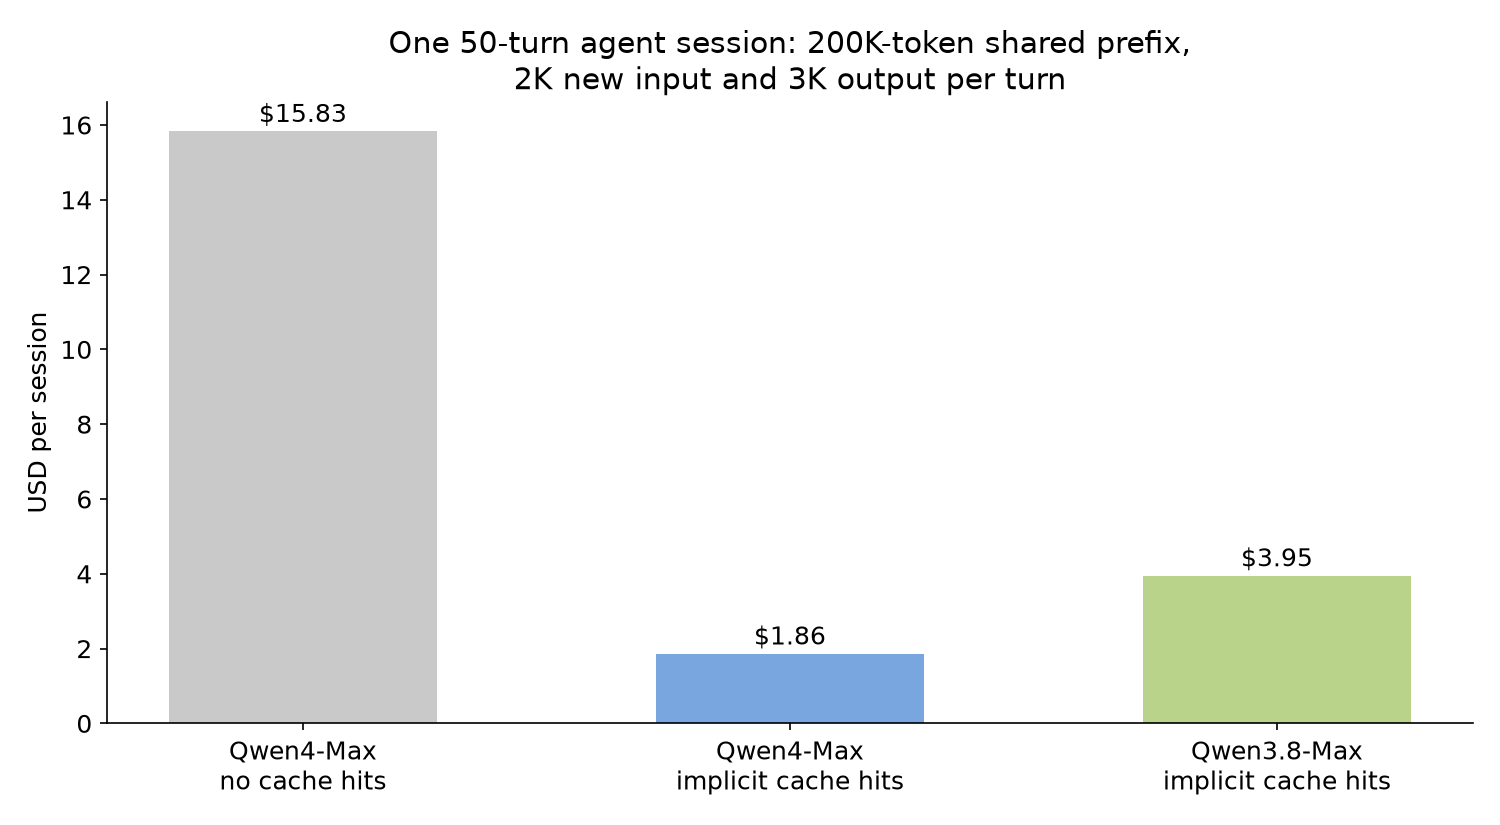
La misma sesión en Qwen3.8-Max, con sus tarifas de 2 $ de entrada, 0,25 $ de caché implícita y 6 $ de salida, asciende a 3,95 $. Ahí es donde se refleja la afirmación de Alibaba del “mayor recorte en la entrada en caché”: Qwen3.8-Max cobra 0,25 $ por un acierto implícito, mientras que Qwen4-Max cobra 0,075 $.
Usa la caché explícita cuando necesites un acierto predecible y la implícita para todo lo demás. Comprueba lo que obtuviste en usage.prompt_tokens_details.cached_tokens y cache_creation_input_tokens. Si estás comparando la economía de la caché entre proveedores, nuestro cálculo del prompt caching de Claude Opus 5.5 usa el mismo método.
¿Hay descuento por lotes (batch) en Qwen4-Max?
Sí, pero solo en una región. La API Batch de QwenCloud normalmente factura la entrada y la salida al 50% del precio en tiempo real. Para qwen4-max, la documentación de batch lo lista solo en China North 2 (Pekín), a 0,707 $ de entrada y 2,12 $ de salida por 1M de tokens para Batch File. Batch Chat en Pekín figura a 1,413 $ / 4,24 $.
Batch no admite caché de contexto, no se acumula con otros descuentos y no está cubierto por la cuota gratuita. Con tasas altas de acierto de caché, la API en tiempo real puede superar a batch.
Qwen4-Max: pago por token frente a Token Plan
Token Plan es la suscripción mensual de QwenCloud para herramientas de programación y agentes como Claude Code, Cursor, Qwen Code, Codex y Qoder. Factura en Créditos, no en tokens, y usa sus propias claves de API sk-sp-. qwen4-max está en la lista de modelos compatibles. Los planes individuales, según la documentación de Token Plan del 16 de noviembre de 2026:
| Plan | Precio mensual | Créditos al mes | Agentes concurrentes |
|---|---|---|---|
| Lite | $6 ($3 precio de lanzamiento para nuevos usuarios) | 20,000 | 1-2 |
| Essential | $10 ($5 precio de lanzamiento para nuevos usuarios) | 45,000 | 2-3 |
| Standard | $18 | 80,000 | 3-4 |
| Pro | $43 | 200,000 | 6-8 |
Los paquetes de créditos adicionales cuestan 15 $ por 20.000 Créditos (hasta 5 a la vez). Cuando se agotan los Créditos, las llamadas se bloquean; no hay vuelta al pago por token.
Cómo elegir:
- Elige Token Plan si una sola persona usa el modelo a diario a través de un agente de programación y quiere un coste mensual fijo.
- Elige pago por token para productos, trabajos de backend, batch, fine-tuning o tráfico irregular. Pagas por lo que usas y conservas el límite de 5.000.000 de TPM.
Los Créditos por solicitud de Qwen4-Max no siguen una relación fija de tokens, así que revisa la consola tras un día de uso real. Cubrimos el plan en profundidad, incluido hasta dónde llegan los Créditos, en Qwen4-Max Token Plan: cuánto cuesta y si vale la pena.
Precio de Qwen4-Max frente a Qwen3.8-Max y otros modelos insignia de la competencia
Qwen4-Max es más barato que su predecesor en entrada, salida, lecturas de caché y la escritura en caché de 5 minutos (Qwen3.8-Max lista un único precio de escritura en caché de 2,50 $; la escritura de 1 hora de Qwen4-Max cuesta 3 $). Así se compara con otros modelos insignia a precios oficiales estándar, consultados en la página de cada proveedor el 16 de noviembre de 2026.
| Modelo | Entrada / 1M | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|
| Qwen4-Max (Singapur) | $1.50 | $0.075 | $4.50 |
| Qwen3.8-Max | $2.00 | $0.25 (implícita), $0.17 (lectura explícita) | $6.00 |
| DeepSeek V4 Pro (hora punta / valle) | $1.32 / $0.66 | $0.044 / $0.022 | $3.96 / $1.98 |
| OpenAI gpt-5.6-sol | $4.00 | $0.40 | $20.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
Fuentes: página del modelo Qwen3.8-Max, precios de DeepSeek, precios de la API de OpenAI y precios de Claude.
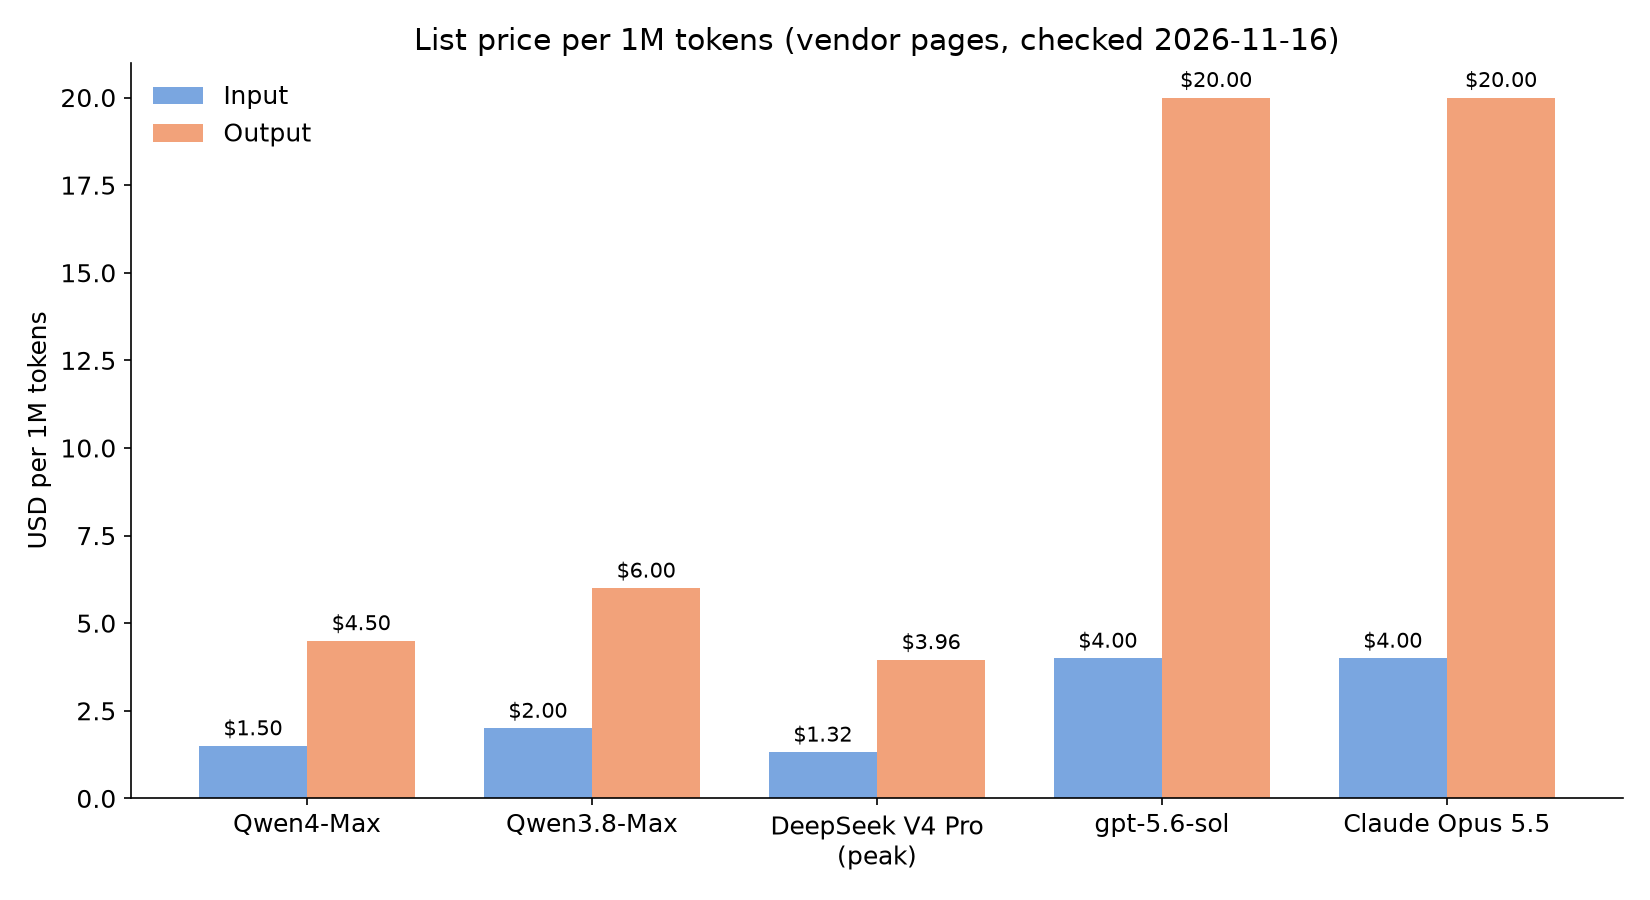
Para agentes, la salida suele ser la partida más grande, y los 4,50 $ de salida de Qwen4-Max quedan muy por debajo de los 20 $ que cobran gpt-5.6-sol y Claude Opus 5.5. DeepSeek V4 Pro es más barato por token, sobre todo en horas valle. El coste por tarea completada depende de cuántos tokens dedique cada modelo a tu carga de trabajo. Para más detalles sobre Qwen3.8-Max, consulta nuestra guía de precios de Qwen 3.8 y la comparativa de Qwen4-Max vs Qwen 3.8.
Deja que tu agente de programación mida los costes de Qwen4-Max con Apidog CLI
La única estimación de coste fiable es la de usage medida sobre tus propios prompts. Deja que tu agente de programación (Claude Code, Codex, Cursor o similar) construya y ejecute esa comprobación con Apidog CLI. Configúralo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Luego dale a tu agente un único prompt:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
El agente comprueba la forma de cada payload contra el esquema de la CLI antes de escribir nada y luego ejecuta los casos:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Compara los dos valores de completion_tokens y multiplícalos por 4,50 $ por 1M: ese es tu sobrecoste de razonamiento, sobre tus propios prompts. Añade --upload-report al comando apidog run para ver la ejecución en la app de Apidog, o pon el mismo comando en CI con -r junit, como se muestra en ejecutar Apidog CLI en CI/CD. ¿Nuevo en la CLI? La guía de instalación de Apidog CLI y Apidog CLI en Codex te ponen en marcha en minutos. El plan gratuito de Apidog cubre hasta 4 usuarios.
FAQ
¿Cuánto cuesta Qwen4-Max por 1M de tokens? 1,50 $ de entrada y 4,50 $ de salida en la región de Singapur, con lecturas de caché a 0,075 $. La columna de Pekín/Global es algo más baja: 1,413 $ y 4,24 $.
¿El modo de razonamiento cuesta más en Qwen4-Max? La tarifa es la misma, pero los tokens de razonamiento se facturan como salida a 4,50 $ por 1M, así que un razonamiento largo multiplica el coste de la llamada.
¿Es Qwen4-Max más barato que Qwen3.8-Max? Sí. La entrada baja de 2 $ a 1,50 $, la salida de 6 $ a 4,50 $, y un acierto de caché implícita de 0,25 $ a 0,075 $ por 1M de tokens. Alibaba también informa de que el coste por tarea en Work360 bajó de 4,43 $ a 1,67 $.
¿Puedo usar Qwen4-Max gratis? QwenCloud ofrece una cuota gratuita para modelos nuevos en la región de Singapur, normalmente 1M de tokens válidos durante 90 días, tras añadir tus datos de pago. Consulta la página de Free Tier en la consola para qwen4-max y mira nuestra guía de acceso gratuito a Qwen4-Max para conocer todas las rutas a 0 $.
¿Qwen4-Max admite precios por lotes? Solo en la región de Pekín: Batch File cuesta 0,707 $ de entrada y 2,12 $ de salida por 1M de tokens, sin caché de contexto.
¿Debo elegir Token Plan o pago por token para Qwen4-Max? Token Plan encaja con una persona que usa herramientas de programación a diario, desde 6 $ al mes. El pago por token encaja con apps, trabajos de backend y procesamiento por lotes.