
Los benchmarks de Qwen4-Max, en una línea: la tabla de Alibaba sitúa a Qwen4-Max por delante de Qwen3.8-Max en cada una de las 15 pruebas en las que ambos aparecen, y primero en la clasificación general en 4 de 16, pero la mayoría de esas cifras provienen de las propias ejecuciones de Alibaba. En Work360 obtiene una puntuación de 52.69 frente a 47.74, y el coste medio por tarea baja de $4.43 a $1.67.
Un benchmark solo es tan útil como la respuesta a la pregunta «¿quién lo ejecutó y cómo?». Esta guía cubre todas las puntuaciones que Alibaba publicó el 16 de noviembre de 2026, las clasifica entre autoinformadas y de terceros, y termina con una forma de ejecutar tu propia comprobación contra la API de Qwen4-Max. Para lo básico, empieza con qué es Qwen4-Max y cómo obtener acceso.
Puntuaciones de los benchmarks de Qwen4-Max de un vistazo
La publicación de lanzamiento de Alibaba compara Qwen4-Max con Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra y Kimi K3.1 en 16 benchmarks.
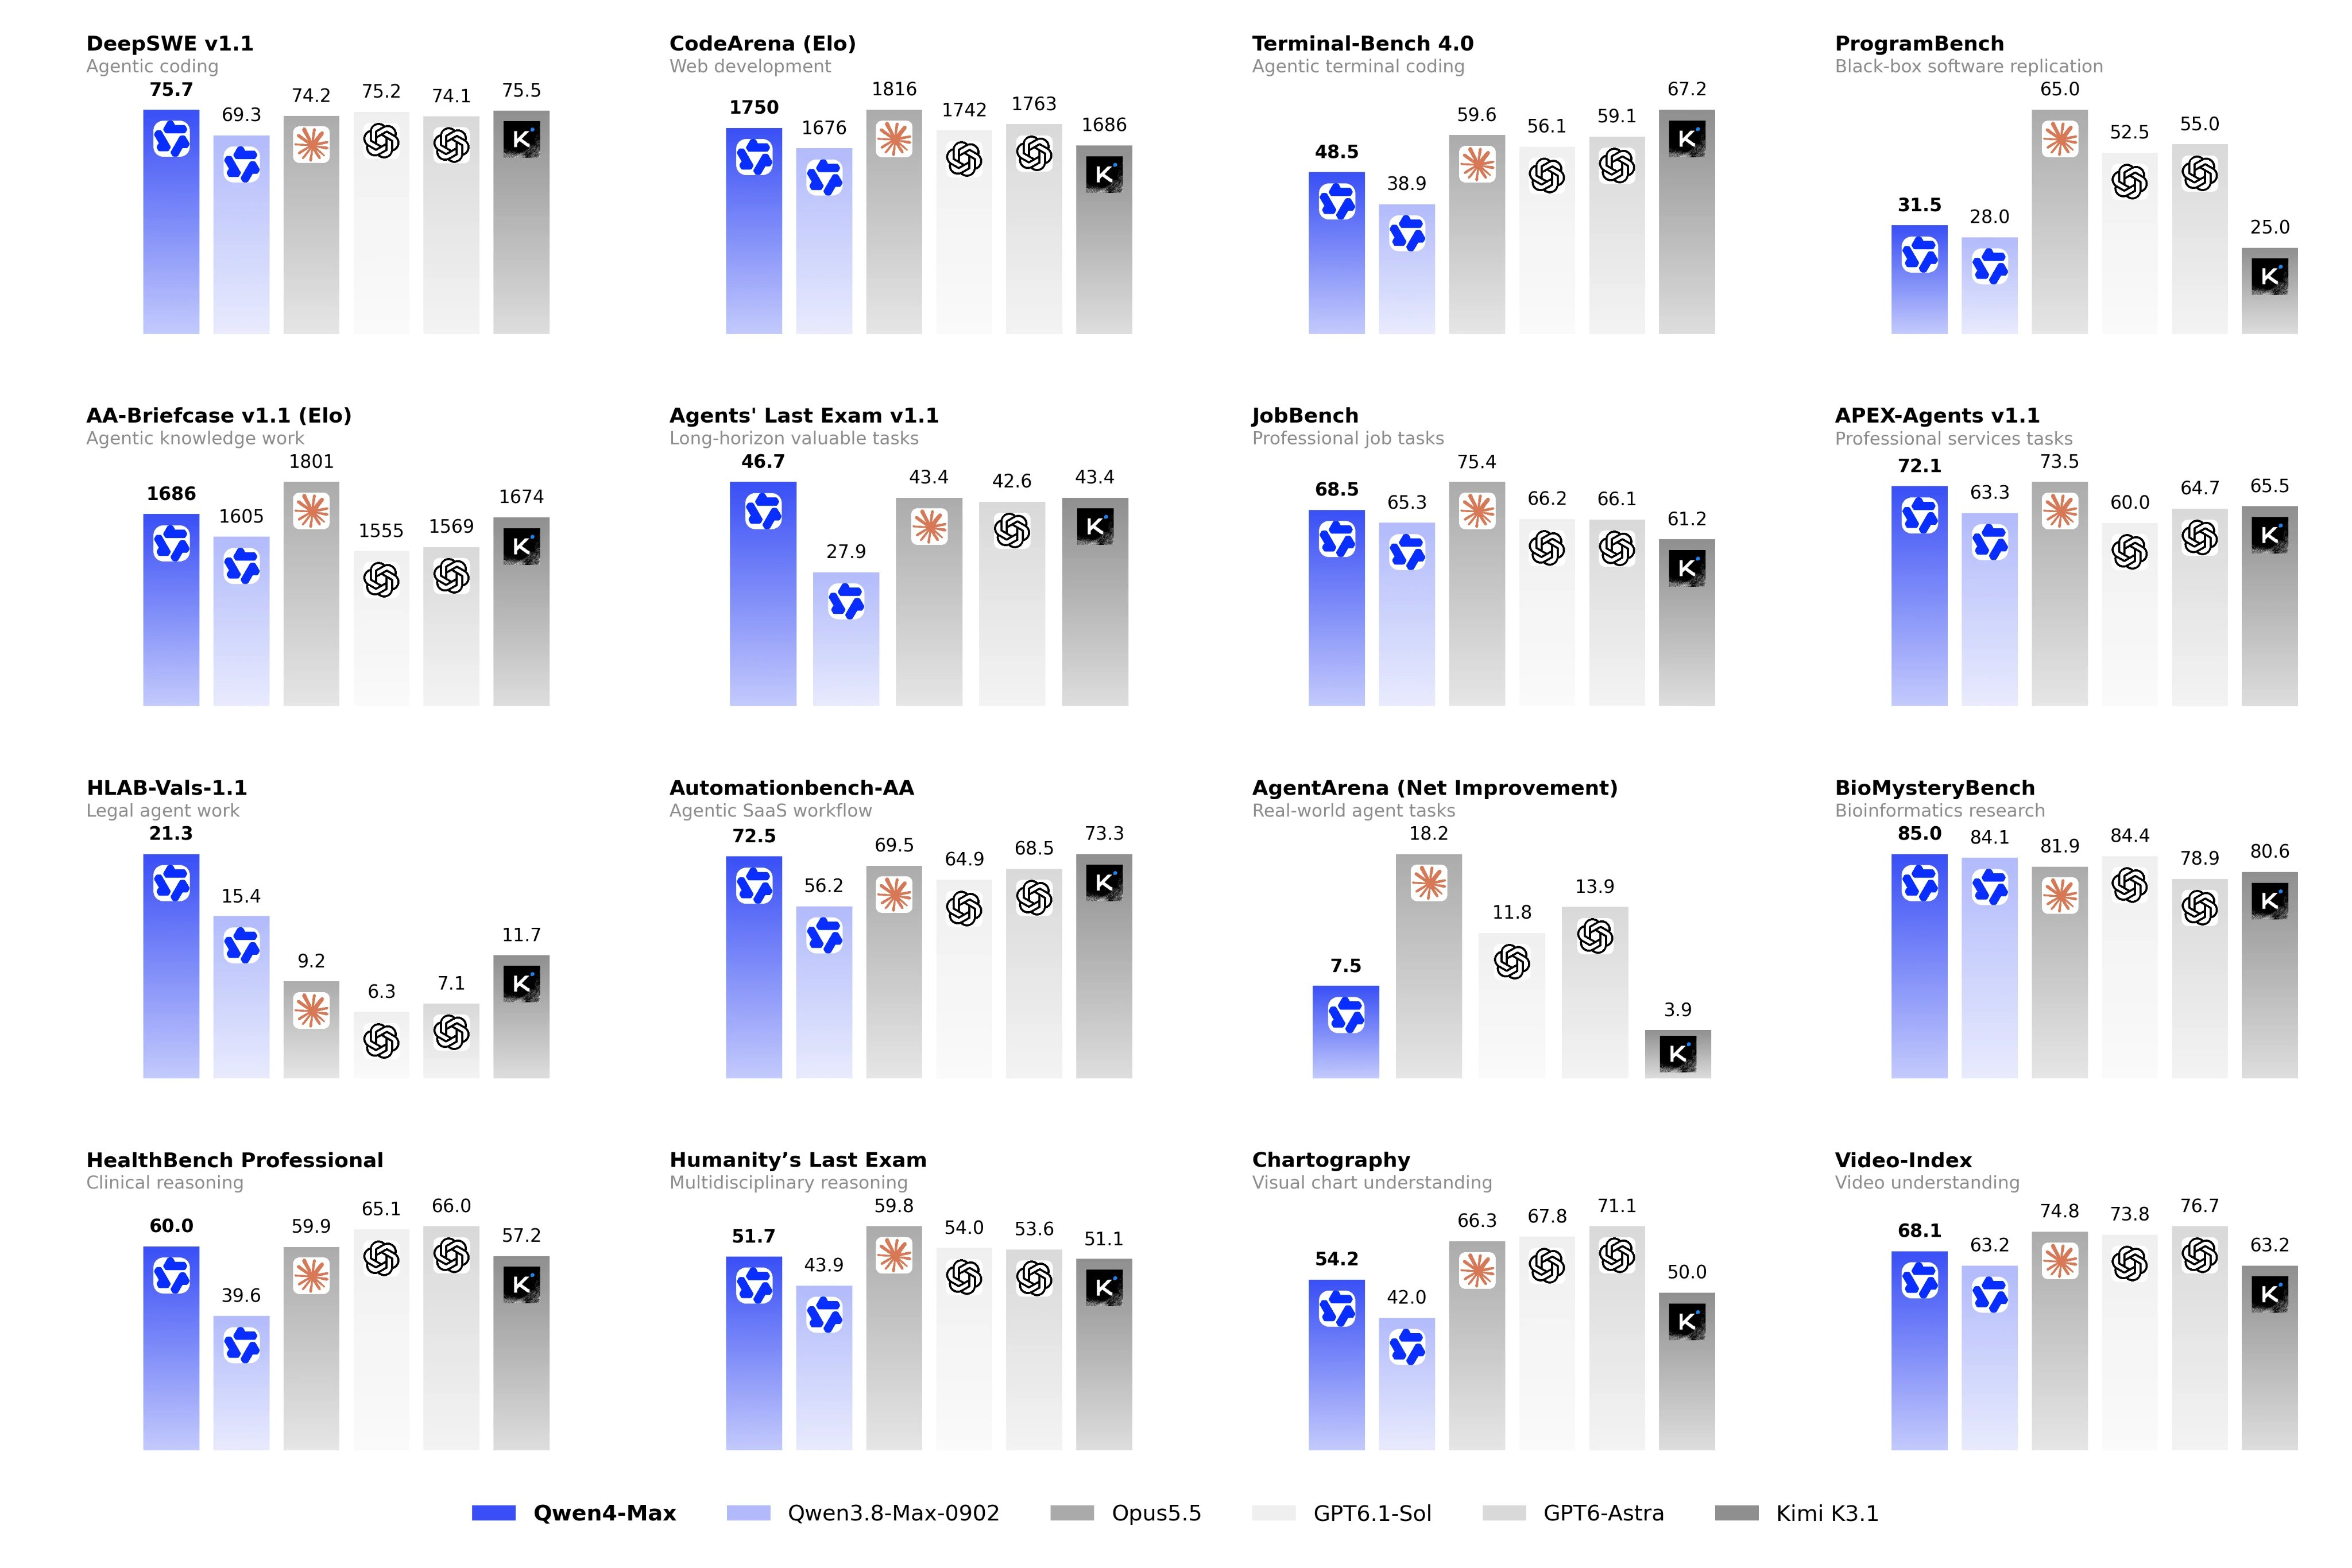
Las negritas marcan la puntuación más alta de la tabla. «Alibaba» significa que las notas al pie no citan ninguna clasificación externa para esa prueba, así que trátala como una ejecución propia de Alibaba (las notas al pie de JobBench y Chartography solo describen la configuración de Alibaba).
Autoinformados frente a terceros: quién ejecutó cada prueba
Diez de las 16 puntuaciones son autoinformadas. Seis están citadas de clasificaciones públicas ejecutadas por otros. Esa división es el filtro más útil que puedes aplicar.
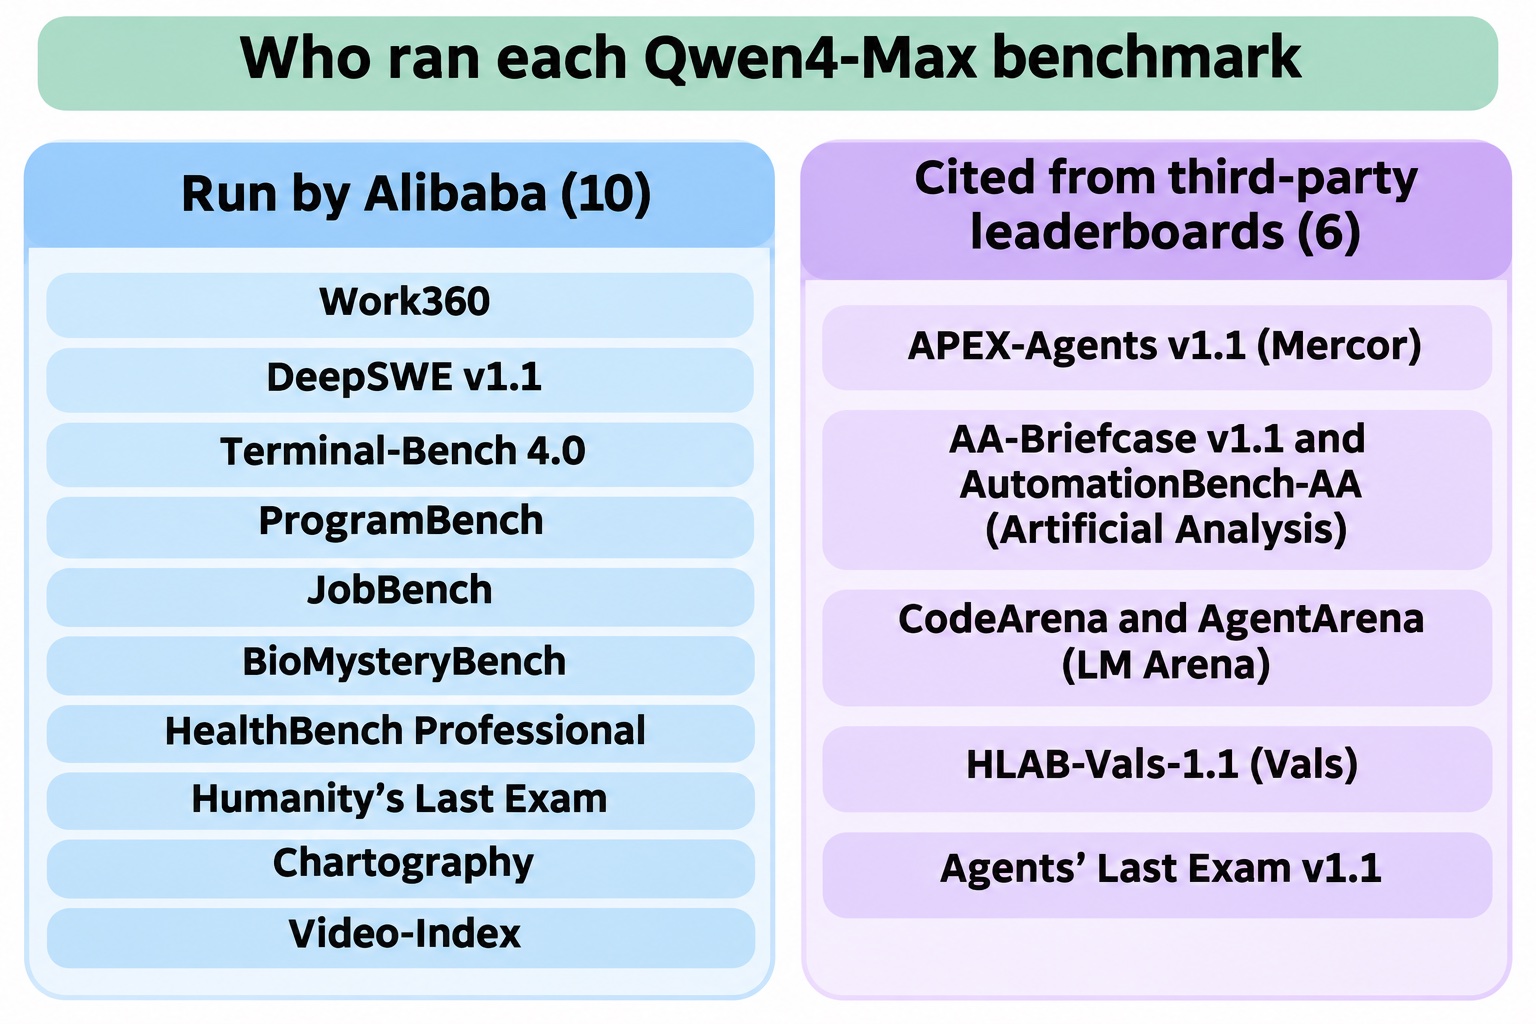
El grupo de terceros, según las notas al pie de la publicación de lanzamiento:
- APEX-Agents v1.1: citado de la clasificación APEX-Agents de Mercor
- AA-Briefcase v1.1 y AutomationBench-AA: citados de Artificial Analysis
- CodeArena y AgentArena: citados de LM Arena
- HLAB-Vals-1.1: citado del Vals Index
- Agents’ Last Exam v1.1: citado de su propia clasificación
Una cifra independiente que puedes consultar hoy: el Vals Index (versión 2.2, actualizado el 15 de noviembre de 2026) sitúa a Qwen 4 Max en un 63.20% general, en el puesto 11, a $9.33 por prueba. Esto lo coloca detrás de diez modelos, encabezados por Claude Fable 5.2 con un 71.31%, y justo por delante de Kimi K3.1 Pro (62.52%) y Qwen 3.8 Max 0902 (59.05%). Es una imagen más modesta que la de la tabla principal.
Work360: el benchmark de trabajo propio de Alibaba
Work360 es el benchmark de Alibaba para tareas industriales complejas, que abarca 26 dominios, 182 subdominios y 721 campos especializados. Qwen4-Max obtuvo 52.69, frente a los 47.74 de Qwen3.8-Max.
Léelo con cuidado: Alibaba diseñó el benchmark y ejecutó los modelos, su comparación publicada cubre solo Qwen4-Max y Qwen3.8-Max, y todavía no existe una clasificación pública para él. Es una cifra de generación a generación, no un ranking frente a otros laboratorios.
Lo que Work360 sí te da es una cifra de coste: el coste medio por tarea bajó de $4.43 a $1.67, una reducción del 62%, gracias a la combinación de menos tokens por tarea y precios más bajos. Qwen4-Max figura a $1.50 por millón de tokens de entrada y $4.50 por millón de tokens de salida en la página del modelo de QwenCloud. Desglose completo en nuestra guía de precios de Qwen4-Max.
Terminal-Bench 4.0 y eficiencia de tokens
Terminal-Bench mide a los agentes completando tareas reales en una terminal. Alibaba reporta 48.5 para Qwen4-Max en la versión 4.0, frente a 38.9 para Qwen3.8-Max. En la propia tabla de Alibaba, los cuatro modelos que no son de Qwen se sitúan entre 56.1 y 67.2, todos por encima.
La afirmación más importante es la eficiencia. Alibaba dice que el uso de tokens cae alrededor de un 48% con esfuerzo Xhigh y un 49% con esfuerzo High en Terminal-Bench 4.0, y alrededor de un 24% (Xhigh) y un 35% (High) en Work360. Su gráfica de puntuación frente a tokens muestra la forma de esta relación:
- En Work360, Qwen4-Max con esfuerzo High ya supera ligeramente a Qwen3.8-Max con Xhigh, con unos 96K tokens por tarea frente a unos 165K (leído de la gráfica, por lo que es aproximado).
- En Terminal-Bench 4.0, Qwen4-Max con Xhigh alcanza 48.5 con unos 150K tokens por tarea, mientras que Qwen3.8-Max con Xhigh llega a unos 38 con unos 290K.
Menos tokens para una mejor puntuación es la dirección correcta si pagas por token. También es autoinformado.
Una comprobación que conviene conocer: la clasificación pública de Terminal-Bench ahora usa por defecto la versión 4.1, y Qwen4-Max no aparece ahí listado a fecha del 16 de noviembre. Qwen3.8-Max-0902 muestra un 27.0% en la 4.1 (ejecutado con Claude Code a esfuerzo máximo), frente a 38.9 en la tabla 4.0 de Alibaba. Versión y harness diferentes, así que no restes uno del otro, pero muestra cuánto puede moverse una puntuación según la configuración.
Dónde lidera Qwen4-Max y dónde se queda atrás
Frente a los otros modelos de frontera en la tabla, el panorama es mixto:
Lidera (4 de 16): DeepSWE v1.1 (75.7, con una ventaja de 0.2 puntos sobre Kimi K3.1), Agents’ Last Exam v1.1 (46.7), HLAB-Vals-1.1 (21.3) y BioMysteryBench (85.0, con menos de un punto de ventaja sobre GPT-6.1 Sol).
Segundo muy cerca: APEX-Agents v1.1 (72.1 frente a 73.5), AutomationBench-AA (72.5 frente a 73.3) y AA-Briefcase (1686 frente a 1801 de Elo).
Claramente por detrás: ProgramBench (31.5 frente a 65.0), Terminal-Bench 4.0 (48.5 frente a 67.2), AgentArena (7.5 frente a 18.2), Chartography (54.2 frente a 71.1) y Humanity’s Last Exam (51.7 frente a 59.8).
Dos de las cuatro liderazgos, Agents’ Last Exam y HLAB-Vals, provienen de clasificaciones de terceros, lo que los convierte en las afirmaciones más sólidas de la tabla. En programación, la situación se divide: una ventaja estrecha en DeepSWE, brechas amplias en ProgramBench y Terminal-Bench. Si ejecutas agentes de terminal de larga duración, haz pruebas antes de cambiar. Para saber qué cambió desde la generación anterior, consulta Qwen4-Max vs Qwen 3.8.
Cifras de codificación segura y preentrenamiento
Codificación segura. En Last Secure Code Bench, en la configuración de «reconstrucción de código sin pista de seguridad» con funcionalidad y vulnerabilidades verificadas, la tasa de aprobación a nivel de función subió del 22.0% de Qwen3.8-Max al 31.8%. La proporción de código que pasó los tres niveles (función, archivo y repositorio) subió del 8% al 14.7%. Aun así, cerca de dos tercios de las salidas a nivel de función fallan alguna verificación, por lo que la revisión de seguridad sigue siendo tu responsabilidad.
Preentrenamiento. En evaluaciones internas de conocimiento, código, preguntas y respuestas y STEM, Qwen4-Max-Base muestra entre un 5% y un 13% menos de bits por byte que Qwen3.8-Max-Base, activando un 25% menos de parámetros. Alibaba señala que dos checkpoints en esa comparación (GLM-5.3 y Kimi-K3.1-Pro) están postentrenados, lo que puede sesgarla.
Lo que aún falta
- Configuraciones de evaluación para la mayoría de las pruebas. La publicación de lanzamiento no indica qué nivel de esfuerzo (High o Xhigh) ni qué harness de agente produjo cada barra.
- Variabilidad. Sin barras de error ni número de ejecuciones. Clasificaciones como Terminal-Bench reportan márgenes de unos 3 a 4 puntos, mayores que algunas de las brechas anteriores.
- Ejecuciones independientes de Terminal-Bench y Work360. Ninguno está todavía en una clasificación pública.
Ejecuta tu propio benchmark de Qwen4-Max con Apidog CLI
Ningún benchmark público usa tus prompts ni tus esquemas. La comprobación honesta más rápida es un conjunto pequeño de tus propias peticiones, ejecutado siempre de la misma manera, con el uso de tokens registrado para que puedas calcular tu propio coste por tarea.
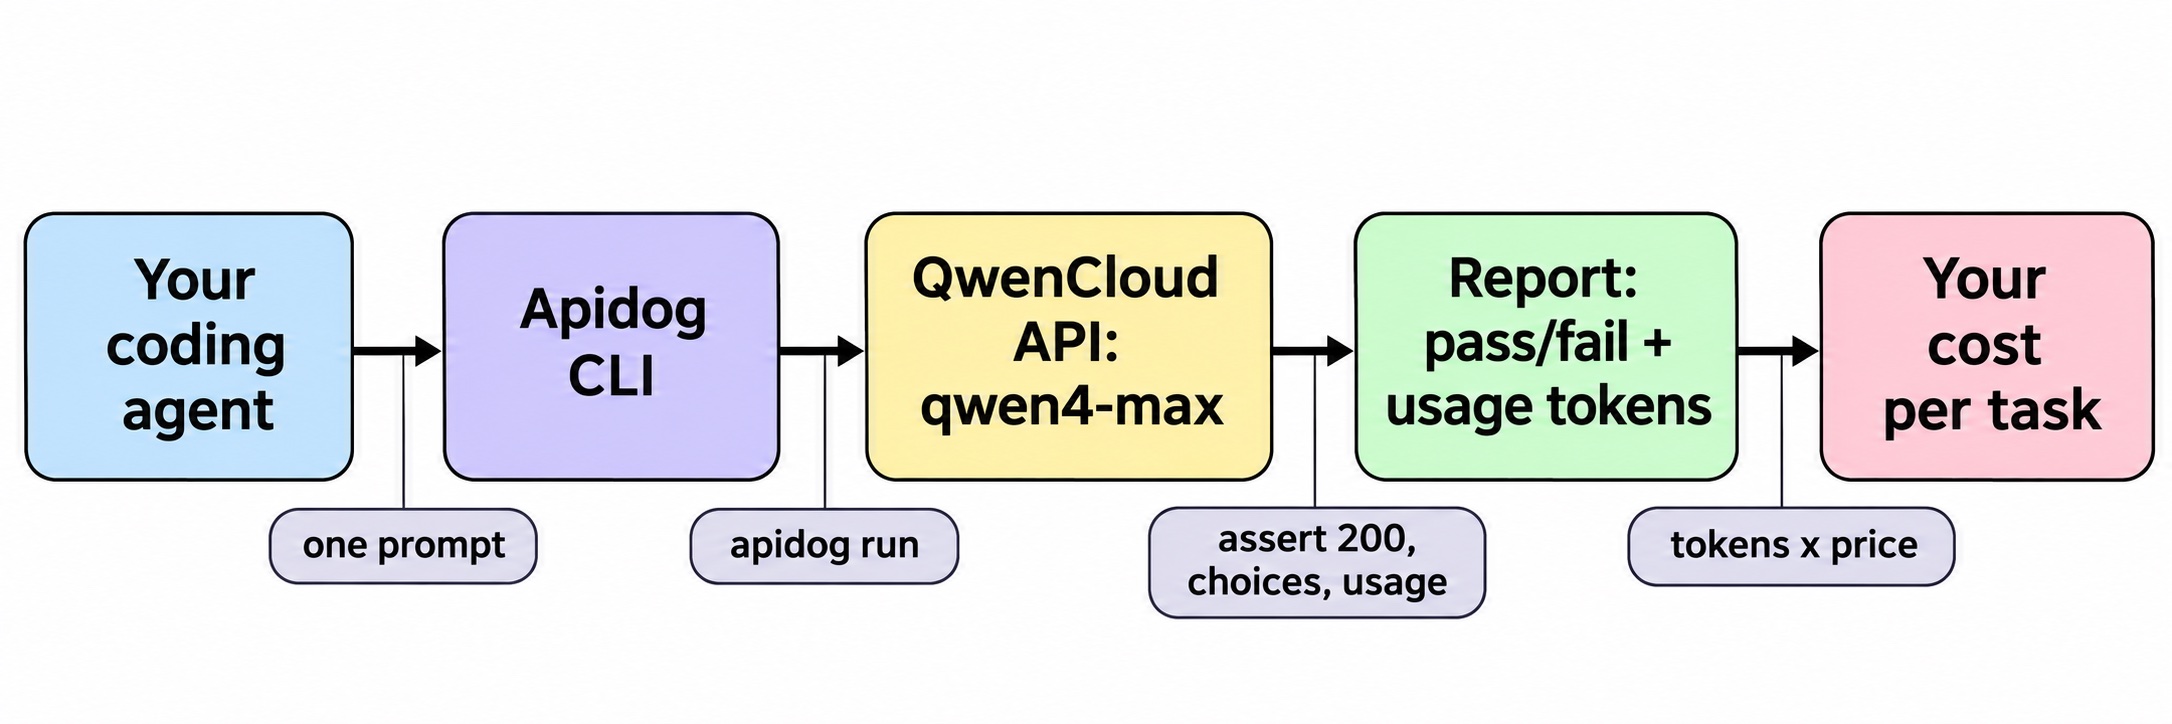
Deja que tu agente de programación haga la configuración con Apidog CLI. Instálalo una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install enseña a tu agente el CLI; la guía de instalación cubre los tokens. Luego dale un solo prompt:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
El agente comprueba la forma de cada payload antes de escribir nada. Cada flag de abajo proviene de apidog <command> --help en Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d ejecuta una iteración por cada fila de tu archivo de prompts, y --env-var pasa la clave en tiempo de ejecución, de modo que nunca queda guardada en el proyecto. El agente lee cada bloque usage del reporte JSON en apidog-reports. Multiplica los tokens de prompt por $1.50 y los tokens de finalización por $4.50 por millón, y tendrás tu propio coste por tarea para comparar con los $1.67 de Alibaba.
Cambia el entorno para ejecutar el mismo conjunto contra tu modelo actual, y repítelo dos o tres veces para ver la variabilidad que la gráfica de lanzamiento no muestra. La misma línea de apidog run se integra en CI con -r junit; consulta la guía de CI/CD. Para una configuración paso a paso con un agente, consulta Apidog CLI en Claude Code. El plan gratuito de Apidog cubre hasta 4 usuarios.
FAQ
¿Los benchmarks de Qwen4-Max son independientes? En su mayoría, no. Diez de las 16 puntuaciones de la tabla de Alibaba son ejecuciones propias. Seis están citadas de clasificaciones de terceros: APEX-Agents (Mercor), AA-Briefcase y AutomationBench-AA (Artificial Analysis), CodeArena y AgentArena (LM Arena), HLAB-Vals (Vals) y Agents’ Last Exam.
¿Qué es Work360? El benchmark propio de Alibaba para tareas industriales complejas en 26 dominios. Qwen4-Max obtuvo 52.69 frente a 47.74 de Qwen3.8-Max; solo esos dos modelos aparecen en su comparación publicada.
¿Cómo le va a Qwen4-Max en Terminal-Bench 4.0? Alibaba reporta 48.5, frente a 38.9, con aproximadamente la mitad de los tokens. Los otros modelos de frontera en la tabla puntúan entre 56.1 y 67.2.
¿Es más barato ejecutar Qwen4-Max que Qwen3.8-Max? En la evaluación de Work360 de Alibaba, el coste medio por tarea bajó de $4.43 a $1.67. Los precios de lista son $1.50 de entrada y $4.50 de salida por millón de tokens. Consulta la guía del Token Plan para opciones de suscripción y Qwen4-Max gratis para rutas sin coste.
¿Qué es Live Delivery en el lanzamiento de Qwen4-Max? Un flujo de trabajo de agente que entrega una primera versión utilizable pronto y la mejora mientras tú la diriges. No es un benchmark. Nuestra guía del plugin Qwen Live Delivery lo cubre.