
Alibaba lanzó Qwen 3.8-Max a principios de agosto de 2026, y si ya estás ejecutando qwen3.7-max en producción, tienes una decisión importante que tomar. El nuevo modelo presenta grandes mejoras en los benchmarks de agentes y de investigación, añade entrada de imágenes, se lanza a un precio de lista más bajo y viene con una promesa que Alibaba nunca hizo para su predecesor: pesos abiertos.
Pero la decisión no es tan simple como "el nuevo modelo gana". Qwen 3.7-Max tiene actualmente un descuento del 50% por tiempo limitado que lo hace más barato que 3.8-Max en términos absolutos. Algunas diferencias en los benchmarks son dramáticas. Otras son prácticamente nulas. Este artículo revisa cada cambio importante para que puedas decidir si cambiar ahora, esperar o bajar de nivel por completo.
Si primero quieres una visión completa del nuevo modelo, comienza con nuestro explicador de Qwen 3.8-Max. Para obtener información sobre el modelo insignia saliente, consulta lo que Qwen 3.7 aportó.
Una nota sobre la metodología antes de los números. Cada cifra de benchmark a continuación proviene de la propia tabla de Alibaba en la publicación oficial de lanzamiento de Qwen 3.8. Esto es realmente útil aquí: ambos modelos fueron evaluados en la misma ejecución del proveedor, por lo que las diferencias son internamente consistentes, incluso si la verificación independiente aún está pendiente. La mayoría de las filas de codificación se ejecutaron en el arnés Claude Code, y varios benchmarks son internos de Qwen.
La versión corta
| Qué cambió | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| Precio de lista (por 1M de tokens) | $2.5 entrada / $7.5 salida | $2 entrada / $6 salida |
| Precio actual (promoción) | $1.25 entrada / $3.75 salida | $2 entrada / $6 salida |
| Entrada de imagen | No | Sí |
| Arquitectura divulgada | No divulgada | 2.4T total, 95B MoE activa |
| Pesos abiertos | Nunca lanzados | Prometidos “la próxima semana” (~10 de agosto) |
| Ventana de contexto | 1M tokens | 1M tokens |
Ahora los detalles.
Diferencias en los benchmarks: dónde el salto es real
Las mejoras destacadas se agrupan en torno al trabajo de agente: tareas de largo horizonte donde el modelo planifica, ejecuta y se autocorrige.
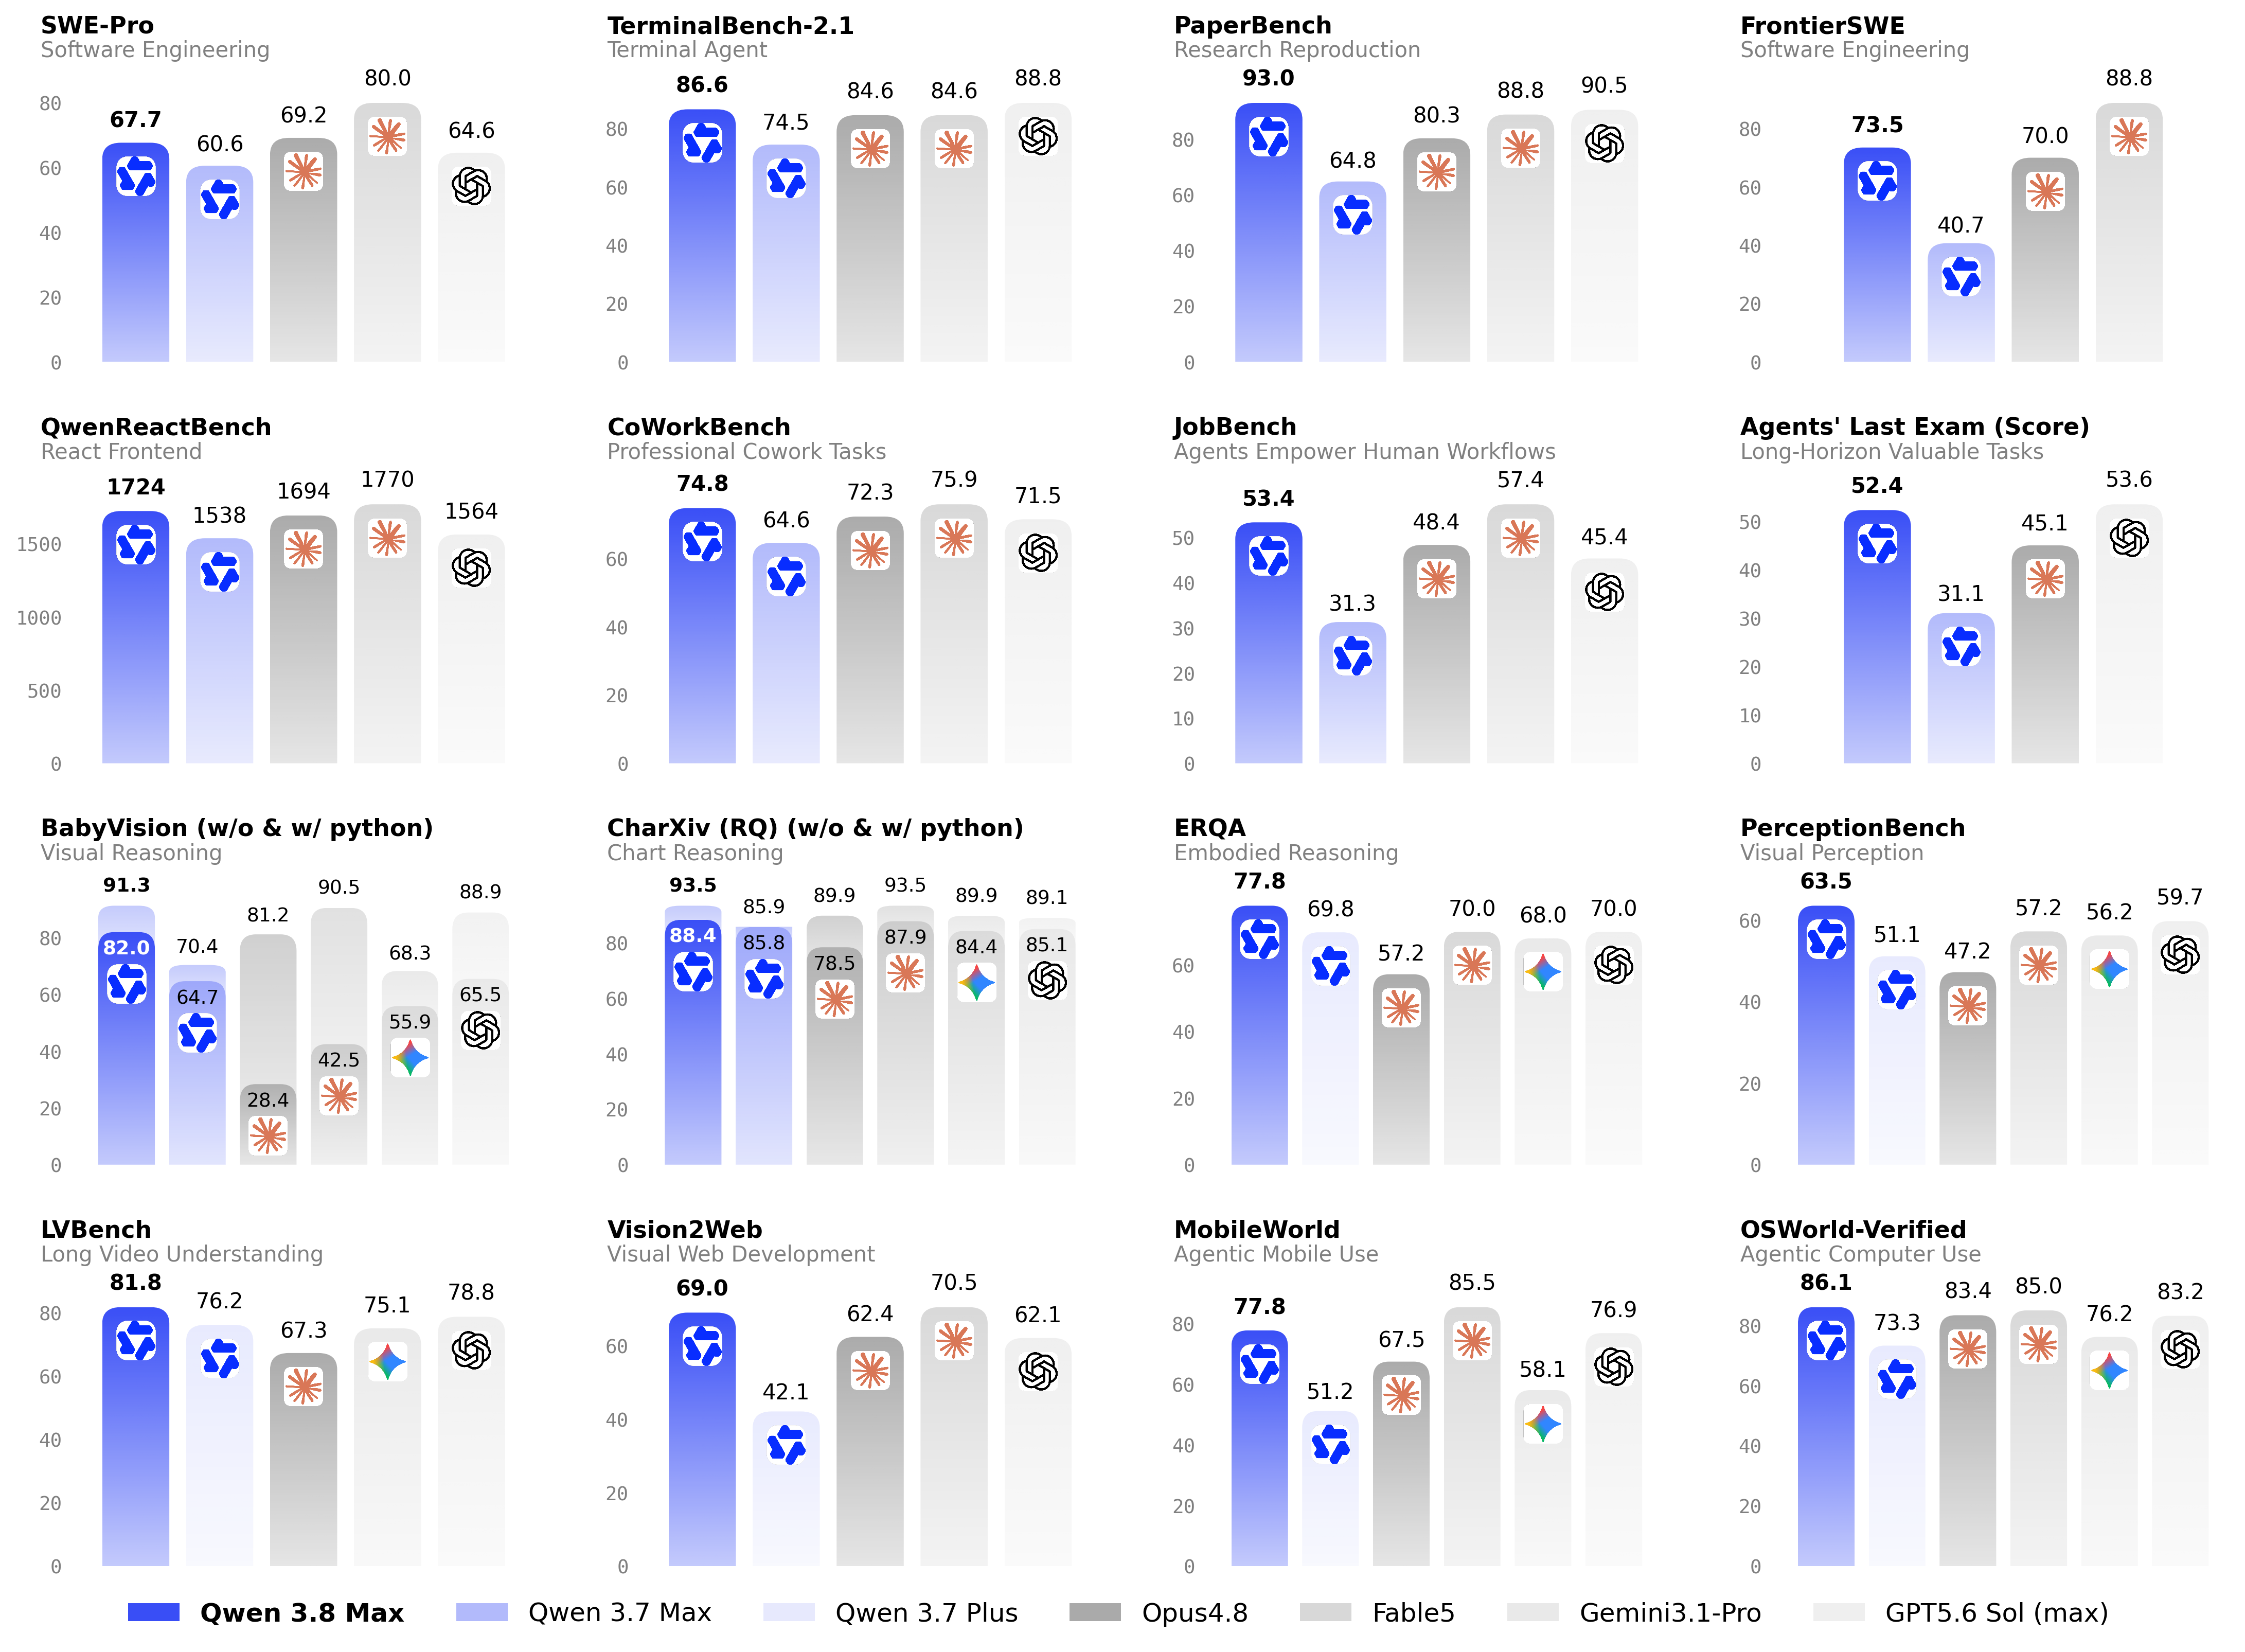
Terminal Bench 2.1: 74.5 a 86.6. Este es un salto de 12 puntos en tareas de agente impulsadas por terminal, y mueve a Qwen de estar claramente rezagado a ser genuinamente competitivo. En la misma tabla, Alibaba califica a Claude Opus 4.8 y Fable 5 con 84.6 cada uno, lo que sitúa a 3.8-Max por delante de ambos en esta fila. GPT-5.6 Sol sigue liderando con 88.8.
SWE-bench Pro: 60.6 a 67.7. Una ganancia de 7 puntos en tareas de ingeniería de software del mundo real. Significativo, pero seamos honestos: Fable 5 se sitúa en 80.0 en la misma tabla, por lo que esto es ponerse al día, no superar. Si el rendimiento en SWE-bench Pro es tu criterio de compra principal, la frontera aún reside en otro lugar.
PaperBench: 64.8 a 93.0. La mayor diferencia en la tabla, un salto de 28 puntos en la reproducción de artículos de investigación de IA. También es la mejor fila insignia de 3.8-Max, por delante de todos los rivales en la comparación de Alibaba. Si tu carga de trabajo implica reproducción de investigación, documentos técnicos largos o razonamiento científico de varios pasos, este es el número que debería llamar tu atención.
IFBench: 79.1 a 82.8. El seguimiento de instrucciones mejora en casi 4 puntos. Cabe destacar que 3.7-Max ya era fuerte aquí (79.1 superó a Opus 4.8 y Fable 5 en la misma ejecución), por lo que esto extiende un liderazgo existente en lugar de corregir una debilidad.
GPQA Diamond: 92.4 a 92.6. Prácticamente sin cambios. Las preguntas y respuestas científicas de nivel de posgrado ya estaban cerca de la saturación para 3.7-Max, y el nuevo modelo no lo mueve. Si tu carga de trabajo se asemeja a GPQA, la actualización no te aporta nada en calidad.
HLE: 41.4 a 43.6. El Último Examen de la Humanidad mejora 2 puntos, pero aún se queda por detrás de la frontera: Fable 5 obtiene 53.3 y GPT-5.6 Sol obtiene 47.2 en la misma tabla. Qwen 3.8-Max cierra brechas en muchos lugares. Este no es uno de ellos.
El patrón: ganancias masivas en benchmarks de agentes y de investigación, ganancias incrementales en el seguimiento de instrucciones, ningún movimiento en benchmarks de conocimiento saturados y una brecha persistente en las evaluaciones de razonamiento más difíciles. Para una revisión más profunda de la tabla completa, incluyendo la letra pequeña sobre arneses y benchmarks internos, consulta nuestro análisis de benchmarks de Qwen 3.8.
Arquitectura: Alibaba finalmente muestra sus números
Qwen 3.8-Max es un modelo mezcla de expertos con 2.4 billones de parámetros y 95B de parámetros activos por pasada hacia adelante, construido sobre la base arquitectónica de Qwen 3.5. Eso es aproximadamente una relación de activación del 4%, lo cual es importante para los costos de servicio: pagas el cómputo por 95B, no por 2.4T.
El contraste con 3.7-Max es la divulgación misma. Alibaba nunca publicó cifras de escala comparables para Qwen 3.7-Max. Recuentos de parámetros, relaciones de activación, configuración de expertos: todo sin revelar. Con 3.8-Max, la documentación del modelo de Model Studio y la publicación de lanzamiento detallan la arquitectura, lo que hace que la planificación de capacidad y el modelado de costos sean mucho menos un juego de adivinanzas.
Para poner en contexto la carrera de pesos abiertos: Kimi K3 tiene un total de 2.8T con 104B activos. Qwen 3.8-Max es más pequeño en ambos ejes.
Multimodal: la capacidad que 3.7-Max nunca tuvo
Qwen 3.7-Max es un modelo de texto. Qwen 3.8-Max acepta entrada de imágenes de forma nativa, y Alibaba publicó una tabla de benchmarks multimodales separada donde lidera la mayoría de las filas frente a Gemini 3.1 Pro y GPT-5.6 Sol.
Las puntuaciones destacadas de la tabla multimodal de Alibaba: MathVision con 95.2, LogicVista con 91.9 y OSWorld-Verified con 86.1 para tareas de uso de computadora. No hay una columna para 3.7-Max en esa tabla para comparar, porque no podría haberla: el modelo anterior no admite imágenes.
En la práctica, esto significa que las cargas de trabajo que antes tenías que dirigir a un modelo de visión separado (comprensión de capturas de pantalla, imágenes de documentos, automatización de UI, extracción de gráficos) ahora pueden ejecutarse con la misma ID de modelo que tu tráfico de texto. La publicación de lanzamiento también demuestra la comprensión de documentos largos y videos, aunque esas son capacidades demostradas en el blog en lugar de tipos de entrada de API distintos, por lo que debes verificar la documentación de la API para tu caso específico.
Precios: el nuevo modelo es más barato, excepto ahora mismo
Aquí es donde las matemáticas de la actualización se ponen interesantes.
Qwen 3.8-Max se lanza con un precio de $2 entrada / $6 salida por 1M de tokens, un único nivel fijo en todo el contexto de 1M. Qwen 3.7-Max tiene un precio de lista de $2.5 / $7.5. Así, el nuevo modelo, más capaz, reduce el precio de lista de su predecesor en un 20%. Eso casi nunca ocurre en un cambio de generación de un modelo insignia.
Pero hay un detalle: Alibaba está ofreciendo actualmente una promoción del 50% por tiempo limitado en 3.7-Max, lo que reduce su tarifa efectiva a $1.25 / $3.75. A los precios de hoy, el modelo anterior cuesta un 38% menos que el nuevo. Todas las tarifas se encuentran en la página oficial de precios de Model Studio.
Dos cosas a tener en cuenta:
- La promoción puede terminar. Alibaba la etiqueta como por tiempo limitado y no ha publicado una fecha de finalización. Si tu arquitectura se basa en $1.25 / $3.75, tu suposición de presupuesto tiene un vencimiento que no puedes ver. A precios de lista, 3.8-Max es el modelo más barato.
- Los tokens de pensamiento inflan las facturas reales. Qwen 3.8-Max por defecto usa
reasoning_effort: xhigh, y los tokens de pensamiento se facturan como salida. Tu costo efectivo por solicitud puede ser muy superior a lo que sugiere la etiqueta. Nuestra guía de precios de Qwen 3.8 explica la economía del caché y el cálculo del costo por tarea.
Y si ningún modelo Max se ajusta a tu presupuesto, qwen3.7-plus a $0.4 / $1.6 (actualmente con un 20% de descuento) sigue siendo la opción de valor. La comparación Plus vs Max cubre cuándo Plus es suficiente.
Pesos abiertos: una novedad para la clase Max
Ningún modelo de la clase Qwen-Max ha entregado pesos abiertos. Qwen 3.7-Max no lo hizo, y Alibaba nunca sugirió que lo haría. Qwen 3.8-Max rompe ese patrón: la publicación de lanzamiento promete pesos en Hugging Face y ModelScope "la próxima semana", lo que apunta aproximadamente al 10 de agosto.
Al momento de escribir esto (3 de agosto de 2026), los pesos no son descargables. Trata la promesa como una promesa. El precedente es alentador: los pesos de Kimi K3 llegaron 11 días después del lanzamiento, y Alibaba tiene un largo historial de pesos abiertos con modelos Qwen más pequeños. Pero una descarga de parámetros de 2.4T es un proyecto de autoalojamiento multinodo incluso cuantificado, por lo que para la mayoría de los equipos el impacto práctico será el acceso alojado por terceros y la presión sobre los precios, no un modelo funcionando en su rack.
Si los pesos abiertos son importantes para tu historia de adquisición o cumplimiento, eso por sí solo puede resolver la cuestión de 3.7 vs 3.8. Un modelo (probablemente) los tendrá. El otro nunca los tendrá.
Lo que no cambió
Vale la pena decirlo claramente, porque las publicaciones de actualización tienden a exagerar:
- Ventana de contexto: 1M de tokens en ambos. Sin expansión. Si elegiste 3.7-Max por su contexto largo, 3.8-Max mantiene la línea en el mismo 1M con un precio fijo en toda la ventana.
- Ruta de acceso: la misma. Ambos modelos se sirven a través de Alibaba Cloud Model Studio con endpoints compatibles con OpenAI. El cambio es una modificación de la ID del modelo (
qwen3.7-maxaqwen3.8-max), no un proyecto de migración. 3.8-Max añade además una superficie de API compatible con Anthropic, lo cual vale la pena probar en un cliente como Apidog si tu herramienta utiliza ese protocolo. - Controles de razonamiento: ahora oficiales.
reasoning_effortes un parámetro documentado y compatible en 3.8-Max con tres niveles (xhigh por defecto, medium, low), junto conenable_thinkingypreserve_thinking. Si ajustaste tus prompts en torno al comportamiento de razonamiento implícito en 3.7-Max, ahora obtienes un control explícito en su lugar.
¿Deberías actualizar? Tres caminos honestos
Actualiza ahora si tu carga de trabajo es de agentes o intensiva en investigación. Las diferencias en Terminal Bench (74.5 a 86.6) y PaperBench (64.8 a 93.0) son el tipo de salto que puedes sentir en producción, y obtienes entrada de imágenes más un precio de lista más bajo como bonificación. Si estás creando agentes que operan terminales, reproducen trabajo técnico o procesan capturas de pantalla, el caso es claro.
Aprovecha la promoción de 3.7-Max si tu carga de trabajo se encuentra en las zonas de estabilidad. Las tareas de conocimiento tipo GPQA se movieron 0.2 puntos. Si tu tráfico es de preguntas y respuestas, resumen o chat general, y 3.7-Max ya cumple con tu estándar de calidad, $1.25 / $3.75 es la mejor oferta por token que cualquier modelo Max ha ofrecido. Configura un recordatorio mensual para revisar el estado de la promoción, y ten en cuenta que tu precio de reserva es 3.8-Max a $2 / $6, no 3.7-Max a precio de lista.
Baja a qwen3.7-plus si te guías por el precio y tus tareas son rutinarias. Con $0.4 / $1.6, es 5 veces más barato que 3.8-Max en entrada, y para clasificación, extracción y generación basada en plantillas, la capacidad de la clase Max a menudo es un gasto innecesario.
Prueba el cambio antes de comprometerte
Los benchmarks de los proveedores, incluso los internamente consistentes, no predicen cómo se comporta un modelo con tus prompts. La forma más económica de resolver esto es una comparación lado a lado con tu carga de trabajo real.
En Apidog, puedes configurar esto en pocos minutos: apunta una colección al endpoint compatible con OpenAI de Model Studio, luego crea dos entornos que solo difieran en la variable de ID del modelo, uno configurado como qwen3.7-max y otro como qwen3.8-max. Ejecuta el mismo conjunto de solicitudes en ambos, cambia de entorno con un clic y compara las salidas, la latencia y el uso de tokens desde el visor de respuestas. Dado que ambos modelos comparten la misma superficie de API, una sola colección los cubre a ambos, y puedes guardar prompts de producción representativos como escenarios de prueba y volver a ejecutarlos cada vez que Alibaba lance una actualización o cambien los precios promocionales.
Eso convierte la pregunta "¿deberíamos actualizar?" de un debate de benchmarks en una tarde de pruebas. Descarga Apidog gratis y ejecuta la comparación con tu propio tráfico antes de cambiar una configuración de producción.
Preguntas frecuentes
¿Es Qwen 3.8-Max más barato que Qwen 3.7-Max?
A precio de lista, sí: $2 / $6 frente a $2.5 / $7.5 por 1M de tokens. A los precios actuales, no: la promoción del 50% por tiempo limitado de 3.7-Max lo reduce a $1.25 / $3.75, lo que lo hace un 38% más barato que 3.8-Max. La promoción no tiene fecha de finalización publicada. Los desgloses completos de costos están en nuestra guía de precios de Qwen 3.8.
¿Necesito cambiar mi código para pasar de qwen3.7-max a qwen3.8-max?
Para un uso básico, no. Ambos modelos se sirven a través de los mismos endpoints de Model Studio compatibles con OpenAI, por lo que cambiar es solo un intercambio de ID de modelo. Puede que quieras establecer reasoning_effort explícitamente, ya que 3.8-Max por defecto usa xhigh y los tokens de pensamiento se facturan como salida. Si envías imágenes, esa es una capacidad exclusiva de 3.8-Max y requiere el formato de mensaje de entrada de imagen estándar.
¿Tiene Qwen 3.7-Max pesos abiertos?
No, y nunca los tendrá, basándose en el historial de Alibaba con esta línea. Qwen 3.8-Max es el primer modelo de la clase Max con pesos abiertos prometidos, esperados en Hugging Face y ModelScope alrededor del 10 de agosto de 2026. A partir del 3 de agosto, aún no son descargables.
¿Es Qwen 3.8-Max mejor que Claude o GPT ahora?
Depende de la fila, y recuerda que estos son los propios números de Alibaba. En su tabla, 3.8-Max supera a Opus 4.8 y Fable 5 en Terminal Bench 2.1 y lidera a todos en PaperBench e IFBench. Se queda muy por detrás de Fable 5 en SWE-bench Pro (67.7 frente a 80.0) y de todos los modelos de vanguardia en HLE. Aún no existen números de benchmarks independientes, así que reserva el juicio final hasta que lleguen las evaluaciones de terceros.