
La pregunta sobre las colecciones de Postman vs la especificación OpenAPI surge cada vez que un equipo crece más allá de un puñado de ingenieros. Abres la colección que escribiste hace seis meses y descubres que describe un endpoint que ahora tiene tres campos requeridos adicionales, dos parámetros obsoletos y una forma de respuesta que ya no coincide con lo que el servidor realmente devuelve. La especificación OpenAPI en Git dice algo diferente. Tu Swagger UI dice otra cosa. Nadie está seguro de cuál es la correcta.
Esa desviación no es un fallo de la herramienta. Es un fallo del flujo de trabajo, y la distinción importa. Postman es una excelente herramienta para la ejecución de solicitudes, la creación de scripts y las pruebas exploratorias. El problema surge cuando los equipos tratan la colección como el contrato de la API en sí, en lugar de como un artefacto derivado de ese contrato.
Por qué las colecciones se desvían en primer lugar
Una colección de Postman es un artefacto centrado en la solicitud. Envías una solicitud, observas la respuesta y la guardas. Con el tiempo, añades scripts previos a la solicitud, sustituciones de variables, aserciones de prueba y estructuras de carpetas que reflejan cómo tu equipo piensa sobre la API, no necesariamente lo que la API especifica formalmente.
Tu especificación OpenAPI, por el contrario, es un artefacto centrado en el contrato. Declara rutas, parámetros, esquemas y tipos de respuesta en un formato legible por máquina a partir del cual las herramientas pueden validar, simular y generar código.
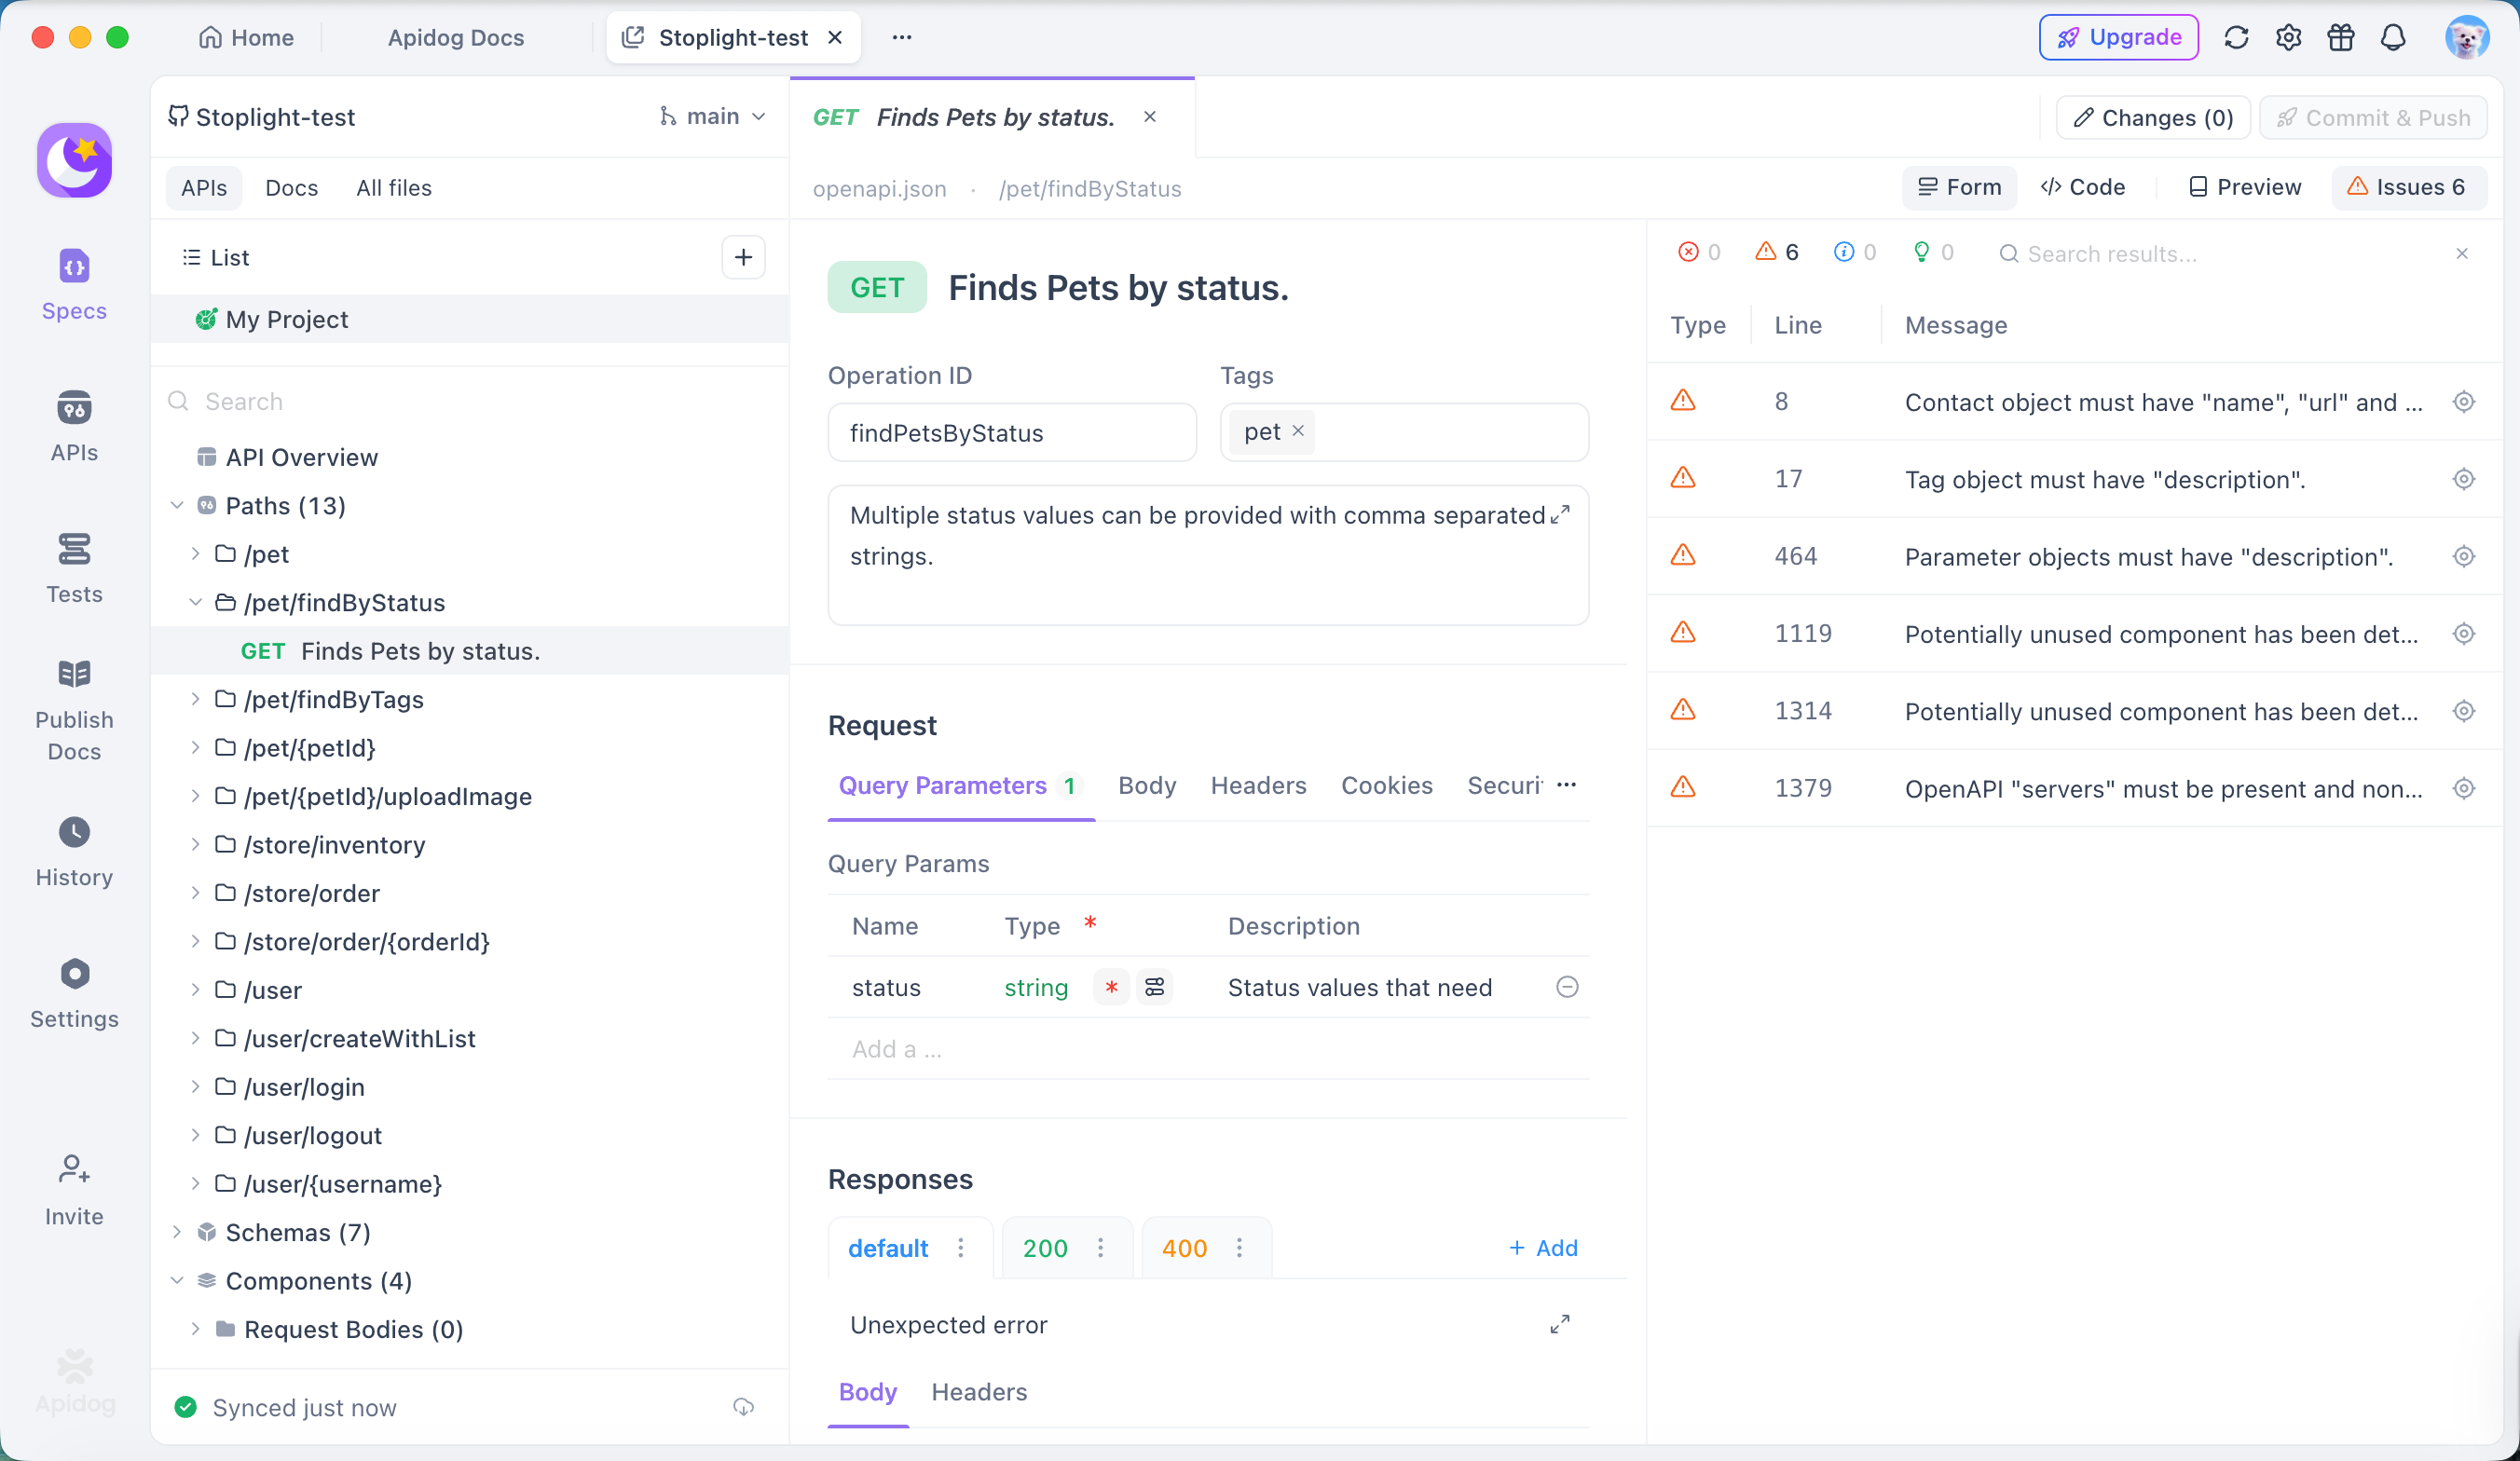
Los dos artefactos responden a preguntas diferentes. La colección responde "¿cómo llamo a este endpoint hoy?". La especificación responde "¿qué se supone que debe hacer esta API?". Cuando los equipos mantienen ambos de forma independiente, inevitablemente divergen. Un desarrollador actualiza la especificación al fusionar una solicitud de extracción (pull request). Otro actualiza la colección cuando nota que una prueba está rota. Nadie los fusiona. En unos pocos meses, tienes dos descripciones parcialmente precisas de la misma API, y ninguna forma fiable de saber cuál está más actualizada.
La evidencia del cliente para este patrón es concreta. Inventis Korea informó exactamente de este problema: su equipo construyó una API, generó una especificación OpenAPI para Swagger, importó la colección a Postman para pruebas y luego dedicó un esfuerzo continuo a mantener tres representaciones sincronizadas. Las pruebas pasaron por alto casos extremos porque la colección no reflejaba el esquema completo. La documentación se desvió porque la especificación no era la entrada para la creación de pruebas. Estos no son casos aislados; son resultados predecibles de un flujo de trabajo centrado en la solicitud a gran escala.
La causa raíz: Postman no está diseñado para ser un almacén de especificaciones
Las colecciones de Postman tienen su propio formato. El esquema de colección de Postman es una estructura JSON propietaria que describe solicitudes, scripts y jerarquías de carpetas. No es OpenAPI. Postman puede importar y exportar OpenAPI, pero la conversión tiene pérdidas en ambas direcciones: de OpenAPI a colección se pierden detalles del esquema que no son expresables como solicitudes; de colección a OpenAPI se pierden scripts y datos que no son expresables como campos de especificación.
Esto no es una crítica a Postman. Es una descripción de para qué sirve realmente la herramienta. Postman es un ejecutor de solicitudes con funciones de colaboración construidas alrededor del modelo centrado en la solicitud. Usarlo como tu descripción canónica de API requiere que impongas una estructura que el formato no fue diseñado para soportar.
Compara las dos representaciones para un único endpoint:
| Propiedad | Colección de Postman | Especificación OpenAPI |
|---|---|---|
| Parámetros de solicitud | Almacenados como pares clave-valor con descripción opcional | Tipados, validados, con campos required y schema |
| Formato de respuesta | Capturado como un ejemplo guardado (opcional) | Definido como un esquema JSON con reutilización de $ref entre rutas |
| Respuestas de error | Añadidas manualmente por solicitud | Enumeradas en responses con components/schemas compartidos |
| Reutilización de esquema | Ninguna; copiar-pegar entre solicitudes | $ref a components/schemas forzado por validadores |
| Contrato legible por máquina | No | Sí; las herramientas pueden generar servidores, clientes, simulaciones |
| Compatible con diff de Git | JSON con IDs opacos; difícil de revisar de forma significativa | YAML; diffs significativos a nivel de línea |
| Lint y validación | No en formato nativo | Spectral, Redocly CLI y otros |
La tabla muestra por qué ocurre la desviación: la colección no puede expresar completamente el contrato, por lo que el contrato reside en otro lugar, y ambos se desincronizan tan pronto como alguien edita uno sin el otro.
Qué significa realmente "spec-first" para un equipo de Postman
"Spec-first" no significa "diseñar todo en YAML antes de escribir cualquier código". Para la mayoría de los equipos que migran de un flujo de trabajo centrado en la colección, significa invertir la dependencia. La metodología "spec-first" coloca el documento OpenAPI en Git como la descripción autoritativa de la API. Cada otro artefacto, incluida la colección que utilizas para las pruebas, se deriva de ese documento, y no al revés.
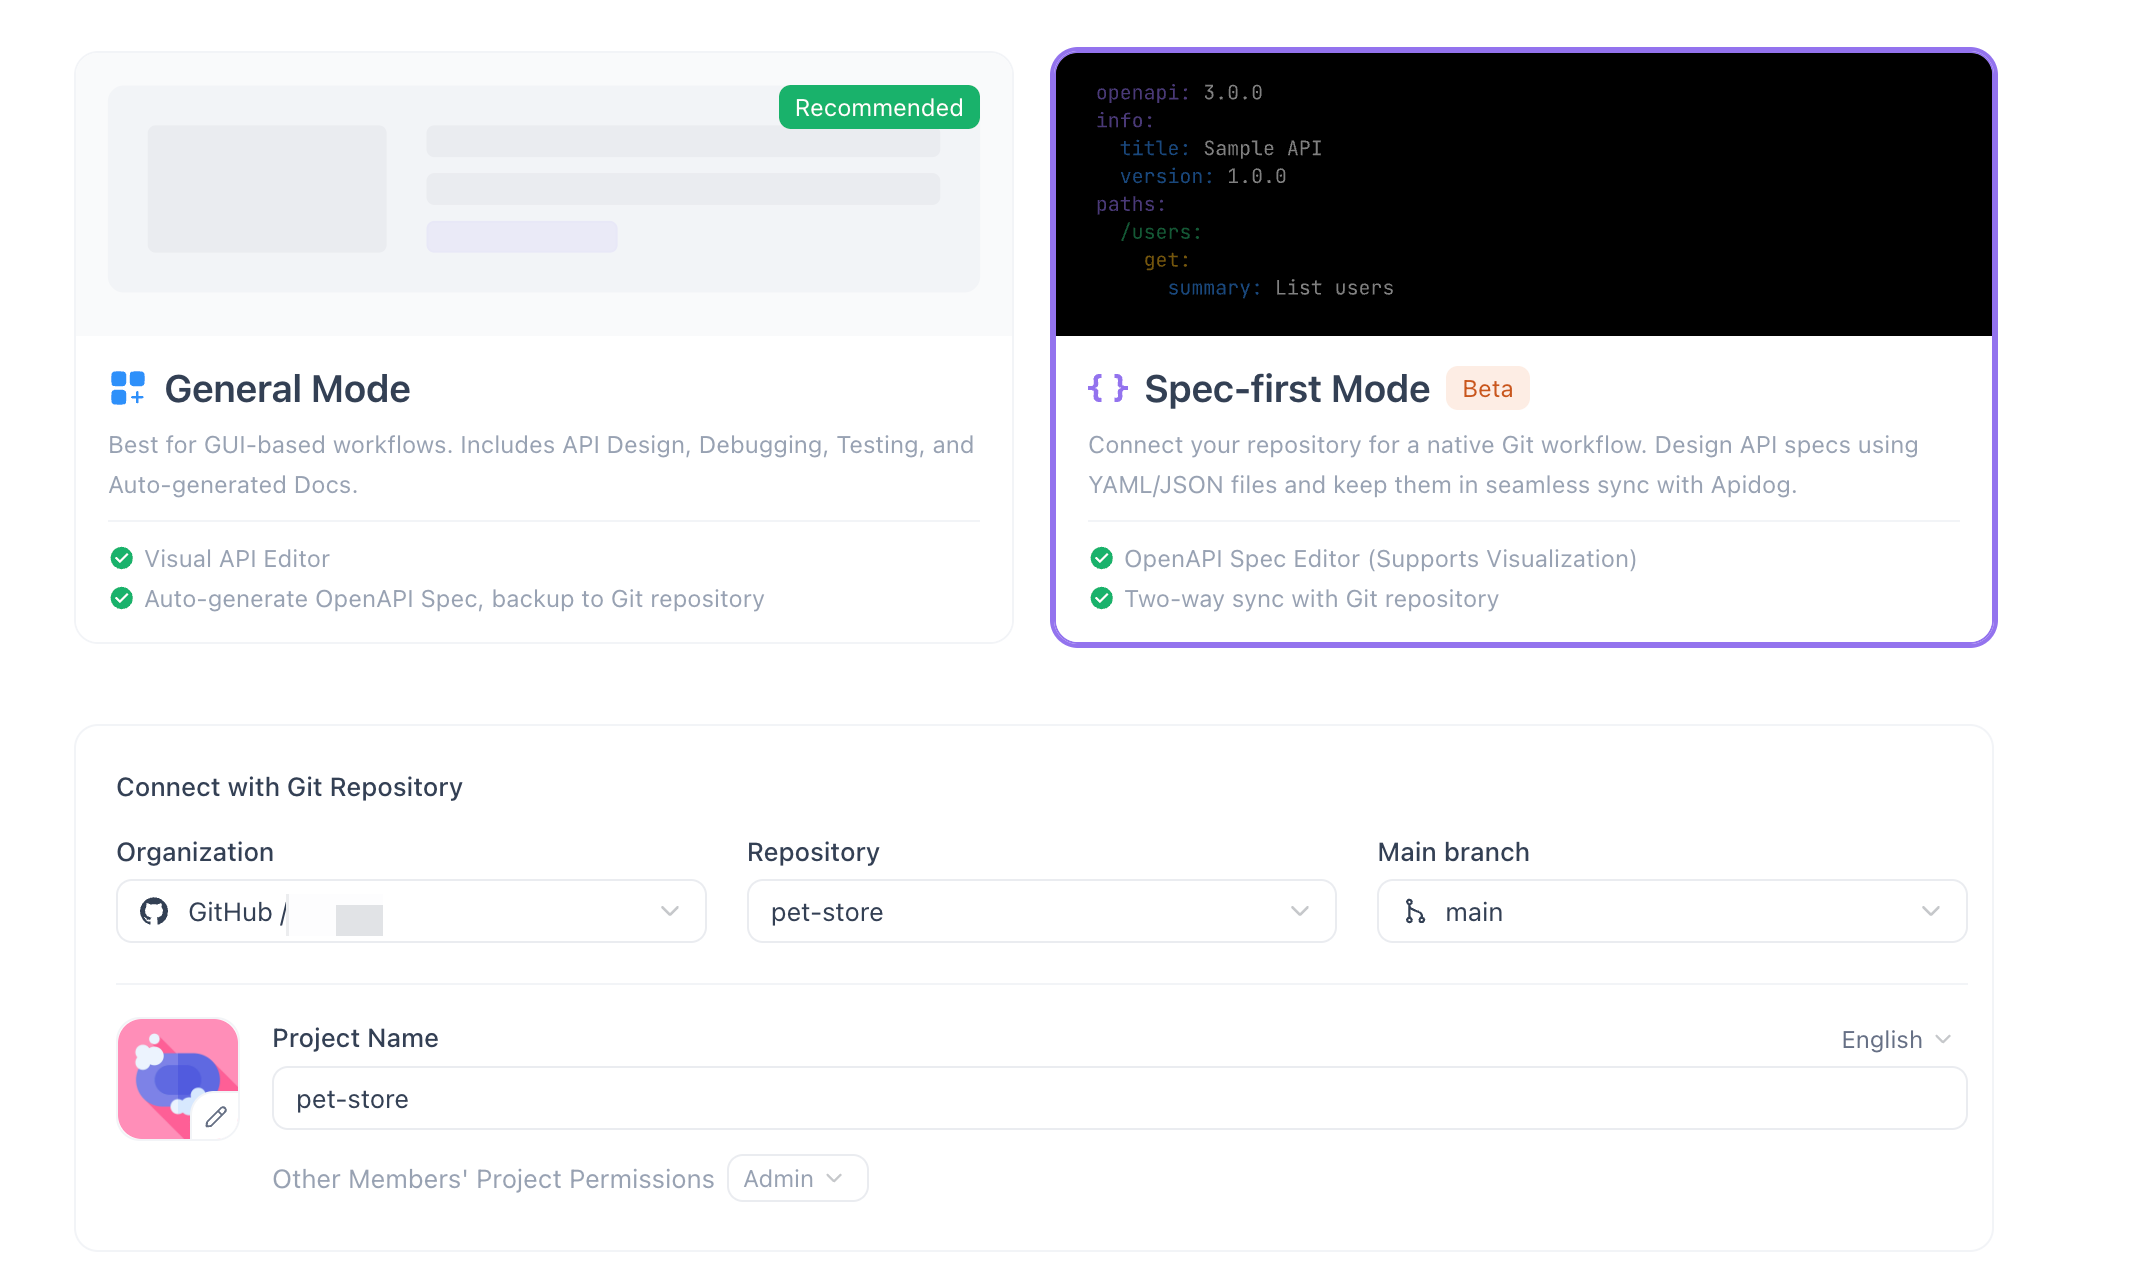
En la práctica, el flujo de trabajo se ve así:
- La especificación se commite a Git y se revisa como parte del proceso de PR.
- Las pruebas, las simulaciones y la documentación se generan a partir de la especificación.
- Cuando la API cambia, la especificación cambia primero. Los artefactos dependientes se actualizan automáticamente o mediante herramientas.
- La colección que tu equipo utiliza para pruebas exploratorias se genera a partir de la especificación, por lo que siempre refleja el contrato actual.
La colección sigue ahí. Tus scripts, pruebas basadas en datos y variables de entorno siguen ahí. La diferencia es que la colección depende de la especificación (downstream), no al revés (upstream). Cuando un nuevo campo aparece en la especificación, aparece en la colección generada. Cuando un campo se elimina de la especificación, la prueba falla porque la solicitud generada ya no lo incluye. La desviación se convierte en un fallo de CI, no en un descubrimiento seis meses después.
Cómo generar colecciones a partir de tu especificación
Existen varias formas de derivar una colección compatible con Postman a partir de una especificación OpenAPI. Aquí te presentamos una que funciona con la CLI de Redocly:
# Install Redocly CLI
npm install -g @redocly/cli

# Validate the spec first
redocly lint openapi/petstore.yaml

# Bundle the spec (resolve $ref chains)
redocly bundle openapi/petstore.yaml -o dist/petstore-bundled.yaml

# Convert to Postman collection v2.1 using the openapi-to-postmanv2 library
npm install -g openapi-to-postmanv2

openapi2postmanv2 \
  --spec dist/petstore-bundled.yaml \
  --output dist/petstore-collection.json \
  --prettyPrint
El resultado es un JSON de colección estándar de Postman. Lo importas a Postman o lo usas como colección base en Newman o la CLI de Postman. Tus scripts previos a la solicitud y variables de entorno permanecen como archivos separados que mantienes de forma independiente; no se sobrescriben cuando regeneras la colección a partir de una especificación actualizada.
Puedes integrar esto en CI para que la colección siempre se regenere a partir de la especificación antes de que se ejecuten las pruebas:
# .github/workflows/api-tests.yml
name: API contract tests

on:
  push:
    paths:
      - "openapi/**"
      - "src/**"

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Install dependencies
        run: |
          npm install -g @redocly/cli openapi-to-postmanv2 newman

      - name: Validate OpenAPI spec
        run: redocly lint openapi/petstore.yaml

      - name: Generate collection from spec
        run: |
          redocly bundle openapi/petstore.yaml -o dist/petstore-bundled.yaml
          openapi2postmanv2 \
            --spec dist/petstore-bundled.yaml \
            --output dist/petstore-collection.json

      - name: Run tests against generated collection
        run: |
          newman run dist/petstore-collection.json \
            --environment config/env-staging.json \
            --reporters cli,junit \
            --reporter-junit-export results/test-results.xml

      - name: Upload test results
        uses: actions/upload-artifact@v4
        with:
          name: test-results
          path: results/
Con este patrón, la especificación es la entrada para cada ejecución de prueba. Un cambio en la especificación que rompa una prueba se detecta en la misma PR que cambió la especificación.
Dónde encaja Apidog en este flujo de trabajo
El valor de Apidog no es que reemplace a Postman como ejecutor de solicitudes. Es que conecta la especificación OpenAPI con todos los demás artefactos con los que trabaja tu equipo, sin el paso de conversión manual. La especificación en Git sigue siendo la fuente de la verdad; Apidog es la capa de colaboración y ejecución sobre ella.
El Modo "Spec-First" de Apidog (actualmente en beta) te permite sincronizar una especificación OpenAPI desde un repositorio Git directamente en un espacio de trabajo de Apidog. A partir de esa especificación sincronizada, obtienes simulaciones auto-generadas, documentación interactiva y escenarios de prueba, todo actualizado automáticamente cuando la especificación cambia en Git. No mantienes una colección separada junto a la especificación; la especificación impulsa lo que Apidog muestra y ejecuta.
Esto es importante para los equipos que experimentan lo que describieron STC Group y el Foro Económico Mundial: mantener Postman para pruebas, una herramienta de documentación separada para la renderización de especificaciones y un servidor de simulación para el desarrollo frontend, tres sistemas que necesitan reflejar el mismo contrato de API. Cuando la especificación cambia, la actualizas en un solo lugar y las tres superficies se actualizan. Vale la pena verificar en una prueba si los permisos de espacio de trabajo de Apidog y la granularidad de SSO cumplen con tus requisitos específicos de control de acceso, particularmente para equipos grandes como el despliegue de DHL descrito (más de 100 usuarios). Esas son preguntas de evaluación significativas para una prueba de concepto.
Para la ruta de migración, puedes convertir tus colecciones existentes de Postman a Apidog como punto de partida, y luego hacer de la especificación el documento canónico en adelante. El paso de importación mecánica se cubre en detalle en la guía enlazada.
Tratando la especificación como código en tu flujo de trabajo Git
El enfoque "api-spec-as-code" significa que el documento OpenAPI recibe el mismo tratamiento que el código de aplicación: solicitudes de extracción (pull requests), revisión de código, linting en CI y etiquetas de versión en los límites de lanzamiento. La mayoría de los equipos descubren que ya tienen la infraestructura para esto; el paso que falta es aplicarlo al archivo de especificación.
Algunas prácticas que ayudan:
- Almacena la especificación en el mismo repositorio que el servicio que describe, no en un repositorio de "documentos" separado. Esto asegura que los cambios en la especificación ocurran en la misma PR que los cambios en el código.
- Añade un paso de linting de Spectral a tu pipeline de CI. Spectral valida la especificación contra la especificación OpenAPI y cualquier regla personalizada que tu equipo defina. Referencias de esquema rotas, descripciones faltantes y nombres inconsistentes se convierten en fallos de CI, no en comentarios de revisión.
- Utiliza el desarrollo de especificaciones basado en ramas para cambios que rompan la compatibilidad, de la misma manera que harías branching en el código de aplicación. Los espacios de trabajo de Apidog soportan el branching en la especificación, de modo que diferentes equipos pueden trabajar contra una rama estable mientras un cambio disruptivo está en revisión.
- Fija las versiones de las especificaciones en los repositorios de consumidores downstream. Cuando el servicio B depende de la especificación del servicio A para las pruebas de contrato, debe hacer referencia a una etiqueta de versión específica, no al HEAD de `main`.
Este enfoque se cubre en profundidad en la guía de flujo de trabajo de API nativo de Git si deseas una configuración paso a paso para un nuevo proyecto.
Preguntas Frecuentes
¿Tengo que dejar de usar Postman por completo?
No. El cambio de metodología se refiere a la dirección de la dependencia, no a la sustitución de herramientas. Puedes seguir usando Postman para pruebas exploratorias y scripting. La diferencia es que tu colección se genera a partir de la especificación antes de cada ejecución de prueba, en lugar de mantenerse como un artefacto separado. Si tu equipo prefiere la interfaz de usuario de Postman para el trabajo exploratorio, esa preferencia es compatible con un flujo de trabajo "spec-first".
¿Qué sucede con nuestros scripts de Postman y variables de entorno existentes?
Tus scripts previos a la solicitud, scripts de prueba y definiciones de variables de entorno no forman parte de la colección generada. Son archivos separados que mantienes de forma independiente. Cuando regeneras la colección a partir de una especificación actualizada, los scripts no se sobrescriben. Mantienes la capa de comportamiento (scripts) mientras que la capa estructural (definiciones de solicitud) siempre se deriva de la especificación.
¿Cómo manejo los endpoints que aún no están en la especificación?
En un flujo de trabajo "spec-first", un endpoint que no está en la especificación no está listo para ser probado. Eso suena estricto, pero es el objetivo: la puerta de la especificación asegura que los nuevos endpoints se describan formalmente antes de que se escriban pruebas para ellos. Para el desarrollo exploratorio, puedes trabajar contra un stub local y añadir la entrada de la especificación como parte de la PR que introduce el endpoint. Consulta la guía de las mejores herramientas de validación de OpenAPI para encontrar herramientas que agilizan el paso de edición "spec-first".
¿Está disponible el Modo "Spec-First" de Apidog ahora?
El Modo "Spec-First" de Apidog está actualmente en beta. Puedes acceder a él a través de Apidog y evaluar si el flujo de trabajo de sincronización con Git, el soporte para ramas y las simulaciones auto-generadas cumplen con los requisitos de tu equipo. Como con cualquier característica beta, vale la pena probarla con tu estructura de especificación específica antes de comprometerte con ella como un flujo de trabajo de producción.
¿Cuál es la diferencia entre esto e importar mi especificación a Postman?
Postman puede importar una especificación OpenAPI y generar una colección a partir de ella. Esa es una conversión única. La colección se mantiene entonces independientemente de la especificación, por lo que la desviación se reanuda inmediatamente. Un flujo de trabajo "spec-first" regenera la colección a partir de la especificación en cada ejecución de CI (o sincronización), por lo que la colección nunca está más de una compilación desactualizada con respecto a la especificación.
Conclusión
El problema de desviación que tu equipo está experimentando no es un error en Postman. Es el resultado predecible de mantener dos descripciones de API parcialmente superpuestas sin una dependencia clara entre ellas. La solución es establecer la especificación OpenAPI en Git como la fuente autoritativa, y tratar la colección de Postman como un artefacto generado a partir de esa especificación.
Esa inversión cambia lo que se rompe y cuándo. Los cambios en la especificación que rompen las pruebas se detectan en la PR que los realizó. La documentación, las simulaciones y los escenarios de prueba permanecen alineados porque todos leen de la misma fuente. La carga de mantenimiento de mantener dos sistemas sincronizados desaparece porque solo hay un sistema.
Descarga Apidog y abre un espacio de trabajo en Modo "Spec-First" con tu especificación OpenAPI existente. Si estás empezando desde una colección en lugar de una especificación, puedes importar la colección como un punto de partida OpenAPI y luego trabajar con un enfoque "spec-forward" desde allí. El flujo de trabajo de sincronización con Git se vuelve concreto una vez que lo ves funcionando con tu propia API, en lugar de un ejemplo artificial.