
El 20 de agosto de 2026, un modelo llamado ox-alpha apareció en plataformas de inferencia de terceros. Sin proveedor, sin anuncio, sin tarjeta de modelo. Tenía una ventana de contexto de 1 millón de tokens y su uso no costaba nada.
En cuestión de días, se convirtió en uno de los modelos más utilizados en esas plataformas. En aproximadamente 48 horas, la comunidad lo había identificado como un modelo de Zhipu. El 26 de agosto, Z.ai lo confirmó: Ox Alpha era GLM-5.3-Flash, y la semana gratuita había sido una prueba deliberada.
Esto es ahora un paso estándar en el lanzamiento de productos, más que una curiosidad. Así es como funciona el patrón, cómo la gente lo identificó y qué significa si eres tú quien consume estos modelos.
La cronología
20 de agosto. ox-alpha aparece en OpenRouter y OpenCode como un modelo anónimo. 1M de contexto, precio cero. Los modelos anónimos no son inusuales en estas plataformas, pero la combinación de una ventana de contexto muy grande y acceso gratuito es una señal fuerte de que alguien está subvencionando algo.
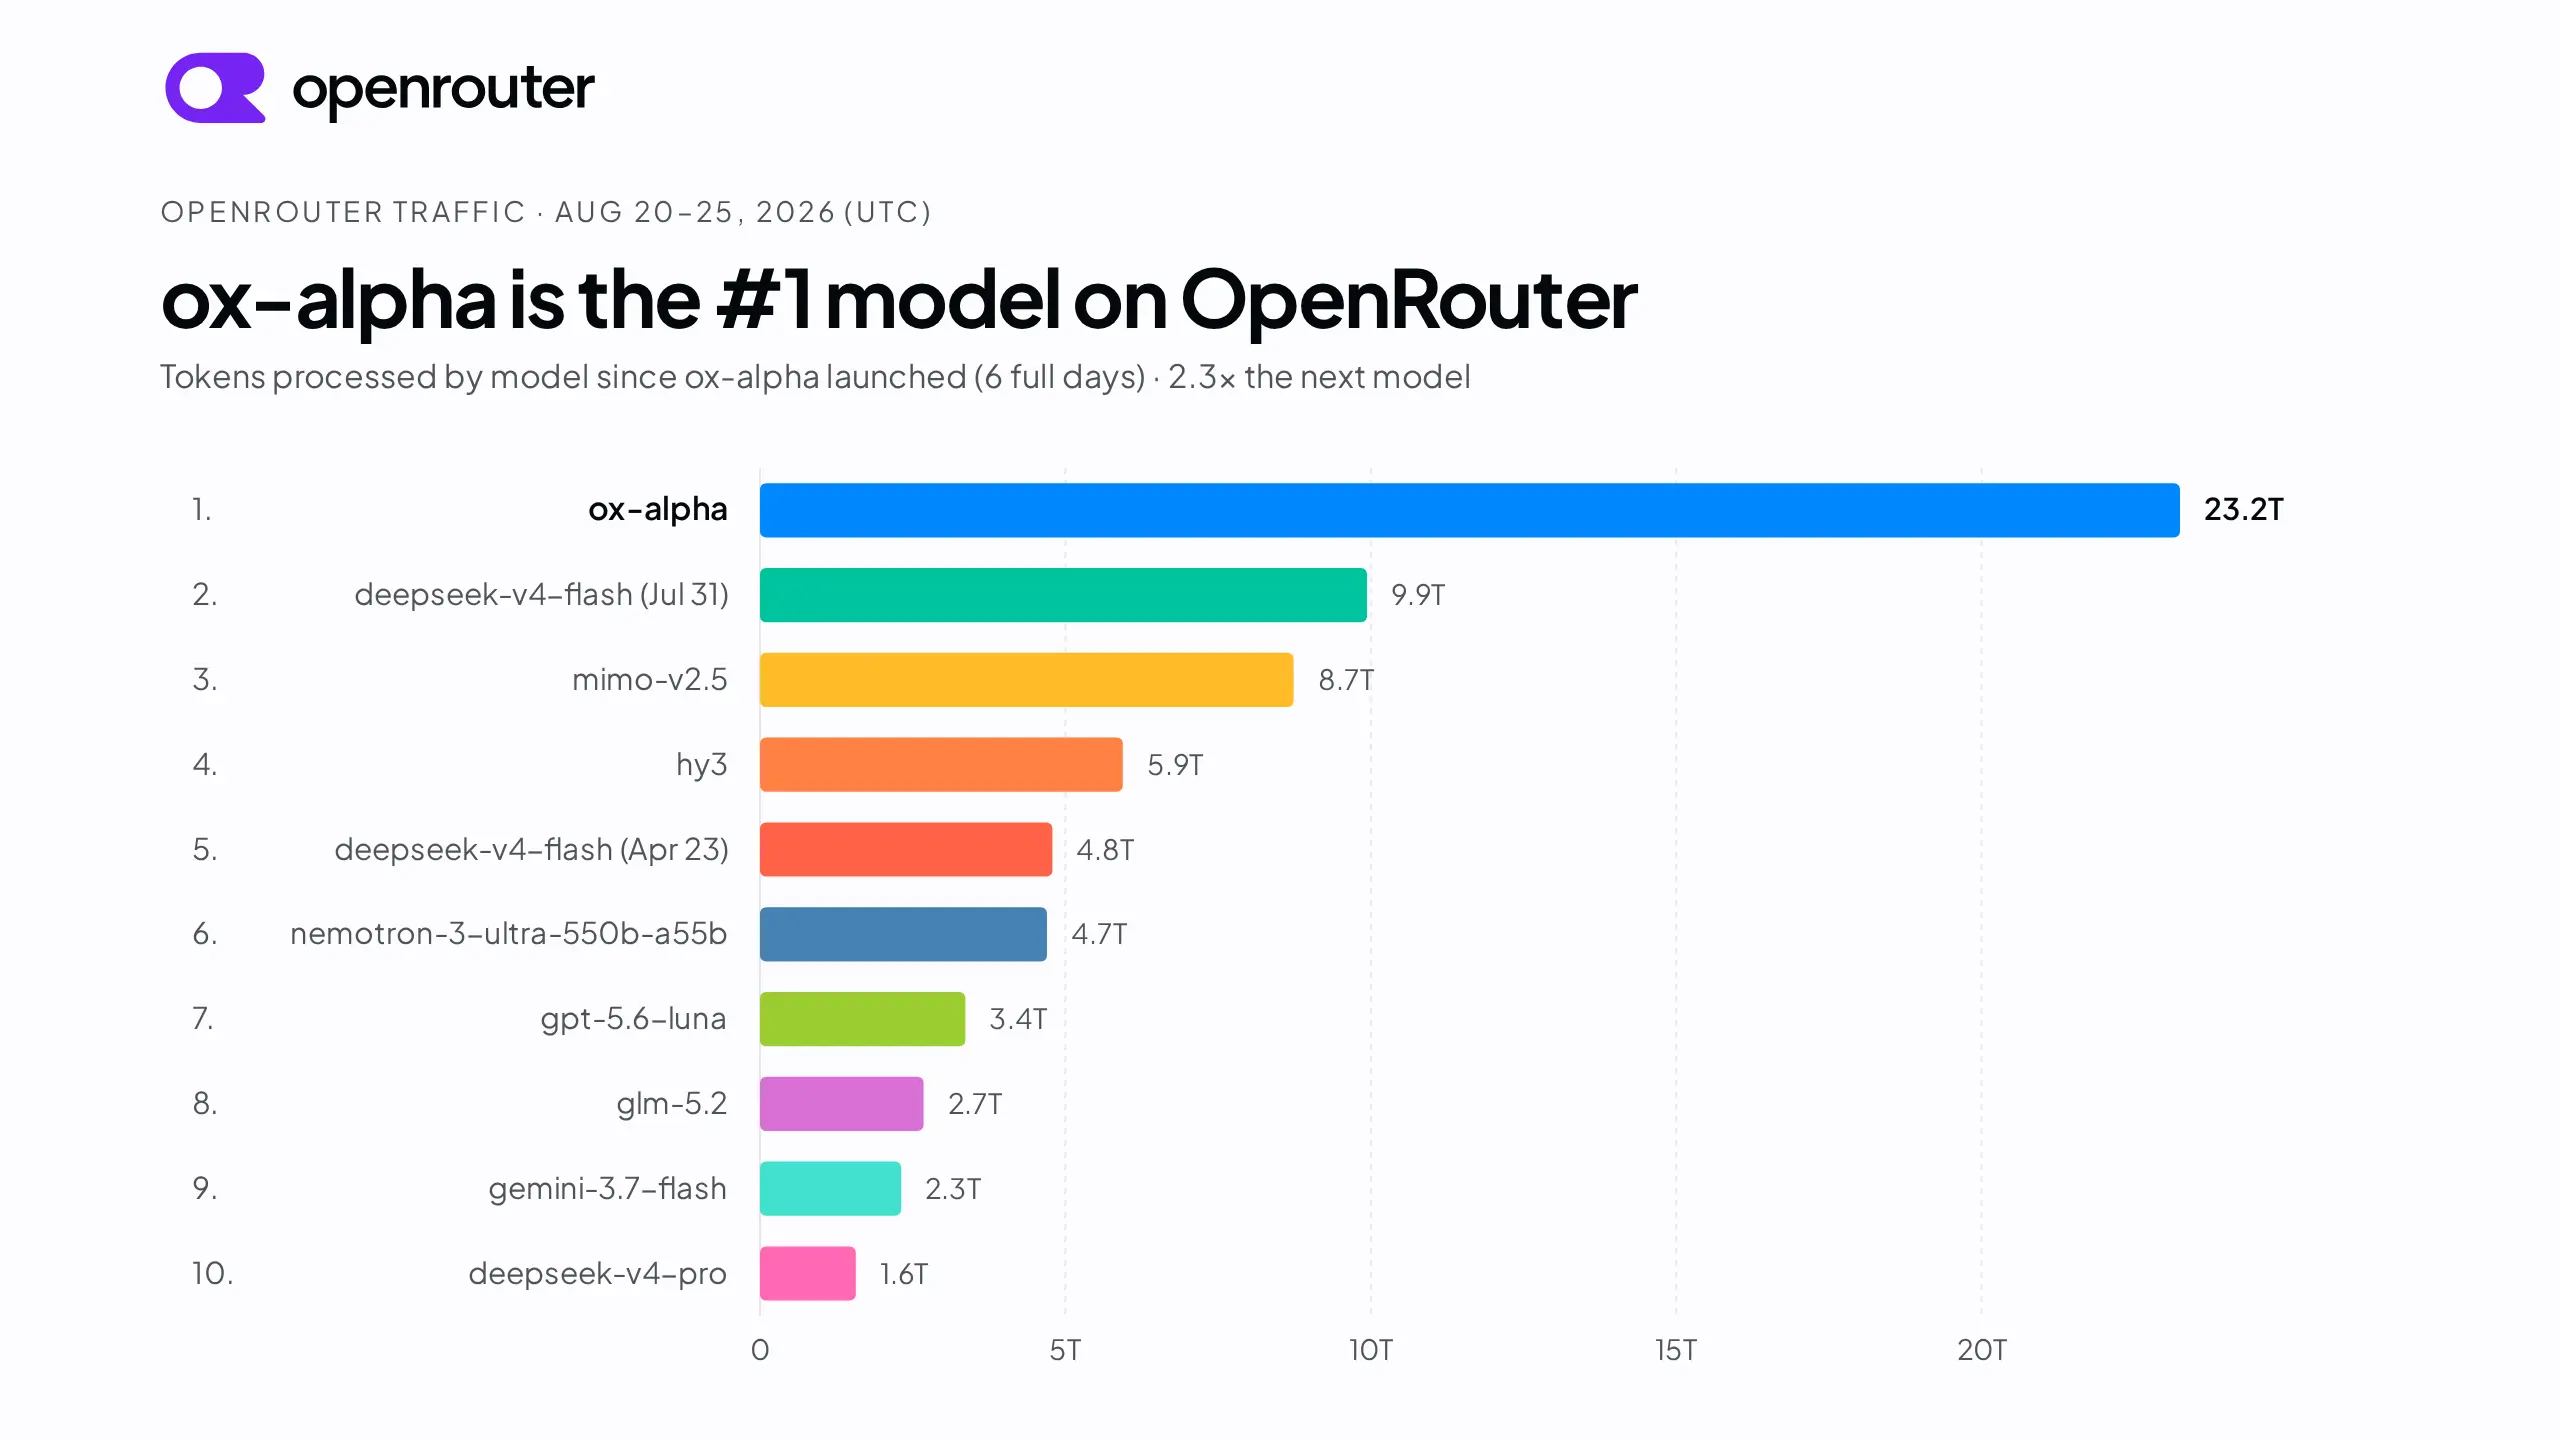
20 al 22 de agosto. El uso aumenta rápidamente. El acceso gratuito a un modelo capaz con contexto largo es fácil de vender, y la comunidad de desarrolladores enruta trabajo real a través de él. Mientras tanto, la gente comienza a investigarlo para averiguar de quién es.
Aproximadamente 48 horas después. El consenso apunta a Zhipu, basándose en las características de salida más que en cualquier divulgación.
26 de agosto. Z.ai anuncia GLM-5.3-Flash y confirma que Ox Alpha era este modelo. La compañía describe la semana gratuita como una prueba intencional.
Cómo identificar un modelo anónimo
Nada de esto requiere acceso especial. Se trata de la coincidencia de patrones en el comportamiento que las familias de modelos llevan consigo.
Comportamiento del tokenizador. Las diferentes familias dividen el texto de manera diferente. Alimente un modelo con cadenas inusuales, secuencias de emojis, escrituras mezcladas, largas secuencias de espacios en blanco, código con sangría inusual, y observe dónde tropieza o cómo se distribuyen los recuentos de tokens. Los tokenizadores se heredan a través de las versiones de una familia y son difíciles de disfrazar.
Autorreportes bajo presión. Los modelos son entrenados con datos que incluyen descripciones de sí mismos. Las preguntas directas obtienen respuestas evasivas o incorrectas, pero las indicaciones oblicuas a menudo revelan rastros de los datos de entrenamiento: frases características, un límite de conocimiento, un estilo de la casa para las negativas.
Estilo de negativa y formato. Cómo un modelo se niega, cómo estructura una lista, si comienza con un preámbulo, si utiliza convenciones de sección particulares. Estos son resultados del post-entrenamiento y tienden a ser consistentes dentro de un laboratorio.
Comportamiento multilingüe. Un modelo entrenado intensamente con datos en chino e inglés se comporta de manera diferente con las indicaciones en chino que uno que trató el chino como un idioma de cola larga. Para un modelo Zhipu, esto es una señal clara.
Forma del benchmark. Ejecute una batería de evaluación rápida y compare el perfil de fortalezas y debilidades con modelos conocidos. Las puntuaciones absolutas importan menos que la forma: qué categorías son fuertes en relación con otras.
Características de servicio. Los patrones de latencia, el rendimiento, los límites de contexto y los parámetros que acepta el endpoint filtran información sobre la pila que lo respalda.
Observamos el mismo proceso cuando Pony Alpha resultó ser un modelo DeepSeek o GLM. La metodología se generaliza.
Por qué los proveedores hacen esto
Un lanzamiento sigiloso consigue cosas que una beta cerrada no puede.
Tráfico real a escala real. Las evaluaciones internas y los probadores amigables producen una pequeña muestra de lo que la gente realmente hace. Una semana de tráfico público abierto revela la cola larga: las indicaciones extrañas, las abusivas, los contextos enormes, los bucles de llamada a herramientas para los que nadie diseñó.
Pruebas de carga honestas. Aprendes lo que hace tu pila de servicio bajo una concurrencia genuina. Z.ai afirma que ejecutó la semana de Ox Alpha enteramente en aceleradores chinos nacionales utilizando una pila basada en SGLang, y asegura que el coste de servicio por token es comparable al hardware principal de NVIDIA. Esa es una afirmación del proveedor sobre su propia infraestructura sin verificación independiente, pero es una afirmación que solo se puede hacer de forma creíble después de servir tráfico real.
Recepción sin marca. La reacción de la gente a "un buen modelo anónimo" es diferente de su reacción a un modelo con un logotipo adjunto. El anonimato elimina los prejuicios de marca en ambas direcciones.
Marketing gratuito al revelarse. Para el día del anuncio, una población de desarrolladores ya había utilizado el modelo y se había formado opiniones positivas. Eso es más persuasivo que cualquier tabla de benchmarks.
El coste es el riesgo de la buena voluntad. Los usuarios que construyeron algo durante una semana gratuita descubren que su dependencia ahora tiene un precio. En este caso, la revelación vino con un descuento de lanzamiento del 50% que se extiende hasta el 9 de septiembre de 2026, lo que suaviza el impacto.
Lo que realmente había detrás del telón
GLM-5.3-Flash es un modelo de mezcla de expertos de 320B parámetros con 18B activos por token, lanzado bajo la licencia MIT con los pesos en Hugging Face. Utiliza atención híbrida lineal y dispersa, soporta 1.048.576 tokens de contexto, y es el primer modelo nativamente multimodal de la serie GLM-5.
Una medición independiente de Artificial Analysis lo sitúa en 57 en el Índice de Inteligencia, frente a 60 para el GLM-5.3 más grande y una mediana de 27 para los modelos de peso abierto de tamaño similar.
La imagen completa se encuentra en nuestra explicación de GLM-5.3-Flash.
Un detalle explica la semana gratuita mejor que cualquier teoría de marketing: Z.ai informa que el modelo utiliza aproximadamente tres veces menos computación de atención que GLM-5.3 y una caché KV aproximadamente 4.4 veces más pequeña. Regalar un modelo tan barato de servir es una apuesta mucho menor que regalar un buque insignia de vanguardia. La economía de la jugada estaba incorporada en la arquitectura.
Lo que esto significa para ti
Los modelos anónimos en los routers suelen ser el buque insignia no lanzado de alguien. Un modelo sin marca con una ventana de contexto inusualmente grande y sin precio no es un proyecto de aficionado. Alguien está pagando por esa inferencia.
El acceso gratuito es temporal por diseño. Si construyes algo durante un período gratuito, espera que llegue el precio. Ox Alpha pasó de ser gratuito a costar 0,15 $ por millón de tokens de entrada en seis días, lo cual es barato pero no es cero.
No pongas modelos sigilosos en producción. Sin tarjeta de modelo, sin garantía de versionado, sin aviso de deprecación, sin soporte. El modelo puede cambiar bajo tus narices o desaparecer. Evaluar uno está bien. Depender de uno no lo está.
Tu evaluación vale más que la revelación. Para cuando llegue el anuncio, es posible que ya tengas una semana de datos reales sobre cómo el modelo maneja tu carga de trabajo. Eso supera cualquier tabla de benchmarks publicada por el proveedor.
Ese último punto solo es válido si realmente capturaste los datos. Las indicaciones ad hoc durante una semana gratuita producen impresiones; un conjunto de pruebas guardado produce evidencia. Mantener tus indicaciones de evaluación como una colección en Apidog, con el ID del modelo y la URL base como variables de entorno, significa que la próxima vez que aparezca un modelo anónimo interesante, podrás apuntar el mismo conjunto de pruebas a él y obtener una comparación en lugar de una sensación. Cuando se revele y se le ponga precio, ya sabrás si vale la pena pagarlo.
Lo que la semana gratuita realmente reveló
Eliminando el marketing, el episodio de Ox Alpha produjo tres señales genuinamente útiles.
El modelo es barato de servir, y eso es arquitectónico. Aproximadamente tres veces menos computación de atención y una caché KV aproximadamente 4.4 veces más pequeña que GLM-5.3 no es una decisión de precios, es una decisión de diseño. Eso hace que el precio de lista bajo sea más probable que persista que una tarifa promocional. Nuestro desglose de precios explica lo que eso significa en la práctica.
Los pesos abiertos siguieron al lanzamiento alojado. El modelo se subió a Hugging Face bajo la licencia MIT, por lo que la semana de acceso gratuito alojado no fue la única forma de usarlo sin coste. Cualquiera con el hardware puede ejecutarlo indefinidamente. Ejecutarlo localmente cubre lo que eso implica.
La multimodalidad fue la parte que nadie sabía cómo probar. Durante la semana anónima, la mayoría de la gente usó Ox Alpha como un modelo de texto, porque no había una tarjeta de modelo que les indicara que aceptaba imágenes. Una capacidad que resultó ser la característica principal quedó en gran parte sin ejercitar por la misma población que supuestamente lo estaba probando bajo estrés. Esa es la debilidad estructural de un lanzamiento sin marca: obtienes volumen, pero obtienes volumen dirigido a lo que la gente asume que hace el modelo. Nuestra guía de visión cubre la vía que quedó sin probar.
El patrón más amplio
Ox Alpha no fue el primero y no será el último. El despliegue sigiloso en routers de terceros se ha convertido en una etapa normal previa al lanzamiento, situándose entre la evaluación interna y el lanzamiento público.
Para los consumidores de estos modelos, la postura práctica es sencilla. Pruébalos, aprende de ellos, guarda registros de lo que encuentres y no construyas nada que dependa de un modelo sin nombre. La semana gratuita es una oportunidad de investigación, no una cadena de suministro.
Preguntas Frecuentes
¿Qué era ox-alpha? GLM-5.3-Flash, el modelo de pesos abiertos 320B-A18B nativamente multimodal de Z.ai, desplegado anónimamente desde el 20 de agosto de 2026 y revelado el 26 de agosto.
¿Sigue siendo gratuito? No. El período gratuito finalizó con el anuncio. Un descuento de lanzamiento del 50% se extiende hasta el 9 de septiembre de 2026, después del cual se aplicarán precios de lista de 0,15 $ por entrada y 0,50 $ por salida por millón de tokens.
¿Cómo supo la gente que era de Zhipu? Comportamiento del tokenizador, estilo de salida, manejo multilingüe, patrones de negativa y forma del benchmark, comparados con versiones conocidas de GLM. No se requirió información interna.
¿Por qué regalar un modelo? Tráfico real a escala, pruebas de carga honestas, retroalimentación sin marca y una base instalada de opiniones positivas el día del lanzamiento.
¿Debería usar modelos anónimos en OpenRouter? Para evaluación, sí. Para producción, no. No ofrecen garantías de versionado, soporte o deprecación.