
Jev es el Modelo Sistema Uno de TypeSafe AI: le envías el estado del programa más preguntas tipadas, y te devuelve decisiones con probabilidades calibradas en lugar de prosa. (Este es Jev el modelo, no FaZe Jev el streamer ni la vacuna JEV.) Sus pesos son cerrados, solo por API, se sirve en POST https://api.typesafe.ai/v1/systemone como jev-latest. Así que “ejecutar Jev localmente” no puede significar Jev. Significa un clúster de proyectos comunitarios de hace unos días, liderados por OpenJev, que reproducen la idea con modelos abiertos. Si eres nuevo en el modelo en sí, lee qué es Jev primero; este artículo cubre las imitaciones.
Es un resumen y una comprobación de la realidad: qué afirma cada README, cuán fiel es, qué hardware necesita y cómo probar cualquiera de ellos a través de un punto final HTTP local en Apidog de la misma manera que probarías la API de TypeSafe. Ninguno ha sido evaluado por terceros, y ninguno es de TypeSafe.
Qué puede significar “ejecutar Jev localmente”
La publicación de lanzamiento de TypeSafe describe un modelo entrenado con Aprendizaje por Refuerzo para Decisiones Calibradas (RLCD), tres primitivas (noul, choice, score), un tiempo de respuesta de 70ms a 500ms, y $0.042 por millón de tokens de entrada con salida gratuita. Esas son afirmaciones del proveedor; la receta de entrenamiento no está publicada. Un hilo de la comunidad dice que Jev fue entrenado con datos 100% sintéticos. Trata eso como un rumor no verificado.
Debido a que la receta es secreta, cada “Jev abierto” toma uno de estos tres atajos:
- Leer los logits de un modelo de chat congelado. Hacer una pregunta de opción múltiple a un Qwen pequeño, omitir la generación y convertir los logits del siguiente token por opción en una probabilidad. OpenJev y mini-jev hacen esto.
- Entrenar un pequeño anotador desde cero. Un modelo cuyo único trabajo es puntuar N opciones contra un contexto en una sola pasada. Eso es jevlike.
- Cambiar el motor de decodificación. Mantener el modelo base, evaluar cada campo en paralelo sobre candidatos restringidos. Ese es el motor Apple Silicon en Hugging Face y la solicitud de extracción de vLLM.
Ninguno de ellos reproduce RLCD. Ese es el titular honesto.
OpenJev: logits de un Qwen congelado en una 3090
OpenJev pregunta "¿Podemos ejecutar algo como Jev en una 3090 en casa?" y responde con un paquete Python con licencia MIT. El README es cuidadoso: "reproduce ese patrón de interfaz con modelos abiertos; no reproduce el modelo o el entrenamiento no revelados de Jev."
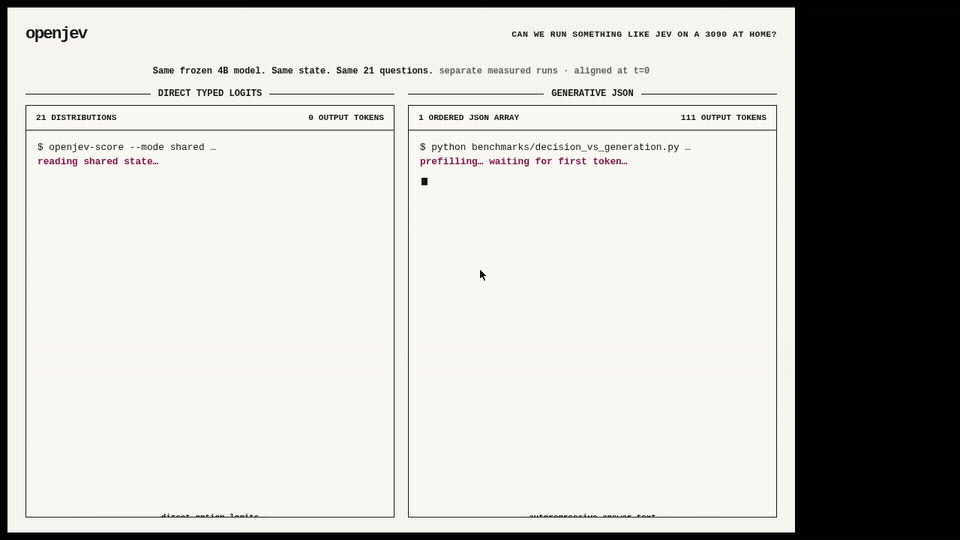
El mecanismo es un paso hacia adelante que lee los logits de opción declarados, sin muestrear ningún token de respuesta. Los criterios y las opciones llegan con cada solicitud, por lo que nada se ajusta por tarea. El modelo principal es Qwen3.5-4B.
Números que el README reporta en una RTX 3090 con Qwen3.5-4B:
- Logits tipados directos: 1.023 s para 21 pares de probabilidad, frente a 5.332 s para una matriz JSON autorregresiva, o 5.21x más lento.
- En un subconjunto de TypeSafe de 102 filas, acuerdo modal de 0.845, frente a 0.883 para Jev publicado.
La entrada es JSONL con id, state, question y una matriz options de {id, description}; la salida es una probabilidad por opción. No hay un servidor HTTP en el repositorio: ejecutas openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl, o pruebas la demostración de WebGPU en openjev.com. Hardware: CUDA y una GPU que contenga un modelo 4B en BF16.
Lo que omite: no hay primitiva noul o score, y las probabilidades son un softmax sobre los logits de la opción, no una confianza calibrada por RLCD.
mini-jev: un estudio preregistrado con un servidor local
mini-jev es más un experimento que un producto. Su lema: "Cómo se ve una interfaz estilo Jev en un Qwen3-4B congelado, lee los logits de la letra de la opción en lugar de generar JSON". Ejecuta Qwen3-4B-Instruct-2507 en la clasificación de intenciones CLINC150 y compara la generación de JSON restringida por gramática con la lectura del logit de una letra de opción.
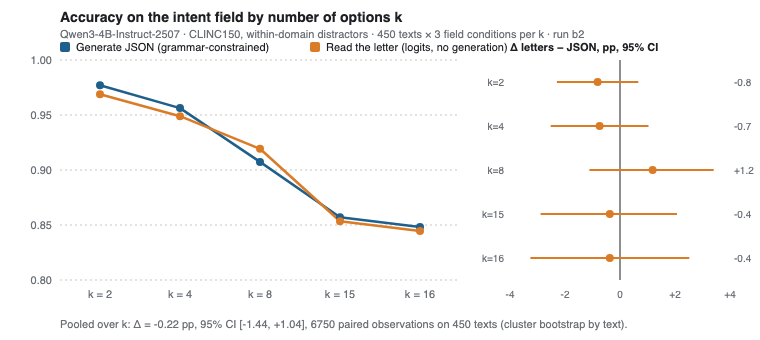
El resultado, a partir de 6.750 observaciones emparejadas: precisión JSON 0.909, letras 0.907, una diferencia de -0.22 puntos dentro de un IC del 95% de [-1.44, +1.04]. La lectura de letras fue aproximadamente 4 veces más rápida en textos de 32 tokens.
El README mapea sus términos a los de TypeSafe: choice y noul son “lo que este estudio mide en un modelo congelado, como la letra leída y el booleano; score (una escala ordenada) no fue medido”. Lo llama “una correspondencia de términos, no una reproducción de su modelo”, y añade la advertencia que todo proyecto aquí debería copiar: “Las cuotas de letras son una clasificación con una brecha de confianza, no probabilidades calibradas”.
Incluye una demostración HTTP. MINIJEV_DEVICE=mps uv run python demo/server.py sirve 127.0.0.1:8765 con POST /run, que toma schema y text y devuelve por campo letter, p, gap y answer. Necesita aproximadamente 8.5 GB de memoria en Apple Silicon o una GPU NVIDIA. MIT, 11 estrellas en el momento de la escritura.
jevlike: un anotador de opciones desde cero
jevlike se comparte como un "modelo tipo Jev de ingeniería inversa". El README dice lo contrario: "TypeSafe no ha publicado su diseño. Este repositorio es un modelo inicial independiente con la misma forma de entrada y salida". Los autores añaden que "no mostraron la misma calidad que Jev ni reprodujeron el método de entrenamiento privado de TypeSafe".
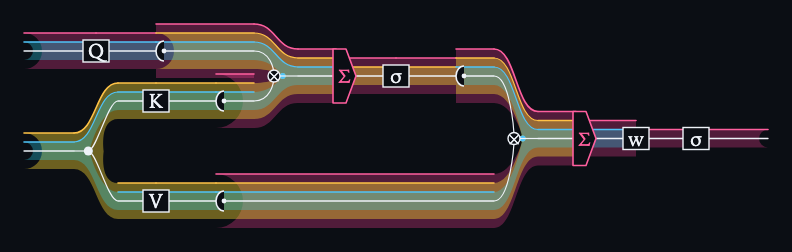
El diseño es pequeño. Cada opción obtiene un vector de consulta que atiende a los tokens de contexto; un producto escalar compartido puntúa cada par; softmax convierte las puntuaciones en probabilidades. El codificador predeterminado son incrustaciones de bytes aprendidas desde cero, con un codificador Hugging Face congelado opcional.
Números reportados: aproximadamente 98% en menús sintéticos, 26% en Wikispeedia con un codificador Qwen2.5-0.5B congelado frente a un control aleatorio del 8%, y una pasada "aproximadamente 100 veces más rápida que un decodificador pequeño forzado a escribir 400 tokens". Se ejecuta en CPU, MPS o CUDA. MIT, 764 estrellas.
La fidelidad es la más baja del grupo. Lo entrenas con tus propias etiquetas, por lo que es un clasificador que construiste, no un modelo de decisión al que puedas entregar criterios arbitrarios. Sin noul ni score, sin afirmación de calibración, sin servidor HTTP.
Decodificación paralela restringida: el motor Apple Silicon
El espacio de Hugging Face parallel-constrained-decoding está circulando como una "alternativa de código abierto de Jev de Typesafe.ai", pero su README nunca menciona a Jev, TypeSafe o RLCD. Su título es "Decodificación Paralela Restringida para Apple Silicon": un motor de inferencia MLX para extracción estructurada sobre mlx-community/Qwen2.5-1.5B-Instruct-4bit, con cualquier decodificador mlx-lm intercambiable.
El método: precargar el contexto una vez en una caché KV, difundirlo a través de cada campo de esquema, evaluar solo los IDs de token candidatos válidos por campo, softmax sobre ese conjunto y ensamblar el JSON en código. El README informa sobre un M4 Max: triage de fraude de 4 campos 420 ms autorregresivo versus 75 ms paralelo (5.6x), y triage de soporte de 28 campos 1,900 ms versus 270 ms (7.0x). Afirma un 100% de validez del esquema, lo que se deriva de nunca muestrear texto libre.
Sirve HTTP en el puerto 8000 a través de uvicorn, devolviendo parsed_json más field_telemetry con confianza por campo. Requisitos: un Mac M1 o posterior, macOS 14+. Apache 2.0. Sin números de precisión, solo latencia, y "calibrado" aquí significa un softmax exacto sobre los candidatos, no una calibración entrenada.
vLLM PR 57250: un modo similar a Jev para DiffusionGemma
La solicitud de extracción (pull request) #57250 de vLLM, abierta el 16 de septiembre y aún abierta, convierte DiffusionGemma en lo que el autor llama una "máquina de opción múltiple calibrada": un lienzo inicializado con ranuras de respuesta de un solo token, leídas con un límite de pasos, con confianza a partir de los logprobs y la entropía. Los nuevos campos vllm_xargs incluyen diffusion_seed_canvas, diffusion_max_steps y diffusion_read_only, y un ejemplo structured_server.py traduce un esquema a un lienzo.
La PR informa 8.7 solicitudes por segundo en lecturas de lienzo único, 54 con concurrencia de 32 vías, y aproximadamente un 90% de precisión en un corpus de clasificación de idiomas. Un revisor marcó la falta de una prueba de condición de carrera y la generación ilimitada de hilos como bloqueantes. Hasta que se fusione, es un diseño para leer, no uno para desplegar.
¿Cuán fiel es cada uno?
| Proyecto | Base | Primitivas | Calibración | Servidor HTTP | Hardware |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, congelado | choice | softmax sobre logits de opción | No (CLI + demo de navegador) | Clase RTX 3090, CUDA |
| mini-jev | Qwen3-4B-Instruct, congelado | choice, noul | clasificación con una brecha | Sí, puerto 8765 | 8.5 GB de memoria, MPS o CUDA |
| jevlike | codificador que entrenas | choice | ninguna declarada | No | CPU, MPS o CUDA |
| Motor MLX | Qwen2.5-1.5B-Instruct-4bit | campos de esquema | softmax sobre candidatos | Sí, puerto 8000 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | sí/no, choice, escala | logprobs más entropía | Sí, compatible con OpenAI | GPU clase vLLM, sin fusionar |
Cada fila es un modelo congelado o autoentrenado que lee logits. Eso te da la forma de Jev: respuestas tipadas, una probabilidad por opción, una pasada hacia adelante. No te da la afirmación central de Jev, que RLCD hace que esas probabilidades sean honestas. El 0.845 de OpenJev frente al 0.883 es la única comparación con el modelo real, y es la propia evaluación del autor. La configuración coincide con nuestra guía para ejecutar Kimi K3 localmente: pesos, una GPU o Mac serie M, un puerto local.
Prueba cualquiera de ellos en Apidog como la API real de Jev
El propósito de una reproducción local es intercambiarla por la API real sin reescribir tu integración, por lo que tus pruebas deberían enviar el mismo cuerpo a ambas. Ninguno de estos proyectos habla de forma nativa el esquema {model, state, questions} de Jev. Coloca un adaptador delgado delante de cualquiera que ejecutes: una aplicación FastAPI de 40 líneas que acepte el cuerpo de Jev, llame a la herramienta y devuelva {"answers": {...}} con las claves choice, probabilities y confidence. Ahora Apidog ve un contrato único.
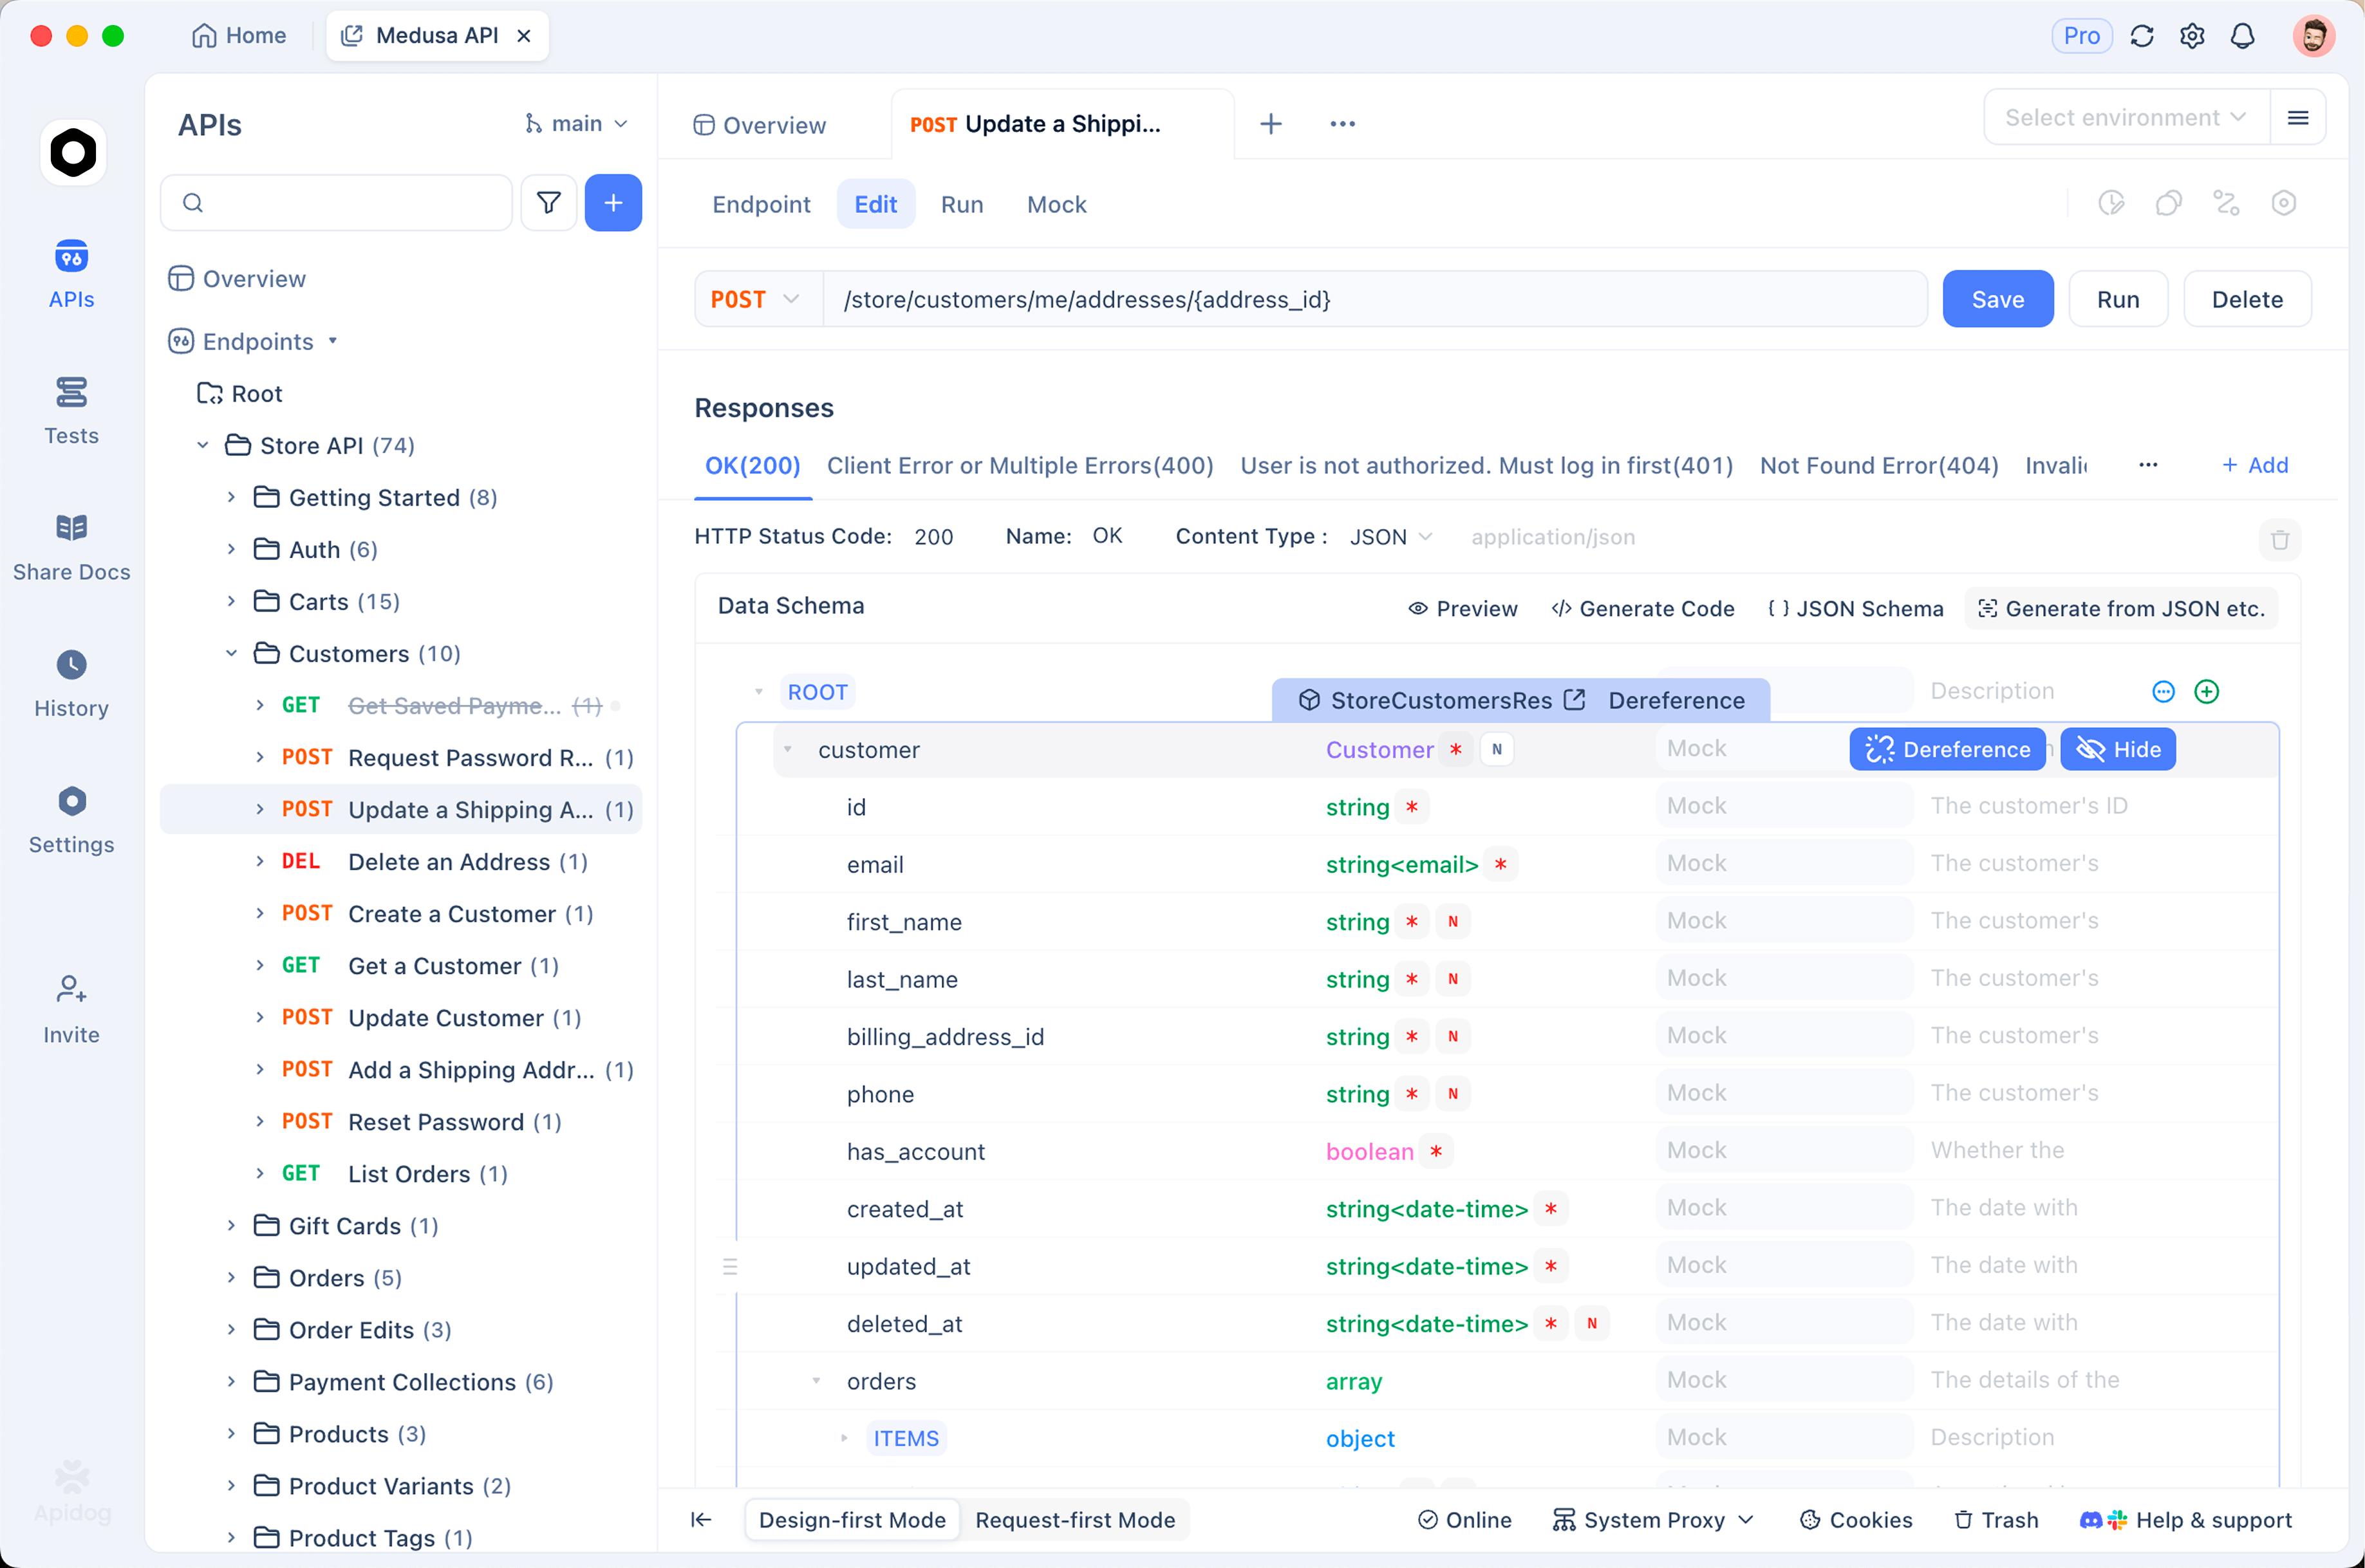
Dos entornos, un conjunto de solicitudes. Crea Local reproduction con BASE_URL = http://localhost:8765 y sin clave, y TypeSafe API con BASE_URL = https://api.typesafe.ai más TYPESAFE_API_KEY en el campo local para que nunca se sincronice con compañeros de equipo (reglas de alcance aquí). Cada solicitud utiliza {{BASE_URL}}/v1/systemone y Bearer {{TYPESAFE_API_KEY}}; el servidor local ignora el encabezado.
Envía el cuerpo de Jev. POST {{BASE_URL}}/v1/systemone con el estado y las preguntas que enviarías a jev-latest:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
Afirma los campos de probabilidad. Añade aserciones post-procesador: answers.department.choice es igual a billing; answers.department.probabilities.billing es mayor que 0.7; answers.wants_refund.noul es mayor que 0.8. Cambia el desplegable del entorno y ejecuta el mismo escenario contra TypeSafe. La brecha entre las dos ejecuciones es tu número de fidelidad, que vale más que cualquier tabla de README.
Guarda la ejecución local como un mock para que el frontend se construya contra un objeto answers estable con cero tiempo de GPU. Descarga Apidog para configurarlo; el plan gratuito cubre a cuatro usuarios. El mismo patrón para modelos de chat se encuentra en probar LLMs locales como APIs.
Preguntas frecuentes
¿Es OpenJev lo mismo que Jev?
No. OpenJev lee los logits de opciones de un Qwen3.5-4B congelado y así lo indica en su README. Jev es un modelo cerrado que TypeSafe entrenó con RLCD. OpenJev reporta un acuerdo modal de 0.845 con Jev en un subconjunto de 102 filas, según la propia evaluación de su autor.
¿Cuál debería probar primero?
mini-jev si estás en un Mac y quieres un punto final HTTP hoy mismo; OpenJev si tienes una GPU NVIDIA y quieres la comparación publicada más cercana a Jev. Elige jevlike solo si tienes datos etiquetados para entrenar.
¿Puedo obtener probabilidades calibradas de un modelo congelado?
No solo leyendo los logits. Un softmax sobre tokens de opción es una clasificación con una brecha, como lo expresa el README de mini-jev. La calibración necesita entrenamiento o un paso post-hoc como el escalado de temperatura en tu conjunto etiquetado, lo cual ninguno de estos ofrece.
¿Es más barato ejecutar uno de estos que pagar a TypeSafe?
A $0.042 por millón de tokens de entrada con salida gratuita, Jev ya se encuentra en el límite inferior de los proveedores de API LLM más baratos. Lo local gana en privacidad y uso sin conexión, no en costo, una vez que cuentas el tiempo de GPU.
Conclusiones
OpenJev, mini-jev, jevlike, el motor MLX y la PR de vLLM prueban una idea: una decisión no necesita texto generado, y leer logits en una sola pasada es más rápido. Ninguno demuestra que estén calibrados, y ninguno es Jev. Ejecuta uno detrás de un adaptador con forma de Jev, mantén un segundo entorno apuntando a TypeSafe, y deja que tus aserciones decidan cuán distantes están.