OpenAI y Anthropic han recortado drásticamente los precios de la API desde julio de 2026, y los recortes están en sus propias páginas de precios. GPT-5.6 Luna bajó un 80 % de la noche a la mañana, GPT-6.1 Sol se lista a $2/$10 frente a los $5/$30 de GPT-5.6 Sol, Claude Opus 5.5 redujo las lecturas de caché un 60 %, y Claude Haiku 5.5 se lista a una décima parte de Haiku 4.5. Si tu modelo de costos, reglas de enrutamiento o alertas de presupuesto son anteriores a septiembre, ahora están equivocados, en su mayoría a tu favor. A continuación: precios verificados antes/después, cálculos por solicitud, las trampas que aún inflan las facturas y cómo hacer que tu agente de codificación convierta los presupuestos de tokens en pruebas.
El gancho es el ensayo de Max Woolf OpenAI y Anthropic recortaron los precios de sus LLM hasta en un 80 % en unos pocos meses. ¿Por qué? y su hilo de Hacker News. Cubrimos el lado del mercado en la guerra de precios de modelos de IA de septiembre de 2026; esta publicación trata sobre lo que un equipo debería cambiar.
Los precios verificados antes/después
USD por millón de tokens (entrada / salida / entrada en caché), nivel estándar, por debajo de los umbrales de contexto largo. Las filas de OpenAI provienen de la página de precios de la API de OpenAI leída el 2026-10-26, con precios "antes" de copias archivadas de esa página. Las filas de Anthropic provienen de la documentación de precios de Claude, que enumeran modelos antiguos y nuevos uno al lado del otro.
| Cambio de modelo | Antes | Después | Cambio | Cuándo |
|---|---|---|---|---|
| GPT-5.6 Luna (recorte de precio) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | -80 % en todos los ámbitos | 2026-07-30 |
| GPT-5.6 Terra (recorte de precio) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20% | 2026-07-30 |
| GPT-5.6 Sol (promocional) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | -20 % entrada, -33 % salida | 2026-08-21 |
| GPT-5.6 Sol lista a GPT-6.1 Sol | $5 / $30 / $0.50 | $2 / $10 / $0.10 | -60 % entrada, -67 % salida, -80 % caché | 2026-09-29 |
| GPT-5.6 Luna a GPT-6 Luna | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | -50 % entrada, -58 % salida | 2026-09-22 |
| Claude Opus 5 a Opus 5.5 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | -20 % entrada/salida, -60 % caché | 2026-09-22 |
| Claude Fable 5 a Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0.25 | -75 % solo caché | Septiembre 2026 |
| Claude Sonnet 5 a Sonnet 5.5 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | -50 % solo caché | Septiembre-Octubre 2026 |
| Claude Haiku 4.5 a Haiku 5.5 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90 % (prompts de hasta 100K) | Octubre 2026 |
Solo las filas de GPT-5.6 son recortes en el mismo modelo; el resto son sucesores más baratos, por lo que la calidad y los recuentos de tokens difieren. El precio de lanzamiento de $2/$10 de Sonnet 5 se volvió permanente, y la documentación dice que el movimiento planeado a $3/$15 "no ocurrirá". El descuento de GPT-5.6 Sol es promocional, "disponible al menos hasta el 21 de noviembre de 2026". Los precios de Luna y Terra anteriores al recorte están en la página de precios archivada de OpenAI del 29 de julio.
Desgloses por modelo: el recorte de precio de GPT-5.6, precios de GPT-6 Sol, precios de Claude Haiku 5.5.
Por qué bajaron los precios
La única razón de primera mano proviene de Anthropic: el anuncio de Claude Opus 5.5 dice que el modelo "requiere menos cómputo para servir que Opus 5, y su precio lo refleja", y estima un costo 40 % menor en cargas de trabajo típicas. Las páginas de OpenAI no dan ninguna razón. El resto es opinión:
- Competencia, bajos costos de cambio. Woolf argumenta que los modelos ahora son sustitutos cercanos: cambiar es una palanca en un arnés o una nueva cadena de modelo a través de un enrutador. Los modelos de pesos abiertos servidos por muchos proveedores (contó 29 para una variante de DeepSeek Flash en OpenRouter el 24 de octubre) establecen el piso.
- Ojo por ojo. Los recortes se alternan entre las dos compañías, y ambas lanzaron insignias más baratas el 22 de septiembre.
- Momento de la IPO. Woolf señala que se rumorea que ambas se acercan a las IPO y encuentra extraño el momento. Eso es especulación sobre el motivo.
- Eficiencia. Muchos comentaristas de HN dan la historia más simple: mejor almacenamiento en caché, modelos más pequeños, servicio más barato.
Woolf también cita datos de Vercel AI Gateway: el costo por token cayó al 43,3 % de su nivel de abril de 2026 mientras que el gasto agregado aumentó. Los tokens más baratos rara vez reducen una factura a menos que cambies cómo los gastas.
Qué cambian los recortes: cálculos por solicitud
Un turno de agente con mucha caché
Tomemos un turno de un agente de codificación: 100.000 tokens de conversación leídos de la caché, 2.000 tokens de entrada nuevos, 1.000 tokens de salida.
| Modelo | Lecturas de caché | Entrada nueva | Salida | Costo del turno |
|---|---|---|---|---|
| GPT-5.6 Sol (lista) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (promo) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
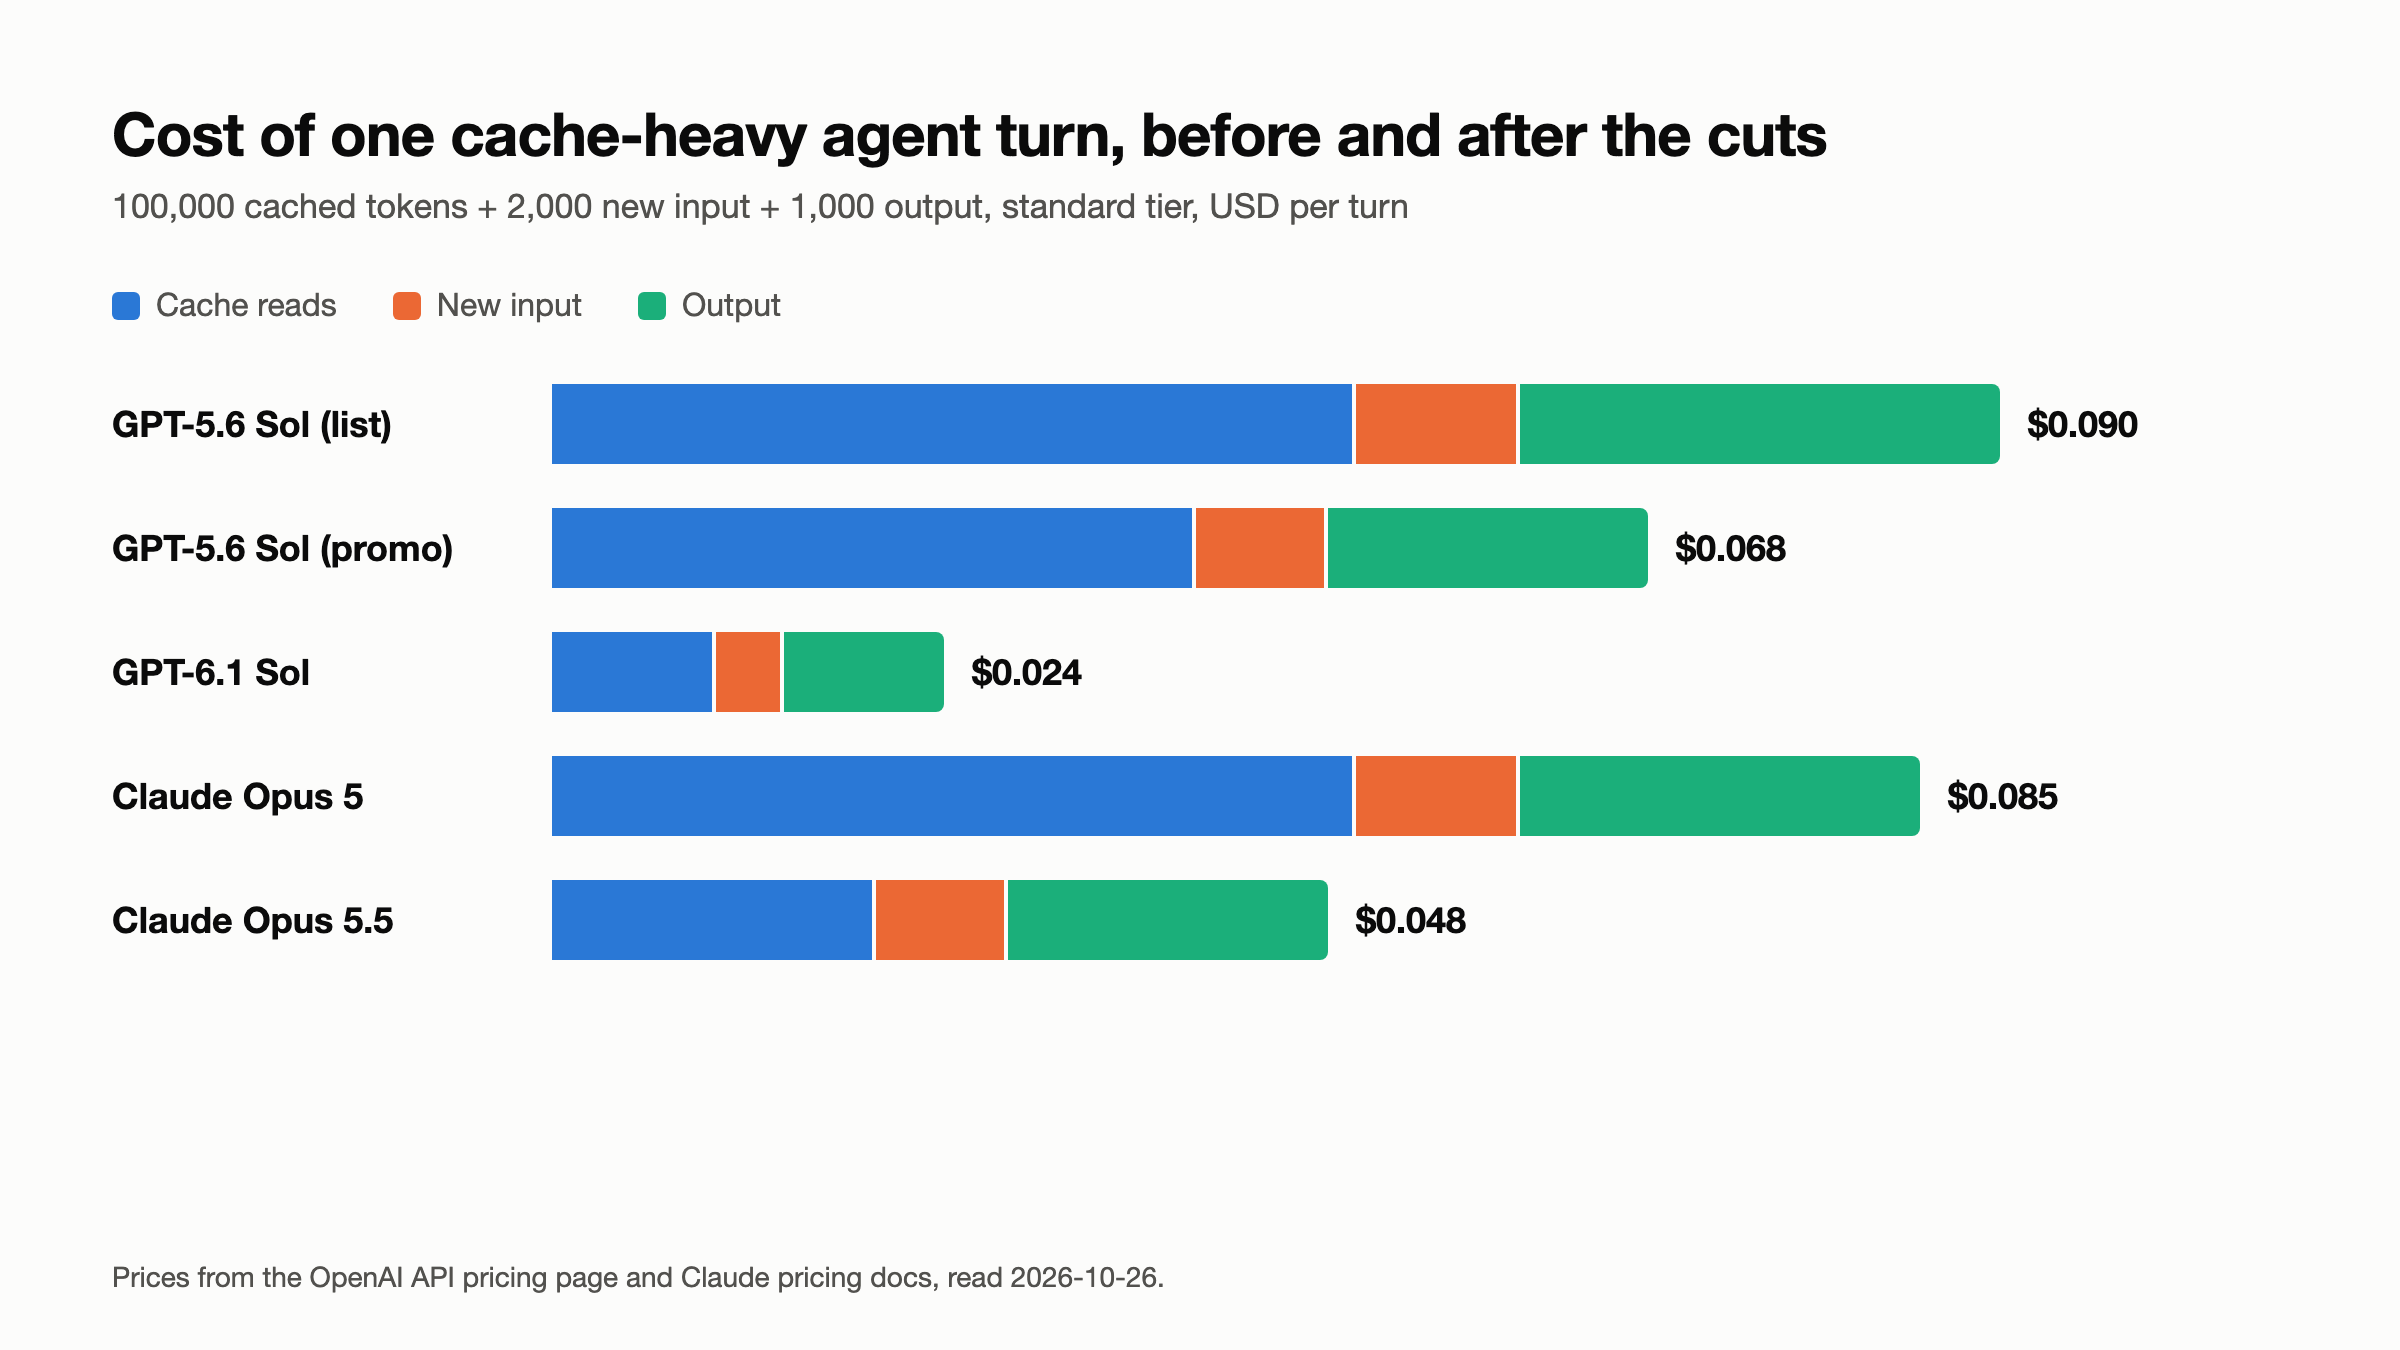
GPT-6.1 Sol está un 73 % por debajo del precio de lista de GPT-5.6 Sol en este turno, y Opus 5.5 está un 44 % por debajo de Opus 5, cerca del 40 % de Anthropic. En los modelos antiguos, las lecturas de caché eran más de la mitad del turno, por lo que el precio de lectura de caché es ahora el número que importa para los agentes. Por eso el recorte solo de caché de Fable 5.1 importa más de lo que sugiere su $10/$50 sin cambios. Consulta nuestros cálculos de punto de equilibrio del almacenamiento en caché de Opus 5.5 y guía de almacenamiento en caché de prompts de GPT-6.
Qué cambiar: clasifica los modelos por costo por turno según tu tasa real de aciertos de caché, no por el precio de entrada de lista.
Un clasificador de alto volumen
Ahora un enrutador o clasificador: 1 millón de solicitudes al día, 1.500 tokens de entrada y 200 tokens de salida cada una, sin almacenamiento en caché.
- GPT-5.6 Luna antes del 30 de julio: 1,5B de entrada a $1 más 200M de salida a $6 = $2.700/día
- GPT-6 Luna: $150 + $100 = $250/día
- Claude Haiku 4.5: $1.500 + $1.000 = $2.500/día
- Claude Haiku 5.5: $150 + $100 = $250/día
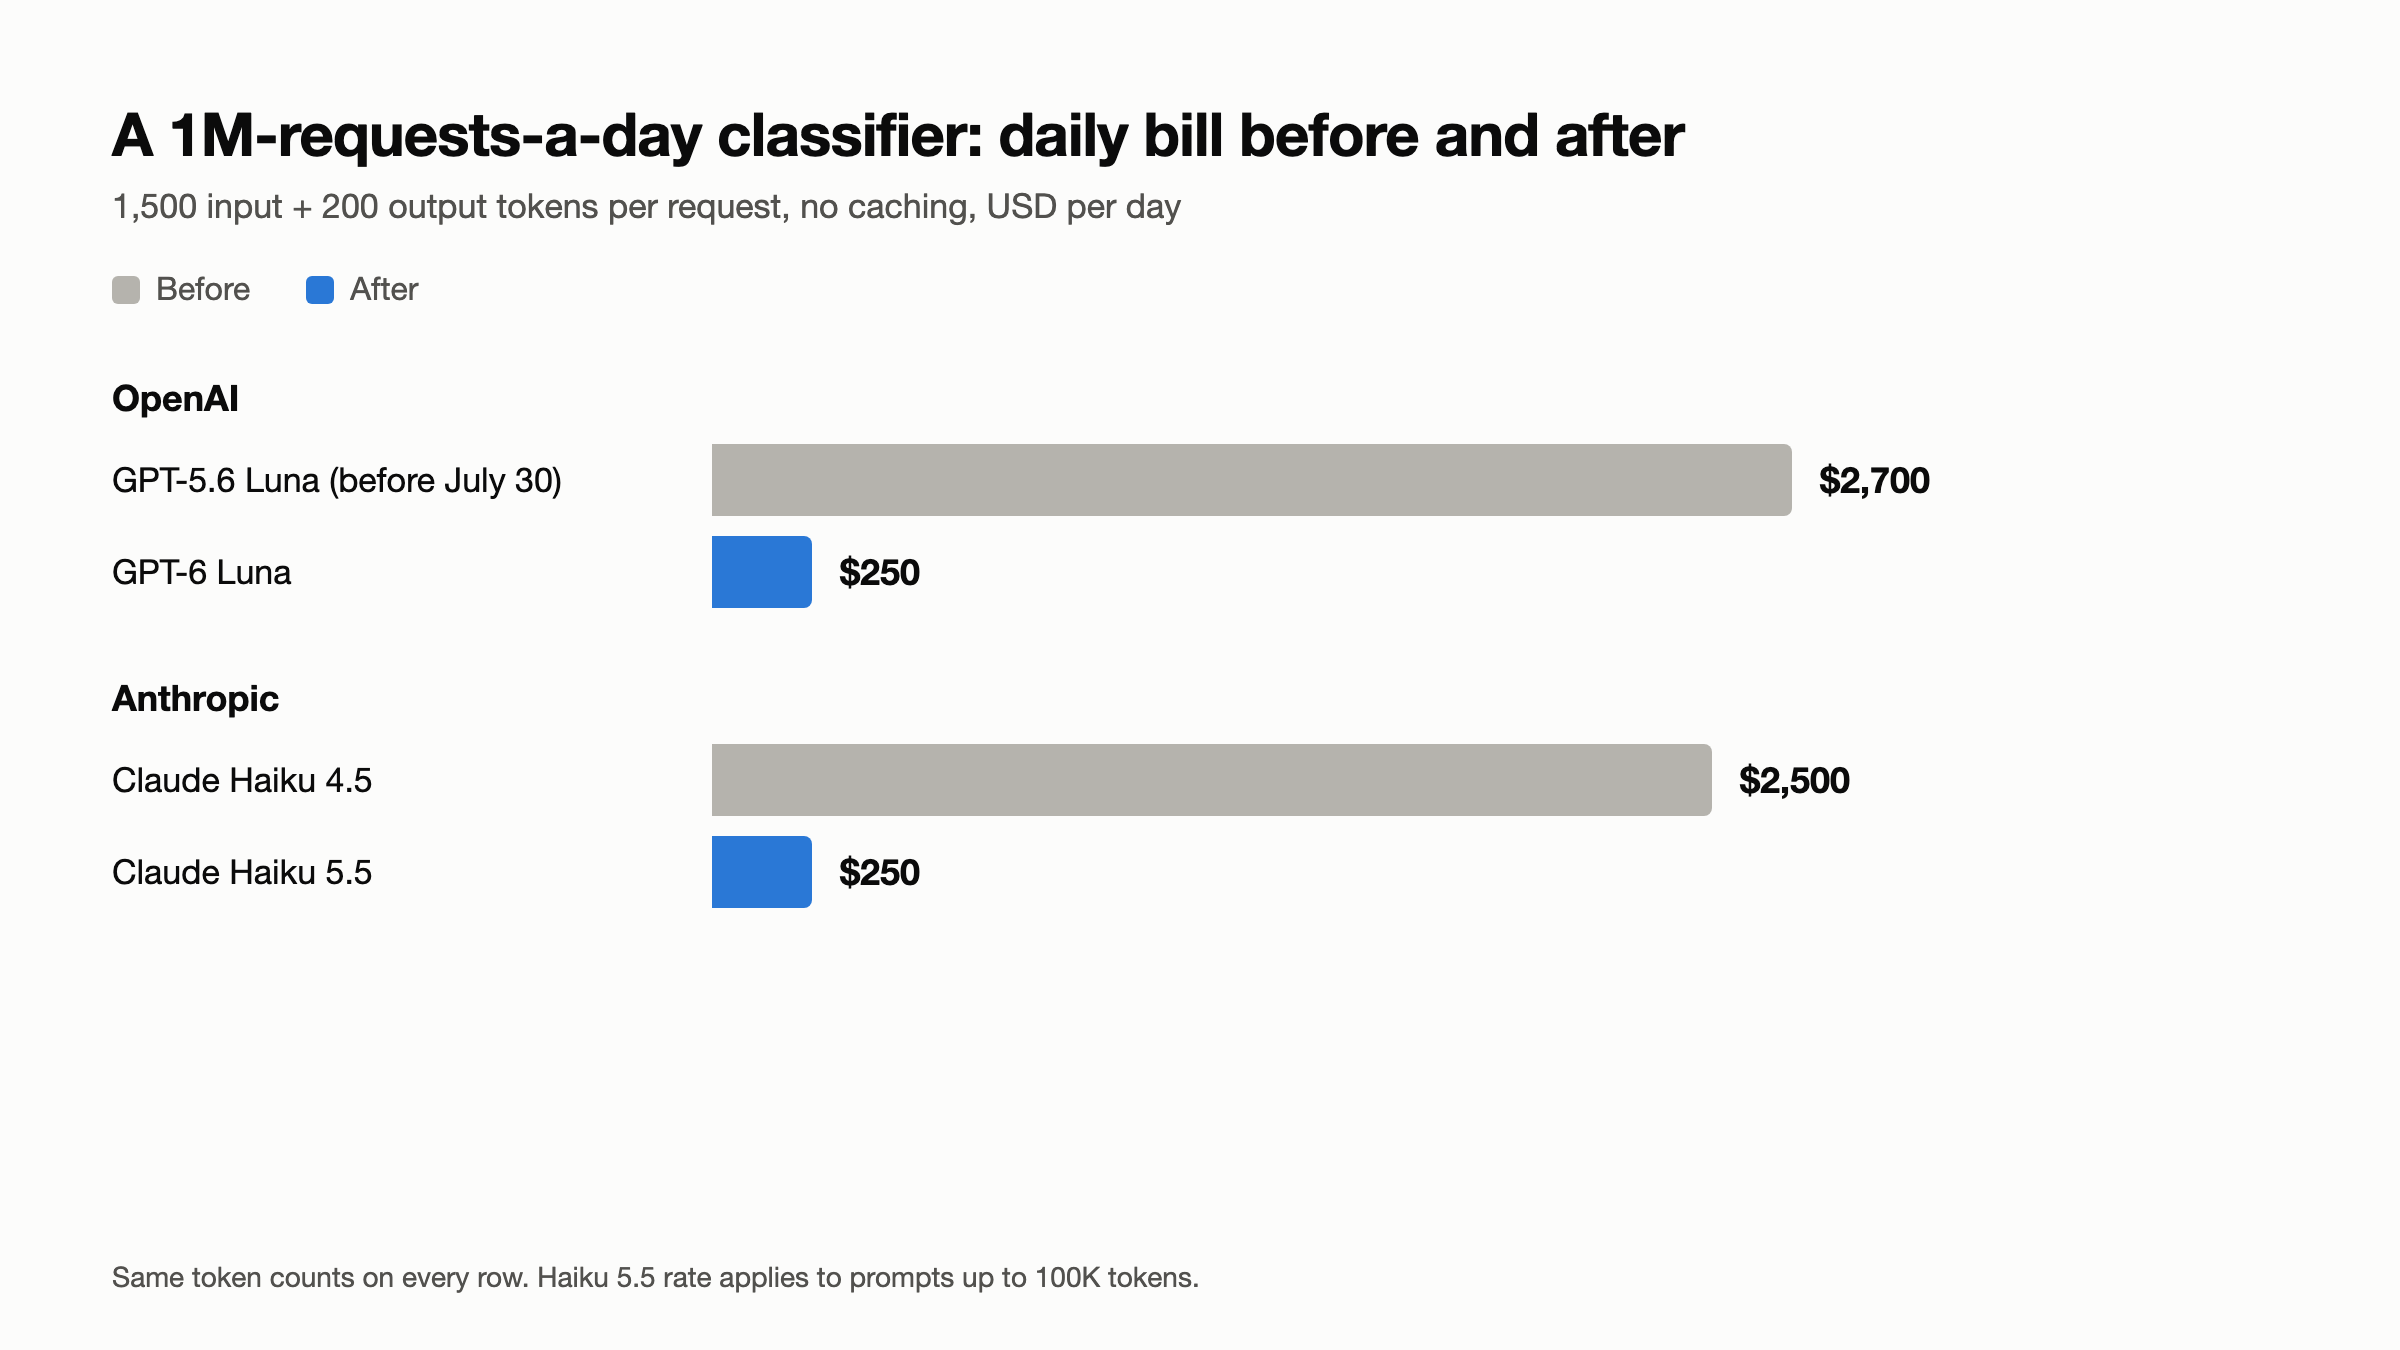
Qué cambiar: deja de recortar prompts para modelos pequeños, y prueba si el tráfico de nivel medio ahora cabe en uno pequeño. Ejecuta primero tu conjunto de evaluación: el precio por token no dice nada sobre la precisión en tus datos.
Batch: menos dólares, mismo porcentaje
Ambos todavía aplican un 50 % de descuento al trabajo asíncrono: la API Batch de Anthropic reduce a la mitad la entrada y la salida, y el nivel Flex/Batch de OpenAI reduce todo a la mitad, incluida la entrada en caché (GPT-6.1 Sol: $1 / $5 / $0.05). En el clasificador anterior, el batch ahora ahorra $125 al día. Para cargas de trabajo pequeñas, eso puede ya no justificar infraestructura adicional de colas; para las grandes, la guía de la API Batch de OpenAI todavía se aplica.
Las trampas que aún inflan la factura
Las escrituras en caché cuestan más que la entrada. Anthropic cobra 1,25 veces la entrada base por una escritura de 5 minutos y 2 veces por una escritura de 1 hora. La tabla de OpenAI también tiene columnas de escritura: 1,25 veces por 30 minutos y 2,5 veces por 12 horas (GPT-6.1 Sol: $2,50 y $5 frente a $2 de entrada). Un prefijo escrito y nunca leído cuesta entre un 25 % y un 150 % más que no tener caché. Con lecturas al 5 % de la entrada, una escritura corta se amortiza después de una lectura, una larga después de dos.
Multiplicadores de contexto largo. En GPT-6.1 Sol y GPT-6 Luna, las páginas de modelos de OpenAI dicen que los prompts de más de 272K tokens de entrada se cobran a 2 veces las tarifas de entrada y caché y 1,5 veces la salida "para la solicitud completa". Claude Haiku 5.5 salta de $0,10/$0,50 a $0,50/$2,50 por encima de 100.000 tokens de prompt, y Anthropic cuenta las lecturas y escrituras de caché para ese umbral. Otros modelos Claude 4.6 y posteriores facturan la ventana completa de 1M a tarifas estándar. Un prompt sobredimensionado en una ruta activa puede borrar los ahorros.
Los tokens de razonamiento son tokens de salida. La guía de razonamiento de OpenAI dice que los tokens de razonamiento se "facturan como tokens de salida" y los muestra en usage.output_tokens_details.reasoning_tokens. Una respuesta puede alcanzar max_output_tokens antes de cualquier salida visible, y aún así pagas. La documentación de costos de pensamiento de Anthropic factura el pensamiento completo, no el resumen visible, reportado en usage.output_tokens_details.thinking_tokens. La salida es el lado caro de cada fila, por lo que la configuración de esfuerzo puede mover las facturas más que la elección del modelo.
Recargos regionales. OpenAI agrega un 10 % por procesamiento regional (residencia de datos) en modelos lanzados el 5 de marzo de 2026 o después, y un 10 % para puntos de conexión FedRAMP. Anthropic aplica un multiplicador de 1,1 cuando configuras inference_geo: "us", y los puntos de conexión regionales en Bedrock y Google Cloud tienen un recargo del 10 % sobre los globales.
Tokenizadores y promociones. La documentación de Anthropic dice que los modelos Claude 4.7 y posteriores usan un tokenizador que produce aproximadamente un 30 % más de tokens para el mismo texto que Sonnet 4.6 y anteriores, por lo que en el mismo texto, Haiku 4.5 a Haiku 5.5 resulta más cercano al 87 % que al 90 %. Y si fijaste gpt-5.6-sol para mantener la tarifa promocional, pon el 21 de noviembre de 2026 en tu calendario.
Deja que tu agente de codificación ponga aserciones de costo en tus llamadas LLM con Apidog CLI
Los precios cambian mensualmente; los recuentos de tokens cambian cada vez que alguien edita un prompt o aumenta una configuración de esfuerzo. La solución duradera es una prueba que falla cuando una llamada supera el presupuesto, ejecutada en cada solicitud de extracción. Deja que Claude Code, Codex o Cursor la escriban con Apidog CLI.
Instala la CLI y la habilidad del agente una vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un prompt:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
El agente lee cada esquema de payload, valida antes de escribir y ejecuta el caso:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Los presupuestos viven en los postProcessors del caso como aserciones en JSONPath, con comparaciones como isAtMost e isAtLeast del esquema test-case-create:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Para Claude, apunta el endpoint a /v1/messages y haz aserciones sobre $.usage.output_tokens y $.usage.output_tokens_details.thinking_tokens. Luego pide un escenario de prueba que haga la misma llamada dos veces y afirme que $.usage.input_tokens_details.cached_tokens (OpenAI) o $.usage.cache_read_input_tokens (Claude) de la segunda respuesta es mayor que cero: cuando alguien rompe el prefijo en caché, la compilación falla antes de que llegue la factura. Alimenta prompts representativos con -d, pasa la clave de API desde los secretos de CI con --env-var, y usa -r junit en tu canalización (guía de CI/CD). Apidog CLI en Claude Code cubre la configuración del agente.
Preguntas frecuentes
¿OpenAI y Anthropic realmente recortaron los precios un 80 %? Para un modelo, sí: GPT-5.6 Luna pasó de $1/$6 a $0,20/$1,20 el 30 de julio de 2026. La mayoría de las otras caídas provienen de modelos sucesores más baratos.
¿Los recortes se aplican a las suscripciones de Claude Code y Codex? Las páginas de precios cubren la API. Woolf dice que los ahorros también llegan a los arneses de suscripción, pero también informa que OpenAI redujo a la mitad la asignación de uso en el nivel de $200 de Codex, así que revisa los límites de tu plan.
¿El precio de GPT-5.6 Sol es permanente? No. Es promocional, al menos hasta el 21 de noviembre de 2026. GPT-6.1 Sol es más barato de todos modos.
¿Cuál es la forma más barata de reducir la factura de un agente ahora? Aumenta tu tasa de aciertos de caché y reduce el esfuerzo de razonamiento. Las lecturas de caché dominan las sesiones largas, y el razonamiento se factura a la tarifa de salida.
Siguiente paso
Vuelve a calcular el costo de tus tres llamadas LLM más frecuentes, luego haz que tu agente agregue una prueba de presupuesto de tokens para cada una. Descarga Apidog para comenzar.