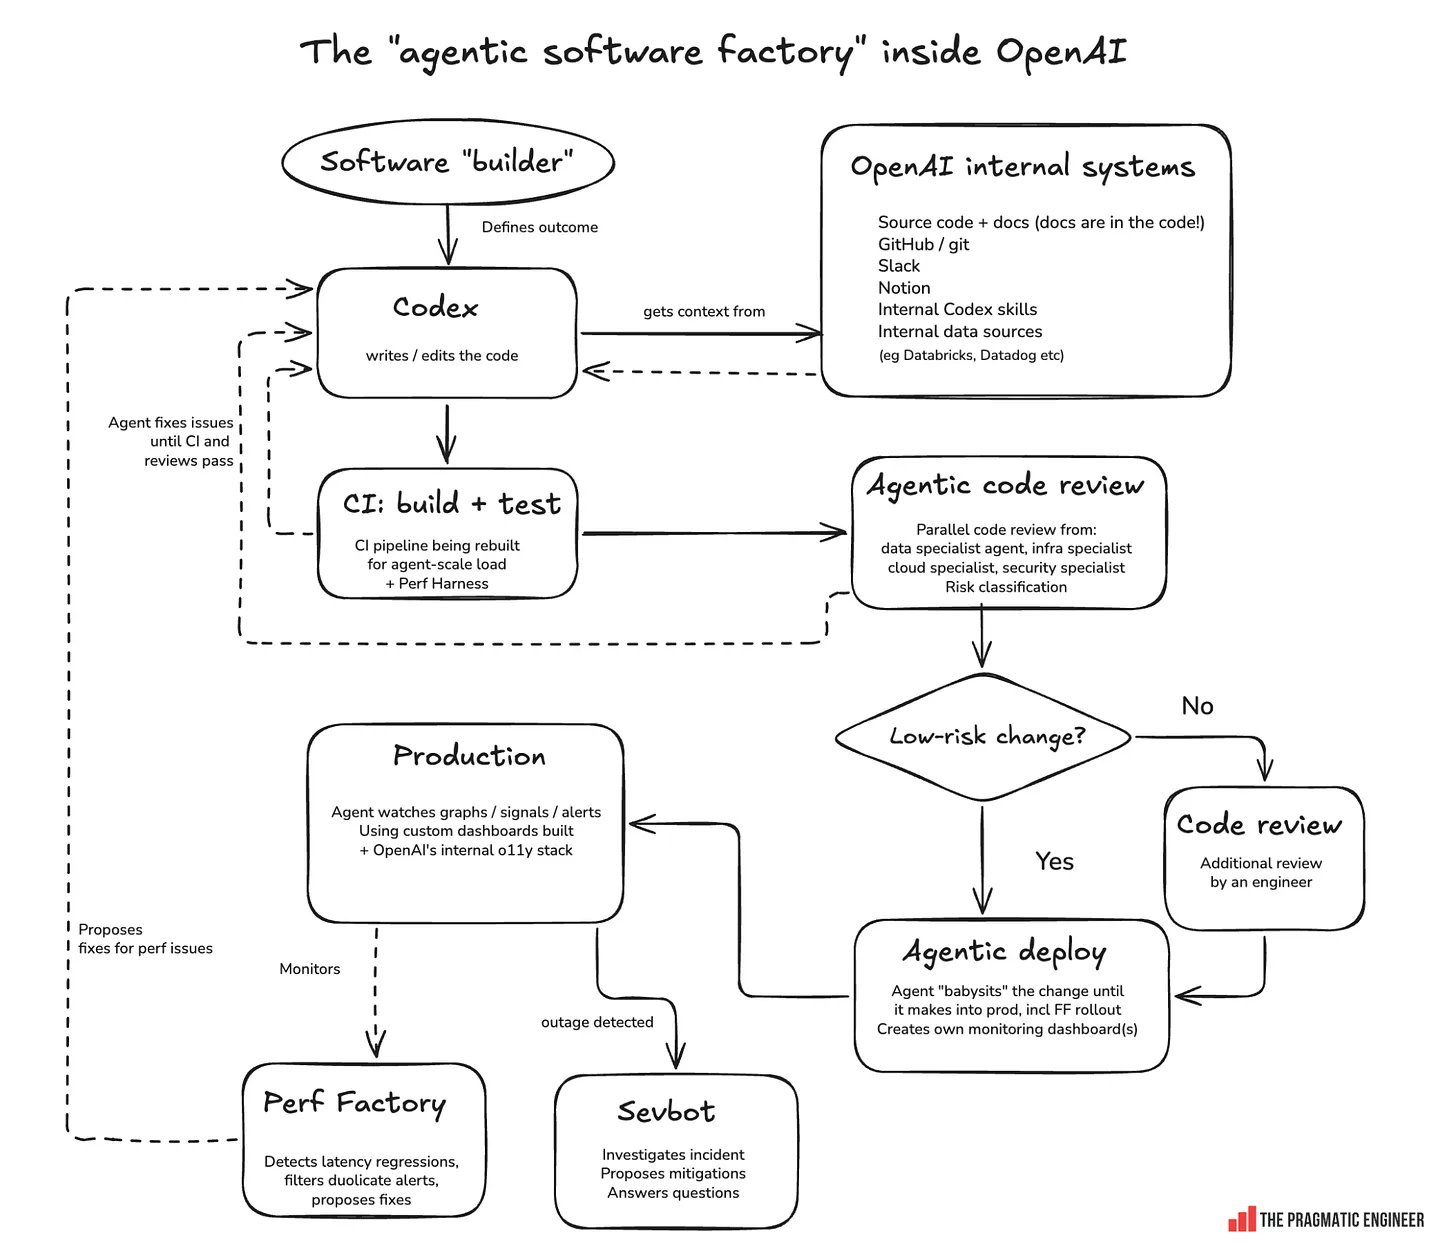
Un diagrama del pipeline de ingeniería interno de OpenAI se volvió semi-viral en X esta semana. Mostraba diez cajas, desde "el constructor de software define el resultado" hasta un agente que monitorea los gráficos de producción y archiva sus propios informes de incidentes. La fuente es el boletín de Gergely Orosz, The Pragmatic Engineer, en un artículo llamado "La fábrica de software agéntica de OpenAI", y el diagrama mismo se difundió rápidamente en X.
La mayor parte de la reacción omitió un detalle importante: varias de esas diez cajas describen la configuración de ingeniería interna de OpenAI, no el producto Codex que puedes instalar hoy. Confundir ambos es el error más común en el discurso en torno a este diagrama. Este artículo analiza caja por caja y se detiene en la única etapa que los equipos externos pueden realmente copiar: CI.
Las diez etapas, en orden
El diagrama se lee de izquierda a derecha como un bucle: un humano establece un objetivo, un agente escribe código, las puertas automatizadas lo verifican, y el agente sigue iterando hasta que esas puertas pasan. Aquí está la secuencia completa con la línea de distinción entre interno y enviado marcada para cada etapa.
| # | Etapa | Qué sucede | Solo interno o incluido en Codex |
|---|---|---|---|
| 1 | Constructor de software | Un ingeniero o PM define el resultado | Paso humano, no software |
| 2 | Codex escribe/edita código | Extrae contexto de la fuente, documentos, GitHub, Slack, Notion, habilidades internas y sistemas de datos como Databricks y Datadog | Codex enviado escribe código; el gráfico de contexto interno (Slack, Notion, datos internos) es solo interno |
| 3 | CI: compilación + prueba | Un pipeline reconstruido para cargas a escala de agentes, más un “Perf Harness” | Incluido (tu propio CI); el trabajo específico de escalado de OpenAI es interno |
| 4 | Revisión de código agéntica | Revisión paralela de agentes especialistas en datos, infraestructura, nube y seguridad, más clasificación de riesgos | Solo interno |
| 5 | Decisión de bajo riesgo | Los cambios de bajo riesgo proceden; los cambios de alto riesgo reciben una revisión adicional de un ingeniero humano | Solo interno |
| 6 | Despliegue agéntico | Un agente “supervisa” el cambio a producción, incluyendo el despliegue de feature flags, y construye sus propios paneles de control | Solo interno |
| 7 | Monitoreo de producción | El agente monitorea gráficos, señales y alertas en la pila de observabilidad interna de OpenAI | Solo interno |
| 8 | Interrupción detectada -> Sevbot | Investiga el incidente, propone mitigaciones, responde preguntas | Solo interno |
| 9 | Fábrica de Rendimiento | Filtra alertas duplicadas, encuentra regresiones de latencia, propone soluciones | Solo interno |
| 10 | Bucle de retorno | El agente soluciona problemas hasta que CI y las revisiones pasan, luego el constructor recibe las soluciones propuestas | Describe el bucle interno |
Exactamente una etapa, el paso de CI, más un segmento de la etapa 2, es algo que un equipo externo puede señalar y decir "nosotros también tenemos eso". Todo, desde la revisión agéntica hasta Sevbot, es una construcción interna de OpenAI.
Esa columna de "solo interno" también es un problema de aprovisionamiento. Las piezas que OpenAI mantiene detrás de su firewall, la orquestación, la puerta de revisión, la aprobación humana, son precisamente la capa para la que la mayoría de los equipos no tienen nada. Sharkly es un lugar neutral para el proveedor donde construirlo: un constructor define el resultado como una Tarea, la asigna a un Agente, y el Agente se ejecuta en una Computadora usando el Runtime que ya tengas, Claude Code o Codex. Listo para el lanzamiento es el estado que un humano debe mover antes de que algo llegue a Hecho, por lo que la aprobación sigue siendo un trabajo de persona, no del pipeline. Sharkly no reemplaza a Codex ni escribe código por sí mismo; ejecuta el Runtime por el que ya pagas y le da al bucle circundante un lugar donde vivir.
Etapa 1-2: un humano todavía establece el objetivo, Codex todavía escribe el código
Un constructor de software, es decir, un ingeniero o un gerente de producto, define el resultado que desea. Codex luego realiza una serie de cambios de código hasta alcanzar ese objetivo y verifica que el resultado funcione. Ese bucle de verificación es la parte de Codex que se envía hoy: la aplicación de escritorio (Mac en febrero de 2026, Windows en marzo), la integración de ChatGPT Work a partir de julio de 2026, los plugins y habilidades basados en roles, y el comando /goal para tareas que se ejecutan durante un período prolongado. Si deseas conocer la mecánica de ese comando, cubrimos el comando /goal para ejecuciones de agentes autónomos por separado.
Lo que no se envía es el grafo de contexto que alimenta a Codex internamente: prácticamente todos los sistemas de OpenAI, desde los hilos de Slack hasta los paneles de Databricks. El artículo de Orosz lo dice directamente: el Codex interno de OpenAI "es mucho más avanzado que su contraparte externa porque está conectado a prácticamente todos los sistemas de OpenAI". Esa brecha entre el Codex interno y externo es la verdadera tesis del artículo.
Etapa 3: CI es donde el bucle se aplica realmente
Esta es la etapa en la que vale la pena detenerse, porque es la única caja en todo el pipeline que cualquier equipo, no solo OpenAI, ya posee. El artículo señala que el CI en OpenAI está siendo reconstruido para un aumento de carga de aproximadamente 10 veces en unos seis meses, porque los agentes ahora impulsan muchos más cambios a través del pipeline de lo que los humanos solos jamás hicieron. Un "Perf Harness" se ejecuta junto a él para detectar regresiones de rendimiento antes de que lleguen a la revisión.
Aquí está la parte que se pasa por alto: un agente que "soluciona problemas hasta que CI y las revisiones pasan" es tan confiable como lo que CI realmente verifica. Si tu suite de pruebas cubre la lógica unitaria pero no el contrato de la API, un agente puede hacer un bucle hasta una compilación exitosa que aún así envía un cambio disruptivo. Los códigos de estado, la forma del esquema, el comportamiento de autenticación y los presupuestos de tiempo de respuesta bajo carga son exactamente el tipo de verificación en la que la mayoría de los equipos invierten poco en relación con las pruebas unitarias. Aquí es donde Apidog encaja: ejecutar los escenarios de prueba de Apidog a través de la CLI de Apidog dentro de tu paso de CI le da a un agente una puerta más difícil de satisfacer que "el código compilado". Hemos escrito sobre cómo conectarlo en Apidog CLI dentro de Codex. Ese es el único rol que Apidog juega en este pipeline. No es el agente, y no interviene en el despliegue, la revisión o la respuesta a incidentes.
Etapa 4-5: agentes de revisión especialistas y la decisión de riesgo
Después de que CI pasa, la configuración interna de OpenAI enruta el cambio a través de una revisión paralela de agentes especialistas en datos, infraestructura, nube y seguridad. Orosz lo describe como "el equivalente a tener un experto en el dominio humano de cada equipo de infraestructura relevante revisando cada cambio", lo cual es un estándar de revisión más exigente de lo que la mayoría de los equipos humanos pueden gestionar para cada pull request. La función de revisión de código incluida en Codex es algo diferente y más ligero que estos agentes especialistas internos; si estás decidiendo qué puede hacer un revisor agéntico de propósito general para tu propia pila tecnológica, nuestra recopilación de herramientas de revisión de código con IA es un buen punto de partida, y nuestro artículo complementario sobre el diseño de la revisión agéntica y la puerta de riesgo de OpenAI profundiza en esta caja (hermano, confirma que esté en vivo antes de enlazar).
La clasificación de riesgos decide entonces lo que sucede a continuación. Las áreas de bajo riesgo de la base de código pueden permitir que un agente apruebe automáticamente sus propias PRs, eliminando por completo la aprobación humana para esa clase de cambio. Los cambios de mayor riesgo reciben más pases de revisión de IA, una revisión humana obligatoria, o ambos. OpenAI no ha publicado la regla exacta de lo que se considera bajo riesgo, y no vamos a especular al respecto aquí. Una idea que se generaliza más allá de la configuración específica de OpenAI: un cambio disruptivo en un contrato de API pública nunca debería clasificarse como de bajo riesgo, por pequeño que parezca el 'diff'. Las herramientas "spec-first" que mantienen tu definición de OpenAPI y tus pruebas en el mismo lugar facilitan la aplicación automática de esa distinción, ya que una diferencia de esquema es una señal de riesgo mucho más clara que una diferencia de conteo de líneas.
Etapa 6-8: desplegar, observar y responder, sin que un humano sea alertado primero
Si un cambio supera la revisión, un agente interno lo "supervisa" en producción, incluyendo el despliegue de feature flags, y construye sus propios paneles de monitoreo para ese cambio específico. Una vez en vivo, el mismo agente (o uno relacionado) monitorea gráficos y alertas en la pila de observabilidad interna de OpenAI. Cuando algo falla, Sevbot toma el control: investiga el incidente, propone mitigaciones y responde preguntas de los desarrolladores en Slack. Vale la pena ser preciso sobre lo que Sevbot no hace. Propone; no ejecuta. Un humano aún autoriza la mitigación y sigue de guardia. Como el artículo afirma claramente, "el servicio de guardia no es cosa del pasado". Ninguna de las etapas 6 a 8 existe en el producto Codex que puedes comprar.
Etapa 9-10: regresiones de rendimiento y el bucle de retorno
Perf Factory se sitúa junto a la ruta de incidentes. Examina alertas y paneles de control, filtra señales duplicadas, detecta regresiones de latencia reales y propone soluciones, que luego vuelven al constructor original. Junto con Sevbot, esta es la respuesta de OpenAI a la fatiga de alertas: en lugar de un ingeniero de guardia que clasifica cada ping, un agente pre-filtra y pre-diagnostica primero. El bucle se cierra con la etapa 10: el agente sigue revisando hasta que CI y cada capa de revisión pasan.
Por qué la línea interno/externo importa para tu equipo
Si estás evaluando si la ingeniería agéntica "al estilo OpenAI" es algo que tu equipo puede adoptar este trimestre, la respuesta honesta es: puedes adoptar las etapas 1 a 3 hoy, y las etapas 4 a 9 describen una dirección, no una característica comprable. Eso no es una crítica a OpenAI; las herramientas internas a esa escala tardan años. Un proyecto de código abierto, orchflows, es un intento público de aproximar este bucle con un comando /software-factory para Claude Code y Codex; su README es directo sobre el objetivo, argumentando que solo necesitas dos habilidades en lugar de una biblioteca de ellas. Es un proyecto temprano, no afiliado, no un lanzamiento de OpenAI, así que trátalo como una implementación de referencia en lugar de una fábrica lista para usar.
La adopción dentro de OpenAI ha avanzado rápidamente en las partes que no necesitan una infraestructura interna personalizada: el uso de Codex en equipos no técnicos pasó de aproximadamente un 0% a un 90% de adopción en cuatro meses, de febrero a mayo de 2026. Esa es una señal más clara que el diagrama del pipeline por sí solo, porque dice que la parte fácil (un agente que escribe código hacia un objetivo declarado) ya es normal en OpenAI, mientras que la parte difícil (despliegue agéntico, revisión y respuesta a incidentes conectados a cada sistema interno) sigue siendo personalizada.
Lo que permanece humano
El artículo es cuidadoso con lo que no cambia. Los constructores aún definen los resultados. Los humanos aún aprueban cambios de alto riesgo y autorizan mitigaciones de incidentes. Alguien todavía revisa lo que hizo Sevbot después del hecho, y las rotaciones de guardia aún existen. La frase con la que cierra el artículo captura el cambio mejor que cualquier estadística: "El juicio, la priorización y el buen criterio son cada vez más importantes". Dos advertencias también mantienen esto en tierra: la revisión de la tienda de aplicaciones móviles sigue siendo un cuello de botella manual que ningún agente puede eludir, y el escalado de la infraestructura es una lucha mensual, no un problema resuelto.
Si estás construyendo tu propia versión de las etapas 1 a 3 en lugar de esperar a que un proveedor envíe las etapas 4 a 9, comienza con la puerta que ya existe en tu pipeline: CI. Nuestro artículo complementario sobre la construcción de una fábrica de software más ligera alrededor de Codex detalla esa construcción (hermano, confirma que esté en vivo antes de enlazar), y el diseño de Sevbot/Perf Factory recibe su propio tratamiento en nuestro artículo sobre la fábrica de rendimiento de OpenAI y Sevbot (hermano, confirma que esté en vivo antes de enlazar). Un agente que hace bucles hasta que las pruebas pasan es una buena idea solo si las pruebas contra las que está haciendo bucles realmente afirman algo. Apidog mantiene las pruebas de contrato de API junto a la especificación para que esa puerta se mantenga íntegra a medida que los agentes, no solo los humanos, comienzan a enviar cambios a través de ella.