
NVIDIA ha lanzado el modelo de voz a texto de pesos abiertos más preciso del Hugging Face Open ASR Leaderboard, y puedes usarlo gratis hoy mismo. Nemotron 3.5 Transcribe (nombre completo NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) llegó el 28 de octubre de 2026 bajo la licencia OpenMDW-1.1, que permite uso comercial. Eso significa tres rutas de $0: el Space de demostración de NVIDIA, los pesos gratuitos en tu propia GPU y los Spaces de la comunidad que envuelven el mismo checkpoint.
Esta guía cubre cada ruta gratuita, lo que puede y no puede hacer, y la alternativa de pago más barata cuando lo gratis deja de ser suficiente. Cada dato proviene de la tarjeta oficial del modelo, el anuncio de lanzamiento de NVIDIA en Hugging Face y el Open ASR Leaderboard, todos consultados el 29 de octubre de 2026.
Si solo necesitas la API alojada, ve directamente a nuestra guía de la API de Nemotron 3.5 Transcribe.
¿Nemotron 3.5 Transcribe es gratis?
Sí, de dos maneras. Los pesos son gratuitos para descargar y la licencia permite uso comercial y no comercial, así que el autoalojamiento solo te cuesta el hardware. NVIDIA también tiene un Space de demostración gratuito en Hugging Face donde puedes probarlo en el navegador.
Lo que no es gratis: las API alojadas. DeepInfra cobra $0.002 por minuto de audio y OpenRouter lo lista a $0.000033 por segundo. Ninguna muestra una variante gratuita. Y a fecha del 29 de octubre de 2026, el modelo no aparece en build.nvidia.com, donde muchos modelos de NVIDIA obtienen una API de prueba gratuita. Una búsqueda allí de “transcribe” devolvió un modelo ASR en español no relacionado.
Por qué la gente lo quiere: los números
Nemotron 3.5 Transcribe es un modelo de lenguaje aumentado con voz. Un codificador ASR de 600M de parámetros y un codificador de hablante alimentan un modelo de lenguaje híbrido de mezcla de expertos Mamba-2 y Transformer. Tiene 34B de parámetros en total, pero solo unos 4.3B están activos por token, por eso se ejecuta en una sola GPU.
Lo que hace en un solo checkpoint:
- Transcripción en 40 idiomas, con 13 calificados como “líderes” (inglés, español, francés, alemán, hindi, coreano, portugués y otros)
- Grabaciones de hasta una hora en una sola solicitud (contexto de 65,536 tokens)
- Atribución de hablantes con hasta ocho hablantes etiquetados
- Marcas de tiempo a nivel de palabra mediante una cabeza de alineación CTC
- Traducción de voz hacia y desde el inglés en 31 idiomas
- Indicaciones de contexto: pasa nombres y jerga para que los escriba correctamente
- Respuesta a preguntas de audio (solo inglés)
En el Open ASR Leaderboard, actualizado el 28 de octubre de 2026, obtiene un WER promedio del 5.33%. Eso lo coloca en el 9.º lugar de 61 modelos. Los ocho por encima (Otter, Zoom Scribe v2 Pro, ElevenLabs Scribe v2, Azure Speech y otros) son todos API cerradas y de pago. Entre los modelos que puedes descargar, ninguno está mejor clasificado. El whisper-large-v3 de OpenAI ocupa el puesto 41 con 7.16%.
La propia tarjeta del modelo de NVIDIA reporta un WER medio del 4.71% en los nueve conjuntos públicos. El 5.33% del leaderboard añade dos conjuntos privados, así que ambos números son honestos; miden mezclas diferentes.
Un límite que debes conocer antes de empezar: es un modelo offline. Transcribe archivos grabados, no un flujo de micrófono en vivo.
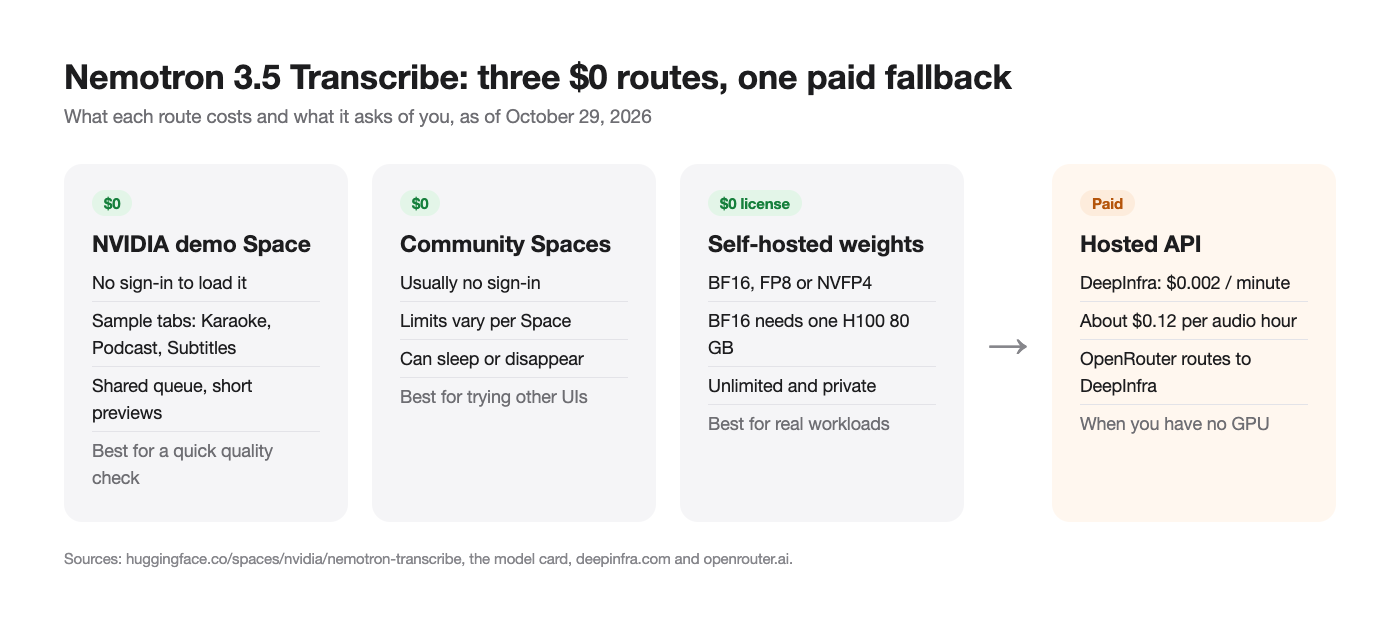
Todas las rutas gratuitas y de pago comparadas
| Ruta | Coste | Inicio de sesión | Límites | Ideal para |
|---|---|---|---|---|
Space de demostración de NVIDIA (nvidia/nemotron-transcribe) |
$0 | No | Vista previa de 60 segundos en las pestañas de muestra; cola compartida | Una comprobación rápida de calidad |
| Spaces de la comunidad | $0 | Normalmente no | Varía según el Space; puede dormirse o desaparecer | Probar otras interfaces |
| Pesos autoalojados (BF16, FP8, NVFP4) | Licencia de $0, tu GPU | Cuenta de Hugging Face para descargar | Una H100 de 80 GB para BF16; tarjetas más pequeñas necesitan FP8 o NVFP4 | Transcripción privada ilimitada |
| API de DeepInfra | $0.002 por minuto | Cuenta y clave de API | Uso de pago | Producción sin GPUs |
| OpenRouter | $0.000033 por segundo | Cuenta y créditos | Enrutado solo a DeepInfra | Una clave para muchos modelos |
| build.nvidia.com | Aún no listado | n/a | n/a | Estate atento a este espacio |
Solo las tres primeras filas no cuestan nada.
Ruta gratuita 1: el Space de demostración de NVIDIA
La forma más rápida de escuchar lo que el modelo puede hacer es el Space oficial de NVIDIA en huggingface.co/spaces/nvidia/nemotron-transcribe.
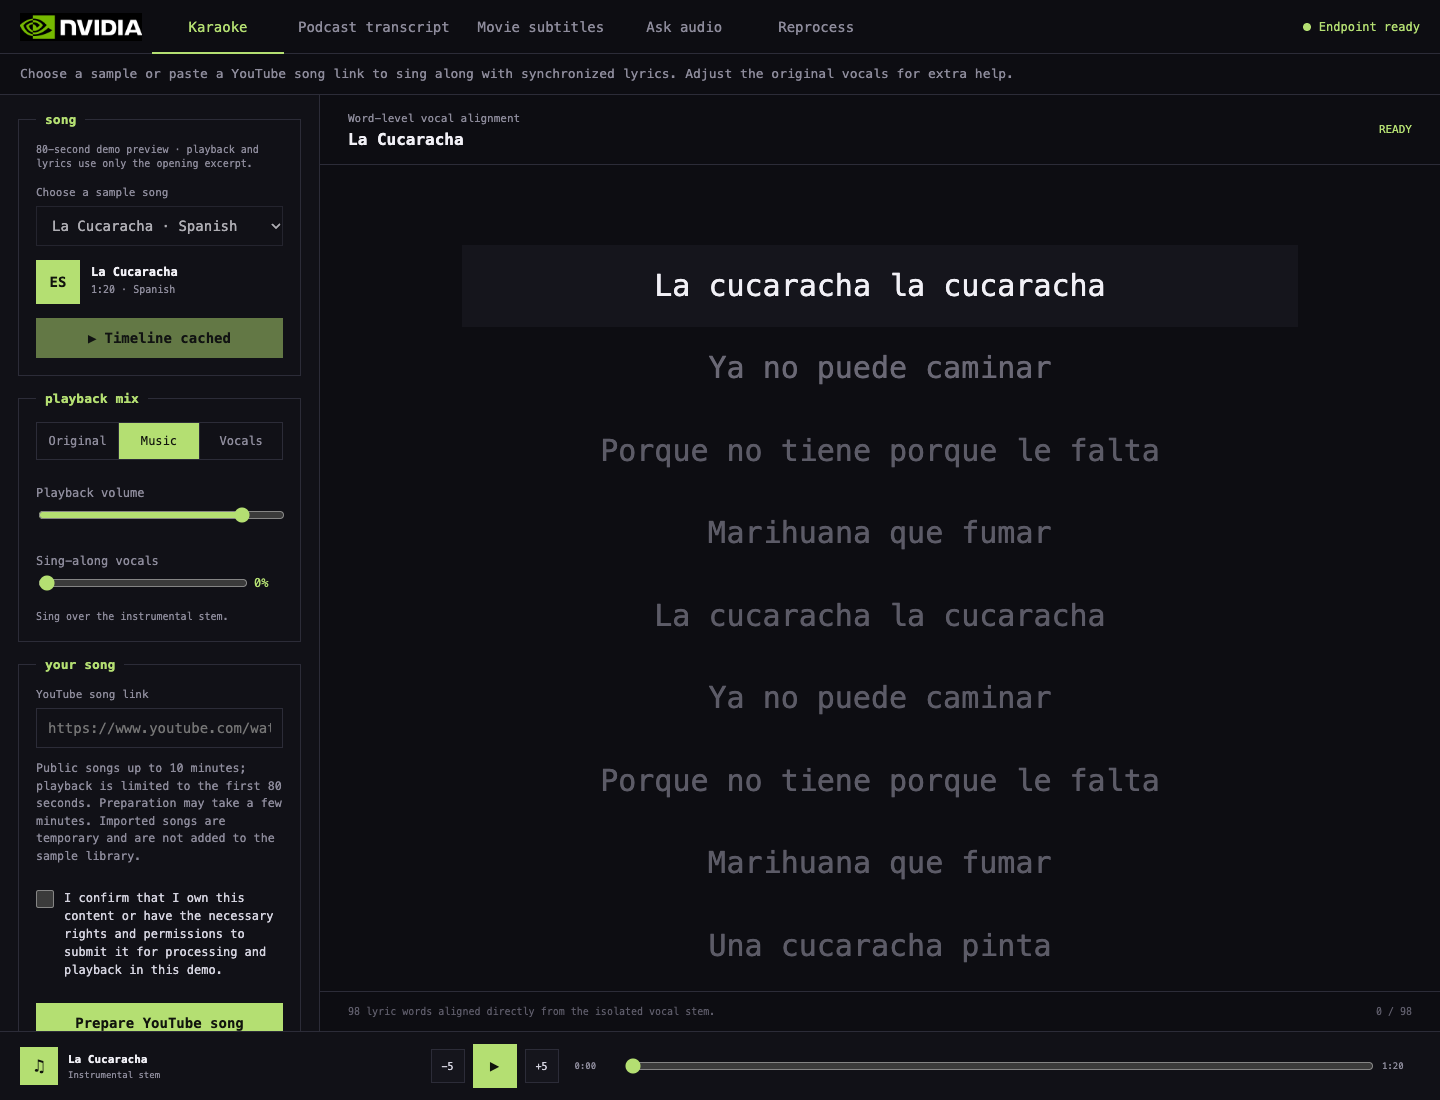
- Abre el Space en tu navegador. No se necesita cuenta para cargarlo.
- Elige una pestaña. El 29 de octubre de 2026 el Space tenía tres: Karaoke (letras cronometradas por palabra), Podcast transcript (texto con atribución de hablante) y Movie subtitles (subtítulos cronometrados).
- Elige una muestra o pega un enlace, según lo permita la pestaña. La pestaña Karaoke indica que su vista previa cubre los primeros 60 segundos.
- Ejecútalo y lee la salida. La vista Karaoke resalta cada palabra mientras se canta, lo que muestra las marcas de tiempo por palabra.
Trata el Space como una demo, no como una API gratuita. Los Spaces públicos comparten GPUs, ponen en cola las solicitudes y pueden cambiar sin aviso. No construyas un producto sobre uno.
Ruta gratuita 2: ejecuta tú mismo los pesos abiertos
Este es el verdadero nivel gratuito: transcripción ilimitada en hardware que ya tienes, sin que nada salga de tu máquina. La licencia (OpenMDW-1.1) permite uso comercial, así que puedes integrarlo en un producto.
El inconveniente es el hardware. La configuración de referencia de NVIDIA es una H100 de 80 GB en BF16. La tabla de compatibilidad en la tarjeta del modelo incluye:
- BF16: H100, H200, A100 80 GB, B200, GB200, DGX Spark
- FP8: H100, H200, L40S 48 GB
- Solo NVFP4: RTX 5090 (32 GB) y RTX PRO 6000 Blackwell
Así que una RTX 5090 de consumo funciona, con el checkpoint NVFP4. Las tarjetas más antiguas de 24 GB como la RTX 4090 no están en la lista.
La prueba más rápida solo necesita Transformers instalado desde el código fuente:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
Eso está bien para un puñado de archivos. Para lotes, grabaciones largas y un endpoint compatible con OpenAI, sírvelo con vLLM 0.32.0 y el plugin NeMo Speech. Nuestra guía paso a paso para ejecutar Nemotron 3.5 Transcribe localmente tiene la instalación exacta y el comando vllm serve de la tarjeta del modelo.
¿No tienes GPU local? Alquilar una por horas es la ruta “casi gratis” más barata para grandes acumulaciones. NVIDIA dice que una RTX PRO 6000 Blackwell puede procesar 100 horas de audio en menos de tres minutos con la compilación NVFP4, aunque esa cifra utiliza optimizaciones de servicio que aún no son de código abierto.
Ruta gratuita 3: Spaces de la comunidad
La página del modelo lista varios Spaces de la comunidad construidos sobre el mismo checkpoint, incluidos hugging-apps/nemotron-3-5-transcribe y mrfakename/nemotron-3.5-transcribe. Son útiles cuando la cola del Space de NVIDIA es larga o quieres un cuadro de carga simple. Los gestionan individuos, así que espera suspensiones, cuotas y algún que otro enlace roto.
Prompts que obtienen mejores resultados gratuitos
Nemotron 3.5 Transcribe acepta instrucciones en lenguaje natural. Estas provienen de la tarjeta del modelo y del listado de DeepInfra. Mantén el prompt del sistema vacío para transcripción y usa temperatura 0.
Texto limpio y legible:
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
Quién dijo qué:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Nombres de productos y jerga:
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
Traducción:
Please translate the given speech to English.
Los términos de contexto importan más de lo que esperarías. En el benchmark ContextASR de NVIDIA, el WER baja del 3.33% sin contexto al 1.71% con contexto detallado.
Cuando lo gratis no es suficiente: la ruta de pago más barata
Si no tienes una GPU compatible y necesitas más que una demo, la API alojada es barata. Con $0.002 por minuto de DeepInfra, una grabación de una hora cuesta $0.12, y 1,000 horas cuestan $120. Los $0.000033 por segundo de OpenRouter equivalen a unos $0.119 por hora, enrutados al mismo proveedor.
Una solicitud mínima a DeepInfra, tomada de su página de API:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
La respuesta incluye text, segments con tiempos de inicio y fin, words y el language detectado. Nuestra guía de la API explica en detalle las claves, los campos de respuesta y los costes.
Deja que tu agente de programación pruebe el endpoint con Apidog CLI
Tanto si autoalojas como si usas DeepInfra, quieres una comprobación que falle ruidosamente cuando una transcripción vuelve vacía o en el idioma equivocado. Delega esa tarea a tu agente de programación y a Apidog CLI en lugar de examinar el JSON a ojo.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Luego dale a tu agente un prompt:
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
El agente lee el esquema, valida su payload, escribe el caso y lo ejecuta:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Cambia el entorno para que apunte a tu servidor local cuando pases de la API al autoalojamiento. El mismo apidog run con -r junit se integra en CI; consulta ejecutar Apidog CLI en un pipeline de CI/CD y Apidog CLI en Claude Code para la configuración.
Límites que debes conocer antes de confiar en él
- Solo offline. No hace streaming. NVIDIA señala un modelo separado Nemotron 3.5 ASR Streaming para audio en vivo.
- Las preguntas y respuestas de audio son solo en inglés. La transcripción cubre 40 idiomas, pero la comprensión de audio y las instrucciones habladas se evaluaron solo en inglés.
- Las etiquetas de hablante no son identidades.
<spk:0>significa “la primera voz”, no una persona con nombre. - Las salidas largas necesitan espacio. Una conversación densa de una hora puede producir unos 20,000 tokens de salida, así que configura
max_new_tokensen consecuencia. - Puede alucinar. La tarjeta advierte que puede “generar una transcripción plausible” para audio poco claro. Revisa cualquier cosa legal o médica.
Preguntas frecuentes
¿Nemotron 3.5 Transcribe es gratis para uso comercial? Sí. La licencia OpenMDW-1.1 permite uso comercial y no comercial de los pesos. Las API alojadas cobran por cómputo.
¿Existe una clave de API gratuita de Nemotron 3.5 Transcribe? No que hayamos encontrado el 29 de octubre de 2026. DeepInfra y OpenRouter son de pago, y aún no está en build.nvidia.com. Compáralo con la API gratuita de NVIDIA para Nemotron Nano 12B v2 VL, que sí obtuvo un endpoint de prueba gratuito.
¿Puedo ejecutarlo en un Mac? No según la lista oficial. Los entornos de ejecución compatibles están dirigidos a GPUs NVIDIA en Linux o Windows (WSL2). El soporte de GGML se indica solo para RTX 5090 y RTX PRO 6000.
¿Cómo se compara con Whisper? En el leaderboard del 28 de octubre, promedia un WER del 5.33% frente al 7.16% de whisper-large-v3. Consulta nuestra guía de la API de Whisper para la opción alojada de OpenAI y nuestra clasificación de mejores modelos de voz a texto de código abierto para ver el panorama completo.
¿Admite MP3? Sí. Acepta WAV, FLAC, MP3, OGG o cualquier cosa que se decodifique a PCM mono de 16 kHz. Usa FFmpeg para convertir otros formatos.
La conclusión
Nemotron 3.5 Transcribe es gratis donde importa: los pesos, la licencia y la demo de NVIDIA. Prueba el Space para una comprobación de calidad, autoaloja en una H100, L40S o RTX 5090 para uso privado ilimitado, y recurre a DeepInfra a $0.12 por hora cuando no tengas el hardware. Elijas la ruta que elijas, deja que tu agente ejecute comprobaciones de Apidog en el endpoint para que una transcripción defectuosa nunca llegue a producción.