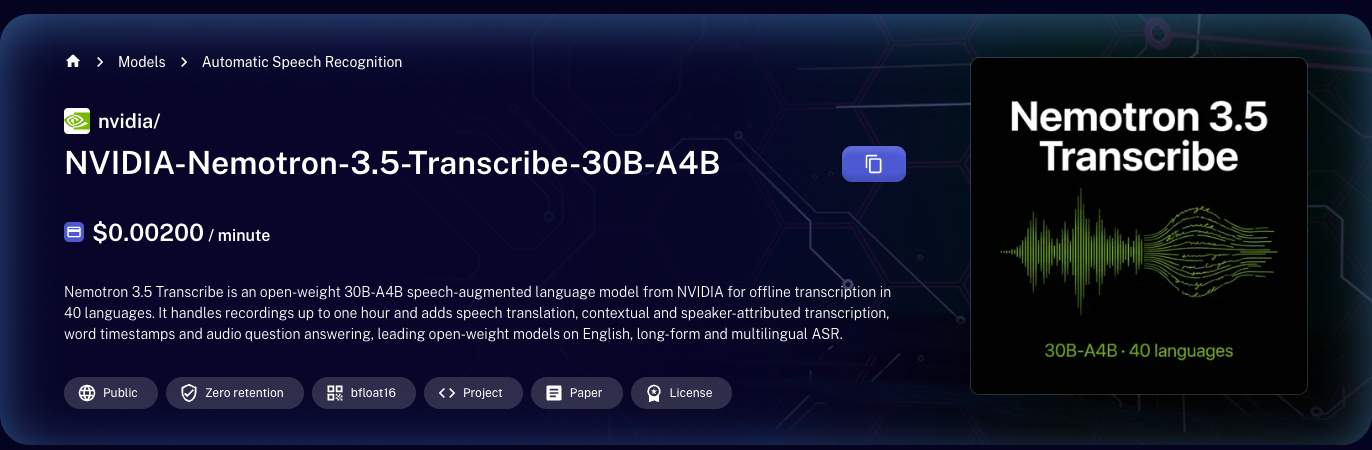
Transcribir una grabación de una hora con la nueva API Nemotron 3.5 Transcribe de NVIDIA cuesta 12 centavos. Ese es el precio de DeepInfra de $0.002 por minuto para el mejor modelo de pesos abiertos en la tabla de clasificación Open ASR de Hugging Face, un modelo que también devuelve marcas de tiempo de palabras, etiquetas de hablante y el idioma detectado en la misma llamada.
Esta guía muestra cómo obtener una clave de API, enviar tu primera solicitud, leer la respuesta, escribir prompts para etiquetas de hablante y jerga, y mantener los costos predecibles. Todo lo siguiente se verificó el 29 de octubre de 2026 con la página del modelo de DeepInfra, el listado de OpenRouter y la tarjeta oficial del modelo.
¿Buscas una ruta de $0 en su lugar? Lee cómo usar Nemotron 3.5 Transcribe gratis.
Qué te ofrece la API Nemotron 3.5 Transcribe
NVIDIA lanzó Nemotron 3.5 Transcribe (NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) el 28 de octubre de 2026. Es un modelo de voz de pesos abiertos con 34B de parámetros totales y aproximadamente 4.3B activos, construido sobre un modelo de lenguaje híbrido de mezcla de expertos Mamba-2 y Transformer con un codificador ASR y un codificador de hablante añadidos.
Desde un solo endpoint obtienes:
- Transcripción en 40 idiomas
- Archivos de hasta una hora de duración
- Marcas de tiempo de palabras y marcas de tiempo de segmentos
- Transcripciones atribuidas a hablantes con hasta ocho hablantes
- Traducción de voz entre 31 idiomas hacia y desde el inglés
- Prompts de contexto para nombres, productos y jerga
- Identificación de idioma
En la tabla de clasificación Open ASR (actualizada el 28 de octubre de 2026) promedia un 5.33% de WER, 9º de 61 modelos y primero entre los modelos con pesos públicos. Los ocho modelos por encima de él son API comerciales cerradas.
Es un modelo offline. Envía archivos grabados, no una transmisión en vivo.
Dónde llamarlo y cuánto cuesta
Con estas tarifas, 1000 horas de audio cuestan alrededor de $120. En comparación, la API OpenAI Whisper históricamente ha cobrado $0.006 por minuto, tres veces el precio de DeepInfra, y whisper-large-v3 ocupa el puesto 41 en la misma tabla de clasificación con un 7.16% de WER.
Paso 1: obtén una clave de API de DeepInfra
- Crea una cuenta en deepinfra.com.
- Abre el panel y crea una clave de API.
- Agrega un método de pago o créditos. La página del modelo requiere iniciar sesión incluso para la demostración en el navegador.
- Exporta la clave en tu shell:
export DEEPINFRA_API_KEY="your_key_here"
Mantén la clave fuera del control de código fuente. Si trabajas a través de un agente de codificación, ponla en el entorno del agente, no en un prompt.
Paso 2: transcribe tu primer archivo
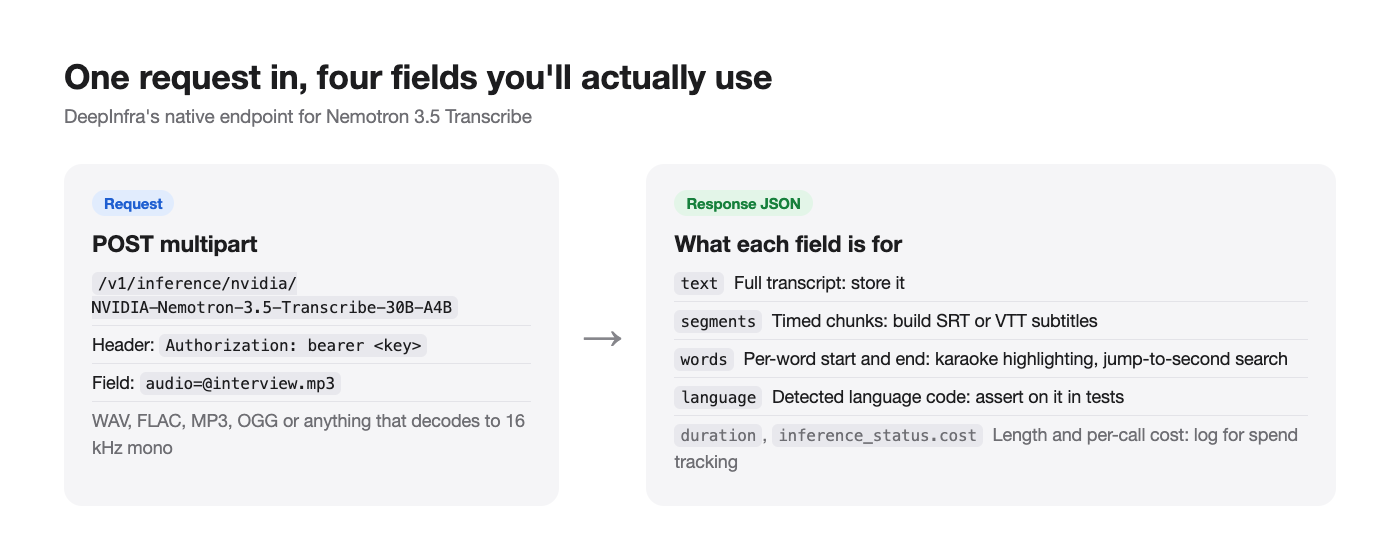
El endpoint de inferencia nativo de DeepInfra acepta una carga multipart con un campo audio. Esta es la forma exacta de la solicitud de su página de API:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
El modelo acepta WAV, FLAC, MP3, OGG o cualquier formato que se decodifique a PCM mono de 16 kHz. Si tienes archivos M4A o de video, conviértelos con FFmpeg primero:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
Paso 3: lee la respuesta
DeepInfra documenta esta forma de respuesta (los valores a continuación son ilustrativos):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
Para qué sirve cada campo:
textes la transcripción completa. Almacena esto.segmentsproporciona fragmentos cronometrados. Úsalos para subtítulos (SRT o VTT).wordsproporciona el tiempo por palabra. Úsalo para resaltado estilo karaoke o búsqueda que salta al segundo exacto.languagees el código de idioma detectado. Verifícalo en las pruebas; un idioma incorrecto es un fallo común en clips cortos.inference_status.costinforma cuánto costó la llamada. Regístralo para rastrear el gasto por archivo.
Paso 4: llámalo desde Python
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
Establece un tiempo de espera largo. Una hora completa de habla densa puede generar alrededor de 20,000 tokens de salida, y la tarjeta del modelo advierte que los trabajos largos tardan tiempo.
DeepInfra también incluye una pestaña "OpenAI Speech-to-Text" para el modelo, por lo que el código del SDK de OpenAI que llama a audio.transcriptions probablemente puede apuntar a la URL base compatible con OpenAI de DeepInfra. Consulta esa pestaña para obtener la URL base exacta antes de cambiar el código de producción.
Prompts: literal, limpio, hablantes, jerga
Lo que distingue a Nemotron 3.5 Transcribe de las API ASR más antiguas es que acepta instrucciones. Los prompts recomendados por NVIDIA, como se enumeran en la página de DeepInfra:
| Quieres | Instrucción |
|---|---|
| Palabras literales | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| Texto legible | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| Vocabulario del dominio | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| Quién dijo qué | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| Traducción | Please translate the given speech to <target language>. |
Usa temperatura 0 con razonamiento desactivado para transcripción, traducción e identificación de idioma, y mantén el prompt del sistema vacío.
Los términos de contexto valen la pena. NVIDIA informa que el WER de ContextASR-Bench cae del 3.33% sin contexto al 1.71% con contexto detallado, y el Earnings22 contextual del 12.54% al 9.58%. Para una llamada de ganancias, pasa los nombres de las empresas, tickers y nombres de ejecutivos.
Consulta la pestaña de esquema de entrada de DeepInfra para encontrar el campo que lleva la instrucción en el endpoint nativo. En un servidor autoalojado, la instrucción va en el mensaje de chat junto al audio, como se muestra en nuestra guía de configuración local.
Usar OpenRouter en su lugar
Si ya usas OpenRouter para LLMs, puedes mantener una clave y una factura. El ID del modelo es nvidia/nemotron-3.5-transcribe, con un precio de $0.000033 por segundo, con DeepInfra como el único proveedor listado el 29 de octubre de 2026 (100% de uptime, aproximadamente un segundo de latencia en ese momento). Copia el formato de solicitud de la pestaña de API del modelo en OpenRouter, ya que los endpoints de audio difieren de las finalizaciones de chat.
La contrapartida: OpenRouter agrega un salto de red, y hoy no hay conmutación por error de proveedor porque solo un proveedor sirve el modelo.
Mantén los costos predecibles
- Recorta el silencio primero. Pagas por minuto de audio, no por minuto de habla. Cortar el aire muerto de las grabaciones reduce la factura.
- Mezcla a mono y remuestrea. 16 kHz mono es lo que el modelo usa de todos modos; enviar estéreo a 48 kHz solo agrega tiempo de carga.
- Procesa por archivo, no por fragmento. El modelo maneja una hora en una sola solicitud. Dividir un archivo en piezas de 30 segundos rompe las etiquetas de hablante y el contexto.
- Registra
inference_status.cost. Súmalo por cliente o por trabajo. - Autoaloja por encima de un volumen constante. El NIM optimizado de NVIDIA procesa hasta 2,238 segundos de audio por segundo en una RTX PRO 6000 Blackwell. Si transcribes miles de horas al mes, una GPU alquilada supera el precio por minuto. Ten en cuenta que se espera que la ruta de vLLM de código abierto sea aproximadamente dos veces más lenta que esa cifra de NIM.
Deja que tu agente de codificación lo pruebe con Apidog CLI
Las API de transcripción fallan silenciosamente: un 200 con text vacío, un clip en español detectado como portugués, o words faltante después de una actualización del proveedor. En lugar de revisar el JSON a mano, deja que tu agente de codificación escriba y ejecute las comprobaciones con Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un prompt:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
El agente lee el esquema, valida su payload, escribe los casos y los ejecuta:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Agrega -r junit y el mismo comando se convierte en una puerta de CI. Consulta Apidog CLI en una canalización CI/CD y Apidog CLI en Claude Code para la configuración completa.
Preguntas frecuentes
¿Cuál es el precio de la API Nemotron 3.5 Transcribe? $0.002 por minuto en DeepInfra y $0.000033 por segundo en OpenRouter, a partir del 29 de octubre de 2026. Eso es aproximadamente $0.12 por hora de audio en cualquiera de los dos.
¿Hay una clave de API gratuita? No encontramos ninguna. El modelo aún no está en build.nvidia.com. Las rutas gratuitas son el Space de demostración de NVIDIA y el autoalojamiento; consulta la guía gratuita.
¿Cuál es la longitud máxima de archivo? Una hora por solicitud, con un contexto de 65,536 tokens.
¿La API transmite resultados? No. Es un modelo offline que devuelve la transcripción cuando el archivo termina.
¿Qué idiomas son compatibles? 40, clasificados en tres niveles. Los 13 idiomas "principales" incluyen inglés, español, francés, alemán, italiano, portugués, hindi, coreano, ruso y polaco. El japonés, turco y ucraniano están "listos para producción". El chino mandarín y el árabe están "compatibles".
¿Cómo se compara con otras API de voz? Consulta nuestra clasificación de mejores modelos de voz a texto de código abierto y la recopilación anterior de mejores API de texto a voz y voz a texto.
Comienza a transcribir
Obtén una clave de DeepInfra, envía un curl con un MP3, y recibirás texto con marcas de tiempo y etiquetado de idioma por $0.002 por minuto. Agrega términos de contexto para tu dominio, usa el prompt de hablante para reuniones, y haz que tu agente ejecute comprobaciones de Apidog en cada lanzamiento para que una regresión silenciosa nunca se publique.