
Mistral ha estado bastante callado en la gama alta durante un tiempo. Mistral Large 3 se lanzó en diciembre de 2025, y desde entonces la conversación sobre los modelos de vanguardia de código abierto se ha centrado en Kimi, DeepSeek, GLM y Qwen. El 6 de octubre de 2026, Mistral respondió con Mistral Large 4, un modelo de 1 billón de parámetros al que el equipo llama "Le Chonk".
La cifra principal es un benchmark de ciberseguridad donde Large 4 obtiene un 82%, mientras que Claude Opus 5.5 y GPT-6 Astra puntúan cerca de cero. Esto es cierto, está en la página de lanzamiento de Mistral, y necesita una frase de contexto antes de compartirlo. Este artículo le proporciona ese contexto, las especificaciones, el precio real y dónde Large 4 aún pierde.
TL;DR
- Qué es: un modelo de mezcla de expertos de 1.05 billones de parámetros con 49 mil millones de parámetros activos, un codificador de visión de 1.6 mil millones, entrada de texto e imagen, y una ventana de contexto de 1 millón de tokens.
- Dónde conseguirlo: vista previa pública en la API de Mistral hoy como
mistral-large-4. Pesos "para finales de mes", es decir, alrededor del 27 de octubre. - Precio: $1.36 de entrada / $4.18 de salida por millón de tokens según la lista, actualmente mostrado a **$0.68 / $2.09** durante la vista previa. La entrada en caché es de $0.07.
- La victoria cibernética: 82% en la prueba de reproducción de vulnerabilidades del Índice Cibernético de AA. Opus 5.5 y Astra puntúan cerca de cero **porque rechazan la tarea**, no porque fallen en ella.
- La verdadera derrota: en la codificación evaluada por humanos, Claude Opus 5 obtuvo 4.22 y Large 4 obtuvo 3.74.
Por qué "Mistral ha vuelto" es justo
Durante la mayor parte de 2026, los modelos de código abierto más potentes procedían de China. Mistral siguió lanzando modelos, con Medium 3.5, Devstral 2 y Small 4, pero nada que compitiera con los modelos cerrados de frontera en su propio terreno.
Large 4 cambia el panorama. Mistral afirma que "supera significativamente a cualquier modelo de código abierto desarrollado en EE. UU. o Europa", y lo respalda con una historia de entrenamiento diseñada para el público preocupado por la soberanía de la UE. El modelo fue entrenado desde cero en 3,800 GPUs NVIDIA Grace Blackwell en los propios centros de datos europeos de Mistral, cubre más de 160 idiomas, incluyendo todos los idiomas oficiales de la UE, y llega semanas después de una ronda de financiación Serie D de 3 mil millones de euros que Mistral califica como la mayor ronda de capital jamás recaudada por una empresa tecnológica europea.
El momento también importa. Large 4 llegó justo después de que Reflection presentara su modelo Beam de código abierto, por lo que la carrera de modelos abiertos entre EE. UU. y China ahora tiene un tercer contendiente serio.
El titular cibernético y el truco
Aquí está el resultado que todo el mundo está capturando. El Índice Cibernético de Artificial Analysis incluye una prueba que pide a un modelo que reproduzca una vulnerabilidad real en software de código abierto y luego la parche. Mistral dice que Large 4 obtiene un **82%, el más alto de cualquier modelo**.
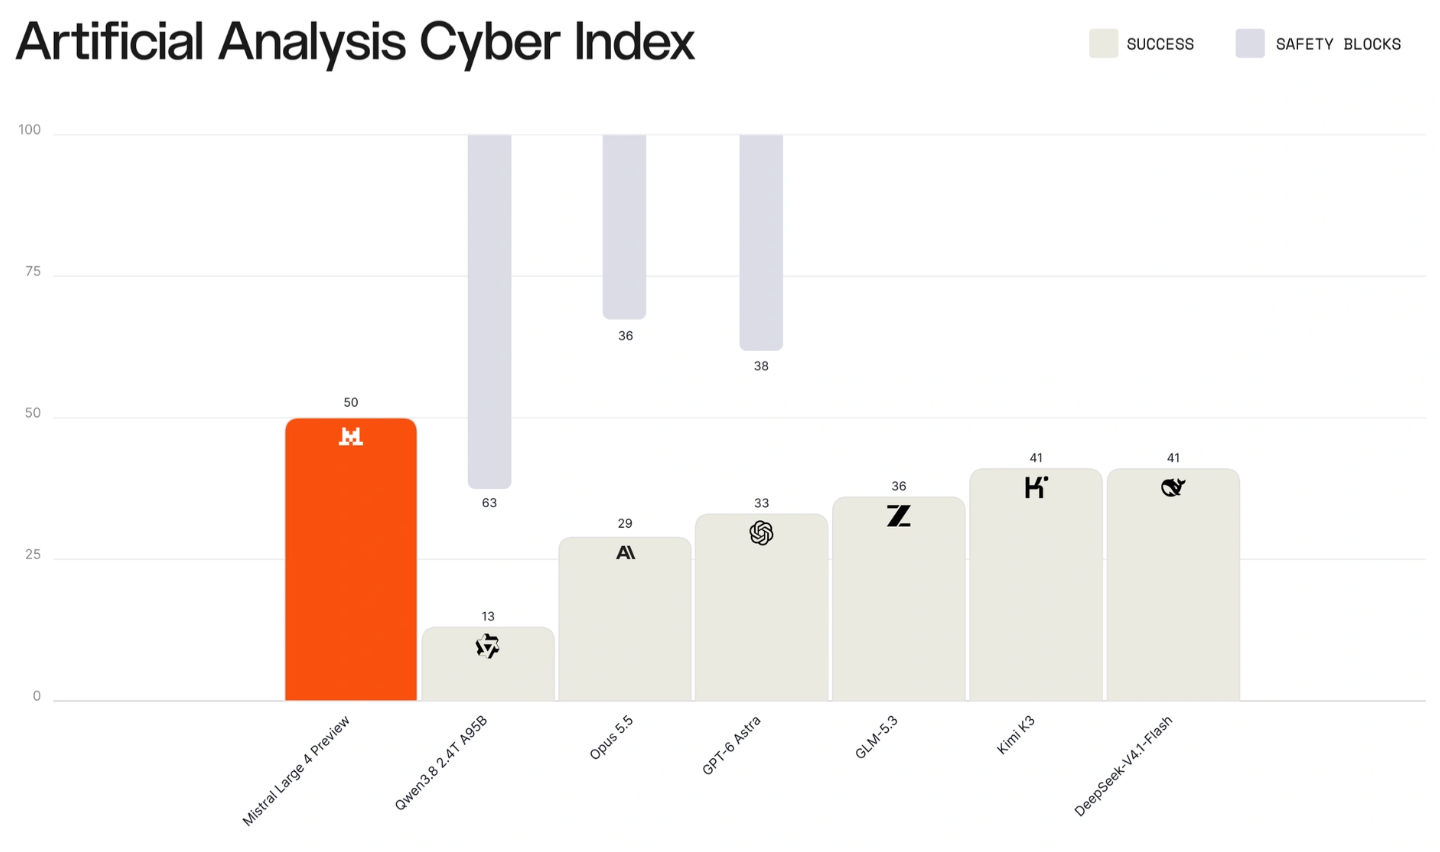
Luego, el truco, en palabras de Mistral: "Varios modelos cerrados líderes, incluidos Claude Opus 5.5 y GPT-6 Astra, puntúan cerca de cero en la misma prueba porque se niegan a realizar la tarea."
Así que léalo de esta manera:
| Afirmación | Lo que realmente significa |
|---|---|
| “Large 4 vence a Astra y Opus 5.5 en ciberseguridad” | En esta prueba específica, los modelos cerrados se niegan a responder. Large 4 responde y generalmente tiene éxito. |
| “Large 4 es el mejor modelo de hacking” | No establecido. Un rechazo es una elección de política, no un límite de capacidad. |
| “Large 4 es inseguro” | Tampoco establecido. Mistral informa que su tasa promedio de rechazo en las solicitudes cibernéticas de JailbreakBench, StrongREJECT y AgentHarm es más alta que la de cualquier otro modelo de código abierto. |
Hay una capacidad real detrás del titular. Large 4 también resuelve el 93% de Cybench, un conjunto de 40 ejercicios de "capture-the-flag", lo que Mistral califica como una de las puntuaciones más altas reportadas para un modelo de código abierto. En el B3 Agent Security Benchmark resiste el 93.3% de los ataques.
Para los equipos de seguridad, esa combinación es la verdadera historia: un modelo que puede autoalojar y que ayudará a reproducir y parchear una CVE en su propio código, mientras sigue rechazando la mayoría de las solicitudes claramente dañinas. Para los equipos de API, es una herramienta útil para tener en su propio hardware en lugar de detrás del filtro de políticas de otra persona.
Dónde Large 4 supera a GPT-6 Astra fuera del ámbito cibernético
El resultado cibernético es el que más ruido hace. Otras dos victorias contra Astra son más discretas y significativas, porque ambos modelos realmente intentaron la tarea:
| Benchmark | Mistral Large 4 | GPT-6 Astra | Notas |
|---|---|---|---|
| Dense 200 (fundamentación visual) | 42% | 41% | Una ventaja de un punto. Real, pero estrecha. |
| Finance Agent v2 (vals.ai) | Adelante | Atrás | Mistral informa el ranking, no las puntuaciones. |
| Harvey Legal Agent Benchmark | Mejor modelo abierto | Listado | No se publicó un número de enfrentamiento directo. |
Frente a otros modelos abiertos, la brecha es mayor:
| Benchmark | Mistral Large 4 | A quién supera |
|---|---|---|
| AutomationBench (657 flujos de trabajo) | 59.9% | Kimi K3, DeepSeek V4 Pro |
| AA-Briefcase (trabajo de conocimiento) | 1,393 Elo | DeepSeek V4 Pro |
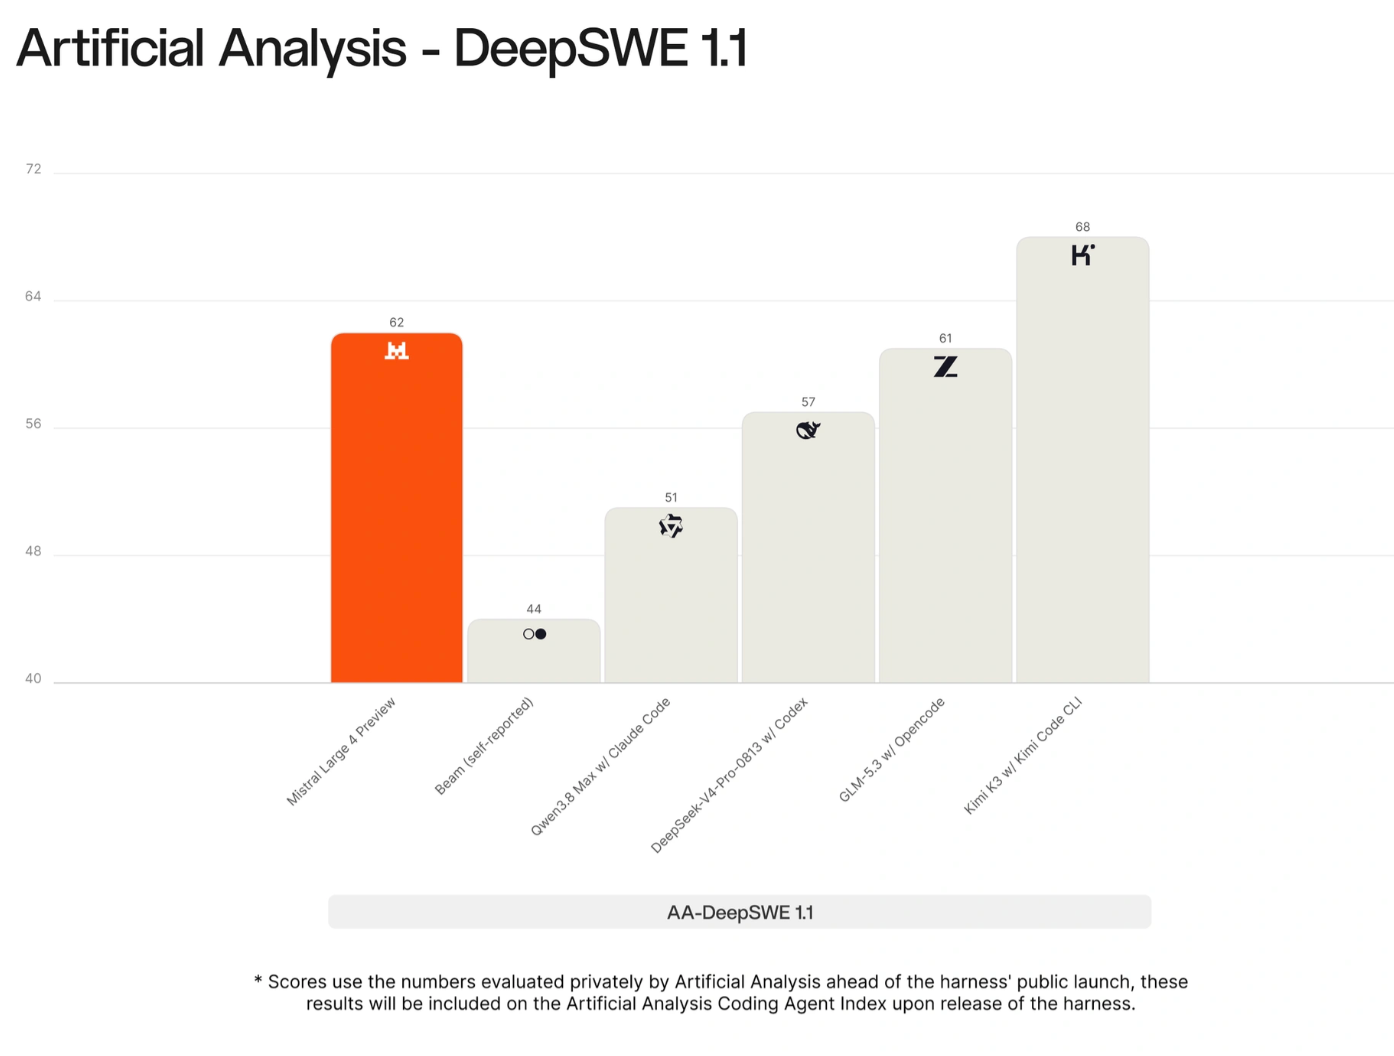
| DeepSWE v1.1 (codificación) | 61.7% | Lidera los modelos de código abierto |
| SWE-Atlas-QnA | 59.4% | |
| Terminal-Bench 4.0 | 28.3% |
Todos estos son números reportados por Mistral, de modelos en vista previa. Ningún laboratorio independiente los ha vuelto a ejecutar todavía, y Euronews informa que el aprendizaje por refuerzo aún estaba terminando en el momento del lanzamiento. Trátelos como una señal fuerte, no como un veredicto.
Dónde todavía pierde
Mistral publicó un resultado donde un modelo cerrado gana claramente. En una evaluación humana de la calidad de la codificación realizada por Surge AI en cinco modelos, Large 4 Preview ocupó el segundo lugar:
| Modelo | Puntuación de codificación humana (sobre 5) |
|---|---|
| Claude Opus 5 | 4.22 |
| Mistral Large 4 Preview | 3.74 |
| GLM-5.3 | 3.60 |
| Kimi K3 | 3.59 |
| GLM-5.2 | 3.40 |
Esa es una clara victoria sobre los mejores modelos abiertos chinos, y una brecha de medio punto detrás de Claude. La propia frase de Mistral es que Large 4 está "cerrando la brecha" con los modelos de frontera en codificación, lo cual es una lectura honesta.
También falta: no hay comparación contra Claude Fable 5.1 o GPT-6 Sol en ninguna parte de los materiales de lanzamiento. Si alguien le dice que Large 4 vence a Fable, pida el benchmark.
Especificaciones de un vistazo
| Especificación | Mistral Large 4 |
|---|---|
| ID del modelo API | mistral-large-4 (alias mistral-large-4-0) |
| Versión | 26.10, vista previa pública |
| Arquitectura | Mezcla de expertos, instrucción + razonamiento híbrido |
| Parámetros | 1.05T en total, 49B activos, codificador de visión de 1.6B |
| Ventana de contexto | 1 millón de tokens |
| Entrada | Texto, imágenes |
| Razonamiento | Parámetro reasoning_effort ("high" o "none") |
| Herramientas | Llamada a funciones, salidas estructuradas, herramientas de agente integradas |
| Endpoints | /v1/chat/completions, /v1/conversations, /v1/agents, /v1/batch |
| Pesos | Abiertos, para finales de octubre de 2026; licencia aún no publicada |
Precio: el modelo de clase frontera más barato que puedes usar hoy
Esta es la parte a la que los equipos de API deberían prestar atención. La página de precios de Mistral lista a Large 4 a la mitad de su precio de lista durante la vista previa:
| Modelo | Entrada / 1M | Salida / 1M | Pesos abiertos |
|---|---|---|---|
| Mistral Large 4 (precio de vista previa) | $0.68 | $2.09 | Sí, finales de octubre |
| Mistral Large 4 (precio de lista) | $1.36 | $4.18 | Sí, finales de octubre |
| Claude Opus 5.5 | $4.00 | $20.00 | No |
| GPT-6 Astra | $10.00 | $50.00 | No |
Con el precio de vista previa, la salida de Large 4 cuesta aproximadamente una veinticuatroava parte de la de Astra. Incluso al precio de lista, es aproximadamente 12 veces más barata en la salida. La entrada en caché baja a $0.07 por millón, lo cual es importante para los agentes que reenvían el mismo "system prompt" y definiciones de herramientas en cada turno.
Mistral no ha dicho cuándo termina el descuento de vista previa, así que presupueste según el precio de lista.
¿Debería cambiar?
Pruébelo ahora si:
- Ejecuta flujos de trabajo con agentes o automatización del trabajo de conocimiento y paga precios de frontera. AutomationBench y AA-Briefcase sugieren que Large 4 es competitivo aquí a una fracción del costo.
- Necesita salida multilingüe en los idiomas de la UE o inferencia alojada en la UE para el cumplimiento.
- Realiza trabajo de seguridad defensiva y sigue encontrando rechazos en la reproducción legítima de vulnerabilidades.
- Quiere un modelo de clase frontera que podrá autoalojar en unas pocas semanas.
Espere si:
- La calidad del código es su métrica principal. Claude sigue liderando en la codificación evaluada por humanos.
- Necesita números que pueda defender en una revisión. Espere a los benchmarks independientes después de que se lancen los pesos.
- Usted ejecuta Large 3 en producción. La vista previa aún puede cambiar, y Mistral aún no ha publicado un ID de versión estable.
Cómo probar Large 4 con sus propias APIs en Apidog
Los benchmarks le dicen cómo se desempeña un modelo en las tareas de otra persona. La forma más rápida de decidir es ejecutar Large 4 en sus propias indicaciones y compararlo con el modelo por el que paga hoy. Apidog lo maneja sin una línea de código "glue":
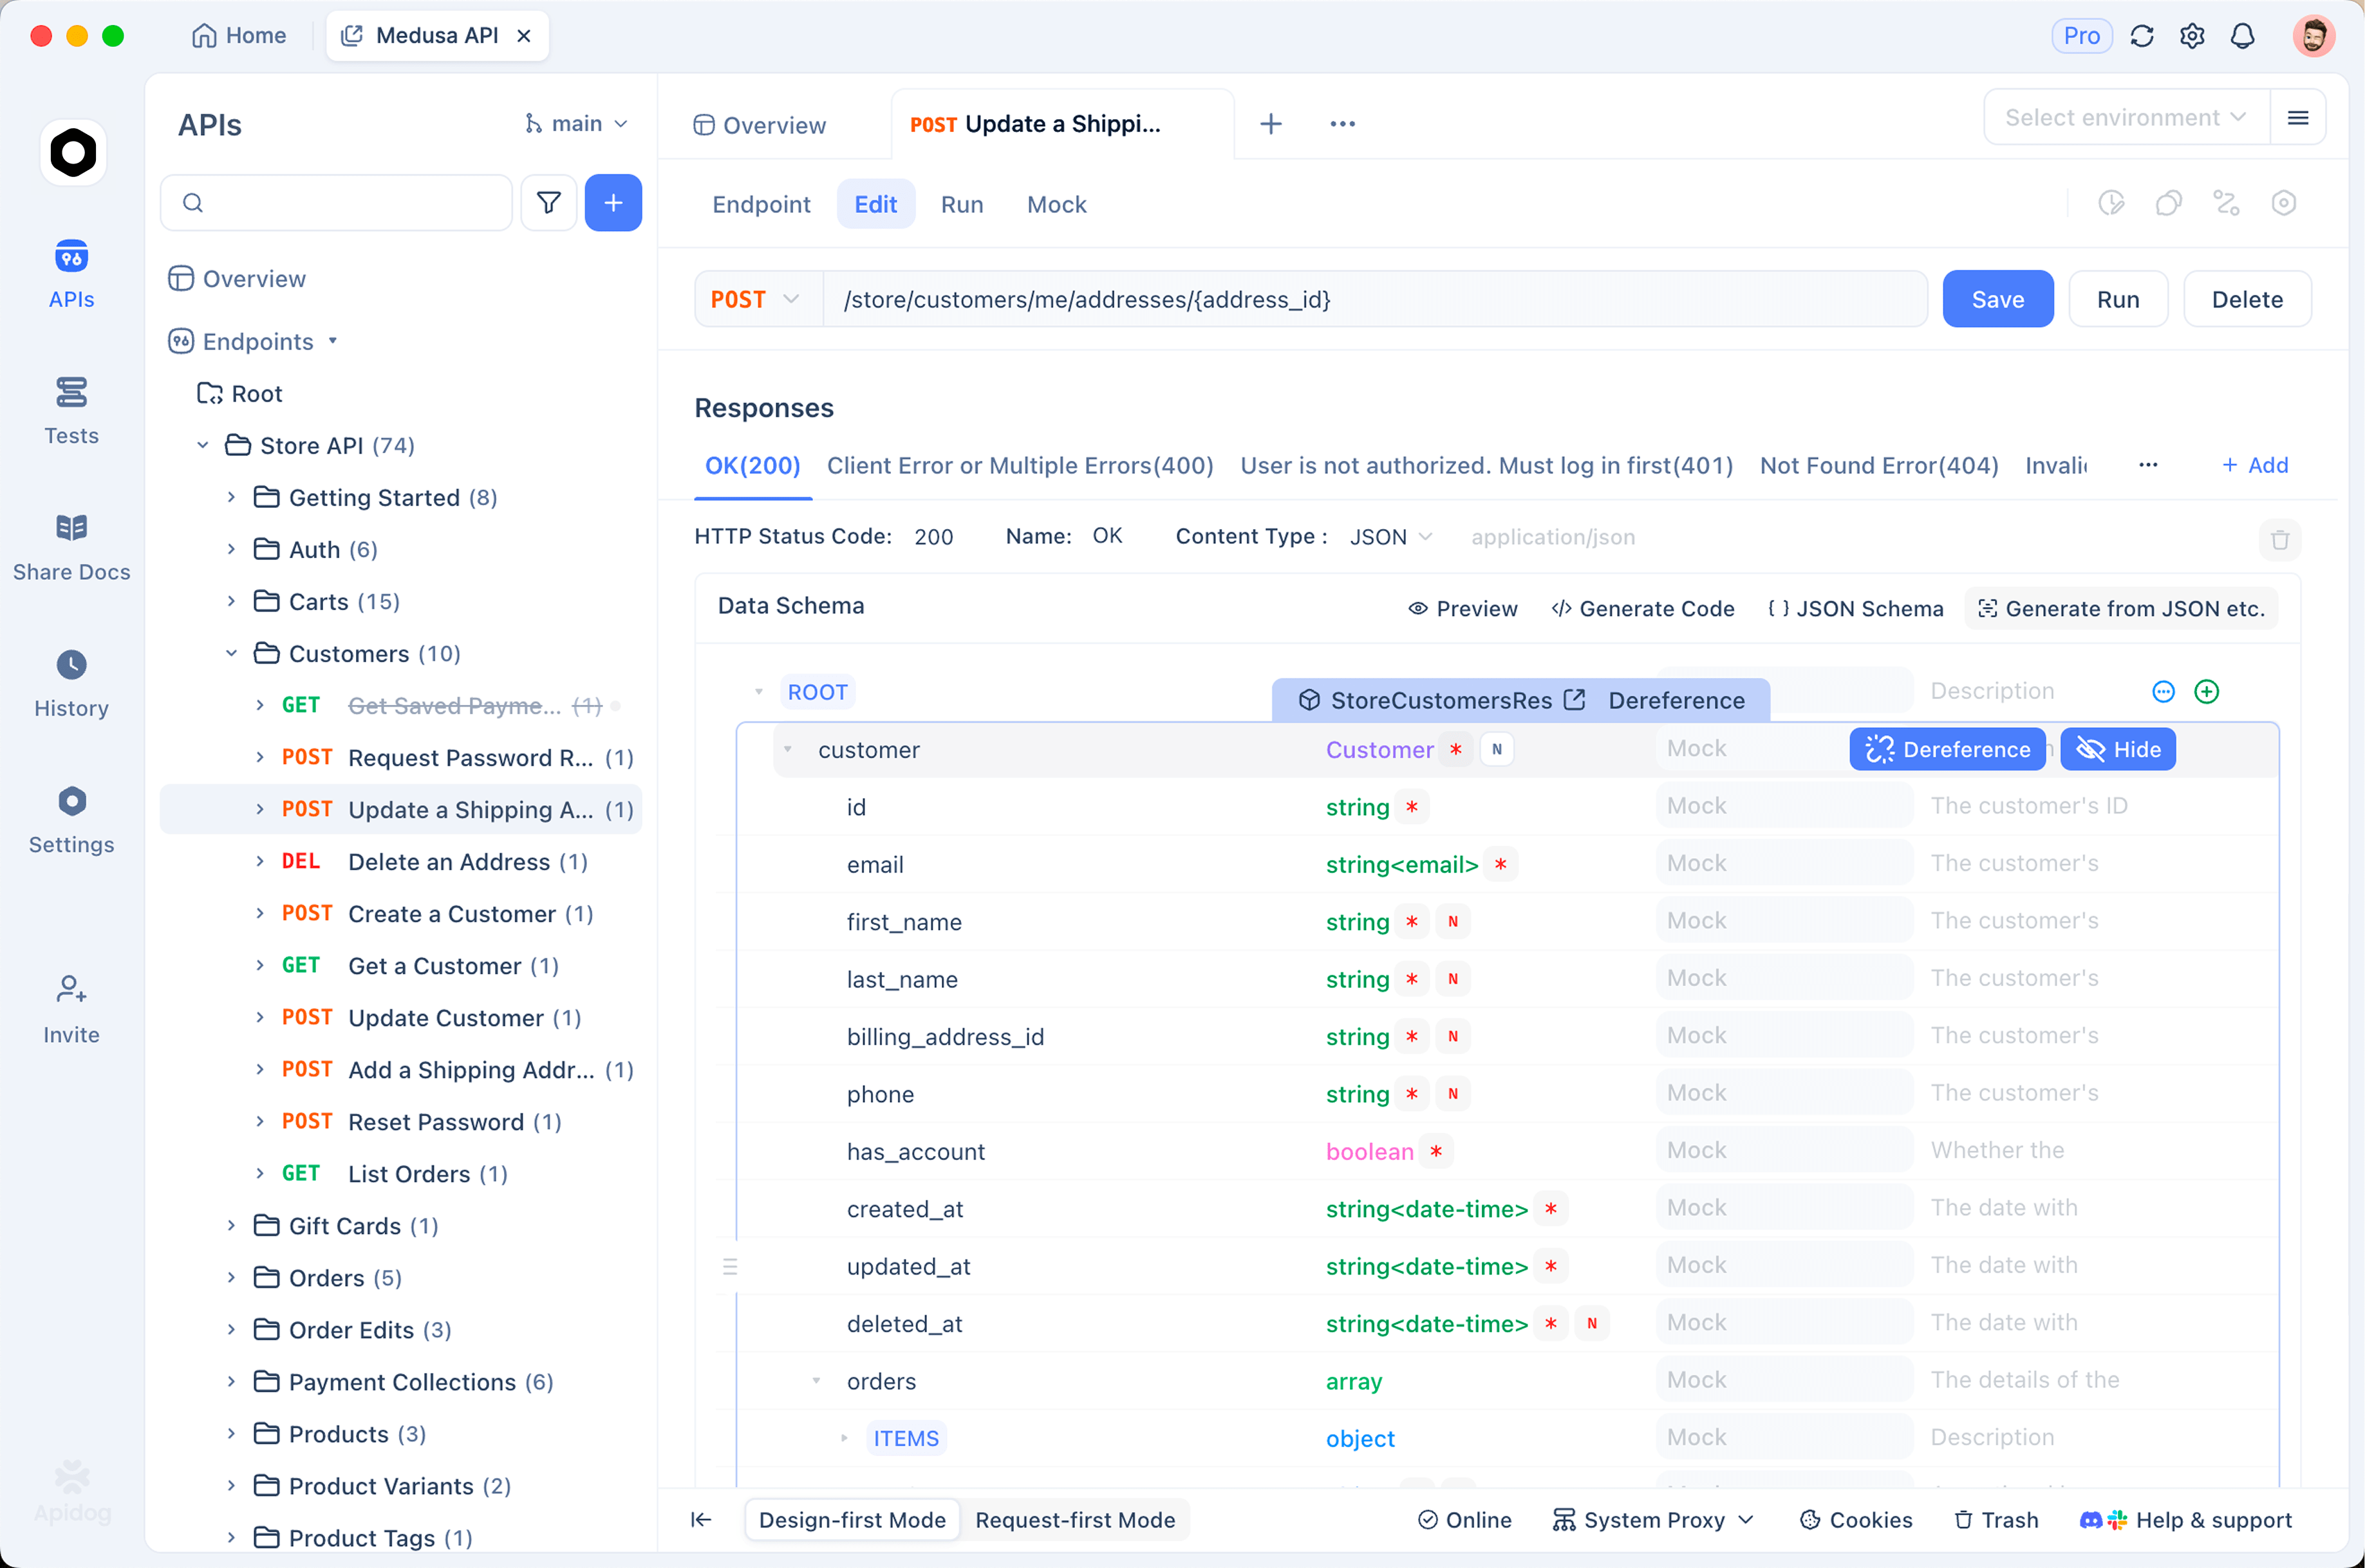
- **Guarde la solicitud una vez.** Cree
POST https://api.mistral.ai/v1/chat/completions, almacene su clave como una variable de entorno y configureAuthorization: Bearer {{MISTRAL_API_KEY}}. - **Clonarlo por modelo.** Duplique la solicitud, cambie solo el campo
model(mistral-large-4vs. su modelo actual) y envíe ambos. Apidog muestra la respuesta, el estado, la latencia y el tamaño uno al lado del otro, y el bloqueusagele da el recuento de tokens para una comparación de costos. - **Añada aserciones.** Verifique un estado
200, una respuesta no vacía y una coincidencia con el esquema JSON si solicita una salida estructurada. Esto convierte un experimento único en una prueba de regresión. - **Vuelva a ejecutarlo en cada actualización del modelo.** Agrupe las solicitudes en un escenario de prueba y vuelva a ejecutarlas cuando Mistral actualice la vista previa o envíe los pesos. Verá si la calidad ha disminuido antes que sus usuarios.
Dos fortalezas de Large 4 encajan naturalmente en el trabajo con APIs. Sus resultados de seguridad lo convierten en un buen segundo revisor para las pruebas de seguridad de API, por ejemplo, cuando reproduce un bypass de autenticación en su propia API de staging. Su llamada a funciones y salidas estructuradas le permiten convertir una especificación OpenAPI diseñada en Apidog en definiciones de herramientas que un agente puede invocar.
Para el recorrido completo del código, incluyendo claves, fragmentos de razonamiento, imágenes, llamada a funciones y cálculo de costos, consulte nuestra guía de la API de Mistral Large 4. ¿Viene de un modelo Mistral anterior? Los fundamentos de la API de Mistral AI y la guía de la API de Mistral Medium 3.5 siguen siendo válidos: misma URL base, misma autenticación, nuevo ID de modelo.
Preguntas frecuentes
¿Mistral Large 4 es de código abierto? Es de "pesos abiertos" (open-weight). Mistral dice que los pesos se enviarán a finales de octubre de 2026. La licencia aún no se ha publicado, así que no asuma que coincide con la Apache 2.0 de Large 3.
¿Mistral Large 4 realmente supera a GPT-6 Astra? En la fundamentación visual (42% vs 41%) y Finance Agent v2, sí, según los números de Mistral. En la prueba de vulnerabilidad cibernética, Astra puntúa cerca de cero porque se niega, por lo que no es una victoria directa comparable.
¿Supera a Claude? No en codificación. Claude Opus 5 lidera la evaluación de codificación humana 4.22 a 3.74. Claude Opus 5.5 también se niega a la tarea de reproducción cibernética, por lo que puntúa cerca de cero allí.
¿Qué significa "Le Chonk"? Es el apodo no oficial de Mistral para el modelo, una broma sobre su tamaño. El nombre oficial es Mistral Large 4, o ML4.
¿Puedo usarlo gratis? El plan gratuito de Mistral incluye $10 al mes en créditos de API y acceso a sus últimos modelos en Le Chat y Vibe. Con el precio de vista previa, $10 compran aproximadamente 4.8 millones de tokens de salida en Large 4.
Conclusión
Mistral está de vuelta en la conversación de frontera. Large 4 es el modelo de código abierto más potente fuera de China según los números de Mistral, cuesta una fracción de Astra u Opus 5.5, y se ejecutará en su propio hardware en cuestión de semanas. La frase "vence a Astra y Claude en ciberseguridad" es real pero proviene de rechazos, y el veredicto honesto en codificación es "segundo después de Claude". Pruébelo en sus propias APIs en Apidog ahora mientras dura el precio de vista previa, y posponga su decisión de producción hasta que lleguen los benchmarks independientes después del 27 de octubre.