
Los pesos abiertos de Mistral Large 4 se publicaron en Hugging Face el 29 de octubre de 2026. Obtienes el mismo modelo de 1,05 billones de parámetros que Mistral sirve en su API, bajo una licencia MIT modificada, en checkpoints FP8 y NVFP4 más cuantizaciones GGUF de la comunidad. Puedes descargarlo sin un paso de aprobación, servirlo en 8 GPU de centro de datos con vLLM o SGLang, o saltarte el hardware y llamar a mistral-large-4 en la API de Mistral por $0,70 por millón de tokens de entrada.
A continuación: qué cambió desde la vista previa del 6 de octubre, tamaños de descarga, hardware por ruta y la licencia. Para la descripción general del modelo, lee nuestro análisis del lanzamiento de Mistral Large 4; para formatos de solicitud y código del SDK, consulta la guía de la API de Mistral Large 4.
¿Qué son los pesos abiertos de Mistral Large 4?
Los pesos abiertos de Mistral Large 4 son los checkpoints descargables del modelo insignia de Mistral, apodado "Le Chonk". Es un modelo multimodal de mezcla de expertos con aproximadamente 1,05 billones de parámetros totales, unos 49 mil millones activos por token (52 mil millones contando embeddings y capas de salida), un codificador de visión de 1,6 mil millones y una ventana de contexto de 1 millón de tokens, publicado bajo la Licencia de Pesos Abiertos del Ecosistema Mistral.
La tarjeta del modelo oficial enumera 72 capas de texto y 128 expertos enrutados, con 4 elegidos por token más 1 experto compartido.
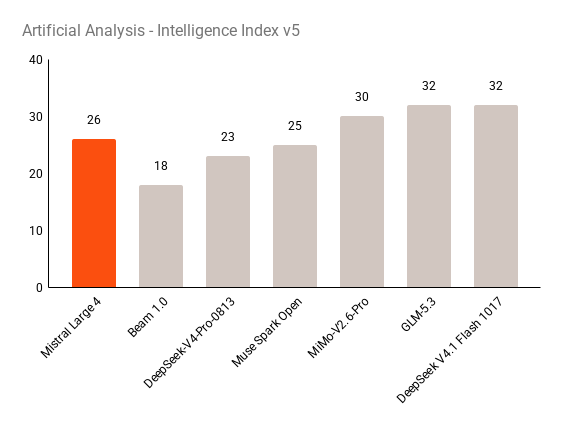
El lanzamiento no es una copia congelada de la vista previa. El anuncio de pesos abiertos de Mistral dice que el modelo recibió tres semanas más de aprendizaje por refuerzo centrado en codificación y ciberseguridad antes de que se publicaran los pesos.
Qué cambió desde la vista previa del 6 de octubre
Si probaste Large 4 durante la vista previa, ahora hay cuatro cosas diferentes.
| Área | Vista previa del 6 de octubre | Lanzamiento abierto del 29 de octubre |
|---|---|---|
| Pesos | Solo API, pesos prometidos para después | FP8 y NVFP4 en Hugging Face, sin restricciones |
| Modos de razonamiento | high o none |
low, medium, high (predeterminado high); low reemplaza a none |
| Terminal-Bench 4.0 (según Mistral) | 28% | 41%, con aproximadamente un 30% menos de tokens de salida |
| Resistencia a ataques de B3 Agent Security (según Mistral) | 93,3% | 97,1% |
| Precio de API por 1M tokens | Mostrado con descuento de vista previa | $0,70 entrada, $0,07 entrada en caché, $2,10 salida |
El cambio de razonamiento rompe el código. Si tu integración de vista previa envía reasoning_effort: "none", cámbialo a "low": la publicación de lanzamiento en Hugging Face señala que Transformers ejecuta none como high, por lo que una configuración obsoleta cuesta tokens en lugar de fallar.
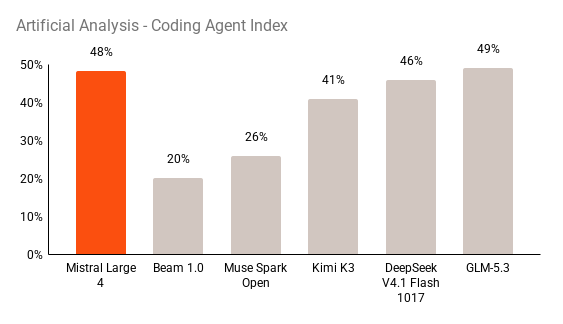
Todas las cifras de benchmark en esta publicación son reportadas por el proveedor. Mistral también afirma un 19,7% en el benchmark privado FrontierCode 2.0 de Cognition, la puntuación más alta de pesos abiertos en su gráfico, y un 48% en el Artificial Analysis Coding Agent Index, prácticamente empatado con GLM-5.3. La replicación independiente aún estaba pendiente cuando lo verificamos el 2 de noviembre.
Tres formas de ejecutar Mistral Large 4
Tienes tres rutas, y la correcta depende de cuánto hardware controlas.
- Llamar a la API de Mistral. Id del modelo
mistral-large-4, $0,70 entrada, $0,07 entrada en caché y $2,10 salida por millón de tokens. Sin GPU. - Usar un proveedor alojado. Mistral lista OpenRouter, endpoints alojados por NVIDIA y un contenedor NIM, y Microsoft Foundry, que también ofrece implementaciones privadas en Azure.
- Autoalojar los pesos. Descarga desde Hugging Face y sirve con vLLM, SGLang, Transformers o llama.cpp en tus propias máquinas.
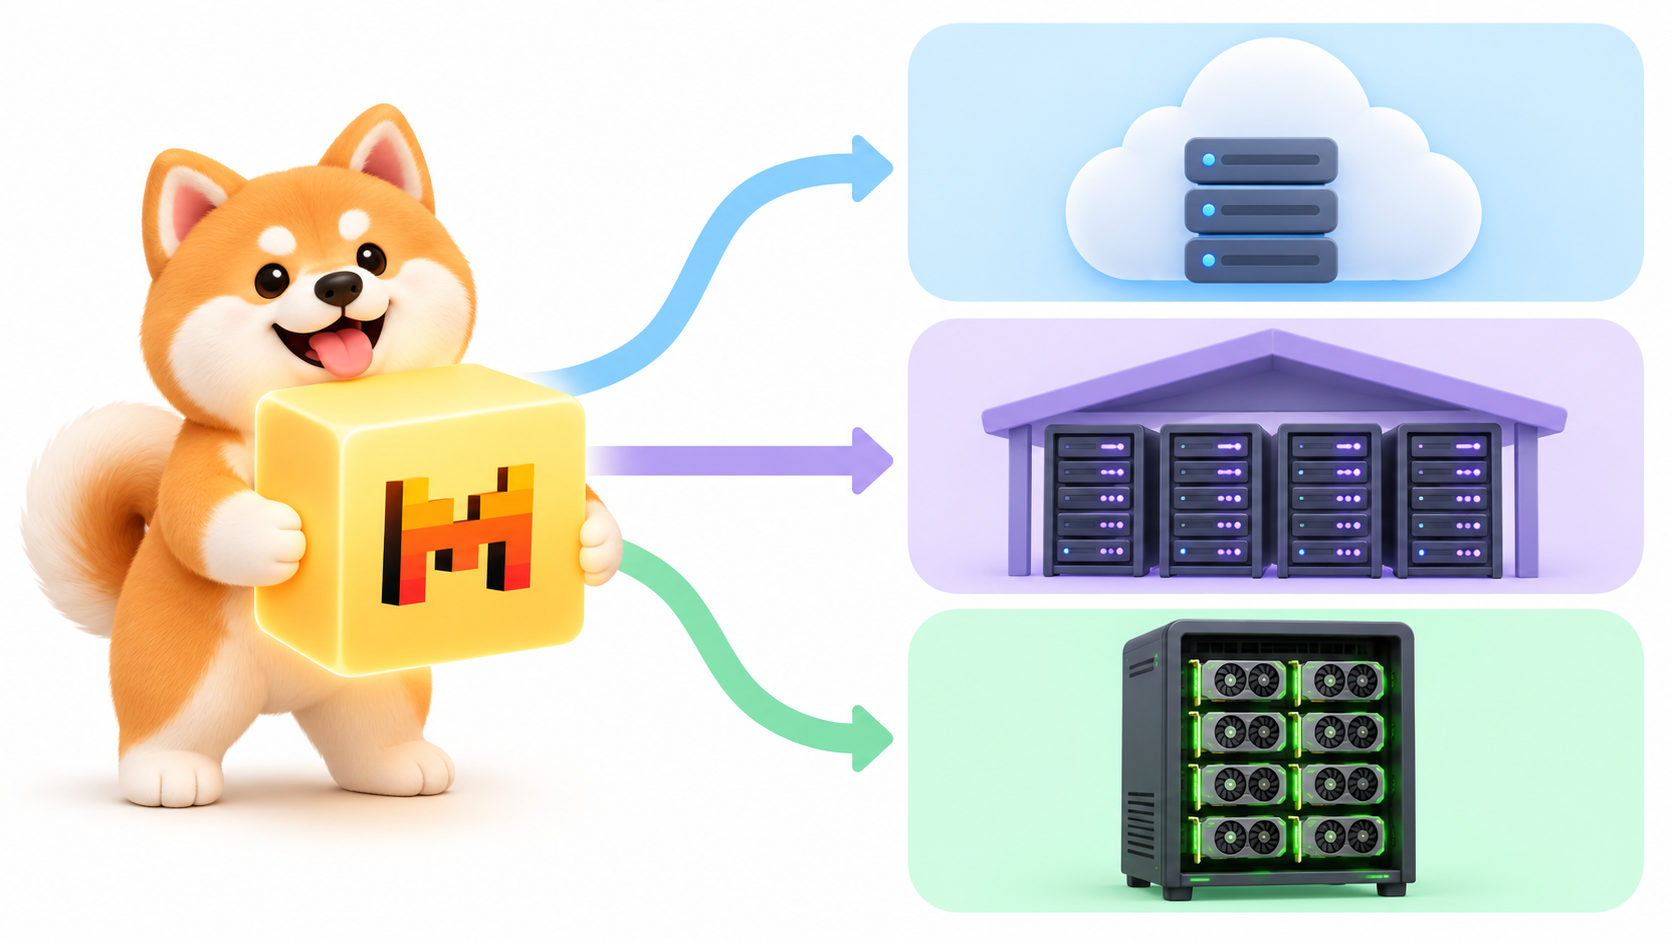
Empieza por la ruta 1 o 2. Pasa a la ruta 3 por una razón concreta: datos que no pueden salir de tu red, un ajuste fino que necesitas poseer, o un volumen que mantiene ocupado un nodo de 8 GPU.
Cómo descargar Mistral Large 4
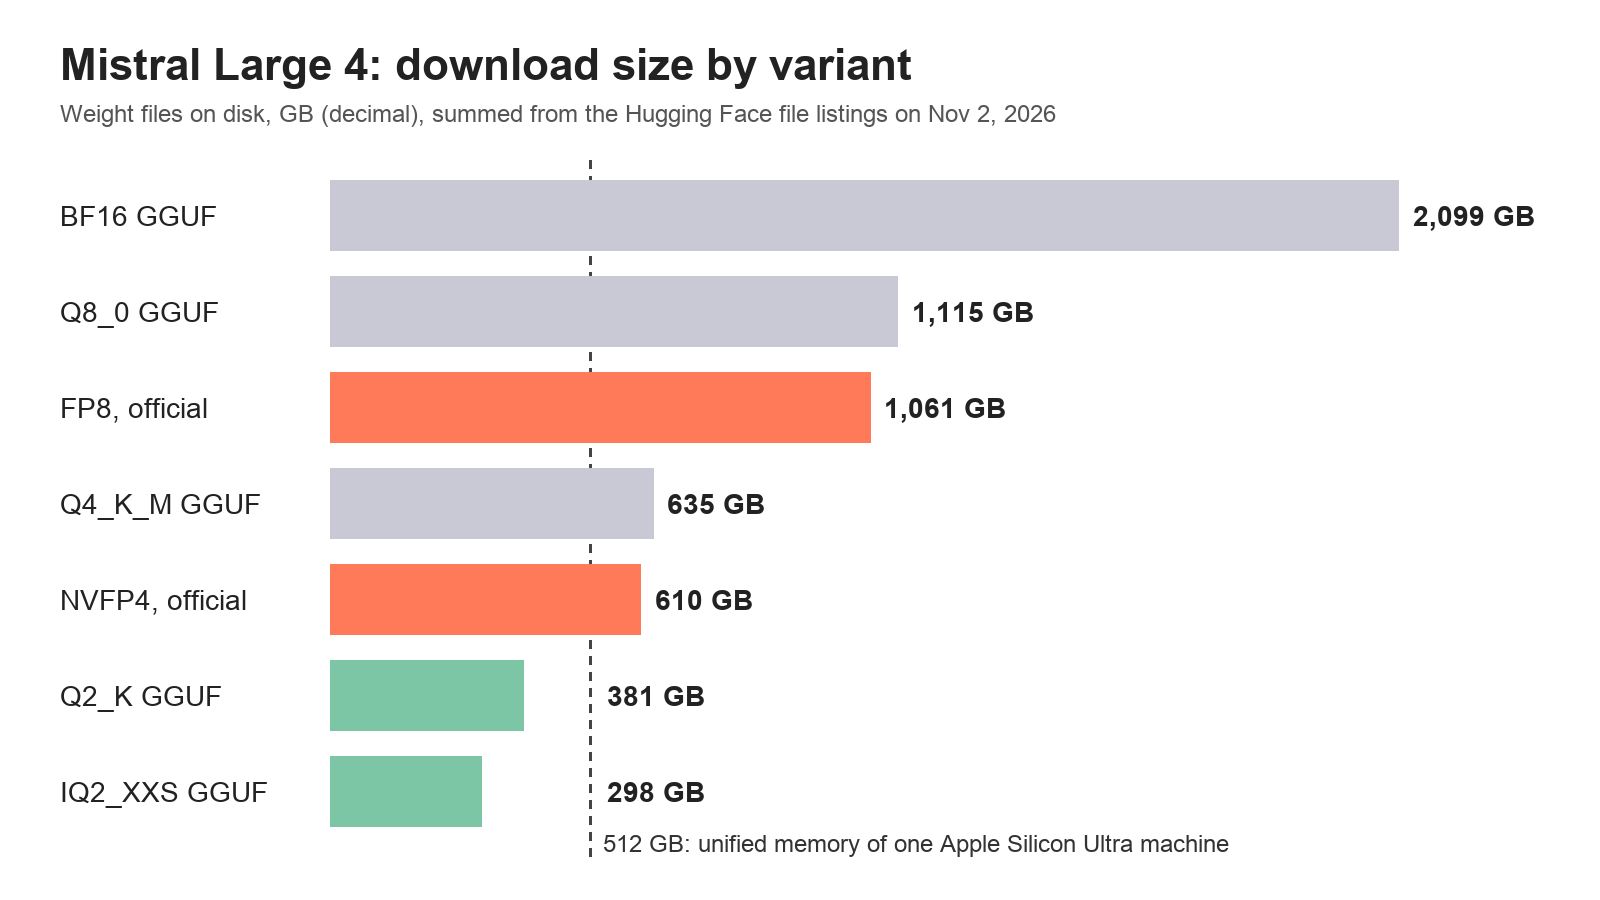
Los repositorios oficiales no están restringidos (la API de Hugging Face reporta gated: false para ambos), así que cualquier cuenta o cliente anónimo puede descargarlos. El tamaño es la verdadera barrera.
| Repositorio | Formato | Tamaño en disco |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, oficial | aproximadamente 1.061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, oficial | aproximadamente 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | aproximadamente 1.115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | aproximadamente 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | aproximadamente 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | aproximadamente 298 GB |
Sumamos estos datos del listado de archivos de cada repositorio el 2 de noviembre de 2026. Unsloth también publica cuantizaciones GGUF bajo unsloth/Mistral-Large-4-1T-A52B-GGUF.
Descarga solo los archivos que necesitas con la CLI de Hugging Face:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
La descarga de FP8 tarda un poco más de dos horas a 1 Gbps sostenidos.
Cómo autoalojar Mistral Large 4
Todos los ejemplos oficiales de servicio asumen un nodo con 8 GPU y paralelismo de tensores de 8. Esto es lo que espera cada motor.
| Motor | Checkpoint | Hardware en los ejemplos oficiales |
|---|---|---|
| vLLM | FP8 | 8 GPU, --tensor-parallel-size 8; Hugging Face Inference Endpoints usan 8x H200 |
| vLLM | NVFP4 | 8 GPU NVIDIA Blackwell |
| SGLang | FP8 | 8 GPU, --tp-size 8 |
| Transformers | FP8 | 8 GPU vía torchrun |
| llama.cpp | Q2_K GGUF | Una máquina Apple Silicon Ultra con 512 GB de memoria unificada |
vLLM
La tarjeta del modelo recomienda vLLM e incluye una imagen Docker dedicada:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Mantén ambas banderas de parser, o el texto de pensamiento terminará en content y las llamadas a herramientas llegarán como texto sin formato. Para una decodificación más rápida, la tarjeta documenta un decodificador especulativo DSpark opcional: añade --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'.
En 8x H200 con ese drafter, Hugging Face midió aproximadamente 65 tokens por segundo para una solicitud y aproximadamente 480 tokens por segundo en total en 1.000 conversaciones de ShareGPT bajo carga.
SGLang también funciona: el ejemplo de sglang serve de la tarjeta del modelo usa --tp-size 8, --speculative-algorithm DSPARK y parsers de razonamiento y llamadas a herramientas en auto.
llama.cpp en una Mac
El equipo de llama.cpp lanzó soporte desde el día 0. La cuantización Q2_K (381 GB) cabe en una máquina Apple Silicon Ultra con 512 GB de memoria unificada:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face reporta aproximadamente 90 tokens por segundo de prefill y 15 de generación en una M3 Ultra: bien para experimentos privados, lento para un bucle de agente. Una cuantización de 2 bits también pierde calidad, así que pruébala primero en tus propias tareas.
El muestreo recomendado por Mistral es temperature=1.0 y top_p=0.95 en todos los niveles de razonamiento.
Llamar a tu modelo autoalojado
vLLM y SGLang exponen un servidor compatible con OpenAI, por lo que la solicitud se ve igual que cualquier finalización de chat:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
En la API alojada, envía el mismo cuerpo a https://api.mistral.ai/v1/chat/completions con "model": "mistral-large-4" y una clave Bearer. La documentación del servidor compatible con OpenAI de vLLM enumera los campos que acepta.
Deja que Claude Code pruebe ambos endpoints con Apidog CLI
Un modelo autoalojado falla en silencio: una bandera de parser faltante filtra el razonamiento en content, o una llamada a herramienta vuelve como texto plano. Deja que tu agente de codificación verifique ambas rutas con Apidog CLI en lugar de pegar comandos curl a mano.
Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Luego dale a Claude Code un prompt:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
El agente lee cada esquema, valida su payload y ejecuta el caso:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Añade --upload-report para ver la ejecución en la aplicación Apidog, o pon la misma línea apidog run ... -r junit en CI para que una actualización de vLLM no pueda publicarse con llamadas a herramientas rotas. Nuestra guía de Apidog CLI en Claude Code cubre la configuración con más detalle. El plan gratuito de Apidog cubre hasta 4 usuarios.
La licencia: qué puedes y qué no puedes hacer
La Licencia de Pesos Abiertos del Ecosistema Mistral es MIT con una condición adicional.
Puedes: ejecutar, implementar, ajustar y modificar el modelo y sus derivados, para uso comercial y no comercial, siempre que conserves el aviso de copyright y permiso en las copias.
Necesitas una licencia comercial separada de Mistral si: lo ejecutas como un "Modelo como Servicio", que la licencia define como dar a un tercero acceso al modelo o sus derivados para inferencia o post-entrenamiento.
Esa condición no se aplica a: uso interno, productos de usuario final donde el modelo se encuentra dentro de características o arneses específicos, simplemente retransmitir solicitudes a un modelo que otro aloja, y uso a través de los propios productos de Mistral.
Un asistente de codificación interno o una característica de producto construida sobre el modelo está bien; revender inferencia en bruto necesita un acuerdo. Esto es un resumen, no asesoramiento legal.
Para un recorrido similar en otro modelo de pesos abiertos, consulta nuestra guía de autoalojamiento de GLM-5.3.
¿Deberías autoalojar o llamar a la API?
Llama a la API cuando tu volumen sea moderado, quieras el contexto de 1M sin ajustar límites del servidor, o no tengas ya nodos de 8 GPU. A $0,70 de entrada y $2,10 de salida por millón de tokens, 100 millones de tokens de entrada más 20 millones de tokens de salida al mes suman $112, antes de cualquier descuento por caché.
Autoaloja cuando tus datos no puedan salir de tu red, cuando quieras poseer un ajuste fino (Hugging Face muestra entrenamiento LoRA con TRL en un nodo 8x B300), o cuando un volumen constante mantenga ocupado un nodo. El servicio Forge de Mistral es la opción gestionada para ajustar con tus propios datos.
Preguntas frecuentes
¿Los pesos abiertos de Mistral Large 4 son gratuitos para descargar?
Sí. Ambos repositorios oficiales en Hugging Face no están restringidos, así que puedes descargarlos sin solicitar acceso. Ejecutarlos es el costo: el checkpoint oficial FP8 es de aproximadamente 1.061 GB y los ejemplos de servicio usan 8 GPU de centro de datos.
¿Puedo ejecutar Mistral Large 4 en una sola GPU?
Ninguna receta oficial cubre una sola GPU. Todos los ejemplos de vLLM, SGLang y Transformers usan 8 GPU con paralelismo de tensores. La configuración documentada más pequeña es llama.cpp con la cuantización Q2_K de 381 GB en una máquina Apple Silicon Ultra con 512 GB de memoria unificada.
¿Mistral Large 4 es de código abierto?
Son pesos abiertos, no código abierto en el sentido de la OSI. Obtienes los pesos bajo una licencia MIT modificada que permite uso comercial, pero ofrecer el modelo a terceros como servicio de inferencia o post-entrenamiento necesita una licencia comercial separada de Mistral.
¿El modelo de pesos abiertos es el mismo que el modelo de la API?
Mistral dice que el checkpoint publicado recibió tres semanas más de aprendizaje por refuerzo después de la vista previa del 6 de octubre, y la API sirve el modelo actualizado como mistral-large-4. Los modos de razonamiento también cambiaron: usa low, medium o high.
¿Cuánto cuesta la API de Mistral Large 4?
Mistral lista $0,70 por millón de tokens de entrada, $0,07 por millón de tokens de entrada en caché y $2,10 por millón de tokens de salida, a partir del 2 de noviembre de 2026.