MCP frente a CLI se reduce a cuándo paga tu agente por una herramienta. Un servidor MCP envía el nombre, la descripción y el JSON Schema de cada herramienta al modelo antes de que escribas nada. Una CLI no cuesta nada hasta que el agente la ejecuta y lee su --help o su salida. En una configuración medida, cuatro servidores MCP habituales sumaban 11 923 tokens de definiciones de herramientas; la skill de Apidog CLI añadía solo 112.
Esa diferencia es toda la historia detrás de dos publicaciones en Dev.to esta semana. Un desarrollador escribió «Run tests» en un agente de código y vio 28 400 tokens de entrada en la primera petición, sin archivos adjuntos y sin historial. El culpable eran siete servidores MCP. Otro sostenía que MCP es extremadamente simple de construir, y que las partes difíciles (autenticación, aprobaciones, llamadas duplicadas) empiezan justo después de que el demo funcione.
Este artículo se centra en una sola pregunta: cuánto cuestan a tu ventana de contexto las definiciones de herramientas, y cuándo una CLI que el agente invoca bajo demanda cuesta menos. Si tu problema son las respuestas enormes de las herramientas, lee el artículo complementario sobre cómo recortar respuestas de API demasiado grandes.
Por qué los servidores MCP consumen tokens de la ventana de contexto
Un servidor MCP anuncia sus herramientas mediante el método tools/list. Según la especificación de herramientas de MCP, cada herramienta incluye un name, una description y un inputSchema (un JSON Schema para sus argumentos). Para que el modelo elija una herramienta, el cliente debe incluir esas definiciones en la petición. En una configuración clásica, eso ocurre en cada turno de cada conversación, tanto si el agente llama a la herramienta como si no.
Así que el costo crece con tres factores:
- Cantidad de herramientas. Una integración completa de GitHub puede exponer decenas de herramientas.
- Profundidad del esquema. Los objetos anidados, los enums y las descripciones largas se convierten todos en tokens.
- Turnos. Un bucle de agente reenvía las definiciones en cada paso.
La publicación de necoz pone cifras: un stack de 52 herramientas costaba 24 600 tokens de esquema en el turno 1, frente a 640 tokens para una configuración de 4 herramientas, y unos 246 000 tokens a lo largo de un bucle de 10 pasos. Tómalo como la medición de un desarrollador, no como un benchmark. El prompt caching reduce el costo en dólares de las definiciones repetidas, pero los tokens siguen ocupando la ventana y compiten con tu código por la atención del modelo.
También hay un costo de calidad. La documentación de búsqueda de herramientas de Anthropic indica que una configuración multi-servidor con GitHub, Slack, Sentry, Grafana y Splunk «puede consumir ~55k tokens en definiciones antes de que Claude haga cualquier trabajo», y que la precisión de Claude al seleccionar herramientas se degrada cuando superas las 30 o 50 herramientas disponibles.
Tokens de definiciones de herramientas MCP: una medición que puedes repetir
El 2026-11-16 inicié cinco servidores MCP localmente sobre stdio, envié initialize y tools/list desde un script de Node de 30 líneas y conté los tokens del name, la description y el inputSchema de cada herramienta.
Una advertencia antes de empezar: conté con la codificación o200k_base de tiktoken de OpenAI porque funciona sin conexión. Claude, Gemini y otros modelos usan sus propios tokenizadores, así que tus conteos variarán en cierto margen. Lo que importa aquí son las proporciones entre configuraciones.
| Servidor MCP (versión) | Herramientas | Tokens de definiciones | Promedio por herramienta |
|---|---|---|---|
@playwright/mcp 0.0.85 |
25 | 4,634 | 185 |
@modelcontextprotocol/server-filesystem 2.3.0 |
16 | 3,281 | 205 |
@modelcontextprotocol/server-memory 2.1.1 |
9 | 2,013 | 224 |
@modelcontextprotocol/server-everything 2.3.0 |
16 | 1,995 | 125 |
| Esos cuatro juntos | 66 | 11,923 | 181 |
apidog-mcp-server 0.0.18 |
3 | 291 | 97 |
Cuatro servidores corrientes cuestan unos 12 000 tokens antes de que el agente lea un solo archivo.
La última fila es el contraejemplo útil. El servidor MCP de Apidog expone tres herramientas acotadas (leer la especificación OpenAPI del proyecto, leer archivos $ref, refrescar la especificación), por lo que cuesta 291 tokens. Lo que dispara la factura es la cantidad de herramientas y la profundidad del esquema, no el protocolo.
En el lado de la CLI, medí lo que un agente realmente lee al usar Apidog CLI 2.2.12:
| Texto de la CLI | Cuándo entra al contexto | Tokens |
|---|---|---|
| Descripción de la skill de Apidog CLI (frontmatter) | Cada sesión, como listado de skills | 112 |
| Cuerpo de la skill de Apidog CLI | Solo cuando la tarea coincide | 1,189 |
apidog --help |
Solo cuando el agente lo ejecuta | 668 |
apidog test-case --help |
Solo cuando el agente lo ejecuta | 511 |
apidog run --help |
Solo cuando el agente lo ejecuta | 1,036 |
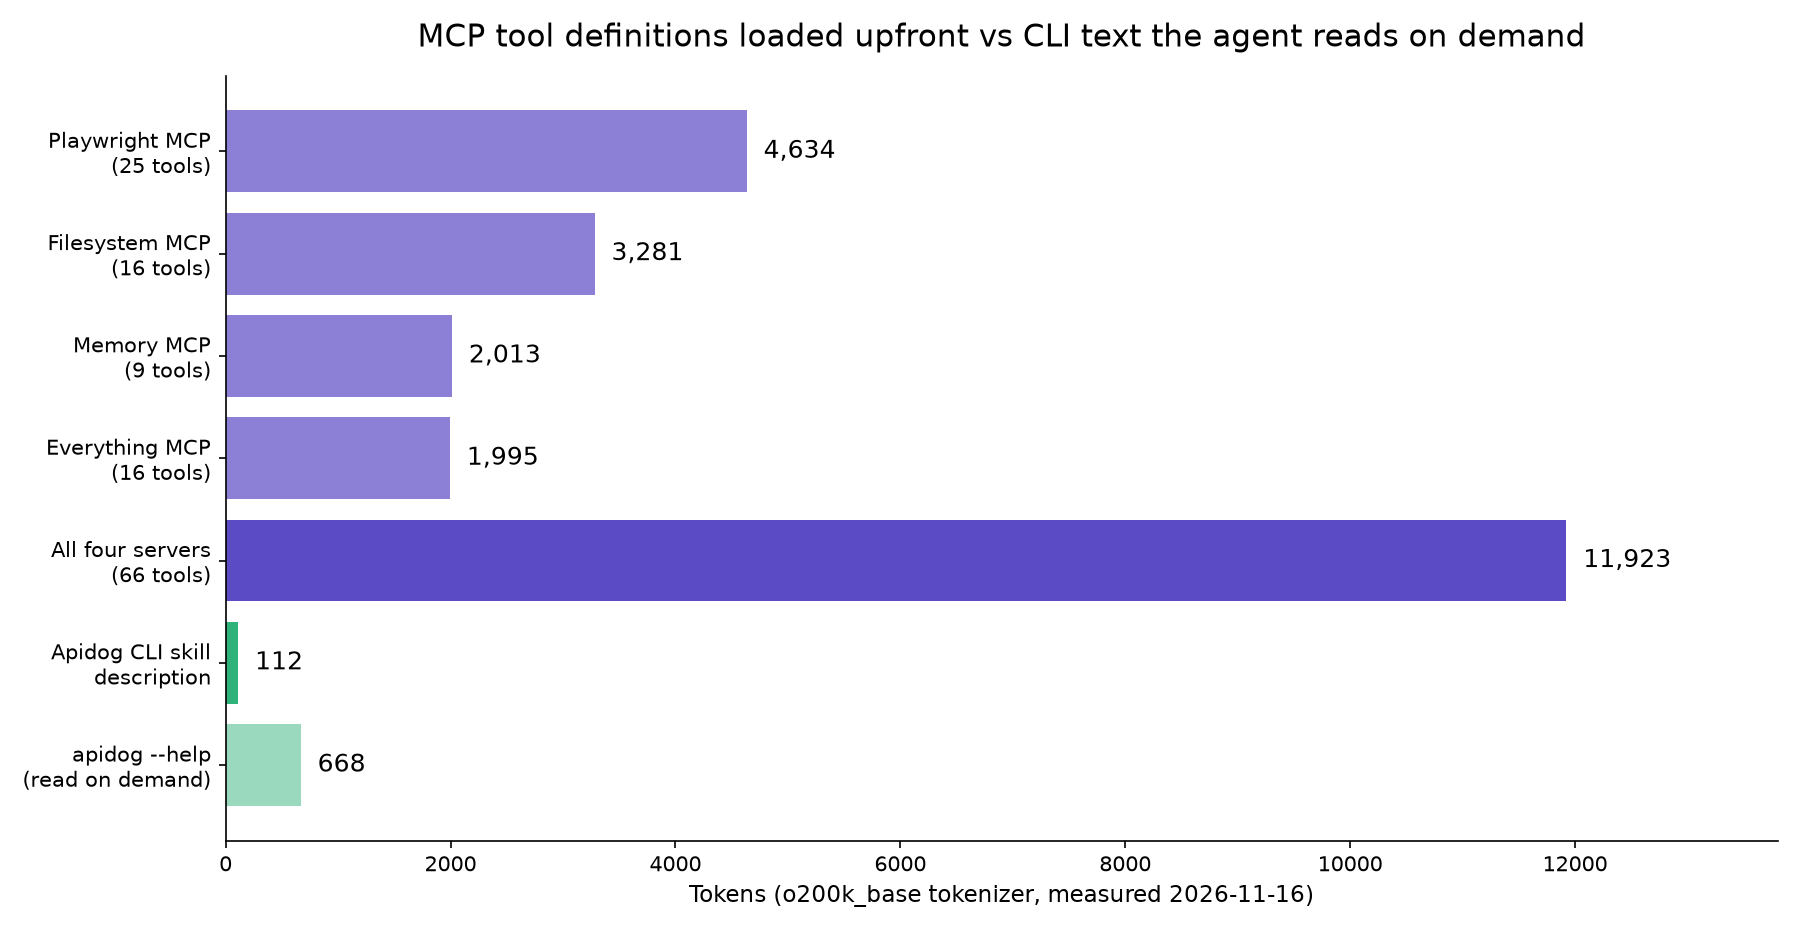
El costo permanente de la vía CLI es de 112 tokens. Incluso si el agente carga la skill completa y lee tres páginas de ayuda, se queda cerca de los 3500 tokens, y solo en la conversación que lo necesita.
MCP vs CLI: la comparación del costo en tokens
| Servidor MCP (definiciones cargadas por adelantado) | CLI invocada mediante el shell | |
|---|---|---|
| Costo inicial | El esquema de cada herramienta, en cada turno | Cero, o una breve descripción de skill |
| Descubrimiento | tools/list estructurado |
Texto --help, leído cuando se necesita |
| Salida | Lo que devuelva la herramienta | Lo que imprima el comando (puedes filtrarlo) |
| Funciona en varios clientes | Cualquier cliente MCP, una sola configuración | Cualquier agente con una herramienta de shell |
| Argumentos tipados | Sí, mediante JSON Schema | Flags; archivos de payload validados aparte |
| Auth y permisos | Tarea del servidor (OAuth para servidores HTTP remotos) | Tu sesión local y permisos del shell |
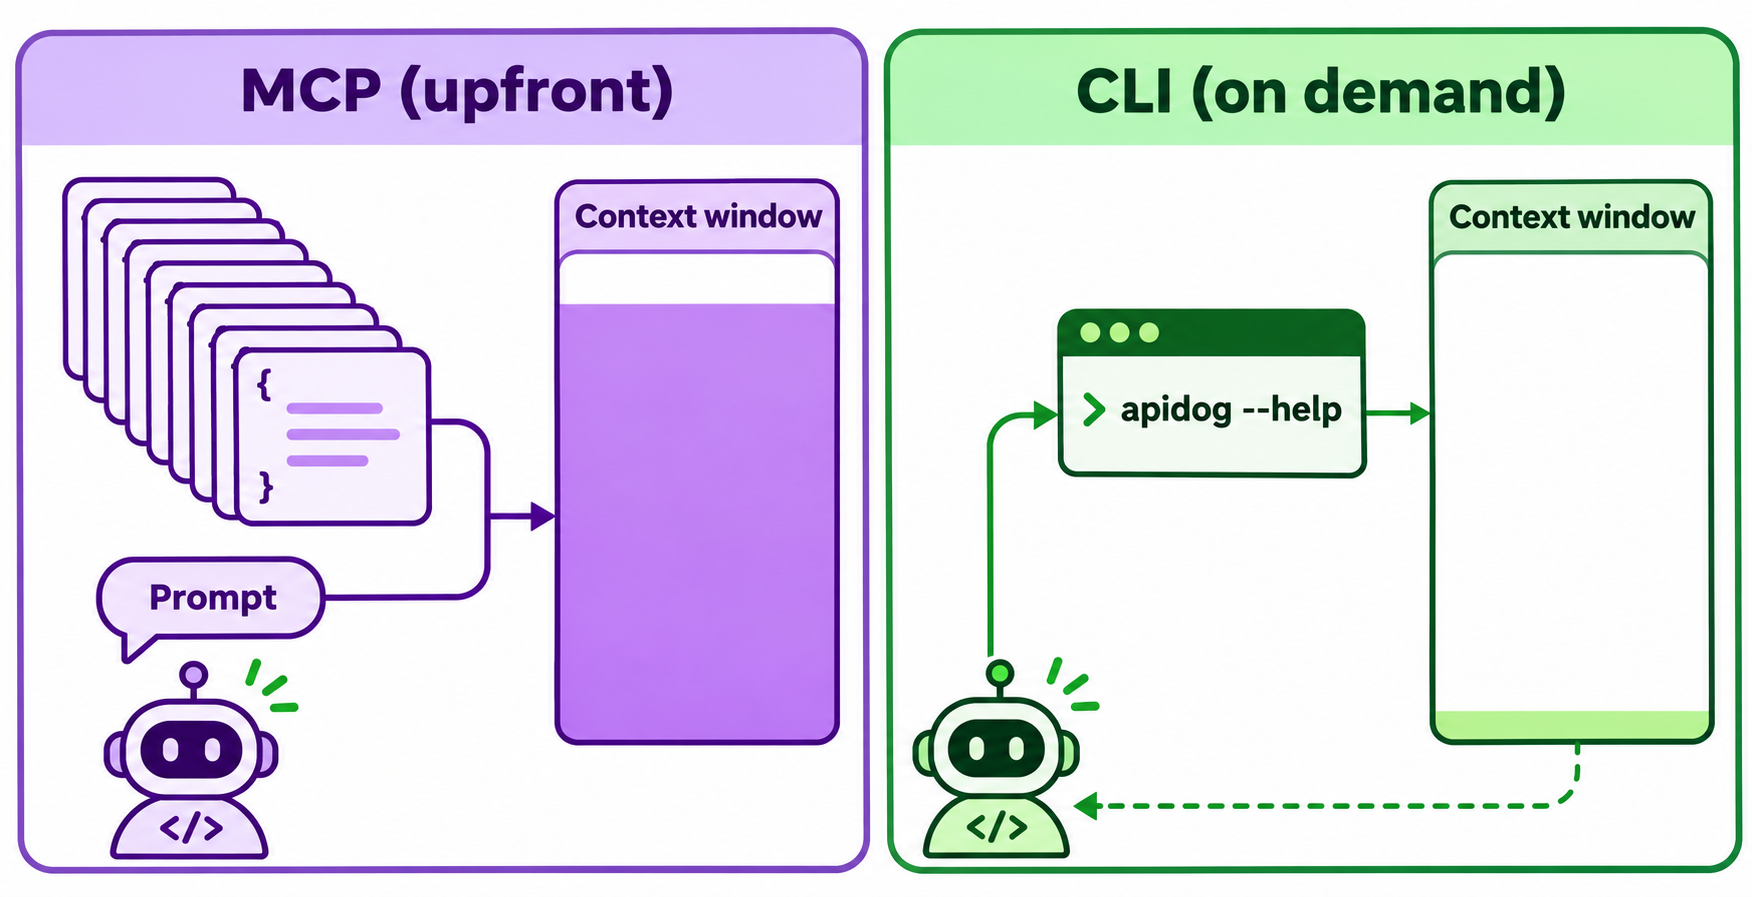
La CLI gana en costo inicial porque el agente ya tiene una herramienta de shell. Ejecutar apidog endpoint list --project 123 usa la herramienta Bash que iba a cargar de todos modos. La vía MCP gana cuando necesitas la misma capacidad en varios clientes sin escribir una integración para cada uno, que es el punto que señala Sylwia Lask: MCP no reemplaza a REST, es una forma estándar para que los clientes de IA descubran y llamen herramientas.
Tu cliente quizá ya difiere las herramientas MCP
Antes de eliminar todos los servidores, revisa lo que hace tu agente. El costo anterior asume que las definiciones se cargan por adelantado. Algunos clientes ya no lo hacen por defecto.
La documentación de MCP de Claude Code indica que la búsqueda de herramientas está habilitada por defecto: «Solo los nombres de herramientas y las instrucciones del servidor se cargan al inicio de la sesión», y las definiciones completas se cargan cuando Claude las busca. Lo controlas con ENABLE_TOOL_SEARCH:
- sin definir o
true: las herramientas MCP se difieren y se cargan bajo demanda auto: las herramientas se cargan por adelantado mientras sus definiciones sumen menos del 10% de la ventana de contextoauto:N: lo mismo, con tu propio porcentajefalse: toda herramienta MCP se carga por adelantado
Dos excepciones importan. Los modelos anteriores a Opus 4 y Sonnet 4 cargan las herramientas MCP por adelantado sin importar la configuración, y un servidor con alwaysLoad: true omite la diferición. Ejecuta /context en Claude Code para ver qué herramientas están marcadas como diferidas. En la API de Claude propiamente dicha, la misma idea es la tool search tool: configuras defer_loading: true en las herramientas que no deben cargarse por adelantado, y Anthropic afirma que esto típicamente reduce los tokens de definiciones en más del 85%.
La diferición resuelve el costo de definiciones, no el de la salida: Claude Code advierte cuando una herramienta MCP devuelve más de 10 000 tokens y limita la salida a 25 000 por defecto (MAX_MCP_OUTPUT_TOKENS). ¿Nuevo en el protocolo? Empieza con qué es MCP y por qué importa para las APIs.
Cuándo usar MCP vs CLI para trabajo con APIs
Para diseño, pruebas y documentación de APIs, usa esta división:
- Usa una CLI cuando la tarea sea algo que de todos modos ejecutarías en una terminal: listar endpoints, exportar un archivo OpenAPI, crear y ejecutar un caso de prueba, correr una suite en CI. El agente solo paga por el texto de ayuda cuando lo necesita, y puedes filtrar la salida con
jqo--reporterspara mantenerla corta. - Usa un servidor MCP acotado cuando el agente necesite acceso de lectura estructurado en cada turno, como leer tu especificación OpenAPI mientras escribe código cliente. Tres herramientas por 291 tokens es un precio justo.
- Evita dejar cinco o más servidores habilitados globalmente en todos tus proyectos. Esa es la configuración que produjo el «Run tests» de 28 400 tokens.
Elijas lo que elijas, las advertencias de Sylwia siguen aplicando: una herramienta que escribe datos necesita comprobaciones de permisos en el servidor, un paso de aprobación humana para acciones riesgosas y detección de duplicados para que una reejecución no cree el mismo registro dos veces.
Deja que tu agente de código maneje Apidog CLI
Aquí tienes la vía CLI para trabajo con APIs, con tu agente de código haciendo el trabajo de escribir. Instala la CLI, inicia sesión una vez y añade la skill del agente:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
También puedes decirle al agente «Read https://apidog.com/apidog-cli-installation-guide.md and set up Apidog CLI», y seguirá la guía de instalación orientada a agentes.
Luego dale un solo prompt:
In Apidog project 123, list the endpoints, export the spec as OpenAPI 3.1 to
./openapi.json, then create a test case for GET /users/{id} that asserts a 200
status and an id field, run it against environment 456 and summarize failures.
Read --help for each command before using it. Print only the lines you need.
El agente lee la ayuda a medida que avanza, valida su JSON y después ejecuta el caso:
apidog endpoint list --project 123 --page 1 --page-size 500
apidog export --project 123 --format openapi --oas-version 3.1 --output ./openapi.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project 123 --file case.json
apidog run --test-case <caseId> --project 123 -e 456 -r cli,json
Cada comando devuelve JSON estructurado, a menudo con agentHints.nextSteps, así que el agente sabe qué ejecutar a continuación sin cargar un esquema para cada acción posible. La misma línea apidog run ... -r junit se integra en CI, como se muestra en la guía de pipeline CI/CD de Apidog CLI. Para un recorrido por Claude Code, consulta Apidog CLI en Claude Code, y para ahorros medidos en llamadas de herramientas, 30% menos llamadas de herramientas, 25% menos tokens.
Para ver todos los grupos de comandos antes de empezar, lee la página de Apidog CLI.
Cómo reducir el costo en tokens de MCP hoy mismo
- Ejecuta
/contexten Claude Code (o el equivalente en tu cliente) y anota el total de definiciones de herramientas. - Mueve los servidores que no necesites de la configuración global a la configuración del proyecto.
- Activa la carga diferida (
ENABLE_TOOL_SEARCHen Claude Code). - Reemplaza los servidores amplios por una CLI más una skill corta para trabajo de tipo terminal.
- En los servidores que construyas, mantén pocas herramientas y descripciones breves.
FAQ
¿Las herramientas MCP consumen tokens aunque el agente nunca las llame? En un cliente que carga las definiciones por adelantado, sí. El nombre, la descripción y el esquema de entrada de cada herramienta entran en cada petición. Los clientes con carga diferida, como Claude Code con la búsqueda de herramientas activada, envían solo los nombres hasta que una herramienta se necesita.
¿Cuántos tokens usa un servidor MCP? Depende de la cantidad de herramientas y de la profundidad del esquema. En mi medición, @playwright/mcp usó 4634 tokens para 25 herramientas y el servidor MCP de Apidog usó 291 para 3 herramientas, contados con el tokenizador o200k_base.
¿Una CLI siempre es más barata que MCP para agentes de IA? En costo inicial, casi siempre, porque el agente reutiliza su herramienta de shell. Por llamada, una CLI igual puede saturar el contexto si el agente imprime un payload grande, así que filtra la salida en ambos casos.
¿El prompt caching soluciona la inflación de contexto de MCP? Reduce el precio de las definiciones repetidas. No libera la ventana de contexto, y el modelo sigue atendiendo a esos tokens en cada turno.
¿Debería dejar de usar servidores MCP? No. Usa servidores acotados para acceso estructurado en cada turno y para compartir una misma capacidad entre varios clientes. Mueve el trabajo de API de tipo terminal, como exportaciones y ejecuciones de pruebas, a una CLI.