
Los ingenieros de Mistral AI diseñaron Magistral Small 1.2 como un modelo de 24 mil millones de parámetros que prioriza la eficiencia del razonamiento. Esta versión se basa directamente en Mistral Small 1.1. Los ingenieros aplicaron un ajuste fino supervisado utilizando rastros de Magistral Medium, seguido de etapas de aprendizaje por refuerzo. En consecuencia, el modelo destaca en la lógica de múltiples pasos sin demandas computacionales excesivas.
Comprendiendo la Evolución de la Familia de Modelos Magistral
Fundamentos de la Arquitectura y Especificaciones Técnicas
El Magistral Small 1.2 se basa en la sólida base de Magistral 1.1, incorporando capacidades avanzadas de razonamiento a través de un ajuste fino supervisado (SFT) a partir de rastros de Magistral Medium combinado con optimización por aprendizaje por refuerzo (RL). Basado en Magistral 1.1, con capacidades de razonamiento añadidas, sometido a SFT a partir de rastros de Magistral Medium y RL adicional, es un modelo de razonamiento pequeño y eficiente con 24 mil millones de parámetros.
Además, el diseño arquitectónico permite escenarios de despliegue eficientes. Magistral Small puede desplegarse localmente, cabiendo en una única RTX 4090 o un MacBook con 32 GB de RAM una vez cuantificado. Esta accesibilidad hace que el modelo sea adecuado tanto para entornos empresariales como para desarrolladores individuales.
Mejoras Técnicas Clave en la Versión 1.2
La transición de la versión 1.1 a la 1.2 introduce varias mejoras críticas que impactan significativamente el rendimiento y la usabilidad del modelo. En particular, estas actualizaciones abordan limitaciones fundamentales al tiempo que amplían los límites de las capacidades.
Avance en la Integración Multimodal
Ahora equipados con un codificador de visión, estos modelos manejan texto e imágenes sin problemas. Esta integración representa un cambio de paradigma, pasando del razonamiento puramente basado en texto a una comprensión multimodal integral. La arquitectura del codificador de visión permite a los modelos procesar información visual manteniendo sus capacidades de razonamiento textual.
Resultados de Optimización del Rendimiento
Mejoras del 15% en los benchmarks de matemáticas y codificación como AIME 24/25 y LiveCodeBench v5/v6. Estas ganancias de rendimiento se traducen directamente en aplicaciones prácticas, beneficiando particularmente a los desarrolladores que trabajan en computación matemática, desarrollo de algoritmos y escenarios complejos de resolución de problemas.
Análisis Exhaustivo de Características
Capacidades Avanzadas de Razonamiento
La arquitectura de razonamiento incorpora tokens de pensamiento especializados que estructuran el proceso de razonamiento interno del modelo. La implementación utiliza los tokens [THINK] y [/THINK] para encapsular el contenido del razonamiento, creando transparencia en el proceso de toma de decisiones del modelo y evitando confusiones durante el procesamiento de las instrucciones.
Además, el sistema de razonamiento opera a través de cadenas extendidas de inferencia lógica antes de generar las respuestas finales. Este enfoque permite al modelo abordar problemas complejos que requieren análisis de múltiples pasos, derivaciones matemáticas y deducciones lógicas.
Infraestructura de Soporte Multilingüe
Los modelos demuestran un soporte lingüístico integral en diversas familias lingüísticas. Los idiomas soportados abarcan regiones europeas, asiáticas, de Oriente Medio y del sur de Asia, incluyendo inglés, francés, alemán, griego, hindi, indonesio, italiano, japonés, coreano, malayo, nepalí, polaco, portugués, rumano, ruso, serbio, español, turco, ucraniano, vietnamita, árabe, bengalí, chino y farsi.
Además, esta amplia capacidad multilingüe garantiza la accesibilidad global y permite a los desarrolladores crear aplicaciones que sirvan a mercados internacionales sin requerir implementaciones de modelos separadas para diferentes idiomas.
Arquitectura de Procesamiento de Visión
La integración del codificador de visión permite un análisis y razonamiento sofisticados de imágenes. El modelo procesa contenido visual y lo combina con información textual para generar respuestas completas. Esta capacidad se extiende más allá del simple reconocimiento de imágenes para incluir la comprensión contextual, el razonamiento espacial y la resolución de problemas visuales.
Benchmarks de Rendimiento y Análisis Comparativo
Rendimiento en Razonamiento Matemático
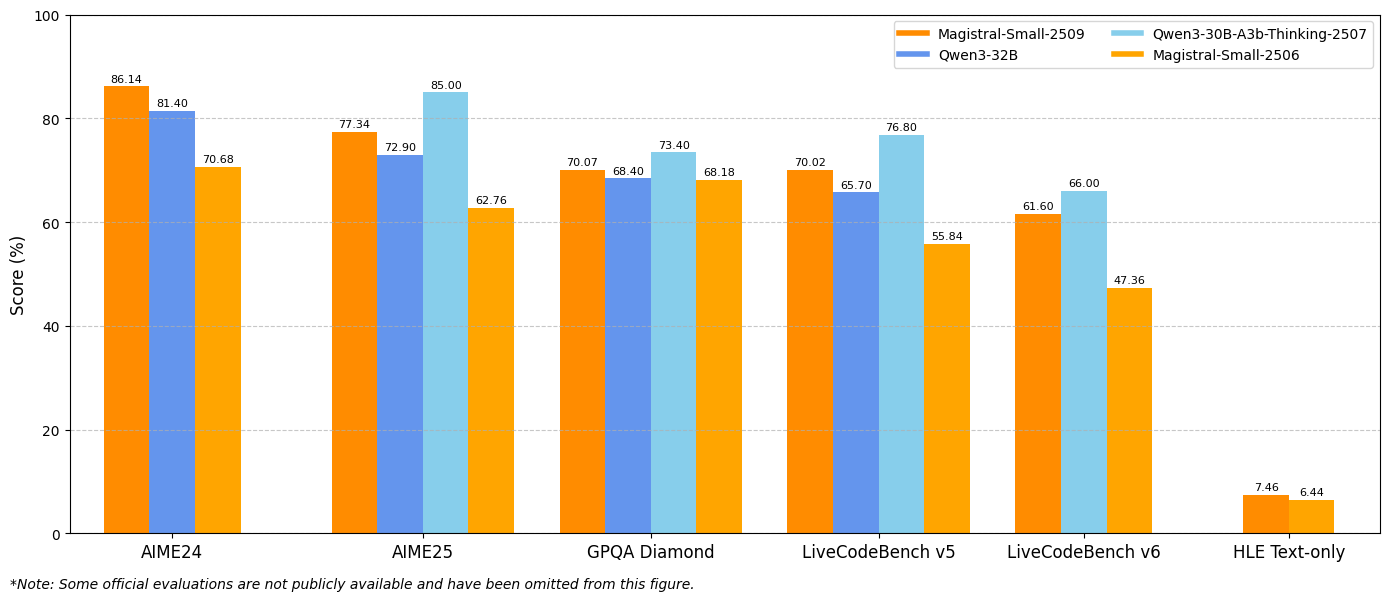
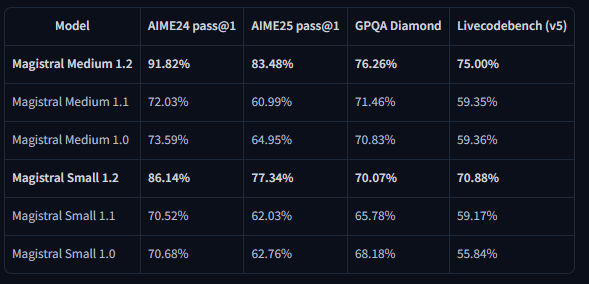
Los resultados de los benchmarks demuestran mejoras sustanciales en las métricas clave de evaluación. Magistral Small 1.2 alcanza el 86.14% en AIME24 pass@1 y el 77.34% en AIME25 pass@1, lo que representa avances significativos sobre el 70.52% y el 62.03% de la versión 1.1, respectivamente.
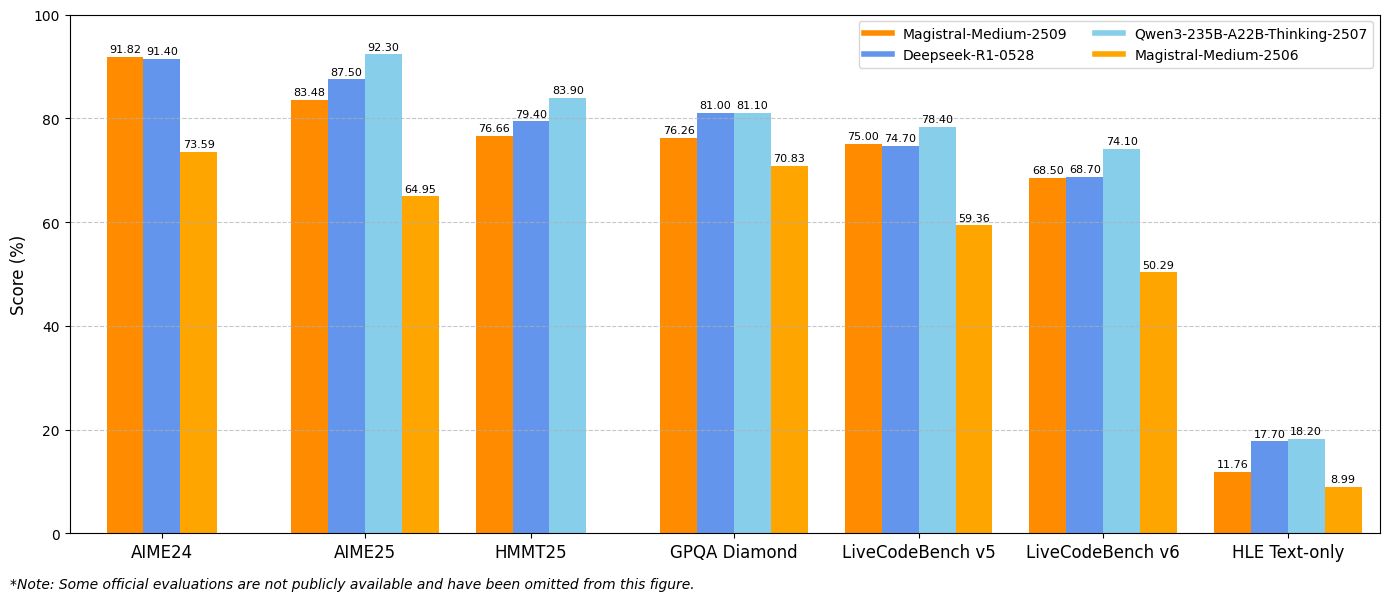
De manera similar, Magistral Medium 1.2 ofrece un rendimiento excepcional con el 91.82% en AIME24 pass@1 y el 83.48% en AIME25 pass@1, superando el 72.03% y el 60.99% de la versión 1.1. Estas mejoras indican capacidades de razonamiento matemático mejoradas que benefician directamente a la computación científica, las aplicaciones de ingeniería y los entornos de investigación.
Métricas de Rendimiento de Codificación
Las evaluaciones de LiveCodeBench revelan mejoras sustanciales en la capacidad de codificación. Magistral Small 1.2 obtiene un 70.88% en LiveCodeBench v5, mientras que Magistral Medium 1.2 alcanza un 75.00%. Estas puntuaciones representan avances significativos en la generación de código, la depuración y las tareas de implementación de algoritmos.
Además, los modelos demuestran una mejor comprensión de los conceptos de programación, los patrones de arquitectura de software y las metodologías de depuración. Este rendimiento de codificación mejorado beneficia a los equipos de desarrollo de software, los marcos de prueba automatizados y los entornos de programación educativa.
Resultados de GPQA Diamond
Los resultados del benchmark GPQA (General Purpose Question Answering) Diamond muestran las amplias capacidades de aplicación de conocimiento de los modelos. Magistral Small 1.2 alcanza el 70.07%, mientras que Magistral Medium 1.2 llega al 76.26%. Estas puntuaciones reflejan la capacidad de los modelos para manejar diversos tipos de preguntas que requieren conocimiento interdisciplinario y razonamiento.
Estrategias de Implementación e Integración
Configuración del Entorno de Desarrollo
La implementación de Magistral Small 1.2 y Magistral Medium 1.2 requiere configuraciones técnicas específicas para optimizar el rendimiento. Los parámetros de muestreo recomendados incluyen top_p: 0.95, temperature: 0.7 y max_tokens: 131072. Estos ajustes equilibran la creatividad con la coherencia al tiempo que admiten secuencias de razonamiento extendidas.
Además, los modelos son compatibles con varios marcos de implementación, incluidos vLLM, Transformers, llama.cpp y formatos de cuantificación especializados. Esta flexibilidad permite la integración en diferentes entornos informáticos y casos de uso.
Integración de API con Apidog
Apidog proporciona herramientas completas para probar e integrar las API de Magistral en tus aplicaciones. La plataforma admite escenarios avanzados de prueba de API, incluido el manejo de entradas multimodales, el análisis de rastros de razonamiento y la supervisión del rendimiento. A través de la interfaz de Apidog, los desarrolladores pueden probar eficientemente combinaciones de imagen y texto, validar salidas de razonamiento y optimizar los parámetros de las llamadas a la API.
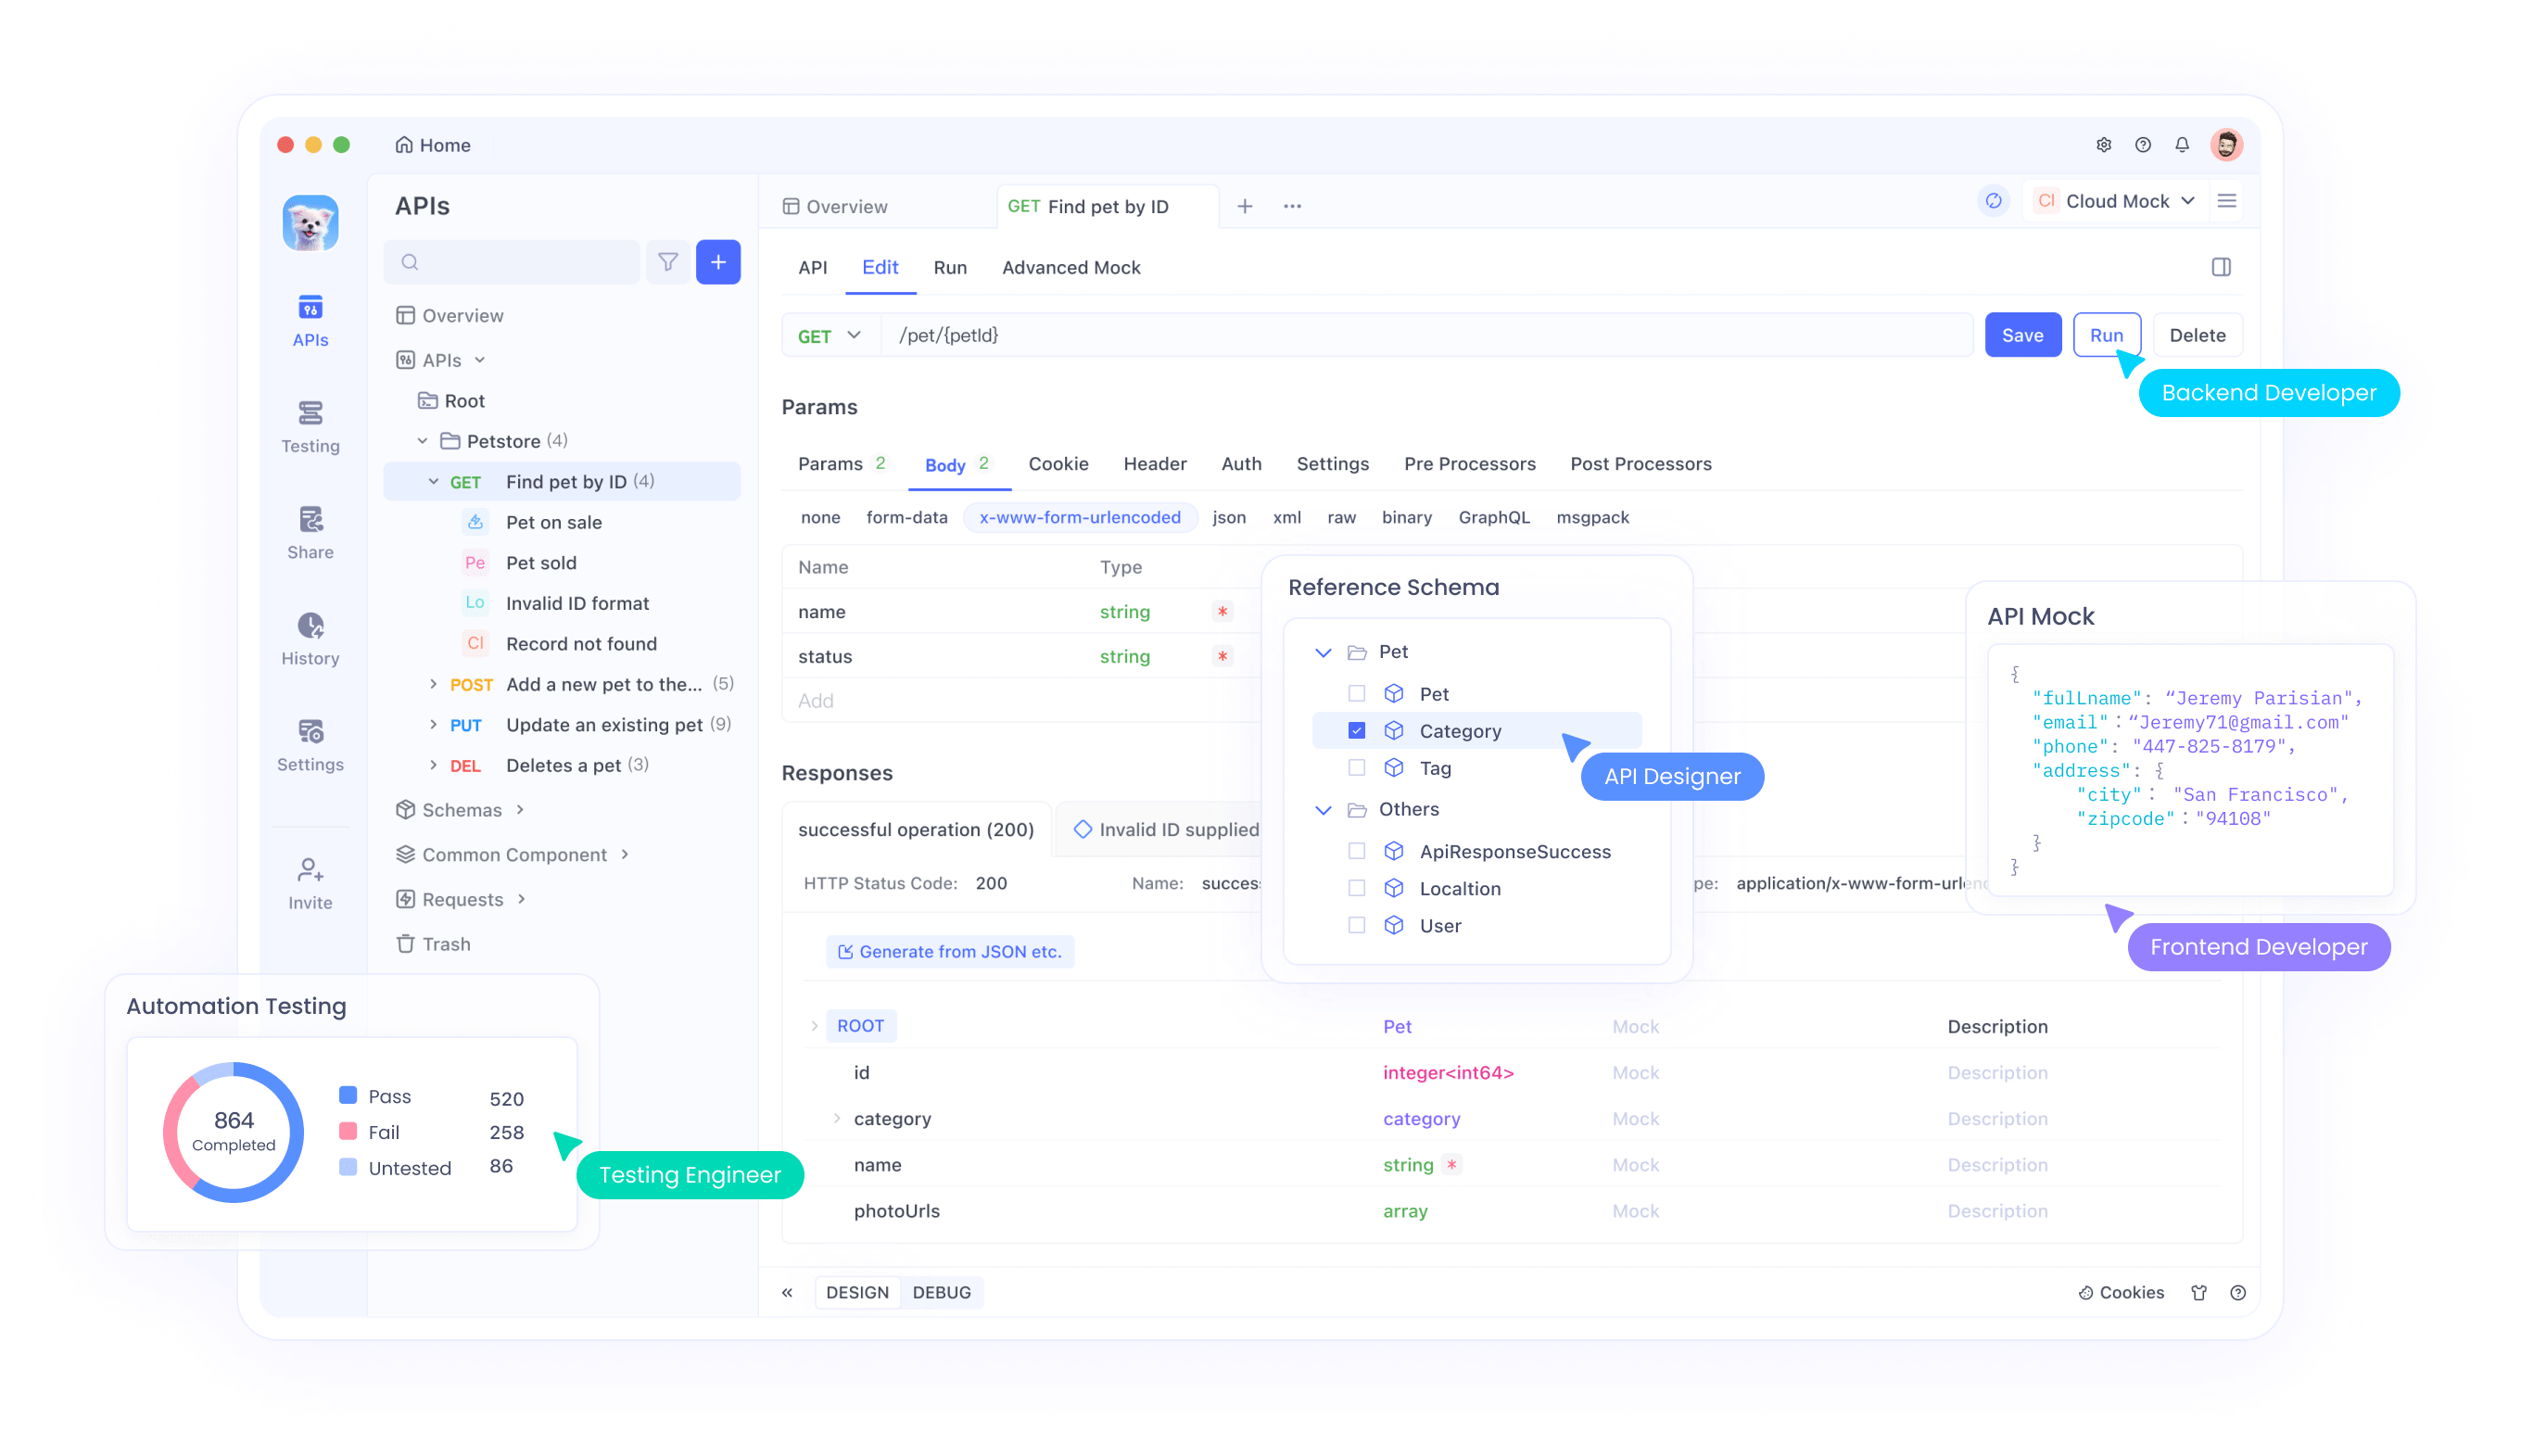
Además, las funciones de colaboración de Apidog permiten a los equipos compartir configuraciones de prueba de API, documentar patrones de integración y mantener estándares de prueba consistentes en todos los ciclos de desarrollo. Este enfoque colaborativo acelera los plazos de desarrollo al tiempo que garantiza implementaciones de API robustas.
Optimización de las Instrucciones del Sistema
Los modelos requieren instrucciones de sistema cuidadosamente elaboradas para lograr un rendimiento óptimo. La estructura recomendada de las instrucciones del sistema incluye instrucciones de razonamiento, pautas de formato y especificaciones de idioma. La instrucción debe solicitar explícitamente procesos de pensamiento utilizando los tokens especializados, manteniendo un formato de respuesta consistente.
Además, la personalización de las instrucciones del sistema permite optimizaciones específicas de la aplicación. Los desarrolladores pueden modificar las instrucciones para enfatizar patrones de razonamiento particulares, ajustar formatos de salida o incorporar requisitos de conocimiento específicos del dominio.
Análisis Profundo de la Implementación Técnica
Requisitos de Memoria y Computación
Magistral Small 1.2 opera eficientemente dentro de entornos de hardware restringidos manteniendo un alto rendimiento. La arquitectura de 24 mil millones de parámetros permite el despliegue en hardware de consumo cuando se cuantifica correctamente, haciendo que las capacidades avanzadas de razonamiento sean accesibles para desarrolladores individuales y pequeños equipos.
Además, las mejoras en la eficiencia computacional en la versión 1.2 reducen la latencia de inferencia manteniendo la calidad del razonamiento. Esta optimización permite aplicaciones en tiempo real y sistemas interactivos que requieren una generación de respuestas inmediata.
Ventana de Contexto y Capacidades de Procesamiento
Los modelos admiten una ventana de contexto de 128.000 tokens, lo que permite el procesamiento de documentos extensos, conversaciones complejas y tareas analíticas a gran escala. Si bien el rendimiento puede degradarse más allá de los 40.000 tokens, los modelos mantienen una funcionalidad razonable en todo el rango de contexto.
Además, la capacidad de contexto extendido permite un análisis documental exhaustivo, tareas de razonamiento de formato largo y conversaciones de múltiples turnos con una conciencia contextual mantenida. Esta capacidad es compatible con aplicaciones empresariales que requieren un procesamiento extenso de información.
Técnicas de Cuantificación y Optimización
Los modelos admiten varios formatos de cuantificación a través de implementaciones GGUF, lo que permite su despliegue en diferentes configuraciones de hardware. Estas optimizaciones reducen los requisitos de memoria al tiempo que preservan las capacidades de razonamiento, haciendo que los modelos sean accesibles en entornos con recursos limitados.
Además, las técnicas de optimización especializadas mantienen la velocidad de inferencia al tiempo que admiten las complejas operaciones de razonamiento. Estas mejoras técnicas garantizan la viabilidad práctica del despliegue en diversos entornos informáticos.
Pruebas y Validación con Apidog
Estrategias Integrales de Pruebas de API
Apidog proporciona herramientas esenciales para validar las integraciones de modelos Magistral a través de marcos de prueba integrales. La plataforma admite pruebas de entrada multimodal, validación de rastros de razonamiento y evaluación comparativa del rendimiento. Los equipos pueden crear conjuntos de pruebas que verifiquen tanto la corrección funcional como las características de rendimiento.
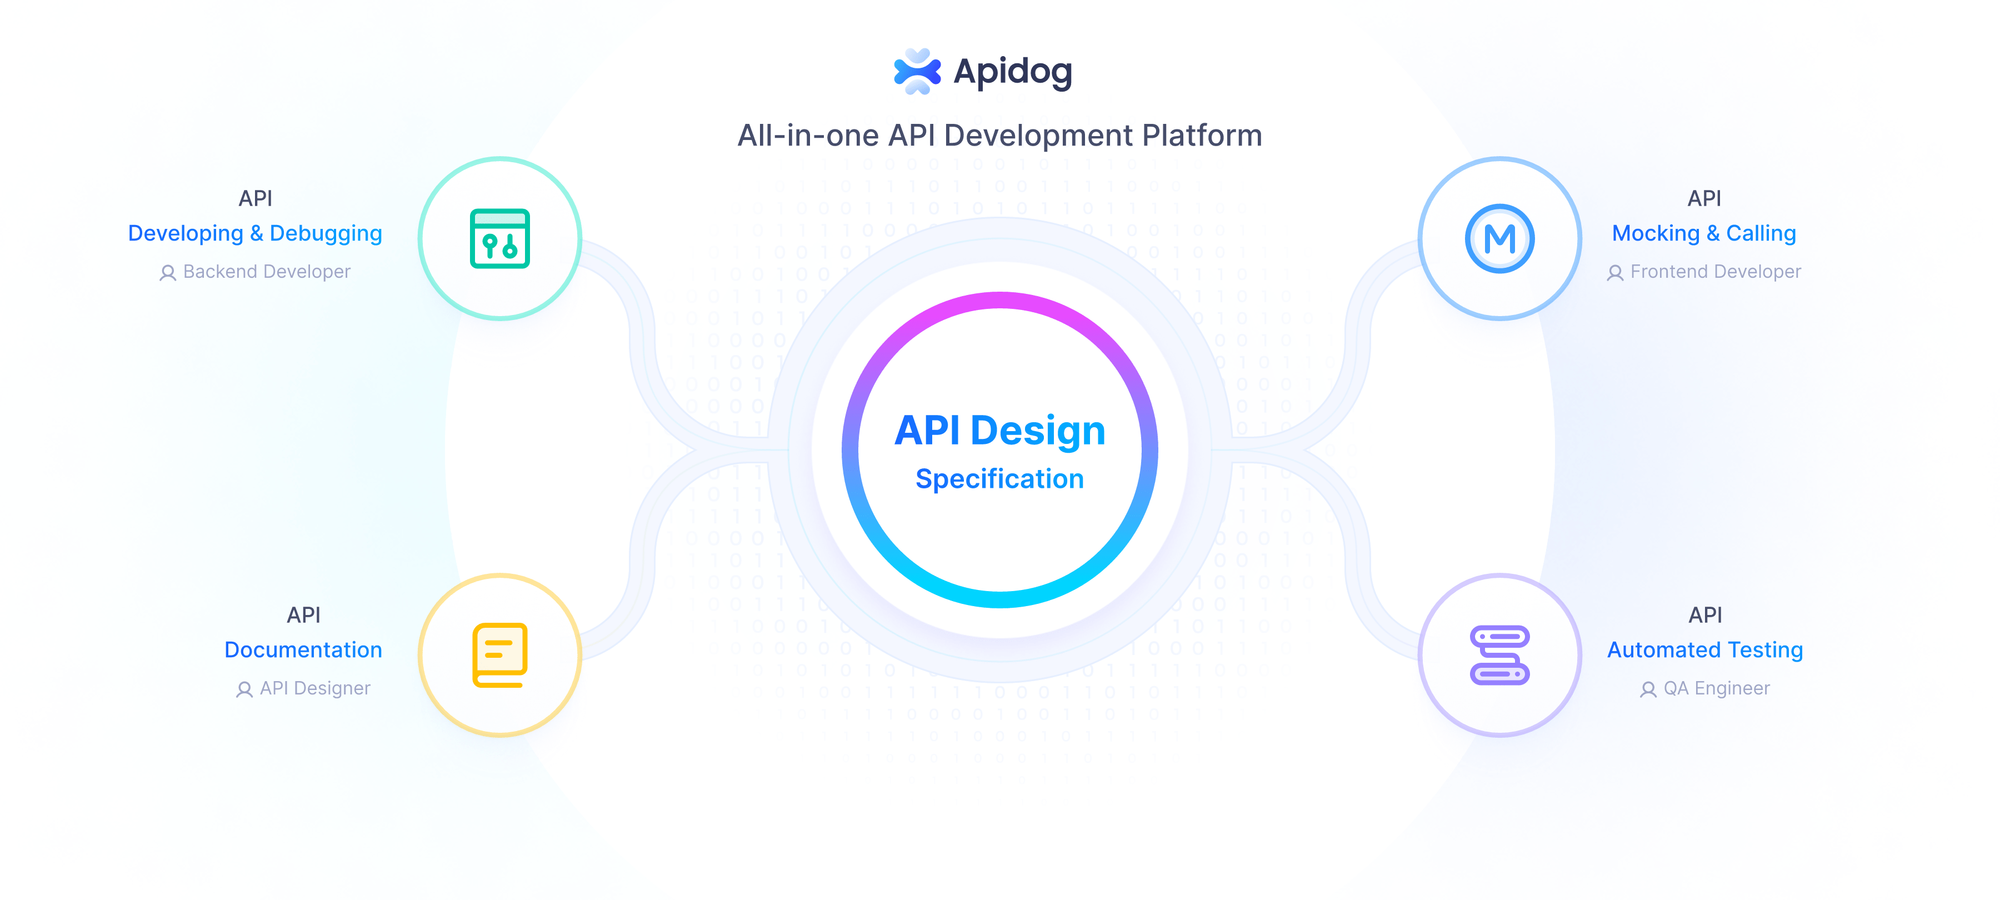
Las capacidades de prueba automatizadas de Apidog permiten flujos de trabajo de integración continua que garantizan la coherencia del rendimiento del modelo en todos los ciclos de desarrollo. Esta automatización reduce la sobrecarga de las pruebas manuales al tiempo que mantiene los estándares de garantía de calidad.
Monitoreo y Optimización del Rendimiento
A través de las capacidades de monitoreo de Apidog, los equipos de desarrollo pueden rastrear las métricas de rendimiento de la API, identificar oportunidades de optimización y mantener la confiabilidad del servicio. La plataforma proporciona análisis detallados sobre los tiempos de respuesta, la calidad del razonamiento y los patrones de utilización de recursos.
Además, los datos de monitoreo permiten estrategias de optimización proactivas que mejoran el rendimiento de la aplicación y la experiencia del usuario. Este enfoque basado en datos garantiza una utilización óptima del modelo en entornos de producción.
Conclusión
Magistral Small 1.2 y Magistral Medium 1.2 representan avances significativos en la tecnología de razonamiento de IA multimodal. La combinación de un rendimiento matemático mejorado, capacidades de visión y una mayor transparencia en el razonamiento crea herramientas poderosas para diversas aplicaciones, desde la investigación científica hasta el desarrollo de software.
Las mejoras de accesibilidad a través de opciones de despliegue local y un soporte integral de API democratizan el acceso a capacidades avanzadas de razonamiento. Las organizaciones ahora pueden integrar un razonamiento de IA sofisticado en sus flujos de trabajo sin requerir grandes inversiones en infraestructura.
Ya sea que estés desarrollando aplicaciones educativas, realizando investigaciones científicas o construyendo sistemas de software complejos, Magistral Small 1.2 y Magistral Medium 1.2 proporcionan las capacidades de razonamiento necesarias para las aplicaciones de IA de próxima generación. Combinados con herramientas robustas de prueba e integración como Apidog, estos modelos permiten flujos de trabajo de desarrollo integrales que aceleran la innovación manteniendo los estándares de calidad.